

Was ist PySpark?
PySpark ist die Python-API für Apache Spark. Dein Python-Code beschreibt die gewünschten Transformationen, und die Engine von Spark, die auf der Java Virtual Machine (JVM) läuft, plant und führt sie im Cluster aus. Du bekommst die verteilte Ausführung von Spark, ohne Scala oder Java schreiben zu müssen.
Data Scientists nutzen PySpark zum Bereinigen und Aggregieren großer Datensätze, Data Engineers für ETL-Pipelines, und beide verwenden pyspark.ml, um Modelle auf Daten zu trainieren, die nicht auf eine einzelne Maschine passen. Wenn du heute vor allem mit pandas arbeitest, wird dir die DataFrame-API vertraut vorkommen.
Wann PySpark statt pandas verwenden
PySpark zahlt sich aus, wenn Daten größer als eine einzelne Maschine werden; darunter ist pandas in der Regel schneller, weil kein JVM-Start und keine Aufgabenplanung anfallen.
| Funktion | pandas | PySpark |
|---|---|---|
| Datengröße | Begrenzt durch den RAM einer Maschine | Begrenzt durch den kombinierten Speicher und die Festplatten im Cluster |
| Ausführung | Sofort, meist einkernig | Lazy, parallel über Kerne oder Maschinen |
| Start-Overhead | Keiner | Einige Sekunden für JVM und SparkSession |
| Streaming-Daten | Nicht unterstützt | Structured Streaming |
| Machine Learning | scikit-learn-Ökosystem | pyspark.ml (verteilt) |
| Fehlertoleranz | Keine; ein Absturz verliert die Arbeit | Verlorene Partitionen werden aus ihrer Abstammung neu berechnet |
Meine Faustregel: Wenn die Daten locker in den Speicher passen und der Job auf einem Laptop läuft, bleib bei pandas. Wechsel zu PySpark, wenn du mit Speicherfehlern kämpfst oder wenn der Job später auf einem Cluster oder einer Plattform wie Databricks laufen soll.
So installierst du PySpark
PySpark wird mit einem pip-Befehl von PyPI installiert und bringt die Spark-Laufzeit mit, sodass du für lokale Arbeit keine separate Spark- oder Hadoop-Installation brauchst. Prüfe vorher die zwei Voraussetzungen.
Voraussetzungen
Laut offiziellem Installationsleitfaden benötigt PySpark 4.3:
- Python 3.11 oder neuer. PySpark 4.3 hat Python 3.10 gestrichen; sieh dir unseren Python-Setup-Guide an, wenn du eine neuere Version brauchst.
- Java 17 oder neuer (Spark 4.3 läuft auf Java 17, 21 und 25) mit der Umgebungsvariable
JAVA_HOME, die darauf zeigt. Unser Guide zur Java-Installation führt durch jedes Betriebssystem.
Beides kannst du im Terminal prüfen:
python3 --version # Python 3.11 oder neuer
java -version # openjdk version "17" oder neuerWenn du in DataLab oder Databricks arbeitest, ist PySpark bereits installiert – spring direkt zum Datensatz.
PySpark mit pip installieren
Ich empfehle eine virtuelle Umgebung, damit PySpark-Abhängigkeiten nicht mit anderen Projekten kollidieren:
python3 -m venv pyspark-env
source pyspark-env/bin/activate
pip install "pyspark[sql]" "pandas<3"
python3 -c "import pyspark; print(pyspark.__version__)"4.3.0Unter Windows verwende python statt python3 und aktiviere die Umgebung mit pyspark-env\Scripts\activate. Das Extra [sql] bringt pandas, PyArrow und NumPy mit, die PySpark für toPandas() und pandas-UDFs nutzt. Ich pinne pandas<3, weil PySpark 4.3 aktuell warnt, dass pandas 3.0 noch nicht vollständig unterstützt wird.
Zwei Fehler verursachen die meisten gescheiterten ersten Läufe:
JAVA_GATEWAY_EXITEDoder "Unable to locate a Java Runtime": Java fehlt oderJAVA_HOMEist nicht gesetzt.PYTHON_VERSION_MISMATCH: Die Worker-Prozesse von Spark haben ein anderes Python als dein Skript gefunden. SetzePYSPARK_PYTHONauf den Interpreter deiner Umgebung, z. B.export PYSPARK_PYTHON=$(which python).
Für betriebssystemspezifische Schritte, inklusive Windows, lies unseren PySpark-Installationsguide.
Den Datensatz beschaffen
Die Beispiele nutzen einen E‑Commerce-Datensatz mit 541.909 Transaktionen eines britischen Online-Händlers, von Dezember 2010 bis Dezember 2011. Jede Zeile ist eine Produktposition auf einer Rechnung mit 8 Spalten:
InvoiceNo: Rechnungsnummer (Nummern mit "C" vorne sind Stornos)StockCodeundDescription: Produktcode und NameQuantityundUnitPrice: Gekaufte Einheiten und Preis pro Einheit in Pfund SterlingInvoiceDate: Datum und Uhrzeit des KaufsCustomerID: Kundenkennung (in einigen Zeilen fehlend)Country: Land des Kunden
Du kannst ihn als datacamp_ecommerce.csv von der DataLab-Dataset-Seite herunterladen. Es ist das Online Retail Dataset aus dem UCI Machine Learning Repository, daher kannst du dieselbe Datei auch aus der öffentlichen Quelle bauen (benötigt pip install openpyxl):
import io
import urllib.request
import zipfile
import pandas as pd
url = "https://archive.ics.uci.edu/static/public/352/online+retail.zip"
with urllib.request.urlopen(url) as response:
archive = zipfile.ZipFile(io.BytesIO(response.read()))
retail = pd.read_excel(
archive.open("Online Retail.xlsx"),
dtype={"InvoiceNo": str, "StockCode": str, "CustomerID": "Int64"},
)
# Datumsformat der DataLab-Datei anpassen, z. B. 12/1/10 8:26
retail["InvoiceDate"] = retail["InvoiceDate"].map(
lambda ts: f"{ts.month}/{ts.day}/{ts:%y} {ts.hour}:{ts:%M}"
)
retail.to_csv("datacamp_ecommerce.csv", index=False)Das Einlesen der 23‑MB-Excel-Datei dauert etwa eine Minute. Speichere die CSV in dem Ordner, aus dem du den restlichen Code ausführst.
Eine SparkSession erstellen
Eine SparkSession ist der Einstiegspunkt in jedes PySpark-Programm: Sie verbindet deinen Python-Code mit der Spark-Engine und erstellt DataFrames. Du erstellst pro Anwendung eine Session mit dem Builder-Pattern:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("PySparkTutorial").getOrCreate()
print(spark.version)4.3.0getOrCreate() gibt die laufende Session zurück, wenn bereits eine existiert – in Notebooks kannst du es also gefahrlos zweimal aufrufen. Aus einem normalen Python-Prozess gestartet, läuft Spark im lokalen Modus (local[*]), nutzt alle CPU-Kerne deiner Maschine als Worker und stellt das Spark-UI unter http://localhost:4040 bereit, um Jobs zu beobachten. Mit spark.stop() gibst du die Ressourcen wieder frei.
Den E‑Commerce-Datensatz laden
Mit laufender Session können wir die CSV in ein DataFrame einlesen. Ich übergebe ein explizites Schema statt inferSchema=True, das die Datei nur zum Raten der Spaltentypen ein zweites Mal scannen würde:
import pyspark.sql.functions as F
schema = """
InvoiceNo STRING, StockCode STRING, Description STRING, Quantity INT,
InvoiceDate STRING, UnitPrice DOUBLE, CustomerID INT, Country STRING
"""
orders = spark.read.csv(
"datacamp_ecommerce.csv", header=True, schema=schema, escape='"'
)
orders = orders.withColumn("InvoiceDate", F.to_timestamp("InvoiceDate", "M/d/yy H:mm"))
orders.printSchema()root
|-- InvoiceNo: string (nullable = true)
|-- StockCode: string (nullable = true)
|-- Description: string (nullable = true)
|-- Quantity: integer (nullable = true)
|-- InvoiceDate: timestamp (nullable = true)
|-- UnitPrice: double (nullable = true)
|-- CustomerID: integer (nullable = true)
|-- Country: string (nullable = true)Zwei Details in diesem Snippet sind wichtig:
escape='"'handhabt Produktnamen mit doppelten Anführungszeichen wieRECORD FRAME 7"" SINGLE SIZE. Der Standard-Escape-Charakter von Spark ist ein Backslash.- Das Datumsformat
M/d/yy H:mmpasst zu Werten wie12/1/10 8:26. Seit Spark 4.0 ist der ANSI-SQL-Modus standardmäßig aktiv, daher wirftto_timestamp()bei einem Wert, der nicht zum Muster passt, einenCANNOT_PARSE_TIMESTAMP-Fehler. VerwendeF.try_to_timestamp(), wenn du für fehlerhafte Zeilen lieberNULLerhalten möchtest.
So siehst du dir die ersten Zeilen an und zählst sie:
orders.show(5, truncate=False)
print(orders.count())+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|InvoiceNo|StockCode|Description |Quantity|InvoiceDate |UnitPrice|CustomerID|Country |
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|536365 |85123A |WHITE HANGING HEART T-LIGHT HOLDER |6 |2010-12-01 08:26:00|2.55 |17850 |United Kingdom|
|536365 |71053 |WHITE METAL LANTERN |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84406B |CREAM CUPID HEARTS COAT HANGER |8 |2010-12-01 08:26:00|2.75 |17850 |United Kingdom|
|536365 |84029G |KNITTED UNION FLAG HOT WATER BOTTLE|6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84029E |RED WOOLLY HOTTIE WHITE HEART. |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
only showing top 5 rows
541909Weitere Leseoptionen, etwa mehrere Dateien, andere Trennzeichen und den Umgang mit defekten Zeilen, findest du in unserem PySpark-CSV-Lese-Tutorial.
RDDs vs. DataFrames
RDDs und DataFrames sind PySparks zwei Repräsentationen verteilter Daten – und für fast allen neuen Code sind DataFrames die richtige Wahl.
| Abstraktion | Was es ist | Wann verwenden |
|---|---|---|
| RDD (Resilient Distributed Dataset) | Niedrigstufige, unveränderliche Sammlung beliebiger Python-Objekte, in Partitionen aufgeteilt | Unstrukturierte Daten oder wenn du feinkörnige Kontrolle über die Partitionierung brauchst |
| DataFrame | Verteilte Tabelle mit benannten, typisierten Spalten, ähnlich einem pandas DataFrame | Analyse, SQL-Abfragen, ETL und Machine Learning |
Hier dieselbe Aggregation – Gesamtmenge pro Land – in beiden Varianten:
sales = [("United Kingdom", 6), ("France", 24), ("United Kingdom", 8)]
# RDD: Du schreibst die Logik mit Python-Funktionen
rdd = spark.sparkContext.parallelize(sales)
print(rdd.reduceByKey(lambda a, b: a + b).collect())
# DataFrame: Du deklarierst das Ergebnis, und Spark plant die Berechnung
sales_df = spark.createDataFrame(sales, ["country", "quantity"])
sales_df.groupBy("country").sum("quantity").show()[('France', 24), ('United Kingdom', 14)]
+--------------+-------------+
| country|sum(quantity)|
+--------------+-------------+
|United Kingdom| 14|
| France| 24|
+--------------+-------------+Die RDD-Version führt deine Lambda in Python-Worker-Prozessen aus. Die DataFrame-Version läuft durch den Catalyst-Optimizer von Spark, der die Abfrage in einen effizienten Plan umschreibt, der innerhalb der JVM läuft – DataFrame-Code ist daher meist ohne Tuning schneller. Der Rest dieses Tutorials nutzt DataFrames.
Lazy Evaluation: Transformationen vs. Actions
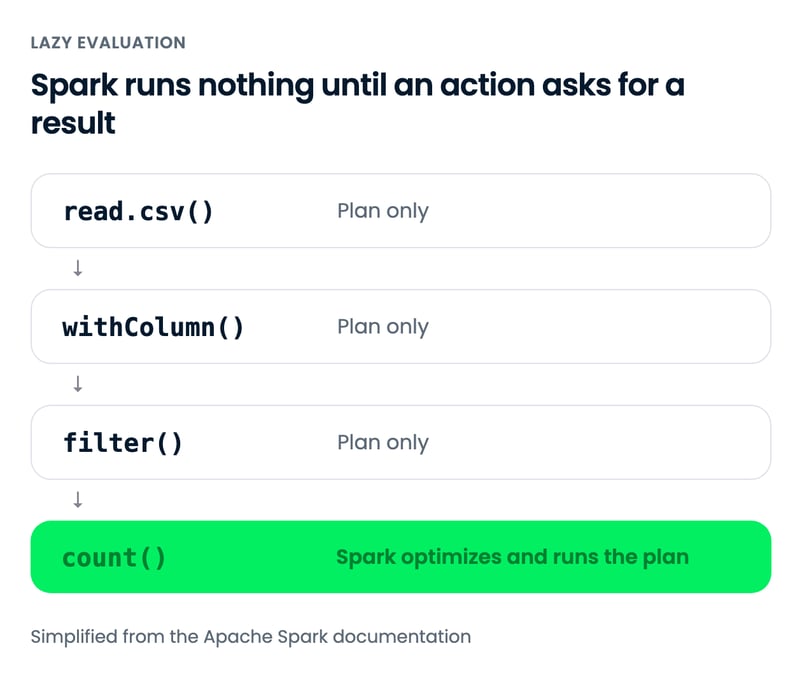
Lazy Evaluation bedeutet, dass Spark eine Transformation beim Aufruf nicht ausführt, sondern den Schritt im Plan vormerkt und den gesamten Plan erst ausführt, wenn eine Action ein Ergebnis verlangt.
| Transformationen | Actions | |
|---|---|---|
| Was sie tun | Beschreiben ein neues DataFrame | Liefern ein Ergebnis zurück oder schreiben Daten |
| Wann sie laufen | Niemals allein | Sofort, und lösen alle ausstehenden Transformationen aus |
| Beispiele | select(), filter(), withColumn(), groupBy(), join() | show(), count(), collect(), toPandas(), write |
Der folgende Filter kehrt sofort zurück, obwohl der Datensatz über eine halbe Million Zeilen hat, weil noch nichts gelesen wurde. Erst count() startet einen Job:
uk_orders = orders.filter(F.col("Country") == "United Kingdom") # Transformation: noch kein Job
print(uk_orders.count()) # Action: Spark liest jetzt die Datei495478Durch das Warten bis zur Action kann Spark die gesamte Kette auf einmal optimieren. explain() druckt den gewählten physischen Plan (hier gekürzt):
uk_orders.explain()== Physical Plan ==
*(1) Project [InvoiceNo#0, StockCode#1, ...]
+- *(1) Filter (isnotnull(Country#7) AND (Country#7 = United Kingdom))
+- FileScan csv [...] PushedFilters: [IsNotNull(Country), EqualTo(Country,United Kingdom)], ...Der Eintrag PushedFilters zeigt, dass Spark den Länderfilter in den Dateiscan hineinschiebt, sodass Zeilen anderer Länder bereits beim Lesen der CSV verworfen werden. Eine praktische Folge: Ein Datenfehler innerhalb einer Transformation, etwa ein Datum, das im ANSI-Modus nicht geparst werden kann, zeigt sich erst bei der nächsten Action – ein paar Zeilen später.
Häufige DataFrame-Operationen
Der Großteil von PySpark-Code ist eine Kette aus fünf DataFrame-Operationen: select(), filter(), withColumn(), groupBy() und join(). Jede gibt ein neues DataFrame zurück, daher kannst du sie beliebig verketten.
Spalten mit select() auswählen
select() gibt ein DataFrame nur mit den benannten Spalten zurück:
orders.select("InvoiceNo", "Description", "Quantity", "UnitPrice").show(3, truncate=False)+---------+----------------------------------+--------+---------+
|InvoiceNo|Description |Quantity|UnitPrice|
+---------+----------------------------------+--------+---------+
|536365 |WHITE HANGING HEART T-LIGHT HOLDER|6 |2.55 |
|536365 |WHITE METAL LANTERN |6 |3.39 |
|536365 |CREAM CUPID HEARTS COAT HANGER |8 |2.75 |
+---------+----------------------------------+--------+---------+
only showing top 3 rowsZeilen mit filter() filtern
filter() behält Zeilen, die eine Bedingung erfüllen. Dieser Datensatz mischt Verkäufe mit Stornos (Rechnungsnummern beginnend mit "C"), negativen Mengen und Zeilen ohne Kunde – ich behalte nur gültige Verkäufe:
sales_only = orders.filter(
(F.col("Quantity") > 0)
& (F.col("UnitPrice") > 0)
& F.col("CustomerID").isNotNull()
& ~F.col("InvoiceNo").startswith("C")
)
print(sales_only.count())397884Kombiniere Bedingungen mit & (und), | (oder) und ~ (nicht) und klammere jede ein, da Python-Operatorpräzedenz sonst & vor > auswertet. Unser PySpark-Filter-Tutorial zeigt weitere Muster.
Spalten mit withColumn() hinzufügen
withColumn() fügt eine Spalte hinzu oder ersetzt eine gleichnamige. Hier berechnet es den Zeilenwert:
sales_only = sales_only.withColumn("TotalAmount", F.round(F.col("Quantity") * F.col("UnitPrice"), 2))
sales_only.select("InvoiceNo", "Quantity", "UnitPrice", "TotalAmount").show(3)+---------+--------+---------+-----------+
|InvoiceNo|Quantity|UnitPrice|TotalAmount|
+---------+--------+---------+-----------+
| 536365| 6| 2.55| 15.3|
| 536365| 6| 3.39| 20.34|
| 536365| 8| 2.75| 22.0|
+---------+--------+---------+-----------+
only showing top 3 rowsSieh dir für bedingte Spalten mit F.when() unser PySpark-withColumn()-Tutorial an.
Aggregieren mit groupBy() und agg()
groupBy() gruppiert Zeilen nach einer oder mehreren Spalten, und agg() berechnet eine oder mehrere Kennzahlen pro Gruppe. Welche Länder bringen den meisten Umsatz?
country_revenue = (
sales_only.groupBy("Country")
.agg(
F.count_distinct("CustomerID").alias("customers"),
F.round(F.sum("TotalAmount"), 2).alias("revenue"),
)
.orderBy(F.desc("revenue"))
)
country_revenue.show(5)+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+
only showing top 5 rowsDas Vereinigte Königreich dominiert – erwartbar bei einem britischen Händler. Interessanter sind die Niederlande und Irland (als EIRE gelistet): 9 bzw. 3 Kunden geben mehr aus als Deutschlands 94 – das deutet auf Großabnehmer hin.
Beachte, dass ich das Functions-Modul als F importiere statt from pyspark.sql.functions import *, was Pythons eingebaute sum(), min() und max() überschattet. Seit PySpark 4.0 zeigt der Wildcard-Import zudem die alten CamelCase-Namen wie countDistinct nicht mehr an.
Unser PySpark-groupBy-Tutorial geht tiefer auf Aggregationen ein.
DataFrames mit join() verknüpfen
join() kombiniert zwei DataFrames über einen gemeinsamen Schlüssel. Um jedes Land mit einer Region zu labeln, verknüpfe ich eine kleine Lookup-Tabelle, die Australien absichtlich auslässt:
regions = spark.createDataFrame(
[("United Kingdom", "UK"), ("Netherlands", "EU"), ("EIRE", "EU"),
("Germany", "EU"), ("France", "EU")],
["Country", "region"],
)
country_revenue.join(regions, on="Country", how="left").orderBy(F.desc("revenue")).show(6)+--------------+---------+----------+------+
| Country|customers| revenue|region|
+--------------+---------+----------+------+
|United Kingdom| 3920|7308391.55| UK|
| Netherlands| 9| 285446.34| EU|
| EIRE| 3| 265545.9| EU|
| Germany| 94| 228867.14| EU|
| France| 87| 209024.05| EU|
| Australia| 9| 138521.31| NULL|
+--------------+---------+----------+------+
only showing top 6 rowsEin Left Join behält jede Zeile aus dem linken DataFrame und füllt fehlende Treffer mit NULL – deshalb bleibt Australien im Ergebnis. Ein Inner Join (how="inner", Standard) würde es entfernen. Unser PySpark-Joins-Tutorial vergleicht alle Join-Typen und ihre Performance.
Spark SQL in PySpark
Mit Spark SQL kannst du ein DataFrame per Standard-SQL abfragen, indem du es als temporäre View registrierst. Diese Abfrage reproduziert die Ländertabelle aus dem groupBy-Abschnitt:
sales_only.createOrReplaceTempView("sales")
spark.sql("""
SELECT Country,
COUNT(DISTINCT CustomerID) AS customers,
ROUND(SUM(TotalAmount), 2) AS revenue
FROM sales
GROUP BY Country
ORDER BY revenue DESC
LIMIT 5
""").show()+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+Beide Varianten kompilieren in denselben optimierten Plan – keine ist schneller. Ich nutze SQL für lange Aggregationen, die Analysten lesen, und die DataFrame-API, wenn ich Python-Logik um die Abfrage brauche, etwa Filter in einer Schleife. spark.sql() gibt ein DataFrame zurück, sodass du beide frei mischen kannst.
Die temporäre View lebt bis zum Stopp der SparkSession.
Machine Learning mit PySpark: Ein K‑Means-Beispiel
PySparks Modul pyspark.ml trainiert Modelle auf DataFrames, und eine Pipeline verknüpft die Feature-Aufbereitung und das Modell zu einem Objekt, das du fitten und wiederverwenden kannst. Als Beispiel segmentiere ich die Kundschaft des Händlers mit K‑Means‑Clustering anhand von Recency, Frequency und Monetary Value (RFM) – ein Standard im Marketing:
- Recency: Tage seit dem letzten Kauf
- Frequency: Anzahl unterschiedlicher Rechnungen
- Monetary: Gesamtumsatz
RFM-Features mit groupBy() bauen
Ein groupBy() über das bereinigte sales_only-DataFrame erzeugt alle drei Features. Recency messen wir ab dem Tag nach der letzten Rechnung im Datensatz:
snapshot = sales_only.agg(F.date_add(F.max("InvoiceDate"), 1)).first()[0]
rfm = sales_only.groupBy("CustomerID").agg(
F.datediff(F.lit(snapshot), F.max("InvoiceDate")).alias("recency"),
F.count_distinct("InvoiceNo").alias("frequency"),
F.round(F.sum("TotalAmount"), 2).alias("monetary"),
)
rfm.describe("recency", "frequency", "monetary").show()+-------+------------------+-----------------+------------------+
|summary| recency| frequency| monetary|
+-------+------------------+-----------------+------------------+
| count| 4338| 4338| 4338|
| mean| 93.05947441217151|4.272014753342554|2054.2664591977896|
| stddev|100.01226424171826|7.697997826095038| 8989.230441421178|
| min| 1| 1| 3.75|
| max| 374| 209| 280206.02|
+-------+------------------+-----------------+------------------+Sieh auf die Spalte Monetary: ein Mittelwert von rund £2.054, eine Standardabweichung über dem Vierfachen davon und ein Maximum über £280.000. K‑Means misst euklidische Distanzen, daher würden wenige Großkunden die Cluster dominieren. Ein Log auf jedem Feature komprimiert diesen langen Schwanz.
Skalieren und Clustern in einer Pipeline
Die Pipeline hat drei Stufen: VectorAssembler packt die Features in die einzelne Vektorspalte, die pyspark.ml-Modelle erwarten, StandardScaler bringt sie auf dieselbe Skala, und KMeans clustert sie. Ich fitte k = 2 bis 6 und bewerte jedes Modell mit dem Silhouetten-Score, der von -1 bis 1 reicht – je höher, desto klarer getrennte Cluster:
from pyspark.ml import Pipeline
from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.feature import StandardScaler, VectorAssembler
rfm_log = rfm.select(
"CustomerID",
"recency", "frequency", "monetary",
F.log1p("recency").alias("log_recency"),
F.log1p("frequency").alias("log_frequency"),
F.log1p("monetary").alias("log_monetary"),
).cache()
assembler = VectorAssembler(
inputCols=["log_recency", "log_frequency", "log_monetary"], outputCol="features_raw"
)
scaler = StandardScaler(
inputCol="features_raw", outputCol="features", withMean=True, withStd=True
)
evaluator = ClusteringEvaluator(featuresCol="features", metricName="silhouette")
for k in range(2, 7):
kmeans = KMeans(featuresCol="features", k=k, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
score = evaluator.evaluate(model.transform(rfm_log))
print(f"k={k} silhouette={score:.3f}")k=2 silhouette=0.624
k=3 silhouette=0.502
k=4 silhouette=0.502
k=5 silhouette=0.478
k=6 silhouette=0.470.cache() hält rfm_log im Speicher, da jeder Fit und jede Bewertung in der Schleife es erneut liest; ohne Caching würde Spark die RFM-Tabelle bei jedem Fit erneut aus der CSV berechnen.
k wählen und Segmente lesen
Der Silhouetten-Score ist bei k = 2 am höchsten, aber zwei Segmente trennen meist nur aktive von inaktiven Kundinnen und Kunden – damit kann ein Marketingteam wenig anfangen. k = 4 erzielt denselben Wert wie k = 3 und splittet die aktiven in Großabnehmer und Newcomer, daher nutze ich es und profile jedes Cluster:
kmeans = KMeans(featuresCol="features", k=4, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
segments = model.transform(rfm_log)
(segments.groupBy("prediction")
.agg(
F.count("*").alias("customers"),
F.round(F.avg("recency"), 1).alias("avg_recency"),
F.round(F.avg("frequency"), 1).alias("avg_frequency"),
F.round(F.avg("monetary"), 1).alias("avg_monetary"),
)
.orderBy("prediction")
.show())+----------+---------+-----------+-------------+------------+
|prediction|customers|avg_recency|avg_frequency|avg_monetary|
+----------+---------+-----------+-------------+------------+
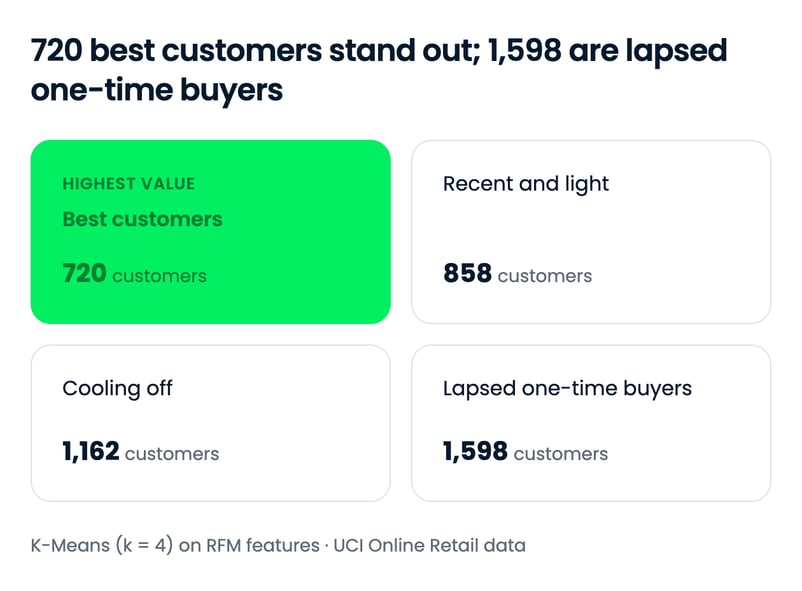
| 0| 1598| 181.2| 1.3| 326.2|
| 1| 720| 13.2| 13.7| 8072.7|
| 2| 1162| 77.1| 3.9| 1765.2|
| 3| 858| 17.4| 2.3| 613.7|
+----------+---------+-----------+-------------+------------+Die vier Segmente lassen sich klar lesen:
- Cluster 1, beste Kundschaft (720): Im Schnitt innerhalb der letzten zwei Wochen gekauft, rund 14 Bestellungen und über £8.000 ausgegeben. Hier greifen Retention- und Loyalty-Angebote.
- Cluster 3, frisch und leicht (858): Aktiv in den letzten drei Wochen, aber nur etwa zwei Bestellungen. Viele sind vermutlich Neukunden, die sich Richtung zweite und dritte Bestellung entwickeln lassen.
- Cluster 2, am Abkühlen (1.162): Mittleres Ausgabenniveau, aber rund elf Wochen seit dem letzten Kauf. Eine Win‑Back‑Kampagne hat hier die besten Chancen.
- Cluster 0, inaktive Einmalkäufer (1.598): Meist eine einzelne Bestellung, etwa £326, vor gut sechs Monaten. Die größte Gruppe und die mit dem geringsten Wert.
Cluster-Nummern sind willkürliche Labels, und ein anderer Seed kann sie umsortieren – profile die Cluster also immer, bevor du sie benennst. Wie K‑Means seine Zentren findet, erklärt unsere Einführung in k‑means clustering, und die pyspark.ml API-Referenz listet alle Modelle und Transformer. Unser Kurs Machine Learning with PySpark behandelt Klassifikation, Regression und Modell-Tuning mit Pipelines.
Fazit
PySpark lässt sich auf wenige Ideen herunterbrechen: eine SparkSession zum Start, DataFrames für fast alles, lazy Transformationen, die erst bei einer Action laufen, und die Wahl, jede Abfrage in Python oder SQL zu schreiben. Alles in diesem Tutorial lief im lokalen Modus auf einem Laptop – derselbe Code läuft unverändert im Cluster.
Eine Datei mit 541.909 Zeilen braucht keinen Cluster, und pandas hätte das geschafft. Das war Absicht, denn die Gewohnheiten, die bei großen Daten zählen (explizite Schemas, früh filtern, Wiederverwendetes cachen und explain() prüfen), baut man leichter auf Daten auf, die man inspizieren kann.
Von hier aus sind das je nach Ziel gute nächste Schritte:
- Übe die DataFrame-API mit Aufgaben: Introduction to PySpark
- Echte, unordentliche Daten aufbereiten: Cleaning Data with PySpark
- Syntax griffbereit behalten: unser PySpark-Cheat‑Sheet
- Für Bewerbungsgespräche vorbereiten: Top PySpark Interviewfragen
Wenn du weiter einsteigen willst, empfehle ich unseren Lernpfad Big Data with PySpark. Er behandelt Datenmanagement, Feature Engineering, Machine-Learning-Pipelines und Empfehlungssysteme Schritt für Schritt. Für Teams bietet DataCamp for Business Lernpfade für Data-Engineering-Rollen.
PySpark FAQs
Welche Voraussetzungen brauche ich, um PySpark zu lernen?
PySpark 4.3 benötigt Python 3.11 oder neuer und Java 17 oder neuer (Spark 4.3 läuft auf Java 17, 21 und 25), mit JAVA_HOME, das auf deine Java-Installation zeigt. Du solltest dich mit grundlegender Python-Programmierung wohlfühlen; Erfahrung mit pandas DataFrames hilft, da die PySpark-DataFrame-API ähnliche Konzepte nutzt. Vorkenntnisse in verteilten Systemen brauchst du nicht.
Ist PySpark schneller als pandas?
Nicht bei kleinen Daten. pandas läuft im selben Prozess ohne Startkosten, während PySpark ein paar Sekunden für JVM-Start und Task-Scheduling braucht – daher gewinnt pandas meist bei Daten, die bequem in den Speicher passen. PySpark ist schneller, sobald die Arbeit den Speicher oder die CPU einer einzelnen Maschine übersteigt, weil Partitionen parallel über Kerne oder Clusterknoten verarbeitet werden.
Was ist der Unterschied zwischen RDDs und DataFrames in PySpark?
Ein RDD (Resilient Distributed Dataset) ist PySparks niedrigstufige Struktur: eine verteilte Sammlung beliebiger Python-Objekte, die du mit eigenen Funktionen verarbeitest. Ein DataFrame organisiert Daten in benannte, typisierte Spalten wie ein pandas DataFrame, und Sparks Catalyst-Optimizer übersetzt DataFrame-Abfragen in effiziente Ausführungspläne. Nutze DataFrames für nahezu allen neuen Code und RDDs nur für unstrukturierte Daten oder feinkörnige Kontrolle über die Partitionierung.
Wie starte ich PySpark in einem Jupyter Notebook?
Installiere Java 17 oder neuer und führe dann pip install "pyspark[sql]" in der Umgebung aus, die dein Notebook nutzt. Erstelle die SparkSession in der ersten Zelle:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("MyNotebook").getOrCreate()Wenn du die lokale Einrichtung überspringen willst: DataLab und Databricks-Notebooks bringen PySpark vorinstalliert mit.
Wann sollte ich PySpark statt pandas verwenden?
Nutze PySpark, wenn deine Daten nicht in den Speicher einer Maschine passen, wenn ein Job auf einem Cluster oder einer Plattform wie Databricks laufen soll oder wenn du Pipelines baust, die über einen Laptop hinauswachsen. Für explorative Analysen auf Daten, die in den Speicher passen, ist pandas einfacher und startet sofort. Lokal geschriebener PySpark-Code läuft unverändert im Cluster – es kann also sinnvoll sein, direkt damit zu starten, wenn Skalierung absehbar ist.
Was ist Lazy Evaluation in PySpark?
Lazy Evaluation bedeutet, dass PySpark Transformationen wie filter() oder withColumn() nicht beim Aufruf ausführt. Es protokolliert sie im Plan und führt diesen erst aus, wenn eine Action wie count(), show() oder write ein Ergebnis benötigt. Das Warten erlaubt Spark, die gesamte Kette zu optimieren – etwa, indem Filter in den Dateiscan geschoben werden.
Wie führe ich SQL-Abfragen in PySpark aus?
Registriere ein DataFrame als temporäre View mit df.createOrReplaceTempView("sales") und frage es mit spark.sql("SELECT ... FROM sales") ab. Das Ergebnis ist ein reguläres DataFrame, sodass du SQL und DataFrame-Code frei mischen kannst. Beide kompilieren in denselben optimierten Plan – keiner ist schneller.
Brauche ich Hadoop, um PySpark auszuführen?
Nein. pip install pyspark bringt die Spark-Laufzeit mit, die im lokalen Modus ohne Hadoop läuft. Hadoop-Komponenten brauchst du nur, wenn du aus HDFS liest oder Spark auf einem YARN-Cluster betreibst.
Natassha ist eine Datenberaterin, die an der Schnittstelle von Datenwissenschaft und Marketing arbeitet. Sie ist davon überzeugt, dass Daten, wenn sie klug genutzt werden, Einzelpersonen und Organisationen zu enormem Wachstum inspirieren können. Als Autodidaktin liebt Natassha es, Artikel zu schreiben, die anderen Data Science-Anwärtern den Einstieg in die Branche erleichtern. Ihre Artikel auf ihrem persönlichen Blog und in externen Publikationen werden durchschnittlich 200.000 Mal pro Monat aufgerufen.






PySpark ist die Python-API für Apache Spark. Du schreibst DataFrame-Code oder SQL in Python, und Spark verteilt die Arbeit auf alle CPU-Kerne deines Laptops oder auf alle Maschinen in einem Cluster. Ich setze es ein, sobald ein Datensatz nicht mehr bequem in pandas passt oder wenn derselbe Job später ohne Umschreiben in einem Cluster laufen soll.
In diesem PySpark-Tutorial installiere ich PySpark 4.3, erstelle eine SparkSession und erkläre die zwei Konzepte, über die Anfänger am häufigsten stolpern: RDDs versus DataFrames und Lazy Evaluation. Danach gehen wir die Alltagsoperationen (select, filter, groupBy, join und Spark SQL) an einem E‑Commerce-Datensatz mit 541.909 Zeilen durch und schließen mit einem K-Means-Kundensegmentierungsmodell über die
pyspark.mlPipeline-API ab.Wenn du zu diesem Tutorial begleitete Übungen möchtest, deckt unser Kurs Introduction to PySpark dasselbe Terrain ab. Für einen längeren Lernplan sieh dir unseren Guide How to Learn PySpark From Scratch an.
TL;DR
pip install "pyspark[sql]"; PySpark 4.3 benötigt Python 3.11+ und Java 17+.SparkSession, und DataFrames (nicht RDDs) sind die Standard-API.count()odershow()ausgelöst wird.pyspark.mlPipelines verketten Feature-Aufbereitung und Modelle wie K-Means zu einem Objekt.Was ist Apache Spark?
Apache Spark ist eine Open-Source-Engine für verteilte Datenverarbeitung. Sie teilt einen Datensatz in Partitionen, verarbeitet sie parallel im Cluster und hält Zwischenergebnisse im Speicher, statt sie zwischen den Schritten auf die Festplatte zu schreiben.
Dieses In‑Memory-Design ist der Hauptgrund, warum Spark Hadoop MapReduce für die meisten Batch-Workloads abgelöst hat (den Vergleich findest du in Hadoop vs Spark). Spark startete 2009 im AMPLab der UC Berkeley, wurde 2014 ein Top-Level-Apache-Projekt und erreichte Version 4.3 am 30. Oktober 2026.
Eine Engine deckt über eingebaute Bibliotheken mehrere Workloads ab:
pyspark.ml) für verteiltes Machine LearningFür einen genaueren Blick darauf, wie Driver, Cluster Manager und Executor die Arbeit aufteilen, lies unseren Leitfaden zur Apache-Spark-Architektur.