

O que é PySpark?
PySpark é a API de Python para o Apache Spark. Seu código em Python descreve as transformações desejadas, e o engine do Spark, que roda na Java Virtual Machine (JVM), planeja e executa tudo pelo cluster. Você obtém execução distribuída do Spark sem escrever Scala ou Java.
Cientistas de dados usam PySpark para limpar e agregar grandes datasets, engenheiros de dados para pipelines de ETL, e ambos usam pyspark.ml para treinar modelos em dados que não cabem em uma única máquina. Se você já trabalha bastante com pandas, a API de DataFrame vai soar familiar.
Quando usar PySpark em vez de pandas
O PySpark compensa quando os dados ultrapassam uma única máquina; abaixo disso, o pandas costuma ser mais rápido porque não tem a sobrecarga de iniciar a JVM ou de agendar tarefas.
| Recurso | pandas | PySpark |
|---|---|---|
| Tamanho dos dados | Limitado pela RAM de uma máquina | Limitado pela soma de memória e disco do cluster |
| Execução | Ávida, majoritariamente em um único núcleo | Preguiçosa, paralela entre núcleos ou máquinas |
| Sobrecarga de início | Nenhuma | Alguns segundos para iniciar a JVM e a SparkSession |
| Dados em streaming | Não suportado | Structured Streaming |
| Machine learning | Ecossistema scikit-learn | pyspark.ml (distribuído) |
| Tolerância a falhas | Nenhuma; um crash perde o trabalho | Partições perdidas são recomputadas a partir da linhagem (lineage) |
Minha regra prática: se os dados cabem na memória com folga e o job roda em um notebook, fique no pandas. Mude para PySpark quando estiver brigando com erros de memória ou quando o job vai acabar rodando em um cluster ou plataforma como o Databricks.
Como instalar o PySpark
O PySpark instala pelo PyPI com um único comando pip, que já inclui o runtime do Spark, então você não precisa baixar Spark ou Hadoop separadamente para uso local. Antes de rodar, confira os dois pré-requisitos.
Pré-requisitos
Segundo o guia oficial de instalação, o PySpark 4.3 requer:
- Python 3.11 ou superior. O PySpark 4.3 não suporta mais Python 3.10; veja nosso guia de configuração do Python se precisar de uma versão mais nova.
- Java 17 ou superior (Spark 4.3 roda em Java 17, 21 e 25) com a variável de ambiente
JAVA_HOMEapontando para essa instalação. Nosso guia de instalação do Java explica passo a passo por sistema operacional.
Você pode checar ambos no terminal:
python3 --version # Python 3.11 ou superior
java -version # openjdk version "17" ou superiorSe você trabalha no DataLab ou no Databricks, o PySpark já está instalado e você pode ir direto para o dataset.
Instalando PySpark com pip
Eu recomendo um ambiente virtual para evitar que as dependências do PySpark conflitem com outros projetos:
python3 -m venv pyspark-env
source pyspark-env/bin/activate
pip install "pyspark[sql]" "pandas<3"
python3 -c "import pyspark; print(pyspark.__version__)"4.3.0No Windows, use python em vez de python3 e ative o ambiente com pyspark-env\Scripts\activate. O extra [sql] adiciona pandas, PyArrow e NumPy, que o PySpark usa em toPandas() e UDFs do pandas. Eu fixo pandas<3 porque o PySpark 4.3 avisa que ainda não oferece suporte completo ao pandas 3.0.
Dois erros explicam a maioria das primeiras execuções fracassadas:
JAVA_GATEWAY_EXITEDou "Unable to locate a Java Runtime": o Java está faltando ou oJAVA_HOMEnão está configurado.PYTHON_VERSION_MISMATCH: os processos workers do Spark pegaram um Python diferente do seu script. DefinaPYSPARK_PYTHONpara o interpretador do seu ambiente, por exemploexport PYSPARK_PYTHON=$(which python).
Para passos específicos por sistema operacional, incluindo Windows, veja nosso guia de instalação do PySpark.
Baixando o dataset
Os exemplos usam um dataset de e-commerce com 541.909 transações de um varejista online do Reino Unido, cobrindo dezembro de 2010 a dezembro de 2011. Cada linha é um item de uma fatura, com 8 colunas:
InvoiceNo: número da fatura (números começando com "C" são cancelamentos)StockCodeeDescription: código e nome do produtoQuantityeUnitPrice: unidades compradas e preço unitário, em libras esterlinasInvoiceDate: data e hora da compraCustomerID: identificador do cliente (ausente em algumas linhas)Country: país do cliente
Você pode baixar como datacamp_ecommerce.csv na página de datasets do DataLab. É o Online Retail dataset do UCI Machine Learning Repository, então você também pode gerar o mesmo arquivo a partir da fonte pública (requer pip install openpyxl):
import io
import urllib.request
import zipfile
import pandas as pd
url = "https://archive.ics.uci.edu/static/public/352/online+retail.zip"
with urllib.request.urlopen(url) as response:
archive = zipfile.ZipFile(io.BytesIO(response.read()))
retail = pd.read_excel(
archive.open("Online Retail.xlsx"),
dtype={"InvoiceNo": str, "StockCode": str, "CustomerID": "Int64"},
)
# Igualar o formato de data do arquivo do DataLab, ex.: 12/1/10 8:26
retail["InvoiceDate"] = retail["InvoiceDate"].map(
lambda ts: f"{ts.month}/{ts.day}/{ts:%y} {ts.hour}:{ts:%M}"
)
retail.to_csv("datacamp_ecommerce.csv", index=False)Ler o arquivo Excel de 23 MB leva cerca de um minuto. Salve o CSV na pasta de onde você vai rodar o restante do código.
Criando uma SparkSession
Uma SparkSession é a porta de entrada para todo programa em PySpark: ela conecta seu código Python ao engine do Spark e cria DataFrames. Você cria uma por aplicação usando o padrão builder:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("PySparkTutorial").getOrCreate()
print(spark.version)4.3.0getOrCreate() retorna a sessão em execução se já existir, então é seguro chamar duas vezes em um notebook. Iniciado de um processo Python comum, o Spark roda em modo local (local[*]), usando todos os núcleos de CPU da sua máquina como workers, e serve a UI do Spark em http://localhost:4040 para acompanhar jobs. Quando terminar, spark.stop() libera os recursos.
Carregando o dataset de e-commerce
Com a sessão ativa, podemos ler o CSV em um DataFrame. Eu passo um schema explícito em vez de inferSchema=True, que faz o Spark varrer o arquivo inteiro uma vez extra só para adivinhar os tipos de coluna:
import pyspark.sql.functions as F
schema = """
InvoiceNo STRING, StockCode STRING, Description STRING, Quantity INT,
InvoiceDate STRING, UnitPrice DOUBLE, CustomerID INT, Country STRING
"""
orders = spark.read.csv(
"datacamp_ecommerce.csv", header=True, schema=schema, escape='"'
)
orders = orders.withColumn("InvoiceDate", F.to_timestamp("InvoiceDate", "M/d/yy H:mm"))
orders.printSchema()root
|-- InvoiceNo: string (nullable = true)
|-- StockCode: string (nullable = true)
|-- Description: string (nullable = true)
|-- Quantity: integer (nullable = true)
|-- InvoiceDate: timestamp (nullable = true)
|-- UnitPrice: double (nullable = true)
|-- CustomerID: integer (nullable = true)
|-- Country: string (nullable = true)Dois detalhes nesse trecho importam:
escape='"'lida com nomes de produto que contêm aspas duplas repetidas, comoRECORD FRAME 7"" SINGLE SIZE. O caractere de escape padrão do Spark é a barra invertida.- O padrão de data
M/d/yy H:mmcorresponde a valores como12/1/10 8:26. Desde o Spark 4.0, o modo ANSI SQL vem ativado por padrão, entãoto_timestamp()lança um erroCANNOT_PARSE_TIMESTAMPem valores que não casam com o padrão. UseF.try_to_timestamp()se preferir receberNULLnas linhas com erro.
Para ver as primeiras linhas e contá-las:
orders.show(5, truncate=False)
print(orders.count())+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|InvoiceNo|StockCode|Description |Quantity|InvoiceDate |UnitPrice|CustomerID|Country |
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|536365 |85123A |WHITE HANGING HEART T-LIGHT HOLDER |6 |2010-12-01 08:26:00|2.55 |17850 |United Kingdom|
|536365 |71053 |WHITE METAL LANTERN |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84406B |CREAM CUPID HEARTS COAT HANGER |8 |2010-12-01 08:26:00|2.75 |17850 |United Kingdom|
|536365 |84029G |KNITTED UNION FLAG HOT WATER BOTTLE|6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84029E |RED WOOLLY HOTTIE WHITE HEART. |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
only showing top 5 rows
541909Para mais opções de leitura, como múltiplos arquivos, delimitadores e registros corrompidos, veja nosso tutorial de leitura de CSV no PySpark.
RDDs vs. DataFrames
RDDs e DataFrames são as duas formas de representar dados distribuídos no PySpark, e para praticamente todo código novo, DataFrames são a escolha certa.
| Abstração | O que é | Quando usar |
|---|---|---|
| RDD (Resilient Distributed Dataset) | Estrutura de baixo nível, imutável, de objetos Python arbitrários, dividida em partições | Dados não estruturados ou quando você precisa de controle fino sobre a partição |
| DataFrame | Tabela distribuída com colunas nomeadas e tipadas, semelhante a um DataFrame do pandas | Análises, consultas SQL, ETL e machine learning |
Aqui está a mesma agregação, quantidade total por país, escrita das duas formas:
sales = [("United Kingdom", 6), ("France", 24), ("United Kingdom", 8)]
# RDD: você escreve a lógica com funções Python
rdd = spark.sparkContext.parallelize(sales)
print(rdd.reduceByKey(lambda a, b: a + b).collect())
# DataFrame: você declara o resultado e o Spark planeja como computá-lo
sales_df = spark.createDataFrame(sales, ["country", "quantity"])
sales_df.groupBy("country").sum("quantity").show()[('France', 24), ('United Kingdom', 14)]
+--------------+-------------+
| country|sum(quantity)|
+--------------+-------------+
|United Kingdom| 14|
| France| 24|
+--------------+-------------+A versão com RDD roda sua lambda em processos workers de Python. A versão com DataFrame passa pelo otimizador Catalyst do Spark, que reescreve a consulta em um plano eficiente que roda dentro da JVM, então código com DataFrame costuma ser mais rápido sem ajustes. O resto deste tutorial usa DataFrames.
Avaliação preguiçosa: transformações vs. ações
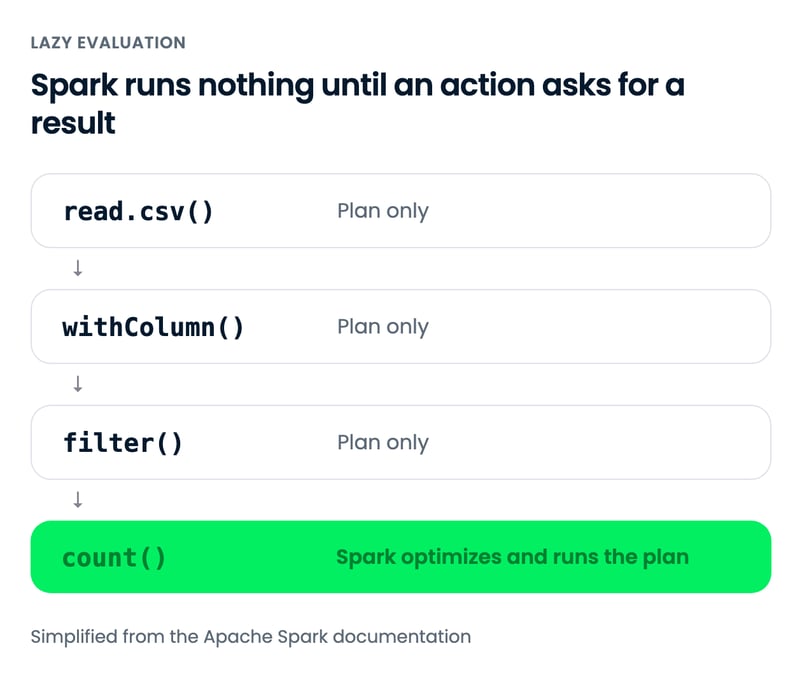
Avaliação preguiçosa significa que o Spark não executa uma transformação quando você a chama; ele registra a etapa em um plano e só roda o plano inteiro quando uma ação pede um resultado.
| Transformações | Ações | |
|---|---|---|
| O que fazem | Descrevem um novo DataFrame | Retornam um resultado ou escrevem dados |
| Quando rodam | Nunca sozinhas | Imediatamente, disparando todas as transformações pendentes |
| Exemplos | select(), filter(), withColumn(), groupBy(), join() | show(), count(), collect(), toPandas(), write |
O filtro abaixo retorna instantaneamente, mesmo com mais de meio milhão de linhas, porque nada foi lido ainda. A chamada count() é o que inicia um job:
uk_orders = orders.filter(F.col("Country") == "United Kingdom") # transformação: ainda sem job
print(uk_orders.count()) # ação: o Spark lê o arquivo agora495478Esperar até uma ação permite ao Spark otimizar toda a cadeia de uma vez. explain() imprime o plano físico escolhido (trecho reduzido):
uk_orders.explain()== Physical Plan ==
*(1) Project [InvoiceNo#0, StockCode#1, ...]
+- *(1) Filter (isnotnull(Country#7) AND (Country#7 = United Kingdom))
+- FileScan csv [...] PushedFilters: [IsNotNull(Country), EqualTo(Country,United Kingdom)], ...A entrada PushedFilters mostra o Spark empurrando o filtro de país para a leitura do arquivo, então linhas de outros países são descartadas conforme o CSV é lido. Uma consequência prática: um erro de dados dentro de uma transformação, como uma data que falha ao converter no modo ANSI, só aparece quando a próxima ação roda, algumas linhas depois.
Operações comuns com DataFrame
A maior parte do código em PySpark é uma cadeia de cinco operações de DataFrame: select(), filter(), withColumn(), groupBy() e join(). Cada uma retorna um novo DataFrame, então você pode encadeá-las em qualquer ordem.
Selecionando colunas com select()
select() retorna um DataFrame só com as colunas nomeadas:
orders.select("InvoiceNo", "Description", "Quantity", "UnitPrice").show(3, truncate=False)+---------+----------------------------------+--------+---------+
|InvoiceNo|Description |Quantity|UnitPrice|
+---------+----------------------------------+--------+---------+
|536365 |WHITE HANGING HEART T-LIGHT HOLDER|6 |2.55 |
|536365 |WHITE METAL LANTERN |6 |3.39 |
|536365 |CREAM CUPID HEARTS COAT HANGER |8 |2.75 |
+---------+----------------------------------+--------+---------+
only showing top 3 rowsFiltrando linhas com filter()
filter() mantém as linhas que atendem a uma condição. Este dataset mistura vendas com cancelamentos (faturas que começam com "C"), quantidades negativas e linhas sem cliente, então vou manter apenas vendas válidas:
sales_only = orders.filter(
(F.col("Quantity") > 0)
& (F.col("UnitPrice") > 0)
& F.col("CustomerID").isNotNull()
& ~F.col("InvoiceNo").startswith("C")
)
print(sales_only.count())397884Combine condições com & (e), | (ou) e ~ (não) e envolva cada uma entre parênteses, pois a precedência de operadores do Python avaliaria & antes de >. Nosso tutorial de filter no PySpark cobre mais padrões.
Adicionando colunas com withColumn()
withColumn() adiciona uma coluna ou substitui uma com o mesmo nome. Aqui, ele calcula o valor de cada linha:
sales_only = sales_only.withColumn("TotalAmount", F.round(F.col("Quantity") * F.col("UnitPrice"), 2))
sales_only.select("InvoiceNo", "Quantity", "UnitPrice", "TotalAmount").show(3)+---------+--------+---------+-----------+
|InvoiceNo|Quantity|UnitPrice|TotalAmount|
+---------+--------+---------+-----------+
| 536365| 6| 2.55| 15.3|
| 536365| 6| 3.39| 20.34|
| 536365| 8| 2.75| 22.0|
+---------+--------+---------+-----------+
only showing top 3 rowsVeja nosso tutorial de withColumn() no PySpark para colunas condicionais com F.when().
Agregando com groupBy() e agg()
groupBy() agrupa linhas por uma ou mais colunas, e agg() calcula um ou mais resumos por grupo. Quais países geram mais receita?
country_revenue = (
sales_only.groupBy("Country")
.agg(
F.count_distinct("CustomerID").alias("customers"),
F.round(F.sum("TotalAmount"), 2).alias("revenue"),
)
.orderBy(F.desc("revenue"))
)
country_revenue.show(5)+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+
only showing top 5 rowsO Reino Unido domina, como esperado para um varejista britânico. As linhas mais interessantes são Holanda e Irlanda (listada como EIRE): 9 e 3 clientes gastam mais do que os 94 da Alemanha, o que sugere compradores atacadistas.
Note que eu importo o módulo de funções como F em vez de usar from pyspark.sql.functions import *, que sombreia os sum(), min() e max() nativos do Python. Desde o PySpark 4.0, esse import coringa também não expõe mais o nome antigo em camelCase countDistinct.
Nosso tutorial de groupBy no PySpark aprofunda as agregações.
Fazendo joins com join()
join() combina dois DataFrames por uma chave compartilhada. Para rotular cada país com uma região, vou juntar uma pequena tabela de referência que, de propósito, deixa a Austrália de fora:
regions = spark.createDataFrame(
[("United Kingdom", "UK"), ("Netherlands", "EU"), ("EIRE", "EU"),
("Germany", "EU"), ("France", "EU")],
["Country", "region"],
)
country_revenue.join(regions, on="Country", how="left").orderBy(F.desc("revenue")).show(6)+--------------+---------+----------+------+
| Country|customers| revenue|region|
+--------------+---------+----------+------+
|United Kingdom| 3920|7308391.55| UK|
| Netherlands| 9| 285446.34| EU|
| EIRE| 3| 265545.9| EU|
| Germany| 94| 228867.14| EU|
| France| 87| 209024.05| EU|
| Australia| 9| 138521.31| NULL|
+--------------+---------+----------+------+
only showing top 6 rowsUm left join mantém todas as linhas do DataFrame da esquerda e preenche correspondências ausentes com NULL, por isso a Austrália permanece no resultado. Um inner join (how="inner", padrão) a removeria. Nosso tutorial de joins no PySpark compara todos os tipos de join e seu desempenho.
Spark SQL no PySpark
O Spark SQL permite consultar um DataFrame com SQL padrão registrando-o como uma view temporária. Esta consulta reproduz a tabela de receita por país da seção de groupBy:
sales_only.createOrReplaceTempView("sales")
spark.sql("""
SELECT Country,
COUNT(DISTINCT CustomerID) AS customers,
ROUND(SUM(TotalAmount), 2) AS revenue
FROM sales
GROUP BY Country
ORDER BY revenue DESC
LIMIT 5
""").show()+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+Ambas as versões compilam para o mesmo plano otimizado, então nenhuma é mais rápida. Eu uso SQL para agregações longas que analistas vão ler, e a API de DataFrame quando preciso de lógica Python em volta da consulta, como construir filtros em um loop. spark.sql() retorna um DataFrame, então você pode misturar as duas livremente.
A view temporária dura até a SparkSession ser encerrada.
Machine learning com PySpark: um exemplo de K-Means
O módulo pyspark.ml do PySpark treina modelos em DataFrames, e uma Pipeline encadeia o preparo de features e o modelo em um único objeto que você pode ajustar e reutilizar. Para demonstrar, vou segmentar os clientes do varejista com clustering K-Means usando recência, frequência e valor monetário (RFM), uma segmentação clássica de marketing:
- Recência: dias desde a última compra do cliente
- Frequência: número de faturas distintas
- Monetário: total gasto
Construindo features RFM com groupBy()
Um único groupBy() sobre o sales_only limpo produz as 3 features. A recência é medida a partir do dia seguinte à última fatura nos dados:
snapshot = sales_only.agg(F.date_add(F.max("InvoiceDate"), 1)).first()[0]
rfm = sales_only.groupBy("CustomerID").agg(
F.datediff(F.lit(snapshot), F.max("InvoiceDate")).alias("recency"),
F.count_distinct("InvoiceNo").alias("frequency"),
F.round(F.sum("TotalAmount"), 2).alias("monetary"),
)
rfm.describe("recency", "frequency", "monetary").show()+-------+------------------+-----------------+------------------+
|summary| recency| frequency| monetary|
+-------+------------------+-----------------+------------------+
| count| 4338| 4338| 4338|
| mean| 93.05947441217151|4.272014753342554|2054.2664591977896|
| stddev|100.01226424171826|7.697997826095038| 8989.230441421178|
| min| 1| 1| 3.75|
| max| 374| 209| 280206.02|
+-------+------------------+-----------------+------------------+Olhe a coluna monetária: média perto de £2.054, desvio-padrão mais de quatro vezes isso e máximo acima de £280.000. O K-Means mede distância euclidiana, então alguns grandes gastadores dominariam os clusters. Tirar o log de cada feature primeiro comprime essa cauda longa.
Escalonando e clusterizando em uma Pipeline
A Pipeline tem 3 estágios: VectorAssembler empacota as features na única coluna vetorial que os modelos do pyspark.ml esperam, StandardScaler coloca tudo na mesma escala, e KMeans faz a clusterização. Eu ajusto para k = 2 a 6 e avalio cada modelo com o silhouette score, que vai de -1 a 1, sendo melhor quanto mais alto:
from pyspark.ml import Pipeline
from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.feature import StandardScaler, VectorAssembler
rfm_log = rfm.select(
"CustomerID",
"recency", "frequency", "monetary",
F.log1p("recency").alias("log_recency"),
F.log1p("frequency").alias("log_frequency"),
F.log1p("monetary").alias("log_monetary"),
).cache()
assembler = VectorAssembler(
inputCols=["log_recency", "log_frequency", "log_monetary"], outputCol="features_raw"
)
scaler = StandardScaler(
inputCol="features_raw", outputCol="features", withMean=True, withStd=True
)
evaluator = ClusteringEvaluator(featuresCol="features", metricName="silhouette")
for k in range(2, 7):
kmeans = KMeans(featuresCol="features", k=k, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
score = evaluator.evaluate(model.transform(rfm_log))
print(f"k={k} silhouette={score:.3f}")k=2 silhouette=0.624
k=3 silhouette=0.502
k=4 silhouette=0.502
k=5 silhouette=0.478
k=6 silhouette=0.470.cache() mantém rfm_log em memória, porque cada ajuste e avaliação no loop o lê novamente; sem isso, o Spark recomputaria a tabela RFM a partir do CSV a cada ajuste.
Escolhendo k e lendo os segmentos
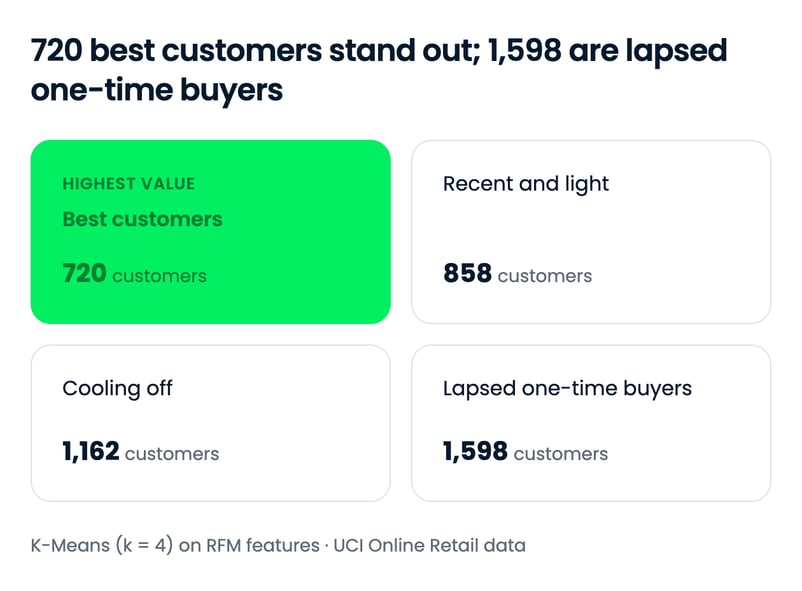
O silhouette atinge o pico em k = 2, mas 2 segmentos geralmente separam clientes ativos dos inativos, o que o time de marketing pouco aproveita. k = 4 pontua igual a k = 3 e divide os clientes ativos entre grandes gastadores e recém-chegados, então vou usá-lo e fazer o perfil de cada cluster:
kmeans = KMeans(featuresCol="features", k=4, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
segments = model.transform(rfm_log)
(segments.groupBy("prediction")
.agg(
F.count("*").alias("customers"),
F.round(F.avg("recency"), 1).alias("avg_recency"),
F.round(F.avg("frequency"), 1).alias("avg_frequency"),
F.round(F.avg("monetary"), 1).alias("avg_monetary"),
)
.orderBy("prediction")
.show())+----------+---------+-----------+-------------+------------+
|prediction|customers|avg_recency|avg_frequency|avg_monetary|
+----------+---------+-----------+-------------+------------+
| 0| 1598| 181.2| 1.3| 326.2|
| 1| 720| 13.2| 13.7| 8072.7|
| 2| 1162| 77.1| 3.9| 1765.2|
| 3| 858| 17.4| 2.3| 613.7|
+----------+---------+-----------+-------------+------------+Os quatro segmentos ficam claros:
- Cluster 1, melhores clientes (720): compraram em média nas últimas 2 semanas, com cerca de 14 pedidos e mais de £8.000 gastos cada. Ações de retenção e fidelidade entram aqui.
- Cluster 3, recentes e leves (858): ativos nas últimas 3 semanas, mas com cerca de 2 pedidos. Muitos provavelmente são novos clientes que valem nutrição rumo ao segundo e terceiro pedidos.
- Cluster 2, esfriando (1.162): gasto intermediário, mas cerca de 11 semanas desde a última compra. Uma campanha de reconquista tem mais chances aqui.
- Cluster 0, compradores únicos inativos (1.598): em sua maioria um pedido único, por volta de £326, há uns 6 meses. O maior grupo e o menos valioso.
Os números dos clusters são rótulos arbitrários, e uma semente diferente pode reordená-los, então sempre faça o perfil antes de nomeá-los. Para entender como o K-Means escolhe seus centróides, veja nossa introdução ao k-means, e a referência da API do pyspark.ml lista todos os modelos e transformadores. Nosso curso Machine Learning with PySpark cobre classificação, regressão e ajuste de modelos com Pipelines.
Considerações finais
PySpark se resume a poucas ideias: uma SparkSession para começar, DataFrames para quase tudo, transformações preguiçosas que só rodam quando uma ação precisa do resultado e a escolha entre escrever cada consulta em Python ou SQL. Tudo neste tutorial rodou em modo local em um notebook, e o mesmo código roda sem mudanças em um cluster.
Um arquivo com 541.909 linhas não precisa de um cluster, e o pandas daria conta. Isso foi proposital, porque os hábitos que importam em dados grandes (schemas explícitos, filtrar cedo, fazer cache do que você reutiliza e checar o explain()) são mais fáceis de formar em dados que você consegue inspecionar.
A partir daqui, estes são os melhores próximos passos, dependendo do seu objetivo:
- Pratique a API de DataFrame com exercícios: Introduction to PySpark
- Prepare dados bagunçados do mundo real: Cleaning Data with PySpark
- Mantenha a sintaxe à mão: nosso cheat sheet de PySpark
- Prepare-se para entrevistas: Top PySpark interview questions
Se quiser ir além, recomendo nossa trilha Big Data with PySpark, que cobre gestão de dados, engenharia de features, pipelines de machine learning e sistemas de recomendação em sequência. Para times, o DataCamp for Business oferece caminhos de aprendizado para funções de engenharia de dados.
Perguntas frequentes sobre PySpark
Quais são os pré-requisitos para aprender PySpark?
O PySpark 4.3 precisa de Python 3.11 ou superior e Java 17 ou superior (Spark 4.3 roda em Java 17, 21 e 25), com JAVA_HOME apontando para sua instalação do Java. Você deve estar à vontade com o básico de Python; experiência com DataFrames do pandas ajuda, pois a API de DataFrame do PySpark usa ideias semelhantes. Você não precisa ter experiência prévia com sistemas distribuídos.
PySpark é mais rápido que pandas?
Não em dados pequenos. O pandas roda no próprio processo sem custo de inicialização, enquanto o PySpark gasta alguns segundos iniciando a JVM e agendando tarefas, então o pandas costuma ganhar quando os dados cabem confortavelmente na memória. O PySpark fica mais rápido quando o trabalho cresce além da memória ou CPU de uma máquina, pois processa partições em paralelo entre núcleos ou nós do cluster.
Qual a diferença entre RDDs e DataFrames no PySpark?
Um RDD (Resilient Distributed Dataset) é a estrutura de baixo nível do PySpark: uma coleção distribuída de objetos Python arbitrários que você processa com suas próprias funções. Um DataFrame organiza os dados em colunas nomeadas e tipadas, como um DataFrame do pandas, e o otimizador Catalyst do Spark transforma consultas de DataFrame em planos de execução eficientes. Use DataFrames para praticamente todo código novo e RDDs apenas para dados não estruturados ou controle fino de partição.
Como rodo PySpark em um Jupyter Notebook?
Instale o Java 17 ou superior, depois rode pip install "pyspark[sql]" no ambiente que seu notebook usa. Crie uma SparkSession na primeira célula:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("MyNotebook").getOrCreate()Se preferir pular a configuração local, os notebooks do DataLab e do Databricks já vêm com PySpark pré-instalado.
Quando devo usar PySpark em vez de pandas?
Use PySpark quando seus dados não cabem na memória de uma máquina, quando um job precisa rodar em um cluster ou plataforma como o Databricks, ou quando você está construindo pipelines que vão crescer além do notebook. Para análise exploratória em dados que cabem na memória, o pandas é mais simples e inicia instantaneamente. O código de PySpark escrito localmente roda sem mudanças em um cluster, então começar com ele faz sentido se a escala deve aumentar.
O que é avaliação preguiçosa no PySpark?
Avaliação preguiçosa significa que o PySpark não executa transformações como filter() ou withColumn() quando você as chama. Ele as registra em um plano e só roda esse plano quando uma ação, como count(), show() ou write, precisa de um resultado. Esperar permite ao Spark otimizar toda a cadeia, por exemplo empurrando filtros para a leitura do arquivo.
Como rodo consultas SQL no PySpark?
Registre um DataFrame como view temporária com df.createOrReplaceTempView("sales") e consulte com spark.sql("SELECT ... FROM sales"). O resultado é um DataFrame comum, então você pode misturar SQL e código de DataFrame livremente. Ambos compilam para o mesmo plano otimizado, então nenhum é mais rápido.
Preciso de Hadoop para rodar PySpark?
Não. pip install pyspark já inclui o runtime do Spark, que roda em modo local na sua máquina sem Hadoop. Você só precisa de componentes do Hadoop se for ler do HDFS ou rodar o Spark em um cluster YARN.
Natassha é uma consultora de dados que trabalha na interseção da ciência de dados e do marketing. Ela acredita que os dados, quando usados com sabedoria, podem inspirar um enorme crescimento para indivíduos e organizações. Como uma profissional de dados autodidata, Natassha adora escrever artigos que ajudem outros aspirantes à ciência de dados a entrar no setor. Seus artigos em seu blog pessoal, bem como em publicações externas, obtêm uma média de 200 mil visualizações mensais.






PySpark é a API de Python para o Apache Spark. Você escreve código de DataFrame ou SQL em Python, e o Spark divide o trabalho entre todos os núcleos de CPU do seu notebook ou entre as máquinas de um cluster. Eu recorro a ele quando um dataset já não cabe confortavelmente no pandas ou quando o mesmo job vai precisar rodar depois em um cluster sem reescrita.
Neste tutorial de PySpark, vou instalar o PySpark 4.3, criar uma SparkSession e explicar as duas ideias que mais confundem quem está começando: RDDs versus DataFrames e avaliação preguiçosa (lazy evaluation). Depois, vamos praticar as operações do dia a dia (select, filter, groupBy, join e Spark SQL) em um dataset de e-commerce com 541.909 linhas, e terminar com um modelo de segmentação de clientes com K-Means usando a API Pipeline do
pyspark.ml.Se você quiser exercícios guiados junto com este tutorial, nosso curso Introduction to PySpark cobre o mesmo conteúdo. Para um plano de estudos mais longo, veja o guia How to Learn PySpark From Scratch.
Resumo (TL;DR)
pip install "pyspark[sql]"; PySpark 4.3 exige Python 3.11+ e Java 17+.SparkSession, e DataFrames (não RDDs) são a API padrão.count()oushow().pyspark.mlencadeiam preparo de features e modelos como K-Means em um único objeto.O que é o Apache Spark?
O Apache Spark é um engine open source para processamento distribuído de dados. Ele divide um dataset em partições, processa em paralelo em um cluster e mantém resultados intermediários em memória em vez de gravar em disco entre as etapas.
Esse design em memória é o principal motivo de o Spark ter substituído o Hadoop MapReduce para a maioria dos workloads em batch (comparamos os dois em Hadoop vs Spark). O Spark começou no AMPLab da UC Berkeley em 2009, tornou-se um projeto de nível principal na Apache em 2014 e chegou à versão 4.3 em 30 de outubro de 2026.
Um único engine cobre vários workloads por meio de bibliotecas nativas:
pyspark.ml) para machine learning distribuídoPara ver de perto como o driver, o gerenciador de cluster e os executores dividem o trabalho, confira nosso guia de arquitetura do Apache Spark.