जब मैंने पहली बार retrieval-augmented generation (RAG) सिस्टम्स की पड़ताल शुरू की, तो मुझे जल्दी ही एहसास हुआ कि उनके प्रदर्शन को प्रभावित करने वाले सबसे अनदेखे लेकिन महत्वपूर्ण कारकों में से एक चंकिंग है.
मूल रूप से, चंकिंग बड़े सूचना खंडों—जैसे दस्तावेज़, ट्रांसक्रिप्ट, या तकनीकी मैनुअल—को छोटे, अधिक प्रबंधनीय खंडों में बाँटने की प्रक्रिया है। इन खंडों को बाद में एआई सिस्टम्स द्वारा प्रोसेस, एम्बेड और रिट्रीव किया जा सकता है।
आधुनिक भाषा मॉडलों और उनके संदर्भ सीमाओं के साथ काम करते हुए, मुझे लगता है कि प्रभावी चंकिंग रणनीतियों को समझना और लागू करना किसी भी व्यक्ति के लिए आवश्यक है जो RAG पाइपलाइंस, सेमांटिक सर्च सिस्टम्स, या दस्तावेज़ प्रोसेसिंग अनुप्रयोग बना रहा है।
इस गाइड में, मैं आपको चंकिंग की अवधारणा से परिचित कराऊँगा, बताऊँगा कि यह एआई अनुप्रयोगों में क्यों मायने रखती है, RAG पाइपलाइन में इसकी भूमिका का वर्णन करूँगा, और चर्चा करूँगा कि अलग-अलग रणनीतियाँ रिट्रीवल सटीकता को कैसे प्रभावित कर सकती हैं। मैं व्यावहारिक अमल संबंधी बातों, मूल्यांकन विधियों, डोमेन-विशिष्ट उपयोग मामलों, और सर्वोत्तम प्रथाओं पर भी बात करूँगा जो आपको अपने प्रोजेक्ट के लिए सही दृष्टिकोण चुनने में मदद करेंगी।
यदि आप RAG और एआई अनुप्रयोगों में नए हैं, तो मैं आपको हमारे कोर्सेज़ में से एक लेने की सलाह देता हूँ, जैसे Retrieval Augmented Generation (RAG) with LangChain, AI Fundamentals Certification, या Artificial Intelligence (AI) Strategy.
एआई और RAG अनुप्रयोगों के लिए चंकिंग क्यों महत्वपूर्ण है
चंकिंग का महत्व साधारण डेटा संगठन से कहीं आगे जाता है; यह बुनियादी तौर पर गढ़ता है कि एआई सिस्टम जानकारी को कैसे समझते और रिट्रीव करते हैं।
बड़े भाषा मॉडल और RAG पाइपलाइंस को उनके संदर्भ विंडो और संगणनात्मक सीमाओं के कारण चंकिंग की आवश्यकता होती है.
जब मैं बड़े दस्तावेज़ों को बिना उचित चंकिंग के प्रोसेस करता हूँ, तो सिस्टम अक्सर महत्वपूर्ण संदर्भ संबंध खो देता है और रिट्रीवल के दौरान प्रासंगिक जानकारी की पहचान करने में संघर्ष करता है। प्रभावी चंकिंग सेमांटिक रूप से सुसंगत खंड बनाकर सीधे रिट्रीवल की सटीकता बढ़ाती है, जो क्वेरी पैटर्न और उपयोगकर्ता के इरादे के अनुरूप हों।
मेरे अनुभव में, अच्छी तरह लागू की गई चंकिंग रणनीतियाँ तर्कसंगत प्रवाह को बनाए रखते हुए, और हर चंक में सार्थक एम्बेडिंग के लिए पर्याप्त संदर्भ सुनिश्चित करते हुए, सेमांटिक सर्च क्षमताओं में उल्लेखनीय सुधार करती हैं। यह दृष्टिकोण एम्बेडिंग मॉडलों को सूक्ष्म संबंधों को पकड़ने देता है और रिट्रीवल के दौरान अधिक सटीक समानता मिलान सक्षम करता है।
इसके विपरीत, खराब चंकिंग रणनीतियाँ एआई पाइपलाइन में नकारात्मक प्रभावों की एक शृंखला पैदा करती हैं। मनमाने विभाजन अवधारणाओं के बीच महत्वपूर्ण संबंधों को तोड़ सकते हैं, जिससे अधूरे या भ्रामक उत्तर मिलते हैं। जब चंक बहुत बड़े हों, तो रिट्रीवल सिस्टम विशिष्ट संबंधित अंशों की पहचान करने में संघर्ष करते हैं, जबकि बहुत छोटे चंक अक्सर सटीक समझ के लिए पर्याप्त संदर्भ से वंचित रहते हैं। अंततः इससे उपयोगकर्ता संतुष्टि घटती है और सिस्टम की विश्वसनीयता प्रभावित होती है।
RAG पाइपलाइन में चंकिंग कहाँ फिट बैठती है
RAG पाइपलाइन में चंकिंग एक महत्वपूर्ण स्थान रखती है—यह कच्चे दस्तावेज़ इनजेशन और सार्थक नॉलेज रिट्रीवल के बीच पुल का काम करती है। एंड-टू-एंड RAG पाइपलाइन में, चंकिंग आमतौर पर दस्तावेज़ प्रीप्रोसेसिंग के बाद लेकिन एम्बेडिंग जनरेशन से पहले होती है। चंकिंग प्रक्रिया सीधे एम्बेडिंग स्टेप में फ़ीड करती है, जहाँ हर चंक को ऐसे वेक्टर निरूपणों में बदला जाता है जो सेमांटिक अर्थ को पकड़ते हैं।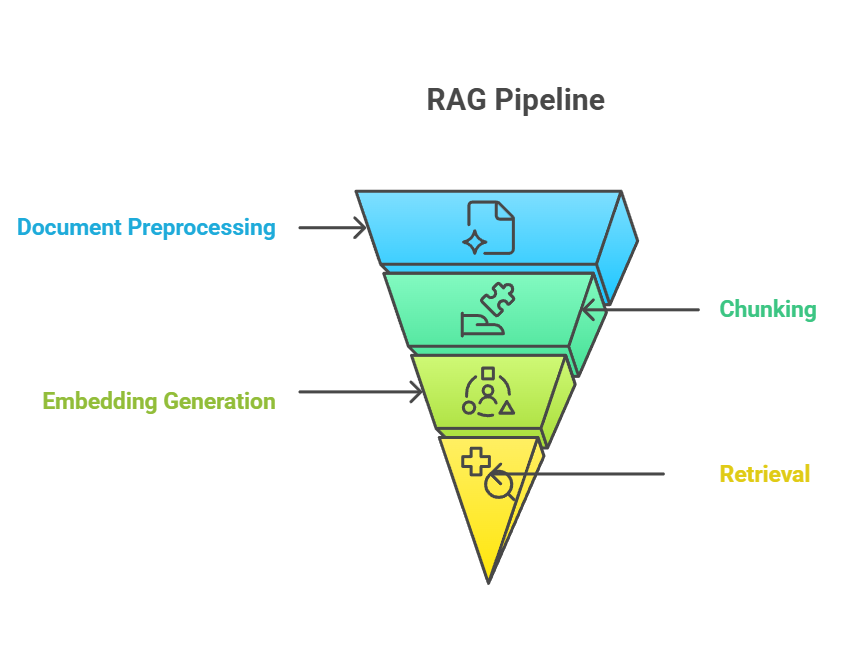
RAG पाइपलाइन
चंकिंग, एम्बेडिंग, और रिट्रीवल के बीच संबंध एक सघन रूप से जुड़ा हुआ सिस्टम बनाता है जहाँ हर घटक की प्रभावशीलता दूसरों के प्रदर्शन पर निर्भर करती है.
जब मैं सुव्यवस्थित चंक बनाता हूँ, तो एम्बेडिंग मॉडल अधिक समृद्ध वेक्टर निरूपण जनरेट कर सकते हैं, जो बदले में उपयोगकर्ता के क्वेरी करने पर अधिक सटीक रिट्रीवल परिणाम सक्षम करते हैं। यह तालमेल दर्शाता है कि चंकिंग में सुधार अक्सर पूरी पाइपलाइन में मापने योग्य प्रदर्शन लाभों में बदल जाता है।
यह कहते हुए भी, कुछ नए दृष्टिकोण इस पारंपरिक क्रम को चुनौती देते हैं। उदाहरण के लिए, पोस्ट-चंकिंग पहले पूरे दस्तावेज़ को एम्बेड करता है और केवल क्वेरी समय पर उन्हें चंक करता है, और बाद में तेज़ एक्सेस के लिए परिणामों को कैश करता है। यह तरीका उन दस्तावेज़ों की प्री-प्रोसेसिंग से बचता है जिन पर कभी क्वेरी ही न आए, और क्वेरी-विशिष्ट चंकिंग की अनुमति देता है, लेकिन पहली बार एक्सेस पर विलंबता लाता है और अतिरिक्त इंफ्रास्ट्रक्चर की आवश्यकता होती है.
इसी तरह, late chunking सूक्ष्म-स्तरीय विभाजन को रिट्रीवल तक टाल देता है। कई छोटे चंक्स के लिए एम्बेडिंग पहले से कंप्यूट करने के बजाय, सिस्टम मोटे प्रतिनिधित्व (जैसे पूरे दस्तावेज़ या सेक्शंस) स्टोर करता है और क्वेरी आने पर उन्हें डायनामिकली विभाजित करता है। यह व्यापक संदर्भ को संरक्षित करता है और अग्रिम प्रोसेसिंग घटाता है, यद्यपि यह पहली क्वेरी में विलंबता लाता है और अतिरिक्त इंफ्रास्ट्रक्चर की मांग करता है।
दृष्टिकोण चाहे जो हो, चंकिंग रणनीतियों को उपयोग में लिए जा रहे भाषा मॉडल की संदर्भ विंडो—यानी एक समय में मॉडल जितना अधिकतम पाठ प्रोसेस और विचार कर सकता है—के अनुरूप होना चाहिए।
दस्तावेज़ चंकिंग की बुनियाद
अब जब आपको यह अंदाज़ा हो गया है कि चंकिंग क्या है और पाइपलाइन में यह कहाँ फिट होती है, तो प्रभावी चंकिंग रणनीतियों का मार्गदर्शन करने वाले मूल सिद्धांतों पर नज़र डालने का समय है। इन बुनियादों को समझने से एआई और RAG अनुप्रयोगों की विस्तृत शृंखला में चंकिंग लागू करने की ठोस ज़मीन मिलती है।
चंकिंग आवश्यक है क्योंकि भाषा मॉडलों की संदर्भ विंडो सीमित होती है। प्राथमिक लक्ष्य ऐसे चंक बनाना है जो स्वतंत्र रूप से अर्थपूर्ण हों, जबकि सामूहिक रूप से दस्तावेज़ की समग्र संरचना और उद्देश्य को संरक्षित रखें—और यह सब मॉडल की संदर्भ विंडो के भीतर।
हालाँकि, संदर्भ विंडो ही एकमात्र विचार नहीं है। जब मैं चंकिंग रणनीतियाँ डिज़ाइन करता हूँ, तो मैं तीन मूल सिद्धांतों पर ध्यान देता हूँ:
- सेमांटिक सुसंगति: हर चंक को संबंधित अवधारणाओं को समूहित करना चाहिए और जानकारी का तार्किक प्रवाह बनाए रखना चाहिए।
- संदर्भ संरक्षण: किसी चंक में इतना आस-पास का संदर्भ होना चाहिए कि मूल दस्तावेज़ से अलग होने पर भी उसका अर्थ बना रहे।
- संगणनात्मक अनुकूलन: चंक का आकार सेमांटिक समृद्धि और दक्षता के बीच संतुलित हो, ताकि सिस्टम तेज़ी से प्रोसेस कर सके और मेमोरी या टोकन सीमाएँ न लाँघे।
ये सिद्धांत मिलकर चंक्स को मॉडल के लिए उपयोगी और रिट्रीवल पाइपलाइंस के लिए कुशल बनाते हैं। इस आधार के साथ, अब मैं व्यवहार में उपयोग की जाने वाली सबसे आम चंकिंग रणनीतियों से गुज़र सकता हूँ।
चंकिंग रणनीतियों का अवलोकन
चंकिंग रणनीतियों का परिदृश्य विभिन्न कंटेंट प्रकारों, अनुप्रयोगों और प्रदर्शन आवश्यकताओं के अनुरूप विविध दृष्टिकोण प्रस्तुत करता है। नीचे की छवि में आप मुख्य चंकिंग विधियों का अवलोकन देख सकते हैं, जिन्हें मैं आगे के अनुभागों में विस्तार से कवर करूँगा।
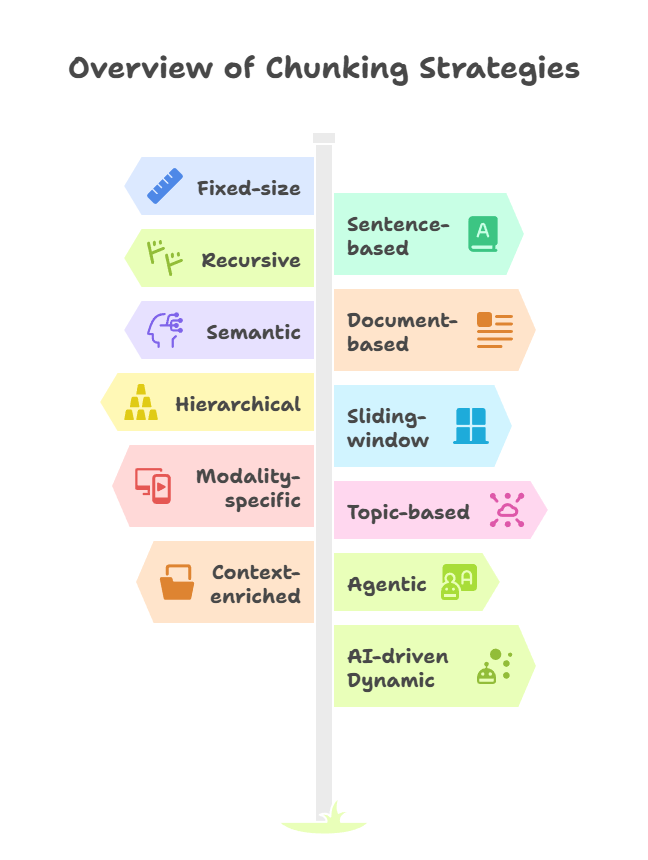
चंकिंग रणनीतियों का अवलोकन
यह व्यापक अवलोकन सरल नियम-आधारित तरीकों से परिष्कृत एआई-चालित तकनीकों तक के विकास को दर्शाता है, जिनमें से प्रत्येक विशिष्ट अनुप्रयोगों और प्रदर्शन आवश्यकताओं के लिए अलग-अलग लाभ प्रदान करता है।
विस्तार से: सामान्य चंकिंग विधियाँ
चलिए सबसे व्यापक रूप से उपयोग की जाने वाली चंकिंग रणनीतियों पर क़रीब से नज़र डालते हैं। हर विधि की अपनी विशेष ताकतें, सीमाएँ, और सर्वोत्तम उपयोग परिदृश्य हैं। इन अंतरों को समझकर, मैं एक-सा सब पर लागू समाधान अपनाने के बजाय किसी विशेष प्रोजेक्ट के लिए सही दृष्टिकोण चुन सकता हूँ। हम सबसे सीधे तरीके से शुरू करेंगे: फिक्स्ड-साइज़ चंकिंग।
फिक्स्ड-साइज़ चंकिंग
फिक्स्ड-साइज़ चंकिंग सबसे सरल विधि है। यह पाठ को अक्षरों, शब्दों, या टोकन्स के आधार पर—बिना अर्थ या संरचना की परवाह किए—खंडित करती है।
- कैरक्टर-आधारित: निश्चित संख्या के अक्षरों के बाद पाठ को विभाजित करती है। हल्की प्रोसेसिंग के लिए उपयोगी, लेकिन वाक्यों या शब्दों को अटपटे स्थानों पर काटने की प्रवृत्ति रखती है।
- वर्ड-आधारित: निश्चित संख्या के शब्दों के बाद पाठ को तोड़ती है। कैरक्टर-आधारित से अधिक स्वाभाविक, लेकिन फिर भी वाक्यों के खंडित होने का जोखिम रहता है।
- टोकन-आधारित: लक्ष्य मॉडल के समान टोकनाइज़ेशन स्कीम (उदा., OpenAI का टोकनाइज़र) का उपयोग करती है। यह मॉडल की संदर्भ सीमाओं के साथ संगतता सुनिश्चित करता है, लेकिन टोकन सीमाएँ हमेशा सेमांटिक सीमाओं से मेल नहीं खातीं।
फिक्स्ड-साइज़ चंकिंग का मुख्य लाभ संगणनात्मक दक्षता है—यह तेज़, पूर्वानुमेय, और लागू करने में आसान है। कमी यह है कि यह अक्सर सेमांटिक संरचना की अनदेखी करती है, जिससे रिट्रीवल सटीकता घट सकती है। मैं आम तौर पर इस विधि का उपयोग तब करता हूँ जब सरलता और गति सेमांटिक परिशुद्धता से अधिक महत्त्वपूर्ण हों और जब दस्तावेज़ की संरचना उतनी मायने न रखती हो। प्रदर्शन सुधारने के लिए, मैं अक्सर चंक्स के बीच ओवरलैप जोड़ता हूँ ताकि सीमाओं के पार संदर्भ संरक्षित रहे।
वाक्य-आधारित चंकिंग
इन कमियों में से कुछ को दूर करने का एक तरीका वाक्य-आधारित चंकिंग है, जो स्वाभाविक भाषा सीमाओं का सम्मान करती है, आमतौर पर पूर्ण विराम या प्रश्नचिह्न जैसे विराम-चिह्नों को पहचानकर।
यह दृष्टिकोण पठनीयता बनाए रखता है और सुनिश्चित करता है कि हर चंक आत्म-निहित रहे। फिक्स्ड-साइज़ चंकिंग की तुलना में, यह ऐसे खंड बनाता है जिन्हें मनुष्यों और मॉडलों दोनों के लिए समझना आसान होता है। हालाँकि, वाक्य की लंबाई बदलती रहती है, इसलिए चंक आकार असमान हो सकते हैं, और वे हमेशा गहरे सेमांटिक संबंधों को नहीं पकड़ पाते।
मुझे वाक्य-आधारित चंकिंग उन अनुप्रयोगों के लिए सबसे उपयोगी लगती है जो स्वाभाविक भाषा प्रवाह पर निर्भर करते हैं, जैसे मशीन अनुवाद, भावविश्लेषण, या संक्षेपण कार्य। लेकिन जब दस्तावेज़ वाक्यों से अधिक संरचित हों, तो रिक्रसिव चंकिंग एक लचीला विकल्प देती है।
रिकरसिव चंकिंग
रिकरसिव चंकिंग पहले बताई गई विधियों से अधिक उन्नत तकनीक है। यह चरणबद्ध तरीके से विभाजन नियम लागू करती है जब तक कि हर चंक परिभाषित आकार सीमा में न आ जाए। उदाहरण के लिए, मैं पहले सेक्शन हेडर से विभाजन कर सकता हूँ, फिर पैराग्राफ से, और अंत में वाक्यों से। प्रक्रिया तब तक जारी रहती है जब तक हर हिस्सा प्रबंधनीय और पूर्व-परिभाषित आकार के भीतर न आ जाए।
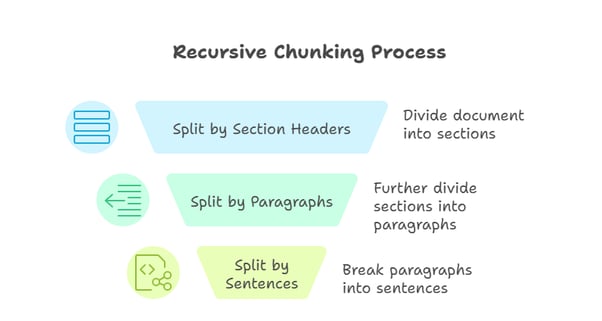
रिकरसिव चंकिंग
इस दृष्टिकोण का मुख्य लाभ लचीलापन है। टॉप-डाउन तरीके से काम करके, रिक्रसिव चंकिंग दस्तावेज़ संरचना को संरक्षित रखती है और साथ ही मॉडल की संदर्भ विंडो के साथ संगतता सुनिश्चित करती है। हालाँकि, इसे लागू करना अधिक जटिल हो सकता है, और परिणामों की गुणवत्ता इस पर निर्भर करती है कि स्रोत दस्तावेज़ कितना अच्छी तरह संरचित है।
मैं अक्सर रिक्रसिव चंकिंग का सहारा लेता हूँ जब मैं तकनीकी मैनुअल्स या अन्य ऐसे दस्तावेज़ों पर काम करता हूँ जिनमें स्पष्ट पदानुक्रम हो।
सेमांटिक चंकिंग
जहाँ रिक्रसिव तरीके संरचना पर निर्भर करते हैं, वहीं सेमांटिक चंकिंग ध्यान को अर्थ पर स्थानांतरित करती है, पाठ को वैचारिक सीमाओं के आधार पर विभाजित करती है। सेमांटिक चंकिंग एक अर्थ-सजग तकनीक है जो एम्बेडिंग्स या सेमांटिक समानता का उपयोग करके पाठ को वहाँ विभाजित करती है जहाँ विषय में बदलाव आता है। मनमानी सीमाओं के बजाय, चंक अर्थ द्वारा परिभाषित होते हैं.
एक तरीका यह है कि पाठ को वाक्यों में तोड़ा जाए और उनके बीच सेमांटिक समानता (उदा., एम्बेडिंग्स पर कोज़ाइन समानता) मापी जाए, और जब सुसंगति घटे तो नए चंक चिन्हित किए जाएँ। उन्नत इम्प्लीमेंटेशन क्लस्टरिंग तरीकों या सुपर्वाइज़्ड बाउंडरी-डिटेक्शन मॉडलों का उपयोग करते हैं, जो जटिल दस्तावेज़ों में विषय बदलावों को बेहतर पकड़ते हैं।
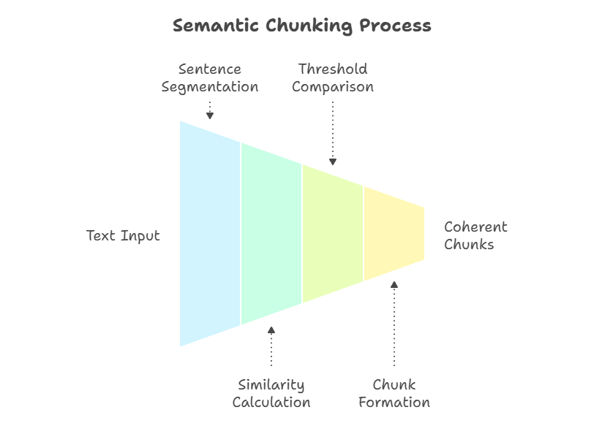
सेमांटिक चंकिंग
यह विधि सेमांटिक सुसंगति बनाए रखती है, यह सुनिश्चित करते हुए कि हर चंक एक ही विचार या थीम को कवर करता है। तकनीकों में एम्बेडिंग समानता, क्लस्टरिंग, या प्राकृतिक ब्रेकपॉइंट्स का पता लगाने के लिए अन्य सेमांटिक-दूरी गणनाएँ शामिल हो सकती हैं।
सबसे बड़ा लाभ है परिशुद्धता—सेमांटिक चंकिंग ऐसे चंक बनाती है जो रिट्रीवल के दौरान उपयोगकर्ता के इरादे के साथ क़रीबी से मेल खाते हैं। मुख्य कमी है संगणनात्मक लागत, क्योंकि इसमें प्रीप्रोसेसिंग के दौरान पाठ को एम्बेड करना पड़ता है। मैं सेमांटिक चंकिंग तब उपयोग करता हूँ जब सटीकता गति से अधिक महत्वपूर्ण हो, जैसे कानूनी या चिकित्सीय डोमेन्स के डोमेन-विशिष्ट RAG सिस्टम्स में।
स्लाइडिंग-विंडो चंकिंग
सेमांटिक चंकिंग, जो सेमांटिक सुसंगति पर ज़ोर देती है, के विपरीत, स्लाइडिंग-विंडो चंकिंग निरंतरता पर ज़ोर देती है—ओवरलैपिंग चंक्स द्वारा, जो पाठ पर एक विंडो को शिफ्ट करती है। उदाहरण के लिए, यदि मैं 500 टोकन के चंक आकार (विंडो) के साथ 250 का स्ट्राइड उपयोग करता हूँ, तो हर चंक अपने पिछले चंक के साथ आधा ओवरलैप करता है।
यह ओवरलैप चंक सीमाओं के पार संदर्भ को संरक्षित रखता है, जिससे किनारों पर महत्वपूर्ण जानकारी खोने का जोखिम घटता है। यह रिट्रीवल सटीकता भी बढ़ाता है, क्योंकि कई ओवरलैपिंग चंक किसी क्वेरी के जवाब में सतह पर आ सकते हैं। समझौता है अनावश्यकता—ओवरलैप स्टोरेज और प्रोसेसिंग लागत बढ़ाता है। स्लाइडिंग विंडोज़ विशेष रूप से असंरचित पाठ, जैसे चैट लॉग्स या पॉडकास्ट ट्रांसक्रिप्ट्स, के लिए उपयोगी हैं।
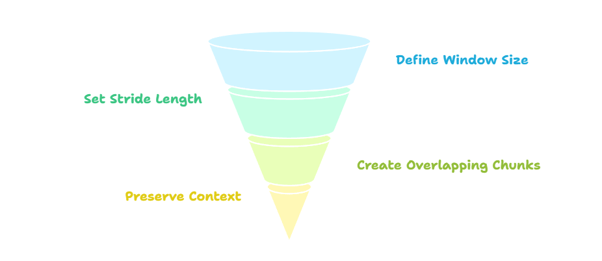
स्लाइडिंग-विंडो चंकिंग
जब मैं इस रणनीति को लागू करता हूँ, तो मैं आम तौर पर चंक्स के बीच 20–50% ओवरलैप का उपयोग करता हूँ ताकि सीमाओं के पार संदर्भ संरक्षित रहे, खासकर तकनीकी या संवादात्मक पाठ में। LangChain जैसे फ्रेमवर्क्स में 200–400 टोकन के चंक आकार सामान्य डिफ़ॉल्ट हैं, यद्यपि इसे मॉडल की संदर्भ सीमाओं और दस्तावेज़ प्रकार के आधार पर ट्यून किया जा सकता है। मैं इस दृष्टिकोण की अनुशंसा वहाँ करता हूँ जहाँ संदर्भ संरक्षण महत्वपूर्ण हो और स्टोरेज दक्षता कम महत्त्वपूर्ण।
पदानुक्रमित और संदर्भात्मक चंकिंग
जब केवल निरंतरता पर्याप्त नहीं होती और दस्तावेज़ संरचना को संरक्षित रखना आवश्यक होता है, तो पदानुक्रमित और संदर्भात्मक चंकिंग काम आती हैं।
पदानुक्रमित चंकिंग किसी दस्तावेज़ की पूरी संरचना—सेक्शंस से लेकर वाक्यों तक—को संरक्षित रखती है। एक सपाट सूची के बजाय, यह मूल पदानुक्रम को दर्शाने वाला एक वृक्ष बनाती है। हर चंक का अपने ऊपर और नीचे के स्तरों के साथ अभिभावक–शिशु संबंध होता है। उदाहरण के लिए, एक सेक्शन में कई पैराग्राफ होते हैं (अभिभावक → शिशु), और प्रत्येक पैराग्राफ में कई वाक्य हो सकते हैं।
रिट्रीवल के दौरान, यह संरचना लचीला नेविगेशन सक्षम करती है। यदि कोई क्वेरी वाक्य-स्तर के चंक से मेल खाती है, तो सिस्टम ऊपर की ओर विस्तार कर उसके अभिभावक पैराग्राफ या पूरे सेक्शन से अतिरिक्त संदर्भ दे सकता है। इसके विपरीत, यदि कोई व्यापक क्वेरी सेक्शन-स्तर के चंक से मेल खाती है, तो सिस्टम सबसे प्रासंगिक शिशु पैराग्राफ या वाक्य में ड्रिल-डाउन कर सकता है। यह बहु-स्तरीय रिट्रीवल परिशुद्धता और रिकॉल दोनों में सुधार करता है, क्योंकि मॉडल लौटाए गए कंटेंट के दायरे को अनुकूलित कर सकता है।
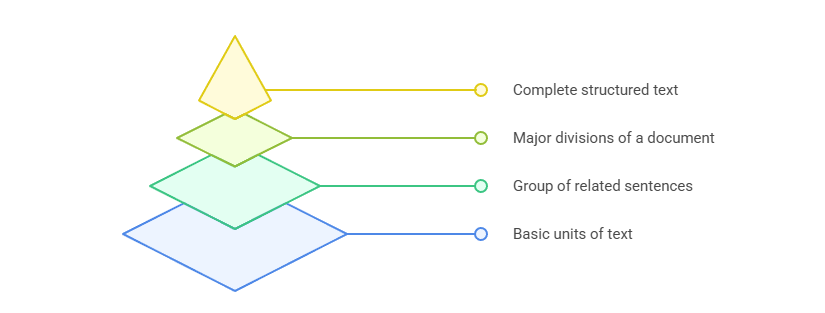
पदानुक्रमित चंकिंग
संदर्भात्मक चंकिंग एक कदम आगे बढ़कर चंक्स को हेडिंग्स, टाइमस्टैम्प्स, या स्रोत संदर्भ जैसी मेटाडेटा से समृद्ध करती है। यह अतिरिक्त जानकारी रिट्रीवल सिस्टम्स को परिणामों का अस्पष्टता-निवारण करने में महत्वपूर्ण संकेत देती है। उदाहरण के लिए, दो दस्तावेज़ों में लगभग समान वाक्य हो सकते हैं, लेकिन उनके सेक्शन शीर्षक या टाइमस्टैम्प यह तय कर सकते हैं कि किसी क्वेरी के लिए कौन अधिक प्रासंगिक है। मेटाडेटा उत्तरों को उनके स्रोत तक ट्रेस करना भी आसान बनाता है, जो विशेष रूप से विनियमित या अनुपालन-प्रेरित डोमेन्स में मूल्यवान है।
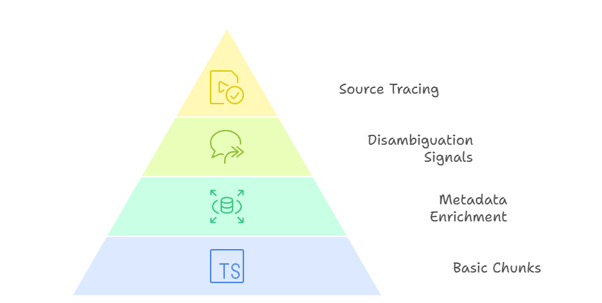
संदर्भात्मक चंकिंग
पदानुक्रमित और संदर्भात्मक चंकिंग का मुख्य लाभ सटीकता और लचीलापन है। समझौता यह है कि प्रीप्रोसेसिंग और रिट्रीवल लॉजिक दोनों में जटिलता बढ़ती है, क्योंकि सिस्टम को चंक्स के बीच संबंधों का प्रबंधन करना पड़ता है, उन्हें स्वतंत्र इकाइयों की तरह ट्रीट करने के बजाय। मैं इन दृष्टिकोणों की सिफारिश उन डोमेन्स के लिए करता हूँ जैसे कानूनी अनुबंध, वित्तीय रिपोर्ट, या तकनीकी विनिर्देश, जहाँ संरचना और ट्रेसबिलिटी का संरक्षित रहना आवश्यक है।
विषय-आधारित और मॉडैलिटी-विशिष्ट चंकिंग
सभी दस्तावेज़ सख्त पदानुक्रम का पालन नहीं करते, इसलिए विषय-आधारित या मॉडैलिटी-विशिष्ट चंकिंग संबंधित कंटेंट को समूहित करने का अधिक लचीला तरीका प्रदान करती है।
विषय-आधारित चंकिंग पाठ को थीमैटिक इकाइयों के अनुसार समूहित करती है, जिसके लिए टॉपिक मॉडलिंग (जैसे Latent Dirichlet Allocation, LDA) या एम्बेडिंग-आधारित क्लस्टरिंग एल्गोरिद्म का उपयोग कर सेमांटिक सीमाएँ पहचानी जाती हैं.
निर्धारित आकारों या संरचनात्मक मार्कर्स के बजाय लक्ष्य यह है कि किसी थीम से संबंधित सारा कंटेंट एक ही जगह रहे। यह दृष्टिकोण लंबे-फ़ॉर्म कंटेंट जैसे शोध रिपोर्ट या ऐसे लेखों के लिए अच्छा काम करता है जो अलग-अलग विषयों के बीच शिफ्ट होते हैं। क्योंकि हर चंक एक ही थीम पर केंद्रित रहता है, रिट्रीवल परिणाम उपयोगकर्ता के इरादे के साथ अधिक संरेखित होते हैं और असंबंधित सामग्री शामिल होने की संभावना कम होती है।
मॉडैलिटी-विशिष्ट चंकिंग विभिन्न कंटेंट प्रकारों के अनुरूप रणनीतियों को अनुकूलित करती है, यह सुनिश्चित करते हुए कि हर माध्यम की संरचना का सम्मान करते हुए सूचना का विभाजन हो। उदाहरण के लिए:
- पाठ: वाक्य-आधारित या सेमांटिक चंकिंग अनुच्छेदों को सुसंगत और क्वेरी-प्रासंगिक रखती है।
- तालिकाएँ: पंक्तियों या तर्कसंगत समूहों के आधार पर विभाजन डेटा संबंधों के अर्थ को संरक्षित रखता है।
- छवियाँ: क्षेत्रों में विभाजित करना या कैप्शन एम्बेड करना रिट्रीवल के लिए स्थानीयकृत संदर्भ देता है।
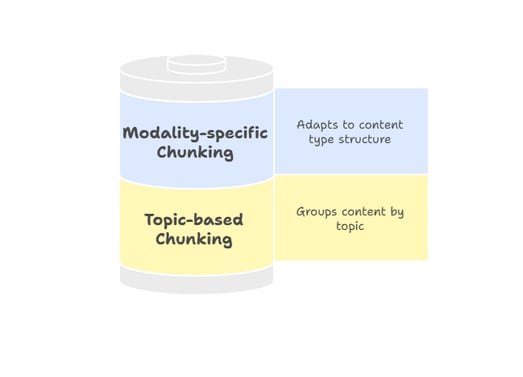
विषय-आधारित और मॉडैलिटी-विशिष्ट चंकिंग
मॉडैलिटी-विशिष्ट चंकिंग में मेटाडेटा विशेष रूप से महत्वपूर्ण भूमिका निभाता है। उदाहरण के लिए, टेबल रो पर कॉलम हेडर्स जोड़ना, छवि क्षेत्रों से कैप्शन लिंक करना, या ट्रांसक्रिप्ट में स्पीकर लेबल और टाइमस्टैम्प जोड़ना रिट्रीवल सिस्टम्स को सही चंक ढूँढने और उसे सही तरह से व्याख्यायित करने में मदद करता है। यह समृद्धि परिशुद्धता और उपयोगकर्ता भरोसा दोनों बढ़ाती है, क्योंकि परिणाम अपनी प्रासंगिकता समझाने वाले संदर्भ संकेतों के साथ आते हैं।
मैं मॉडैलिटी-विशिष्ट चंकिंग की अनुशंसा तब करता हूँ जब आप मल्टीमॉडल पाइपलाइंस या गैर-पारंपरिक दस्तावेज़ों के साथ काम कर रहे हों जो पाठ-आधारित रणनीतियों में सुव्यवस्थित रूप से फिट नहीं होते। यह सुनिश्चित करता है कि हर कंटेंट प्रकार का प्रतिनिधित्व इस तरह हो जो रिट्रीवल गुणवत्ता और उपयोगिता को अधिकतम करे।
एजेंटिक और एआई-चालित डायनामिक चंकिंग
इन नियम- और अर्थ-चालित तरीकों से आगे, एआई-चालित डायनामिक चंकिंग और एजेंटिक चंकिंग जैसी अग्रणी तकनीकें सीमाओं को और आगे बढ़ाती हैं।
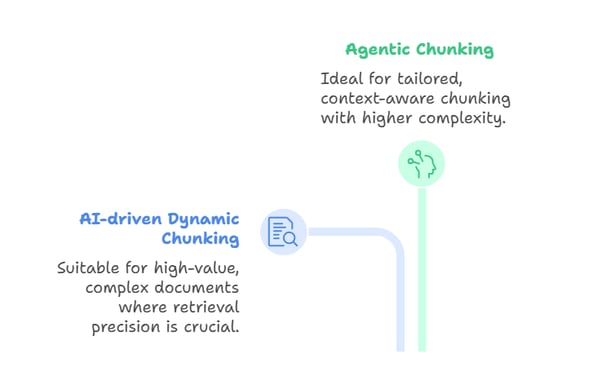
एआई-चालित डायनामिक चंकिंग पूर्व-निर्धारित नियमों पर निर्भर रहने के बजाय सीधे ही एक बड़े भाषा मॉडल का उपयोग कर चंक सीमाएँ निर्धारित करती है। LLM दस्तावेज़ को स्कैन करता है, स्वाभाविक ब्रेकपॉइंट्स पहचानता है, और चंक आकार को अनुकूल रूप से समायोजित करता है.
घने हिस्सों को छोटे चंक्स में बाँटा जा सकता है, जबकि हल्के हिस्सों को समूहीकृत किया जा सकता है। इससे सेमांटिक रूप से सुसंगत चंक बनते हैं जो पूर्ण अवधारणाओं को कैप्चर करते हैं, और रिट्रीवल सटीकता में सुधार होता है। यह विधि उन उच्च-मूल्य, जटिल दस्तावेज़ों के साथ काम करते समय उपयुक्त है—जैसे कानूनी अनुबंध, अनुपालन मैनुअल्स, या शोध पत्र—जहाँ रिट्रीवल परिशुद्धता थ्रूपुट या लागत से अधिक महत्वपूर्ण होती है।
दूसरी ओर, एजेंटिक चंकिंग इस विचार को उच्च-स्तरीय तर्क जोड़कर आगे बढ़ाती है। केवल LLM को पाठ विभाजित करने देने के बजाय, एक एआई एजेंट दस्तावेज़ और उपयोगकर्ता के इरादे का मूल्यांकन करता है और तय करता है कि इसे कैसे चंक करना है.
एजेंट अलग-अलग सेक्शंस के लिए अलग रणनीतियाँ चुन सकता है। उदाहरण के लिए, एक मेडिकल रिपोर्ट को रोगी इतिहास, लैब परिणाम, और चिकित्सक नोट्स के अनुसार तोड़ना, जबकि कथात्मक विवरणों पर सेमांटिक सेगमेंटेशन लागू करना। यह कुछ चंक्स को टाइमस्टैम्प्स, डायग्नोसिस कोड्स, या क्लिनिशियन आइडेंटिफ़ायर्स जैसी मेटाडेटा से भी समृद्ध कर सकता है.
इस तरह, एजेंटिक चंकिंग एक ऑर्केस्ट्रेशन लेयर की तरह काम करती है: एजेंट पूरे दस्तावेज़ पर एक ही विधि लागू करने के बजाय चंकिंग दृष्टिकोणों का चयन या संयोजन डायनामिक रूप से करता है। परिणाम अधिक अनुरूपित और संदर्भ-सचेत चंकिंग होती है, यद्यपि इसकी कीमत अधिक जटिलता और संगणनात्मक आवश्यकताओं के रूप में चुकानी पड़ती है।
एजेंटिक और एआई-चालित डायनामिक चंकिंग
दोनों विधियाँ अत्याधुनिक और शक्तिशाली हैं, लेकिन वे अलग-अलग समस्याओं को संबोधित करती हैं। एआई-चालित डायनामिक चंकिंग इनजेशन के दौरान सेमांटिक रूप से संरेखित सीमाएँ बनाने पर केंद्रित होती है, जबकि एजेंटिक चंकिंग प्रत्येक अद्वितीय दस्तावेज़ के लिए चंकिंग रणनीतियों का बुद्धिमानी से चयन और संयोजन करने पर केंद्रित होती है। वे लेट चंकिंग से संबंधित हैं, जिसका उल्लेख लेख की शुरुआत में हुआ था, जो लंबे-संदर्भ मॉडलों का समर्थन इस तरह करता है कि पहले पूरे दस्तावेज़ को एम्बेड किया जाता है और फिर एम्बेडिंग स्तर पर चंकिंग लागू होती है.
ये दृष्टिकोण अत्यधिक अनुकूलनीय, सेमांटिक रूप से जागरूक चंक देते हैं। समझौते महत्वपूर्ण हैं: एआई-चालित चंकिंग महंगी और धीमी हो सकती है, जबकि एजेंटिक चंकिंग जटिलता और इंफ्रास्ट्रक्चर की एक और परत जोड़ती है। एआई-चालित डायनामिक चंकिंग उन परिदृश्यों के लिए सबसे उपयुक्त है जहाँ कंटेंट को चलते-चलते अर्थपूर्ण ढंग से विभाजित करने की आवश्यकता होती है, जबकि एजेंटिक चंकिंग तब चमकती है जब दस्तावेज़ व्यापक रूप से भिन्न हों और रणनीति-स्तरीय तर्क की मांग करें।
कार्यान्वयन संबंधी विचार
एक बार जब मैं चंकिंग रणनीति चुन लेता हूँ, तो अगला कदम कार्यान्वयन के विवरणों पर विचार करना होता है। व्यावहारिक कारक—जैसे चंक आकार, ओवरलैप प्रबंधन, और टोकन काउंटिंग—सीधे प्रभावित करते हैं कि सिस्टम कितना अच्छा प्रदर्शन करता है। बहुत बड़े हों तो चंक संदर्भ सीमाएँ पार कर सकते हैं; बहुत छोटे हों तो उनका अर्थ खो सकता है।
संगतता एक और प्रमुख चिंता है। अलग-अलग मॉडल और एम्बेडिंग समाधान अपनी-अपनी टोकनाइज़ेशन स्कीम और संदर्भ विंडो रखते हैं, इसलिए मैं सुनिश्चित करता हूँ कि मेरी चंकिंग प्रक्रिया इन अंतरों का हिसाब रखे.
इंफ्रास्ट्रक्चर की तरफ, मेमोरी प्रबंधन और संगणनात्मक दक्षता को नज़रअंदाज़ नहीं किया जा सकता; ओवरलैप अनावश्यकता बढ़ाता है, और रिक्रसिव या सेमांटिक तरीके प्रोसेसिंग ओवरहेड जोड़ सकते हैं। चंक विस्तार या मेटाडेटा समृद्धि जैसे पोस्ट-प्रोसेसिंग कदम संदर्भ पुनर्प्राप्त करने में मदद कर सकते हैं, लेकिन वे जटिलता भी बढ़ाते हैं।
इन बुनियादों के साथ, यह मापना महत्वपूर्ण है कि व्यवहार में चंकिंग रणनीतियाँ वास्तव में कितना अच्छा काम करती हैं।
प्रदर्शन मूल्यांकन और अनुकूलन
चंकिंग की प्रभावशीलता केवल सिद्धांत की बात नहीं—इसे स्पष्ट मैट्रिक्स के साथ मापा जाना चाहिए.
उदाहरण के लिए, संदर्भ प्रिसीजन मापती है कि रिट्रीव किए गए चंक्स में से कितने वास्तव में क्वेरी से संबंधित हैं, जबकि संदर्भ रिकॉल मापता है कि नॉलेज बेस से संबंधित कितने चंक्स सफलतापूर्वक रिट्रीव हुए.
दोनों मिलकर यह उजागर करते हैं कि कोई चंकिंग रणनीति रिट्रीवर को सही जानकारी खोजने में मदद करती है या नहीं.
इसी से क़रीबी रूप से जुड़ा है संदर्भ प्रासंगिकता, जो इस पर केंद्रित होती है कि रिट्रीव किए गए चंक्स उपयोगकर्ता के इरादे के साथ कितनी अच्छी तरह मेल खाते हैं—यह विशेष रूप से तब उपयोगी होती है जब top-K जैसी रिट्रीवल सेटिंग्स को ट्यून किया जा रहा हो।
अन्य चंक-विशिष्ट मैट्रिक्स, जैसे चंक उपयोग, मापते हैं कि मॉडल ने वास्तव में अपने उत्तर को जनरेट करने के लिए किसी चंक की सामग्री का कितना उपयोग किया; यदि उपयोग कम है, तो चंक बहुत व्यापक या शोरयुक्त हो सकता है.
दूसरी ओर, चंक एट्रिब्यूशन यह मूल्यांकित करता है कि सिस्टम ने अंतिम उत्तर में योगदान देने वाले चंक्स की सही पहचान की या नहीं। ये चंक-स्तरीय मूल्यांकन पुष्टि करने में मदद करते हैं कि चंक्स न केवल रिट्रीव हुए बल्कि सार्थक रूप से लागू भी हुए।
अनुकूलन भी एक प्रमुख भूमिका निभाता है और अक्सर गति और सटीकता के बीच संतुलन का अर्थ रखता है। चंक आकार, ओवरलैप प्रतिशत, और रिट्रीवल पैरामीटर्स के साथ प्रयोग करना—ताकि संगणनात्मक दक्षता और सेमांटिक समृद्धि दोनों में सुधार हो—महत्वपूर्ण है। इसके अतिरिक्त, A/B परीक्षण आवश्यक है क्योंकि यह ठोस फीडबैक देता है, जबकि क्रमिक समायोजन यह सुनिश्चित करते हैं कि रणनीति ठहरने के बजाय समय के साथ बेहतर होती जाए।
जहाँ प्रदर्शन ट्यूनिंग सामान्य-उद्देश्य सिस्टम्स में सुधार ला सकती है, वहीं डोमेन-विशिष्ट अनुप्रयोग अपनी अनूठी चुनौतियाँ प्रस्तुत करते हैं।
चंकिंग के डोमेन-विशिष्ट अनुप्रयोग
विभिन्न उद्योग चंकिंग रणनीतियों पर अलग-अलग मांगें रखते हैं। वित्त में, वार्षिक रिपोर्ट या फाइलिंग जैसे दस्तावेज़ घने और तकनीकी होते हैं, इसलिए ऐसी चंकिंग रणनीति चुनना अनिवार्य है जो संख्यात्मक तालिकाओं, हेडर्स, और फुटनोट्स को संरक्षित रखे। कानूनी और तकनीकी दस्तावेज़ भी समान चुनौतियाँ पेश करते हैं—सटीकता और संरचना पर समझौता नहीं किया जा सकता, जो पदानुक्रमित या संदर्भ-समृद्ध दृष्टिकोणों को विशेष रूप से मूल्यवान बनाता है।
चिकित्सा और मल्टीमॉडल दस्तावेज़ उभरती ज़रूरतें पेश करते हैं। किसी रोगी का रिकॉर्ड क्लिनिकल नोट्स, लैब परिणामों, और इमेजिंग डेटा को मिला सकता है, जबकि मल्टीमॉडल दस्तावेज़ टेक्स्ट को चार्ट्स या ऑडियो ट्रांसक्रिप्ट्स के साथ एकीकृत कर सकते हैं। यहाँ, मॉडैलिटी-विशिष्ट चंकिंग सुनिश्चित करती है कि हर डेटा प्रकार का विभाजन इस तरह हो जो अर्थ को संरक्षित रखे और मॉडैलिटीज़ के बीच समंजन बनाए रखे।
डोमेन चाहे जो हो, कुछ सर्वोत्तम प्रथाओं का पालन चंकिंग रणनीतियों को अधिक विश्वसनीय और बनाए रखने में आसान बनाता है।
सर्वोत्तम प्रथाएँ और दिशा-निर्देश
सही चंकिंग रणनीति का चयन कई कारकों पर निर्भर करता है: कंटेंट प्रकार, क्वेरी की जटिलता, उपलब्ध संसाधन, और मॉडल की संदर्भ विंडो का आकार। मैं शायद ही कभी हर मामले में एक ही विधि पर निर्भर करता हूँ—इसके बजाय, मैं दृष्टिकोण को सिस्टम की ज़रूरतों के अनुरूप ढालता हूँ।
दीर्घकालिक सफलता के लिए क्रमिक अनुकूलन केंद्रीय है। चंकिंग की प्रभावशीलता का लगातार परीक्षण होना चाहिए, वास्तविक क्वेरीज़ से परिणामों का सत्यापन और फीडबैक के आधार पर समायोजन के साथ। क्रॉस-वैलिडेशन यह सुनिश्चित करने में मदद करता है कि सुधार केवल एकमुश्त सफलताएँ नहीं, बल्कि अलग-अलग उपयोग मामलों में भी कायम रहें।
अंततः, मैं चंकिंग को एक विकसित होती प्रणाली की तरह ट्रीट करने की सलाह देता हूँ। अच्छा दस्तावेजीकरण, नियमित परीक्षण, और सतत रखरखाव ड्रिफ्ट को रोकने में मदद करते हैं और सुनिश्चित करते हैं कि डेटा और मॉडल दोनों बदलते रहने पर भी पाइपलाइंस मज़बूत रहें।
निष्कर्ष
चंकिंग एक प्रीप्रोसेसिंग विवरण जैसी लग सकती है, लेकिन जैसा कि आपने इस गाइड में देखा, यह बुनियादी तौर पर निर्धारित करती है कि retrieval-augmented generation सिस्टम कैसे प्रदर्शन करते हैं। फिक्स्ड-साइज़ और वाक्य-आधारित तरीकों से लेकर उन्नत सेमांटिक, एजेंटिक, और एआई-चालित रणनीतियों तक, हर दृष्टिकोण सरलता, सटीकता, दक्षता, और अनुकूलनशीलता के बीच अलग-अलग समझौते प्रदान करता है।
कोई एकल विधि हर परिदृश्य में काम नहीं करती। सही चंकिंग रणनीति कंटेंट प्रकार, भाषा मॉडल की क्षमताओं, और अनुप्रयोग के लक्ष्यों पर निर्भर करती है। सेमांटिक सुसंगति, संदर्भ संरक्षण, और संगणनात्मक दक्षता जैसे सिद्धांतों पर ध्यान देकर, आप ऐसे चंक्स डिज़ाइन कर सकते हैं जो रिट्रीवल परिशुद्धता बढ़ाएँ, प्रदर्शन को अनुकूलित करें, और अधिक विश्वसनीय परिणाम सुनिश्चित करें।
आगे देखते हुए, चंकिंग रणनीतियाँ और भी अधिक डायनामिक, अनुकूलनीय, और मॉडल-सचेत होने की संभावना है। जैसे-जैसे लंबे-संदर्भ मॉडल विकसित होंगे और मूल्यांकन टूल परिपक्व होंगे, मुझे उम्मीद है कि चंकिंग एक स्थिर प्रीप्रोसेसिंग स्टेप से आगे बढ़कर एक बुद्धिमान, संदर्भ-संवेदनशील प्रक्रिया बन जाएगी जो निरंतर उपयोग से सीखती रहेगी.
जो भी लोग RAG सिस्टम्स के साथ निर्माण कर रहे हैं, उनके लिए सटीक, कुशल, और भविष्य-तैयार रिट्रीवल पाइपलाइंस बनाने हेतु चंकिंग में महारत आवश्यक है।
सीखना जारी रखने के लिए, निम्न संसाधनों को अवश्य देखें:


जब मैंने पहली बार retrieval-augmented generation (RAG) सिस्टम्स की पड़ताल शुरू की, तो मुझे जल्दी ही एहसास हुआ कि उनके प्रदर्शन को प्रभावित करने वाले सबसे अनदेखे लेकिन महत्वपूर्ण कारकों में से एक चंकिंग है.
मूल रूप से, चंकिंग बड़े सूचना खंडों—जैसे दस्तावेज़, ट्रांसक्रिप्ट, या तकनीकी मैनुअल—को छोटे, अधिक प्रबंधनीय खंडों में बाँटने की प्रक्रिया है। इन खंडों को बाद में एआई सिस्टम्स द्वारा प्रोसेस, एम्बेड और रिट्रीव किया जा सकता है।
आधुनिक भाषा मॉडलों और उनके संदर्भ सीमाओं के साथ काम करते हुए, मुझे लगता है कि प्रभावी चंकिंग रणनीतियों को समझना और लागू करना किसी भी व्यक्ति के लिए आवश्यक है जो RAG पाइपलाइंस, सेमांटिक सर्च सिस्टम्स, या दस्तावेज़ प्रोसेसिंग अनुप्रयोग बना रहा है।
इस गाइड में, मैं आपको चंकिंग की अवधारणा से परिचित कराऊँगा, बताऊँगा कि यह एआई अनुप्रयोगों में क्यों मायने रखती है, RAG पाइपलाइन में इसकी भूमिका का वर्णन करूँगा, और चर्चा करूँगा कि अलग-अलग रणनीतियाँ रिट्रीवल सटीकता को कैसे प्रभावित कर सकती हैं। मैं व्यावहारिक अमल संबंधी बातों, मूल्यांकन विधियों, डोमेन-विशिष्ट उपयोग मामलों, और सर्वोत्तम प्रथाओं पर भी बात करूँगा जो आपको अपने प्रोजेक्ट के लिए सही दृष्टिकोण चुनने में मदद करेंगी।
यदि आप RAG और एआई अनुप्रयोगों में नए हैं, तो मैं आपको हमारे कोर्सेज़ में से एक लेने की सलाह देता हूँ, जैसे Retrieval Augmented Generation (RAG) with LangChain, AI Fundamentals Certification, या Artificial Intelligence (AI) Strategy.
एआई और RAG अनुप्रयोगों के लिए चंकिंग क्यों महत्वपूर्ण है
चंकिंग का महत्व साधारण डेटा संगठन से कहीं आगे जाता है; यह बुनियादी तौर पर गढ़ता है कि एआई सिस्टम जानकारी को कैसे समझते और रिट्रीव करते हैं।
बड़े भाषा मॉडल और RAG पाइपलाइंस को उनके संदर्भ विंडो और संगणनात्मक सीमाओं के कारण चंकिंग की आवश्यकता होती है.
जब मैं बड़े दस्तावेज़ों को बिना उचित चंकिंग के प्रोसेस करता हूँ, तो सिस्टम अक्सर महत्वपूर्ण संदर्भ संबंध खो देता है और रिट्रीवल के दौरान प्रासंगिक जानकारी की पहचान करने में संघर्ष करता है। प्रभावी चंकिंग सेमांटिक रूप से सुसंगत खंड बनाकर सीधे रिट्रीवल की सटीकता बढ़ाती है, जो क्वेरी पैटर्न और उपयोगकर्ता के इरादे के अनुरूप हों।
मेरे अनुभव में, अच्छी तरह लागू की गई चंकिंग रणनीतियाँ तर्कसंगत प्रवाह को बनाए रखते हुए, और हर चंक में सार्थक एम्बेडिंग के लिए पर्याप्त संदर्भ सुनिश्चित करते हुए, सेमांटिक सर्च क्षमताओं में उल्लेखनीय सुधार करती हैं। यह दृष्टिकोण एम्बेडिंग मॉडलों को सूक्ष्म संबंधों को पकड़ने देता है और रिट्रीवल के दौरान अधिक सटीक समानता मिलान सक्षम करता है।
इसके विपरीत, खराब चंकिंग रणनीतियाँ एआई पाइपलाइन में नकारात्मक प्रभावों की एक शृंखला पैदा करती हैं। मनमाने विभाजन अवधारणाओं के बीच महत्वपूर्ण संबंधों को तोड़ सकते हैं, जिससे अधूरे या भ्रामक उत्तर मिलते हैं। जब चंक बहुत बड़े हों, तो रिट्रीवल सिस्टम विशिष्ट संबंधित अंशों की पहचान करने में संघर्ष करते हैं, जबकि बहुत छोटे चंक अक्सर सटीक समझ के लिए पर्याप्त संदर्भ से वंचित रहते हैं। अंततः इससे उपयोगकर्ता संतुष्टि घटती है और सिस्टम की विश्वसनीयता प्रभावित होती है।
RAG पाइपलाइन में चंकिंग कहाँ फिट बैठती है
RAG पाइपलाइन में चंकिंग एक महत्वपूर्ण स्थान रखती है—यह कच्चे दस्तावेज़ इनजेशन और सार्थक नॉलेज रिट्रीवल के बीच पुल का काम करती है। एंड-टू-एंड RAG पाइपलाइन में, चंकिंग आमतौर पर दस्तावेज़ प्रीप्रोसेसिंग के बाद लेकिन एम्बेडिंग जनरेशन से पहले होती है। चंकिंग प्रक्रिया सीधे एम्बेडिंग स्टेप में फ़ीड करती है, जहाँ हर चंक को ऐसे वेक्टर निरूपणों में बदला जाता है जो सेमांटिक अर्थ को पकड़ते हैं।
RAG पाइपलाइन
चंकिंग, एम्बेडिंग, और रिट्रीवल के बीच संबंध एक सघन रूप से जुड़ा हुआ सिस्टम बनाता है जहाँ हर घटक की प्रभावशीलता दूसरों के प्रदर्शन पर निर्भर करती है.
जब मैं सुव्यवस्थित चंक बनाता हूँ, तो एम्बेडिंग मॉडल अधिक समृद्ध वेक्टर निरूपण जनरेट कर सकते हैं, जो बदले में उपयोगकर्ता के क्वेरी करने पर अधिक सटीक रिट्रीवल परिणाम सक्षम करते हैं। यह तालमेल दर्शाता है कि चंकिंग में सुधार अक्सर पूरी पाइपलाइन में मापने योग्य प्रदर्शन लाभों में बदल जाता है।
यह कहते हुए भी, कुछ नए दृष्टिकोण इस पारंपरिक क्रम को चुनौती देते हैं। उदाहरण के लिए, पोस्ट-चंकिंग पहले पूरे दस्तावेज़ को एम्बेड करता है और केवल क्वेरी समय पर उन्हें चंक करता है, और बाद में तेज़ एक्सेस के लिए परिणामों को कैश करता है। यह तरीका उन दस्तावेज़ों की प्री-प्रोसेसिंग से बचता है जिन पर कभी क्वेरी ही न आए, और क्वेरी-विशिष्ट चंकिंग की अनुमति देता है, लेकिन पहली बार एक्सेस पर विलंबता लाता है और अतिरिक्त इंफ्रास्ट्रक्चर की आवश्यकता होती है.
इसी तरह, late chunking सूक्ष्म-स्तरीय विभाजन को रिट्रीवल तक टाल देता है। कई छोटे चंक्स के लिए एम्बेडिंग पहले से कंप्यूट करने के बजाय, सिस्टम मोटे प्रतिनिधित्व (जैसे पूरे दस्तावेज़ या सेक्शंस) स्टोर करता है और क्वेरी आने पर उन्हें डायनामिकली विभाजित करता है। यह व्यापक संदर्भ को संरक्षित करता है और अग्रिम प्रोसेसिंग घटाता है, यद्यपि यह पहली क्वेरी में विलंबता लाता है और अतिरिक्त इंफ्रास्ट्रक्चर की मांग करता है।
दृष्टिकोण चाहे जो हो, चंकिंग रणनीतियों को उपयोग में लिए जा रहे भाषा मॉडल की संदर्भ विंडो—यानी एक समय में मॉडल जितना अधिकतम पाठ प्रोसेस और विचार कर सकता है—के अनुरूप होना चाहिए।
दस्तावेज़ चंकिंग की बुनियाद
अब जब आपको यह अंदाज़ा हो गया है कि चंकिंग क्या है और पाइपलाइन में यह कहाँ फिट होती है, तो प्रभावी चंकिंग रणनीतियों का मार्गदर्शन करने वाले मूल सिद्धांतों पर नज़र डालने का समय है। इन बुनियादों को समझने से एआई और RAG अनुप्रयोगों की विस्तृत शृंखला में चंकिंग लागू करने की ठोस ज़मीन मिलती है।
चंकिंग आवश्यक है क्योंकि भाषा मॉडलों की संदर्भ विंडो सीमित होती है। प्राथमिक लक्ष्य ऐसे चंक बनाना है जो स्वतंत्र रूप से अर्थपूर्ण हों, जबकि सामूहिक रूप से दस्तावेज़ की समग्र संरचना और उद्देश्य को संरक्षित रखें—और यह सब मॉडल की संदर्भ विंडो के भीतर।
हालाँकि, संदर्भ विंडो ही एकमात्र विचार नहीं है। जब मैं चंकिंग रणनीतियाँ डिज़ाइन करता हूँ, तो मैं तीन मूल सिद्धांतों पर ध्यान देता हूँ:
ये सिद्धांत मिलकर चंक्स को मॉडल के लिए उपयोगी और रिट्रीवल पाइपलाइंस के लिए कुशल बनाते हैं। इस आधार के साथ, अब मैं व्यवहार में उपयोग की जाने वाली सबसे आम चंकिंग रणनीतियों से गुज़र सकता हूँ।
चंकिंग रणनीतियों का अवलोकन
चंकिंग रणनीतियों का परिदृश्य विभिन्न कंटेंट प्रकारों, अनुप्रयोगों और प्रदर्शन आवश्यकताओं के अनुरूप विविध दृष्टिकोण प्रस्तुत करता है। नीचे की छवि में आप मुख्य चंकिंग विधियों का अवलोकन देख सकते हैं, जिन्हें मैं आगे के अनुभागों में विस्तार से कवर करूँगा।
चंकिंग रणनीतियों का अवलोकन
यह व्यापक अवलोकन सरल नियम-आधारित तरीकों से परिष्कृत एआई-चालित तकनीकों तक के विकास को दर्शाता है, जिनमें से प्रत्येक विशिष्ट अनुप्रयोगों और प्रदर्शन आवश्यकताओं के लिए अलग-अलग लाभ प्रदान करता है।
विस्तार से: सामान्य चंकिंग विधियाँ
चलिए सबसे व्यापक रूप से उपयोग की जाने वाली चंकिंग रणनीतियों पर क़रीब से नज़र डालते हैं। हर विधि की अपनी विशेष ताकतें, सीमाएँ, और सर्वोत्तम उपयोग परिदृश्य हैं। इन अंतरों को समझकर, मैं एक-सा सब पर लागू समाधान अपनाने के बजाय किसी विशेष प्रोजेक्ट के लिए सही दृष्टिकोण चुन सकता हूँ। हम सबसे सीधे तरीके से शुरू करेंगे: फिक्स्ड-साइज़ चंकिंग।
फिक्स्ड-साइज़ चंकिंग
फिक्स्ड-साइज़ चंकिंग सबसे सरल विधि है। यह पाठ को अक्षरों, शब्दों, या टोकन्स के आधार पर—बिना अर्थ या संरचना की परवाह किए—खंडित करती है।
फिक्स्ड-साइज़ चंकिंग का मुख्य लाभ संगणनात्मक दक्षता है—यह तेज़, पूर्वानुमेय, और लागू करने में आसान है। कमी यह है कि यह अक्सर सेमांटिक संरचना की अनदेखी करती है, जिससे रिट्रीवल सटीकता घट सकती है। मैं आम तौर पर इस विधि का उपयोग तब करता हूँ जब सरलता और गति सेमांटिक परिशुद्धता से अधिक महत्त्वपूर्ण हों और जब दस्तावेज़ की संरचना उतनी मायने न रखती हो। प्रदर्शन सुधारने के लिए, मैं अक्सर चंक्स के बीच ओवरलैप जोड़ता हूँ ताकि सीमाओं के पार संदर्भ संरक्षित रहे।
वाक्य-आधारित चंकिंग
इन कमियों में से कुछ को दूर करने का एक तरीका वाक्य-आधारित चंकिंग है, जो स्वाभाविक भाषा सीमाओं का सम्मान करती है, आमतौर पर पूर्ण विराम या प्रश्नचिह्न जैसे विराम-चिह्नों को पहचानकर।
यह दृष्टिकोण पठनीयता बनाए रखता है और सुनिश्चित करता है कि हर चंक आत्म-निहित रहे। फिक्स्ड-साइज़ चंकिंग की तुलना में, यह ऐसे खंड बनाता है जिन्हें मनुष्यों और मॉडलों दोनों के लिए समझना आसान होता है। हालाँकि, वाक्य की लंबाई बदलती रहती है, इसलिए चंक आकार असमान हो सकते हैं, और वे हमेशा गहरे सेमांटिक संबंधों को नहीं पकड़ पाते।
मुझे वाक्य-आधारित चंकिंग उन अनुप्रयोगों के लिए सबसे उपयोगी लगती है जो स्वाभाविक भाषा प्रवाह पर निर्भर करते हैं, जैसे मशीन अनुवाद, भावविश्लेषण, या संक्षेपण कार्य। लेकिन जब दस्तावेज़ वाक्यों से अधिक संरचित हों, तो रिक्रसिव चंकिंग एक लचीला विकल्प देती है।
रिकरसिव चंकिंग
रिकरसिव चंकिंग पहले बताई गई विधियों से अधिक उन्नत तकनीक है। यह चरणबद्ध तरीके से विभाजन नियम लागू करती है जब तक कि हर चंक परिभाषित आकार सीमा में न आ जाए। उदाहरण के लिए, मैं पहले सेक्शन हेडर से विभाजन कर सकता हूँ, फिर पैराग्राफ से, और अंत में वाक्यों से। प्रक्रिया तब तक जारी रहती है जब तक हर हिस्सा प्रबंधनीय और पूर्व-परिभाषित आकार के भीतर न आ जाए।
रिकरसिव चंकिंग
इस दृष्टिकोण का मुख्य लाभ लचीलापन है। टॉप-डाउन तरीके से काम करके, रिक्रसिव चंकिंग दस्तावेज़ संरचना को संरक्षित रखती है और साथ ही मॉडल की संदर्भ विंडो के साथ संगतता सुनिश्चित करती है। हालाँकि, इसे लागू करना अधिक जटिल हो सकता है, और परिणामों की गुणवत्ता इस पर निर्भर करती है कि स्रोत दस्तावेज़ कितना अच्छी तरह संरचित है।
मैं अक्सर रिक्रसिव चंकिंग का सहारा लेता हूँ जब मैं तकनीकी मैनुअल्स या अन्य ऐसे दस्तावेज़ों पर काम करता हूँ जिनमें स्पष्ट पदानुक्रम हो।
सेमांटिक चंकिंग
जहाँ रिक्रसिव तरीके संरचना पर निर्भर करते हैं, वहीं सेमांटिक चंकिंग ध्यान को अर्थ पर स्थानांतरित करती है, पाठ को वैचारिक सीमाओं के आधार पर विभाजित करती है। सेमांटिक चंकिंग एक अर्थ-सजग तकनीक है जो एम्बेडिंग्स या सेमांटिक समानता का उपयोग करके पाठ को वहाँ विभाजित करती है जहाँ विषय में बदलाव आता है। मनमानी सीमाओं के बजाय, चंक अर्थ द्वारा परिभाषित होते हैं.
एक तरीका यह है कि पाठ को वाक्यों में तोड़ा जाए और उनके बीच सेमांटिक समानता (उदा., एम्बेडिंग्स पर कोज़ाइन समानता) मापी जाए, और जब सुसंगति घटे तो नए चंक चिन्हित किए जाएँ। उन्नत इम्प्लीमेंटेशन क्लस्टरिंग तरीकों या सुपर्वाइज़्ड बाउंडरी-डिटेक्शन मॉडलों का उपयोग करते हैं, जो जटिल दस्तावेज़ों में विषय बदलावों को बेहतर पकड़ते हैं।
सेमांटिक चंकिंग
यह विधि सेमांटिक सुसंगति बनाए रखती है, यह सुनिश्चित करते हुए कि हर चंक एक ही विचार या थीम को कवर करता है। तकनीकों में एम्बेडिंग समानता, क्लस्टरिंग, या प्राकृतिक ब्रेकपॉइंट्स का पता लगाने के लिए अन्य सेमांटिक-दूरी गणनाएँ शामिल हो सकती हैं।
सबसे बड़ा लाभ है परिशुद्धता—सेमांटिक चंकिंग ऐसे चंक बनाती है जो रिट्रीवल के दौरान उपयोगकर्ता के इरादे के साथ क़रीबी से मेल खाते हैं। मुख्य कमी है संगणनात्मक लागत, क्योंकि इसमें प्रीप्रोसेसिंग के दौरान पाठ को एम्बेड करना पड़ता है। मैं सेमांटिक चंकिंग तब उपयोग करता हूँ जब सटीकता गति से अधिक महत्वपूर्ण हो, जैसे कानूनी या चिकित्सीय डोमेन्स के डोमेन-विशिष्ट RAG सिस्टम्स में।
स्लाइडिंग-विंडो चंकिंग
सेमांटिक चंकिंग, जो सेमांटिक सुसंगति पर ज़ोर देती है, के विपरीत, स्लाइडिंग-विंडो चंकिंग निरंतरता पर ज़ोर देती है—ओवरलैपिंग चंक्स द्वारा, जो पाठ पर एक विंडो को शिफ्ट करती है। उदाहरण के लिए, यदि मैं 500 टोकन के चंक आकार (विंडो) के साथ 250 का स्ट्राइड उपयोग करता हूँ, तो हर चंक अपने पिछले चंक के साथ आधा ओवरलैप करता है।
यह ओवरलैप चंक सीमाओं के पार संदर्भ को संरक्षित रखता है, जिससे किनारों पर महत्वपूर्ण जानकारी खोने का जोखिम घटता है। यह रिट्रीवल सटीकता भी बढ़ाता है, क्योंकि कई ओवरलैपिंग चंक किसी क्वेरी के जवाब में सतह पर आ सकते हैं। समझौता है अनावश्यकता—ओवरलैप स्टोरेज और प्रोसेसिंग लागत बढ़ाता है। स्लाइडिंग विंडोज़ विशेष रूप से असंरचित पाठ, जैसे चैट लॉग्स या पॉडकास्ट ट्रांसक्रिप्ट्स, के लिए उपयोगी हैं।
स्लाइडिंग-विंडो चंकिंग
जब मैं इस रणनीति को लागू करता हूँ, तो मैं आम तौर पर चंक्स के बीच 20–50% ओवरलैप का उपयोग करता हूँ ताकि सीमाओं के पार संदर्भ संरक्षित रहे, खासकर तकनीकी या संवादात्मक पाठ में। LangChain जैसे फ्रेमवर्क्स में 200–400 टोकन के चंक आकार सामान्य डिफ़ॉल्ट हैं, यद्यपि इसे मॉडल की संदर्भ सीमाओं और दस्तावेज़ प्रकार के आधार पर ट्यून किया जा सकता है। मैं इस दृष्टिकोण की अनुशंसा वहाँ करता हूँ जहाँ संदर्भ संरक्षण महत्वपूर्ण हो और स्टोरेज दक्षता कम महत्त्वपूर्ण।
पदानुक्रमित और संदर्भात्मक चंकिंग
जब केवल निरंतरता पर्याप्त नहीं होती और दस्तावेज़ संरचना को संरक्षित रखना आवश्यक होता है, तो पदानुक्रमित और संदर्भात्मक चंकिंग काम आती हैं।
पदानुक्रमित चंकिंग किसी दस्तावेज़ की पूरी संरचना—सेक्शंस से लेकर वाक्यों तक—को संरक्षित रखती है। एक सपाट सूची के बजाय, यह मूल पदानुक्रम को दर्शाने वाला एक वृक्ष बनाती है। हर चंक का अपने ऊपर और नीचे के स्तरों के साथ अभिभावक–शिशु संबंध होता है। उदाहरण के लिए, एक सेक्शन में कई पैराग्राफ होते हैं (अभिभावक → शिशु), और प्रत्येक पैराग्राफ में कई वाक्य हो सकते हैं।
रिट्रीवल के दौरान, यह संरचना लचीला नेविगेशन सक्षम करती है। यदि कोई क्वेरी वाक्य-स्तर के चंक से मेल खाती है, तो सिस्टम ऊपर की ओर विस्तार कर उसके अभिभावक पैराग्राफ या पूरे सेक्शन से अतिरिक्त संदर्भ दे सकता है। इसके विपरीत, यदि कोई व्यापक क्वेरी सेक्शन-स्तर के चंक से मेल खाती है, तो सिस्टम सबसे प्रासंगिक शिशु पैराग्राफ या वाक्य में ड्रिल-डाउन कर सकता है। यह बहु-स्तरीय रिट्रीवल परिशुद्धता और रिकॉल दोनों में सुधार करता है, क्योंकि मॉडल लौटाए गए कंटेंट के दायरे को अनुकूलित कर सकता है।
पदानुक्रमित चंकिंग
संदर्भात्मक चंकिंग एक कदम आगे बढ़कर चंक्स को हेडिंग्स, टाइमस्टैम्प्स, या स्रोत संदर्भ जैसी मेटाडेटा से समृद्ध करती है। यह अतिरिक्त जानकारी रिट्रीवल सिस्टम्स को परिणामों का अस्पष्टता-निवारण करने में महत्वपूर्ण संकेत देती है। उदाहरण के लिए, दो दस्तावेज़ों में लगभग समान वाक्य हो सकते हैं, लेकिन उनके सेक्शन शीर्षक या टाइमस्टैम्प यह तय कर सकते हैं कि किसी क्वेरी के लिए कौन अधिक प्रासंगिक है। मेटाडेटा उत्तरों को उनके स्रोत तक ट्रेस करना भी आसान बनाता है, जो विशेष रूप से विनियमित या अनुपालन-प्रेरित डोमेन्स में मूल्यवान है।
संदर्भात्मक चंकिंग
पदानुक्रमित और संदर्भात्मक चंकिंग का मुख्य लाभ सटीकता और लचीलापन है। समझौता यह है कि प्रीप्रोसेसिंग और रिट्रीवल लॉजिक दोनों में जटिलता बढ़ती है, क्योंकि सिस्टम को चंक्स के बीच संबंधों का प्रबंधन करना पड़ता है, उन्हें स्वतंत्र इकाइयों की तरह ट्रीट करने के बजाय। मैं इन दृष्टिकोणों की सिफारिश उन डोमेन्स के लिए करता हूँ जैसे कानूनी अनुबंध, वित्तीय रिपोर्ट, या तकनीकी विनिर्देश, जहाँ संरचना और ट्रेसबिलिटी का संरक्षित रहना आवश्यक है।
विषय-आधारित और मॉडैलिटी-विशिष्ट चंकिंग
सभी दस्तावेज़ सख्त पदानुक्रम का पालन नहीं करते, इसलिए विषय-आधारित या मॉडैलिटी-विशिष्ट चंकिंग संबंधित कंटेंट को समूहित करने का अधिक लचीला तरीका प्रदान करती है।
विषय-आधारित चंकिंग पाठ को थीमैटिक इकाइयों के अनुसार समूहित करती है, जिसके लिए टॉपिक मॉडलिंग (जैसे Latent Dirichlet Allocation, LDA) या एम्बेडिंग-आधारित क्लस्टरिंग एल्गोरिद्म का उपयोग कर सेमांटिक सीमाएँ पहचानी जाती हैं.
निर्धारित आकारों या संरचनात्मक मार्कर्स के बजाय लक्ष्य यह है कि किसी थीम से संबंधित सारा कंटेंट एक ही जगह रहे। यह दृष्टिकोण लंबे-फ़ॉर्म कंटेंट जैसे शोध रिपोर्ट या ऐसे लेखों के लिए अच्छा काम करता है जो अलग-अलग विषयों के बीच शिफ्ट होते हैं। क्योंकि हर चंक एक ही थीम पर केंद्रित रहता है, रिट्रीवल परिणाम उपयोगकर्ता के इरादे के साथ अधिक संरेखित होते हैं और असंबंधित सामग्री शामिल होने की संभावना कम होती है।
मॉडैलिटी-विशिष्ट चंकिंग विभिन्न कंटेंट प्रकारों के अनुरूप रणनीतियों को अनुकूलित करती है, यह सुनिश्चित करते हुए कि हर माध्यम की संरचना का सम्मान करते हुए सूचना का विभाजन हो। उदाहरण के लिए:
विषय-आधारित और मॉडैलिटी-विशिष्ट चंकिंग
मॉडैलिटी-विशिष्ट चंकिंग में मेटाडेटा विशेष रूप से महत्वपूर्ण भूमिका निभाता है। उदाहरण के लिए, टेबल रो पर कॉलम हेडर्स जोड़ना, छवि क्षेत्रों से कैप्शन लिंक करना, या ट्रांसक्रिप्ट में स्पीकर लेबल और टाइमस्टैम्प जोड़ना रिट्रीवल सिस्टम्स को सही चंक ढूँढने और उसे सही तरह से व्याख्यायित करने में मदद करता है। यह समृद्धि परिशुद्धता और उपयोगकर्ता भरोसा दोनों बढ़ाती है, क्योंकि परिणाम अपनी प्रासंगिकता समझाने वाले संदर्भ संकेतों के साथ आते हैं।
मैं मॉडैलिटी-विशिष्ट चंकिंग की अनुशंसा तब करता हूँ जब आप मल्टीमॉडल पाइपलाइंस या गैर-पारंपरिक दस्तावेज़ों के साथ काम कर रहे हों जो पाठ-आधारित रणनीतियों में सुव्यवस्थित रूप से फिट नहीं होते। यह सुनिश्चित करता है कि हर कंटेंट प्रकार का प्रतिनिधित्व इस तरह हो जो रिट्रीवल गुणवत्ता और उपयोगिता को अधिकतम करे।
एजेंटिक और एआई-चालित डायनामिक चंकिंग
इन नियम- और अर्थ-चालित तरीकों से आगे, एआई-चालित डायनामिक चंकिंग और एजेंटिक चंकिंग जैसी अग्रणी तकनीकें सीमाओं को और आगे बढ़ाती हैं।
एआई-चालित डायनामिक चंकिंग पूर्व-निर्धारित नियमों पर निर्भर रहने के बजाय सीधे ही एक बड़े भाषा मॉडल का उपयोग कर चंक सीमाएँ निर्धारित करती है। LLM दस्तावेज़ को स्कैन करता है, स्वाभाविक ब्रेकपॉइंट्स पहचानता है, और चंक आकार को अनुकूल रूप से समायोजित करता है.
घने हिस्सों को छोटे चंक्स में बाँटा जा सकता है, जबकि हल्के हिस्सों को समूहीकृत किया जा सकता है। इससे सेमांटिक रूप से सुसंगत चंक बनते हैं जो पूर्ण अवधारणाओं को कैप्चर करते हैं, और रिट्रीवल सटीकता में सुधार होता है। यह विधि उन उच्च-मूल्य, जटिल दस्तावेज़ों के साथ काम करते समय उपयुक्त है—जैसे कानूनी अनुबंध, अनुपालन मैनुअल्स, या शोध पत्र—जहाँ रिट्रीवल परिशुद्धता थ्रूपुट या लागत से अधिक महत्वपूर्ण होती है।
दूसरी ओर, एजेंटिक चंकिंग इस विचार को उच्च-स्तरीय तर्क जोड़कर आगे बढ़ाती है। केवल LLM को पाठ विभाजित करने देने के बजाय, एक एआई एजेंट दस्तावेज़ और उपयोगकर्ता के इरादे का मूल्यांकन करता है और तय करता है कि इसे कैसे चंक करना है.
एजेंट अलग-अलग सेक्शंस के लिए अलग रणनीतियाँ चुन सकता है। उदाहरण के लिए, एक मेडिकल रिपोर्ट को रोगी इतिहास, लैब परिणाम, और चिकित्सक नोट्स के अनुसार तोड़ना, जबकि कथात्मक विवरणों पर सेमांटिक सेगमेंटेशन लागू करना। यह कुछ चंक्स को टाइमस्टैम्प्स, डायग्नोसिस कोड्स, या क्लिनिशियन आइडेंटिफ़ायर्स जैसी मेटाडेटा से भी समृद्ध कर सकता है.
इस तरह, एजेंटिक चंकिंग एक ऑर्केस्ट्रेशन लेयर की तरह काम करती है: एजेंट पूरे दस्तावेज़ पर एक ही विधि लागू करने के बजाय चंकिंग दृष्टिकोणों का चयन या संयोजन डायनामिक रूप से करता है। परिणाम अधिक अनुरूपित और संदर्भ-सचेत चंकिंग होती है, यद्यपि इसकी कीमत अधिक जटिलता और संगणनात्मक आवश्यकताओं के रूप में चुकानी पड़ती है।
एजेंटिक और एआई-चालित डायनामिक चंकिंग
दोनों विधियाँ अत्याधुनिक और शक्तिशाली हैं, लेकिन वे अलग-अलग समस्याओं को संबोधित करती हैं। एआई-चालित डायनामिक चंकिंग इनजेशन के दौरान सेमांटिक रूप से संरेखित सीमाएँ बनाने पर केंद्रित होती है, जबकि एजेंटिक चंकिंग प्रत्येक अद्वितीय दस्तावेज़ के लिए चंकिंग रणनीतियों का बुद्धिमानी से चयन और संयोजन करने पर केंद्रित होती है। वे लेट चंकिंग से संबंधित हैं, जिसका उल्लेख लेख की शुरुआत में हुआ था, जो लंबे-संदर्भ मॉडलों का समर्थन इस तरह करता है कि पहले पूरे दस्तावेज़ को एम्बेड किया जाता है और फिर एम्बेडिंग स्तर पर चंकिंग लागू होती है.
ये दृष्टिकोण अत्यधिक अनुकूलनीय, सेमांटिक रूप से जागरूक चंक देते हैं। समझौते महत्वपूर्ण हैं: एआई-चालित चंकिंग महंगी और धीमी हो सकती है, जबकि एजेंटिक चंकिंग जटिलता और इंफ्रास्ट्रक्चर की एक और परत जोड़ती है। एआई-चालित डायनामिक चंकिंग उन परिदृश्यों के लिए सबसे उपयुक्त है जहाँ कंटेंट को चलते-चलते अर्थपूर्ण ढंग से विभाजित करने की आवश्यकता होती है, जबकि एजेंटिक चंकिंग तब चमकती है जब दस्तावेज़ व्यापक रूप से भिन्न हों और रणनीति-स्तरीय तर्क की मांग करें।
कार्यान्वयन संबंधी विचार
एक बार जब मैं चंकिंग रणनीति चुन लेता हूँ, तो अगला कदम कार्यान्वयन के विवरणों पर विचार करना होता है। व्यावहारिक कारक—जैसे चंक आकार, ओवरलैप प्रबंधन, और टोकन काउंटिंग—सीधे प्रभावित करते हैं कि सिस्टम कितना अच्छा प्रदर्शन करता है। बहुत बड़े हों तो चंक संदर्भ सीमाएँ पार कर सकते हैं; बहुत छोटे हों तो उनका अर्थ खो सकता है।
संगतता एक और प्रमुख चिंता है। अलग-अलग मॉडल और एम्बेडिंग समाधान अपनी-अपनी टोकनाइज़ेशन स्कीम और संदर्भ विंडो रखते हैं, इसलिए मैं सुनिश्चित करता हूँ कि मेरी चंकिंग प्रक्रिया इन अंतरों का हिसाब रखे.
इंफ्रास्ट्रक्चर की तरफ, मेमोरी प्रबंधन और संगणनात्मक दक्षता को नज़रअंदाज़ नहीं किया जा सकता; ओवरलैप अनावश्यकता बढ़ाता है, और रिक्रसिव या सेमांटिक तरीके प्रोसेसिंग ओवरहेड जोड़ सकते हैं। चंक विस्तार या मेटाडेटा समृद्धि जैसे पोस्ट-प्रोसेसिंग कदम संदर्भ पुनर्प्राप्त करने में मदद कर सकते हैं, लेकिन वे जटिलता भी बढ़ाते हैं।
इन बुनियादों के साथ, यह मापना महत्वपूर्ण है कि व्यवहार में चंकिंग रणनीतियाँ वास्तव में कितना अच्छा काम करती हैं।
प्रदर्शन मूल्यांकन और अनुकूलन
चंकिंग की प्रभावशीलता केवल सिद्धांत की बात नहीं—इसे स्पष्ट मैट्रिक्स के साथ मापा जाना चाहिए.
उदाहरण के लिए, संदर्भ प्रिसीजन मापती है कि रिट्रीव किए गए चंक्स में से कितने वास्तव में क्वेरी से संबंधित हैं, जबकि संदर्भ रिकॉल मापता है कि नॉलेज बेस से संबंधित कितने चंक्स सफलतापूर्वक रिट्रीव हुए.
दोनों मिलकर यह उजागर करते हैं कि कोई चंकिंग रणनीति रिट्रीवर को सही जानकारी खोजने में मदद करती है या नहीं.
इसी से क़रीबी रूप से जुड़ा है संदर्भ प्रासंगिकता, जो इस पर केंद्रित होती है कि रिट्रीव किए गए चंक्स उपयोगकर्ता के इरादे के साथ कितनी अच्छी तरह मेल खाते हैं—यह विशेष रूप से तब उपयोगी होती है जब top-K जैसी रिट्रीवल सेटिंग्स को ट्यून किया जा रहा हो।
अन्य चंक-विशिष्ट मैट्रिक्स, जैसे चंक उपयोग, मापते हैं कि मॉडल ने वास्तव में अपने उत्तर को जनरेट करने के लिए किसी चंक की सामग्री का कितना उपयोग किया; यदि उपयोग कम है, तो चंक बहुत व्यापक या शोरयुक्त हो सकता है.
दूसरी ओर, चंक एट्रिब्यूशन यह मूल्यांकित करता है कि सिस्टम ने अंतिम उत्तर में योगदान देने वाले चंक्स की सही पहचान की या नहीं। ये चंक-स्तरीय मूल्यांकन पुष्टि करने में मदद करते हैं कि चंक्स न केवल रिट्रीव हुए बल्कि सार्थक रूप से लागू भी हुए।
अनुकूलन भी एक प्रमुख भूमिका निभाता है और अक्सर गति और सटीकता के बीच संतुलन का अर्थ रखता है। चंक आकार, ओवरलैप प्रतिशत, और रिट्रीवल पैरामीटर्स के साथ प्रयोग करना—ताकि संगणनात्मक दक्षता और सेमांटिक समृद्धि दोनों में सुधार हो—महत्वपूर्ण है। इसके अतिरिक्त, A/B परीक्षण आवश्यक है क्योंकि यह ठोस फीडबैक देता है, जबकि क्रमिक समायोजन यह सुनिश्चित करते हैं कि रणनीति ठहरने के बजाय समय के साथ बेहतर होती जाए।
जहाँ प्रदर्शन ट्यूनिंग सामान्य-उद्देश्य सिस्टम्स में सुधार ला सकती है, वहीं डोमेन-विशिष्ट अनुप्रयोग अपनी अनूठी चुनौतियाँ प्रस्तुत करते हैं।
चंकिंग के डोमेन-विशिष्ट अनुप्रयोग
विभिन्न उद्योग चंकिंग रणनीतियों पर अलग-अलग मांगें रखते हैं। वित्त में, वार्षिक रिपोर्ट या फाइलिंग जैसे दस्तावेज़ घने और तकनीकी होते हैं, इसलिए ऐसी चंकिंग रणनीति चुनना अनिवार्य है जो संख्यात्मक तालिकाओं, हेडर्स, और फुटनोट्स को संरक्षित रखे। कानूनी और तकनीकी दस्तावेज़ भी समान चुनौतियाँ पेश करते हैं—सटीकता और संरचना पर समझौता नहीं किया जा सकता, जो पदानुक्रमित या संदर्भ-समृद्ध दृष्टिकोणों को विशेष रूप से मूल्यवान बनाता है।
चिकित्सा और मल्टीमॉडल दस्तावेज़ उभरती ज़रूरतें पेश करते हैं। किसी रोगी का रिकॉर्ड क्लिनिकल नोट्स, लैब परिणामों, और इमेजिंग डेटा को मिला सकता है, जबकि मल्टीमॉडल दस्तावेज़ टेक्स्ट को चार्ट्स या ऑडियो ट्रांसक्रिप्ट्स के साथ एकीकृत कर सकते हैं। यहाँ, मॉडैलिटी-विशिष्ट चंकिंग सुनिश्चित करती है कि हर डेटा प्रकार का विभाजन इस तरह हो जो अर्थ को संरक्षित रखे और मॉडैलिटीज़ के बीच समंजन बनाए रखे।
डोमेन चाहे जो हो, कुछ सर्वोत्तम प्रथाओं का पालन चंकिंग रणनीतियों को अधिक विश्वसनीय और बनाए रखने में आसान बनाता है।
सर्वोत्तम प्रथाएँ और दिशा-निर्देश
सही चंकिंग रणनीति का चयन कई कारकों पर निर्भर करता है: कंटेंट प्रकार, क्वेरी की जटिलता, उपलब्ध संसाधन, और मॉडल की संदर्भ विंडो का आकार। मैं शायद ही कभी हर मामले में एक ही विधि पर निर्भर करता हूँ—इसके बजाय, मैं दृष्टिकोण को सिस्टम की ज़रूरतों के अनुरूप ढालता हूँ।
दीर्घकालिक सफलता के लिए क्रमिक अनुकूलन केंद्रीय है। चंकिंग की प्रभावशीलता का लगातार परीक्षण होना चाहिए, वास्तविक क्वेरीज़ से परिणामों का सत्यापन और फीडबैक के आधार पर समायोजन के साथ। क्रॉस-वैलिडेशन यह सुनिश्चित करने में मदद करता है कि सुधार केवल एकमुश्त सफलताएँ नहीं, बल्कि अलग-अलग उपयोग मामलों में भी कायम रहें।
अंततः, मैं चंकिंग को एक विकसित होती प्रणाली की तरह ट्रीट करने की सलाह देता हूँ। अच्छा दस्तावेजीकरण, नियमित परीक्षण, और सतत रखरखाव ड्रिफ्ट को रोकने में मदद करते हैं और सुनिश्चित करते हैं कि डेटा और मॉडल दोनों बदलते रहने पर भी पाइपलाइंस मज़बूत रहें।
निष्कर्ष
चंकिंग एक प्रीप्रोसेसिंग विवरण जैसी लग सकती है, लेकिन जैसा कि आपने इस गाइड में देखा, यह बुनियादी तौर पर निर्धारित करती है कि retrieval-augmented generation सिस्टम कैसे प्रदर्शन करते हैं। फिक्स्ड-साइज़ और वाक्य-आधारित तरीकों से लेकर उन्नत सेमांटिक, एजेंटिक, और एआई-चालित रणनीतियों तक, हर दृष्टिकोण सरलता, सटीकता, दक्षता, और अनुकूलनशीलता के बीच अलग-अलग समझौते प्रदान करता है।
कोई एकल विधि हर परिदृश्य में काम नहीं करती। सही चंकिंग रणनीति कंटेंट प्रकार, भाषा मॉडल की क्षमताओं, और अनुप्रयोग के लक्ष्यों पर निर्भर करती है। सेमांटिक सुसंगति, संदर्भ संरक्षण, और संगणनात्मक दक्षता जैसे सिद्धांतों पर ध्यान देकर, आप ऐसे चंक्स डिज़ाइन कर सकते हैं जो रिट्रीवल परिशुद्धता बढ़ाएँ, प्रदर्शन को अनुकूलित करें, और अधिक विश्वसनीय परिणाम सुनिश्चित करें।
आगे देखते हुए, चंकिंग रणनीतियाँ और भी अधिक डायनामिक, अनुकूलनीय, और मॉडल-सचेत होने की संभावना है। जैसे-जैसे लंबे-संदर्भ मॉडल विकसित होंगे और मूल्यांकन टूल परिपक्व होंगे, मुझे उम्मीद है कि चंकिंग एक स्थिर प्रीप्रोसेसिंग स्टेप से आगे बढ़कर एक बुद्धिमान, संदर्भ-संवेदनशील प्रक्रिया बन जाएगी जो निरंतर उपयोग से सीखती रहेगी.
जो भी लोग RAG सिस्टम्स के साथ निर्माण कर रहे हैं, उनके लिए सटीक, कुशल, और भविष्य-तैयार रिट्रीवल पाइपलाइंस बनाने हेतु चंकिंग में महारत आवश्यक है।
सीखना जारी रखने के लिए, निम्न संसाधनों को अवश्य देखें: