रीट्रीवल-ऑग्मेंटेड जेनरेशन (RAG) दस्तावेज़ रिट्रीवल को प्राकृतिक भाषा जेनरेशन से जोड़ता है, जिससे अधिक सटीक और संदर्भ-संवेदी उत्तर मिलते हैं।
बेसिक RAG प्रभावी है, लेकिन यह जटिल क्वेरी, हेल्यूसिनेशन, और मल्टी-टर्न बातचीत में संदर्भ बनाए रखने में संघर्ष करता है।
इस ब्लॉग में, मैं उन्नत तकनीकों का अन्वेषण करूँगा जो रिट्रीवल सटीकता, जेनरेशन गुणवत्ता, और समग्र सिस्टम प्रदर्शन में सुधार करके इन चुनौतियों का समाधान करती हैं।
यदि आप इसे इंटरव्यू की तैयारी में पढ़ रहे हैं, तो टॉप 30 RAG इंटरव्यू प्रश्न और उत्तर वाला लेख अवश्य देखें।
बेसिक RAG सिस्टम की सीमाएँ
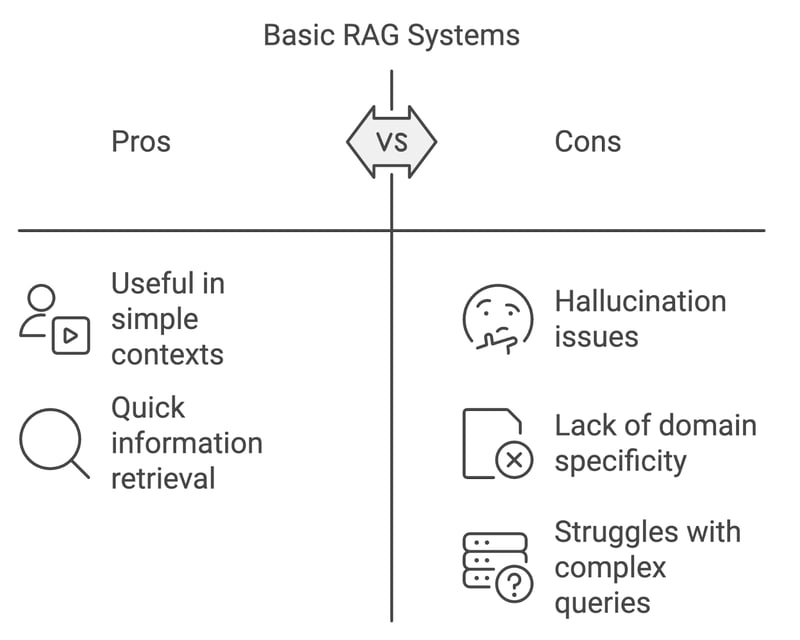
बेसिक RAG इम्प्लीमेंटेशन उपयोगी हो सकते हैं, लेकिन अधिक मांग वाले संदर्भों में इनकी कुछ सीमाएँ होती हैं।
हेल्यूसिनेशन
सबसे प्रमुख समस्याओं में से एक हेल्यूसिनेशन है, जहाँ मॉडल तथ्यात्मक रूप से गलत या रिट्रीव किए गए दस्तावेज़ों द्वारा असमर्थित सामग्री बना देता है। यह सिस्टम की विश्वसनीयता को कमजोर कर सकता है, खासकर उन क्षेत्रों में जहाँ उच्च सटीकता आवश्यक है, जैसे चिकित्सा या कानून।
डोमेन-विशिष्टता की कमी
मानक RAG मॉडल डोमेन-विशिष्ट क्वेरियों को संभालते समय संघर्ष कर सकते हैं। यदि रिट्रीवल और जेनरेशन प्रक्रियाओं को विशेष डोमेनों की बारीकियों के अनुसार नहीं ढाला गया, तो सिस्टम अप्रासंगिक या गलत जानकारी रिट्रीव करने का जोखिम उठाता है।
जटिल या मल्टी-टर्न बातचीत को संभालना
एक अन्य चुनौती जटिल, मल्टी-स्टेप क्वेरियों या मल्टी-टर्न बातचीत का प्रबंधन है। बेसिक RAG सिस्टम अक्सर इंटरैक्शन में संदर्भ बनाए रखने में चूकते हैं, जिससे बिखरे हुए या अधूरे उत्तर मिलते हैं। जैसे-जैसे उपयोगकर्ता क्वेरियाँ अधिक जटिल होती जाती हैं, RAG सिस्टम को इस बढ़ती जटिलता को संभालने के लिए विकसित होना होगा।
आरेख napkin.ai से जनरेट किया गया
उन्नत रिट्रीवल तकनीकें
उन्नत रिट्रीवल तकनीकें रिट्रीव किए गए दस्तावेज़ों की प्रासंगिकता और दायरे दोनों को बढ़ाने पर केंद्रित हैं। घनी रिट्रीवल, हाइब्रिड सर्च, री-रैंकिंग, और क्वेरी एक्सपैंशन जैसी तकनीकें कीवर्ड-आधारित रिट्रीवल की सीमाओं को संबोधित करती हैं।
घनी रिट्रीवल और हाइब्रिड सर्च
घनी रिट्रीवल और हाइब्रिड सर्च रिट्रीवल सटीकता और प्रासंगिकता में सुधार के लिए प्रमुख तकनीकें हैं। TF-IDF या BM25 जैसे तरीके तब अर्थ-समझ में चूकते हैं जब क्वेरियाँ दस्तावेज़ों से अलग तरीके से लिखी जाती हैं।
DPR (Dense Passage Retrieval) जैसी घनी रिट्रीवल डीप लर्निंग का उपयोग करके क्वेरियों और दस्तावेज़ों को घने वेक्टर निरूपण में मैप करती है, जिससे सटीक कीवर्ड से आगे जाकर अर्थ पकड़ा जाता है।
हाइब्रिड सर्च स्पार्स और डेंस रिट्रीवल को मिलाकर, कीवर्ड-आधारित मैचिंग और सिमेंटिक समानता को संयोजित करता है, जिससे सटीकता और रिकॉल में संतुलन बनता है और जटिल क्वेरियों के लिए यह प्रभावी बनता है।
री-रैंकिंग
री-रैंकिंग एक उन्नत तकनीक है जिसका उपयोग जेनरेशन कंपोनेंट तक भेजने से पहले रिट्रीव किए गए दस्तावेज़ों की सूची को परिष्कृत करने के लिए किया जाता है। एक सामान्य RAG सिस्टम में, शुरुआती रिट्रीवल चरण में प्रासंगिकता में भिन्नता वाले दस्तावेज़ों का बड़ा सेट आ सकता है।
री-रैंकिंग का काम इन दस्तावेज़ों को फिर से क्रमित करना है ताकि सबसे प्रासंगिक दस्तावेज़ों को भाषा मॉडल द्वारा उपयोग के लिए प्राथमिकता दी जाए। री-रैंकिंग क्वेरी-दस्तावेज़ समानता पर आधारित साधारण स्कोरिंग से लेकर प्रत्येक दस्तावेज़ की प्रासंगिकता की भविष्यवाणी करने के लिए प्रशिक्षित जटिल मशीन लर्निंग मॉडलों तक से की जा सकती है।
आप इस ट्यूटोरियल में RankGPT के साथ री-रैंकिंग लागू करना सीख सकते हैं।
क्वेरी एक्सपैंशन
क्वेरी एक्सपैंशन में उपयोगकर्ता की क्वेरी को अतिरिक्त शब्दों से समृद्ध करना शामिल है, जिससे प्रासंगिक दस्तावेज़ों के रिट्रीवल की संभावना बढ़ जाती है। यह इन तरीकों से किया जा सकता है:
- समानार्थक विस्तार: मूल क्वेरी में समानार्थी या निकट से संबंधित शब्द जोड़ना ताकि ऐसे दस्तावेज़ भी पकड़े जाएँ जो अलग शब्दावली का उपयोग करते हों पर अर्थ समान हो।
- वैचारिक विस्तार: क्वेरी को व्यापक या संबंधित अवधारणाओं तक बढ़ाना, जिससे विविध लेकिन प्रासंगिक दस्तावेज़ सतह पर आएँ।
उदाहरण के लिए, यदि मूल क्वेरी “स्वास्थ्य सेवा में आर्टिफिशियल इंटेलिजेंस” है, तो क्वेरी एक्सपैंशन में “AI”, “मशीन लर्निंग” या “हेल्थ टेक” जैसे संबंधित शब्द शामिल हो सकते हैं, जिससे रिट्रीवल का दायरा बढ़ जाए।
RAG सिस्टम में प्रासंगिकता और गुणवत्ता का अनुकूलन
RAG सिस्टम में केवल दस्तावेज़ रिट्रीव करना पर्याप्त नहीं है; इन दस्तावेज़ों की प्रासंगिकता और गुणवत्ता सुनिश्चित करना अंतिम आउटपुट को बेहतर बनाने की कुंजी है। इसके लिए रिट्रीव की गई सामग्री को परिष्कृत और फ़िल्टर करने वाली उन्नत तकनीकें आवश्यक हैं।
ये तरीके शोर को कम करते हैं, प्रासंगिकता बढ़ाते हैं, और जेनरेशन के दौरान भाषा मॉडल का ध्यान सबसे महत्वपूर्ण जानकारी पर केंद्रित करते हैं।
उन्नत फ़िल्टरिंग तकनीकें
उन्नत फ़िल्टरिंग तकनीकें मेटाडेटा या कंटेंट-आधारित नियमों का उपयोग करके अप्रासंगिक या निम्न-गुणवत्ता वाले दस्तावेज़ों को बाहर करती हैं, जिससे केवल सबसे प्रासंगिक परिणाम आगे भेजे जाते हैं।
- मेटाडेटा-आधारित फ़िल्टरिंग: दस्तावेज़ों को तारीख, लेखक, डोमेन, या दस्तावेज़ प्रकार जैसे मेटाडेटा के आधार पर फ़िल्टर किया जा सकता है। कानूनी या चिकित्सा अनुप्रयोगों में यह सुनिश्चित करता है कि केवल नवीनतम या सबसे प्रामाणिक स्रोत उपयोग हों।
- कंटेंट-आधारित फ़िल्टरिंग: यह स्वयं दस्तावेज़ों की सामग्री का आकलन करता है और ऐसे दस्तावेज़ों को बाहर करता है जो कुछ प्रासंगिकता थ्रेशहोल्ड को पूरा नहीं करते। इसमें क्वेरी से निम्न सिमेंटिक समानता वाले या क्वेरी से संबंधित प्रमुख वाक्यांश/शब्द न रखने वाले दस्तावेज़ों को फ़िल्टर करना शामिल हो सकता है।
कॉन्टेक्स्ट डिस्टिलेशन
कॉन्टेक्स्ट डिस्टिलेशन रिट्रीव किए गए दस्तावेज़ों का सार-संक्षेप या संकुचन करने की प्रक्रिया है, ताकि भाषा मॉडल का ध्यान सबसे महत्वपूर्ण सूचनाओं पर रहे। यह तब उपयोगी है जब रिट्रीव की गई सामग्री में बहुत अधिक अप्रासंगिक भाग हों या क्वेरी में जटिल, मल्टी-स्टेप तर्क शामिल हो।
संदर्भ को डिस्टिल करके, सिस्टम रिट्रीव किए गए दस्तावेज़ों से प्रमुख अंतर्दृष्टि और सबसे प्रासंगिक अंश निकालता है, जिससे भाषा मॉडल के पास काम करने के लिए सबसे स्पष्ट और उपयुक्त जानकारी रहती है।
जेनरेशन प्रक्रिया का अनुकूलन
एक बार प्रासंगिक दस्तावेज़ रिट्रीव और परिष्कृत हो जाएँ, तो RAG सिस्टम में अगला कदम जेनरेशन प्रक्रिया है। भाषा मॉडल द्वारा उत्तर जनरेट करने के तरीके का अनुकूलन सटीकता, सामंजस्य और प्रासंगिकता स्थापित करने के लिए आवश्यक है।
प्रॉम्प्ट इंजीनियरिंग
प्रॉम्प्ट इंजीनियरिंग उस प्रक्रिया को संदर्भित करता है जिसमें भाषा मॉडल को दिए जाने वाले प्रॉम्प्ट डिज़ाइन और संरचित किए जाते हैं। प्रॉम्प्ट की गुणवत्ता सीधे मॉडल के जनरेटेड आउटपुट की गुणवत्ता को प्रभावित करती है, क्योंकि प्रॉम्प्ट जेनरेशन कार्य के लिए शुरुआती निर्देश या संदर्भ प्रदान करता है।
आरेख napkin.ai से जनरेट किया गया
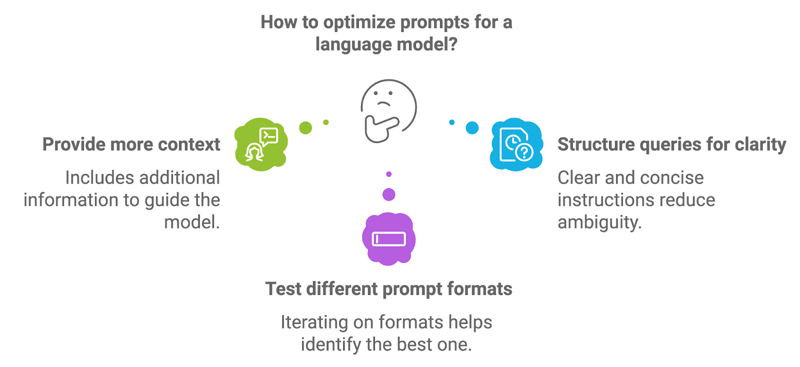
प्रॉम्प्ट को ऑप्टिमाइज़ करने के लिए, डेवलपर्स कुछ अलग-अलग तरीकों के साथ प्रयोग कर सकते हैं।
अधिक संदर्भ प्रदान करना
स्पष्ट निर्देश या प्रमुख शब्दों जैसी अतिरिक्त जानकारी शामिल करना मॉडल को अधिक सटीक और संदर्भानुकूल उत्तरों की ओर मार्गदर्शन कर सकता है। उदाहरण के लिए, एक चिकित्सा RAG सिस्टम में, प्रॉम्प्ट स्पष्ट रूप से रिट्रीव किए गए दस्तावेज़ों के आधार पर निदान सारांश देने का अनुरोध कर सकता है।
स्पष्टता के लिए क्वेरियों की संरचना
अच्छी तरह संरचित प्रॉम्प्ट, जिनमें स्पष्ट और संक्षिप्त निर्देश हों, अस्पष्टता को कम करते हैं और अधिक केंद्रित जेनरेशन परिणाम देते हैं। प्रॉम्प्ट को सीधे प्रश्न या अनुरोध के रूप में व्यक्त करना अक्सर बेहतर परिणाम देता है।
विभिन्न प्रॉम्प्ट फ़ॉर्मैट का परीक्षण
प्रश्नों को पुनः व्यक्त करना, विशिष्टता के स्तर को समायोजित करना, या उदाहरण प्रदान करना जैसी प्रॉम्प्ट शैलियों पर पुनरावृत्ति करके, किसी विशेष उपयोग-प्रकरण के लिए सर्वोत्तम परिणाम देने वाले फ़ॉर्मैट की पहचान की जा सकती है।
इस ब्लॉग में और जानें: प्रॉम्प्ट ऑप्टिमाइज़ेशन तकनीकें।
मल्टी-स्टेप रीजनिंग
कई क्वेरियाँ, खासकर शोध, कानून या तकनीकी सहायता जैसे क्षेत्रों में, एक से अधिक चरणों में होती हैं या जटिल तर्क की मांग करती हैं। मल्टी-स्टेप रीजनिंग वह प्रक्रिया है जिसमें सिस्टम एक जटिल क्वेरी को प्रबंधनीय उप-कार्यों में तोड़ता है और व्यापक उत्तर तक पहुँचने के लिए उन्हें क्रमिक रूप से संसाधित करता है।
हम RAG सिस्टम के भीतर मल्टी-स्टेप रीजनिंग को कई तरीकों से लागू कर सकते हैं:
- रिट्रीवल और जेनरेशन की चेनिंग: कुछ मामलों में, रिट्रीवल और जेनरेशन चरणों को एक साथ चेन करके मल्टी-स्टेप रीजनिंग हासिल की जा सकती है। शुरुआती क्वेरी प्रोसेस करने के बाद, सिस्टम अंतिम उत्तर देने से पहले फॉलो-अप क्वेरी बना सकता है या अतिरिक्त जानकारी माँग सकता है।
- मध्यवर्ती चरणों को शामिल करना: ऐसी क्वेरियों के लिए जिनमें कई दस्तावेज़ों या विषयों पर तर्क करना आवश्यक हो, सिस्टम प्रत्येक चरण के लिए अलग-अलग दस्तावेज़ सेट रिट्रीव कर सकता है और धीरे-धीरे अधिक सूक्ष्म और पूर्ण उत्तर बना सकता है।
- मल्टी-हॉप प्रश्नोत्तर: यह तरीका सिस्टम को रिट्रीव की गई विभिन्न सूचनाओं के टुकड़ों के बीच तार्किक कड़ियाँ बनाने देता है, जिससे ऐसे उच्च-स्तरीय प्रश्न संभाले जा सकें जिनमें विभिन्न तथ्यों या डेटा पॉइंट्स के बीच संबंध शामिल हों।
हेल्यूसिनेशन का समाधान
संक्षेप में बताया गया था कि जेनरेशन मॉडलों, जिनमें RAG सिस्टम भी शामिल हैं, की मुख्य चुनौतियों में से एक हेल्यूसिनेशन है। RAG सिस्टम में हेल्यूसिनेशन को कम करने के कई तरीके हैं:
- रिट्रीव किए गए दस्तावेज़ों पर ग्राउंडिंग: हेल्यूसिनेशन घटाने का एक प्रभावी तरीका यह सुनिश्चित करना है कि जेनरेशन मॉडल रिट्रीव्ड कंटेंट पर कड़ी तरह से आधारित हो। इसका मतलब है कि मॉडल को दस्तावेज़ों की वास्तविक सामग्री के आधार पर ही उत्तर जनरेट करने की कंडीशनिंग दी जाए, न कि बाहरी, प्री-ट्रेंड जानकारी पर निर्भरता हो।
- संदर्भ कंडीशनिंग: संदर्भ कैसे प्रदान किया जाता है, इसे परिष्कृत करके डेवलपर्स जेनरेशन प्रक्रिया को बेहतर नियंत्रित कर सकते हैं। इसमें मॉडल को देने से पहले रिट्रीव्ड दस्तावेज़ों के अप्रासंगिक भागों को फ़िल्टर करना या मॉडल को प्रमुख जानकारी पर ध्यान केंद्रित करने हेतु विशिष्ट निर्देश देना शामिल हो सकता है।
- फ़ीडबैक लूप: ऐसा फीडबैक मैकेनिज़्म लागू करना जिसमें सिस्टम जनरेटेड आउटपुट को रिट्रीव्ड दस्तावेज़ों के साथ सटीकता के लिए जाँचता है, उपयोगकर्ता तक पहुँचने से पहले हेल्यूसिनेशन पकड़ने में मदद कर सकता है। यह अतिरिक्त सत्यापन कदम सिस्टम की विश्वसनीयता को काफी बढ़ा सकता है।
जटिल क्वेरी और बातचीत को संभालना
जैसे-जैसे RAG सिस्टम वास्तविक-world कार्यों में अधिक उपयोग हो रहे हैं, उन्हें जटिल, मल्टी-टर्न इंटरैक्शन और अस्पष्ट क्वेरियों को संभालने में सक्षम होना चाहिए।
मल्टी-टर्न बातचीत का प्रबंधन
कन्वर्सेशनल RAG सिस्टम में प्रमुख चुनौतियों में से एक कई इंटरैक्शन के दौरान जानकारी के प्रवाह का प्रबंधन करना है। कई रोज़मर्रा के परिदृश्यों, जैसे ग्राहक सहायता या चल रही तकनीकी चर्चाओं में, उपयोगकर्ता मल्टी-टर्न बातचीत में शामिल होते हैं जहाँ संदर्भ को कई एक्सचेंजों में बनाए रखना पड़ता है।
सिस्टम द्वारा बातचीत के प्रासंगिक हिस्सों का ट्रैक और स्मरण रखना सुसंगत और एकरूप उत्तर देने की कुंजी है। मल्टी-टर्न बातचीत को प्रभावी ढंग से संभालने के लिए, RAG सिस्टम निम्न तकनीकों का उपयोग कर सकते हैं:
- कन्वर्सेशन हिस्ट्री ट्रैकिंग: बातचीत के इतिहास का संरचित निरूपण बनाए रखना महत्वपूर्ण भूमिका निभाता है। इसमें पिछली क्वेरियों और जनरेटेड उत्तरों जैसी प्रमुख इंटरैक्शन को सहेजना शामिल हो सकता है, ताकि उन्हें आगे के टर्न में संदर्भ के रूप में उपयोग किया जा सके।
- कॉन्टेक्स्ट विंडोइंग: बातचीत के आगे बढ़ने पर गतिशील रूप से अपडेट होने वाली संदर्भ विंडो का उपयोग सिस्टम को इंटरैक्शन के सबसे प्रासंगिक भागों पर ध्यान केंद्रित करने देता है। बातचीत इतिहास के दायरे को हालिया या महत्वपूर्ण एक्सचेंजों तक सीमित करके, सिस्टम बिना अत्यधिक जानकारी से मॉडल को बोझिल किए केंद्रित रह सकता है।
- रिट्रीवल-आधारित मेमोरी: विशेष रूप से जटिल या लंबी बातचीत के लिए, RAG सिस्टम रिट्रीवल-आधारित मेमोरी मैकेनिज़्म लागू कर सकते हैं। यह तरीका आवश्यकता पड़ने पर बातचीत इतिहास के प्रासंगिक हिस्सों को चयनित रूप से रिट्रीव करने देता है, जिससे केवल सबसे उपयुक्त संदर्भ भाषा मॉडल को दिया जाए।
अस्पष्ट या जटिल क्वेरियों को संभालना
उपयोगकर्ता क्वेरियाँ हमेशा सीधी नहीं होतीं; कई बार वे अस्पष्ट, दोअर्थी, या जटिल तर्क सहित होती हैं जो RAG सिस्टम की क्षमताओं को चुनौती देती हैं।
स्पष्टीकरण के माध्यम से डिसऐम्बिगुएशन
अस्पष्टता दूर करने का एक तरीका यह है कि सिस्टम उपयोगकर्ता से स्पष्टीकरण माँगे। उदाहरण के लिए, यदि क्वेरी बहुत धुंधली है, तो सिस्टम अधिक विशिष्टताओं के लिए फॉलो-अप प्रश्न जनरेट कर सकता है। यह इंटरैक्टिव प्रक्रिया रिट्रीवल और जेनरेशन चरणों पर आगे बढ़ने से पहले उपयोगकर्ता के इरादे को सीमित करने में मदद करती है।
बहुमुखी क्वेरी प्रोसेसिंग
ऐसी जटिल क्वेरियों के लिए जिनमें कई पहलू या उप-विषय शामिल हों, सिस्टम क्वेरी को छोटे, अधिक प्रबंधनीय भागों में तोड़ सकता है। इसमें चरणों में जानकारी रिट्रीव करना शामिल है, जहाँ हर चरण क्वेरी के एक विशिष्ट पहलू को संबोधित करता है। अंतिम आउटपुट कई रिट्रीवल और जेनरेशन चरणों से संश्लेषित होता है, जिससे क्वेरी के सभी घटक कवर हो सकें।
संदर्भ संकेतों का उपयोग
अस्पष्टता को संभालने के लिए, सिस्टम क्वेरी या बातचीत इतिहास से संदर्भ संकेतों का उपयोग कर सकता है। पिछली इंटरैक्शन या संबंधित विषयों का विश्लेषण करके, RAG सिस्टम उपयोगकर्ता के इरादे का अधिक सटीक अनुमान लगा सकता है, जिससे अप्रासंगिक या गलत उत्तरों की संभावना कम होती है।
जटिल क्वेरियों के लिए उन्नत रिट्रीवल तकनीकें
विशेष रूप से चुनौतीपूर्ण क्वेरियों के लिए, RAG सिस्टम मल्टी-हॉप प्रश्नोत्तर जैसी उन्नत रिट्रीवल विधियाँ लागू कर सकते हैं, जहाँ सिस्टम कई दस्तावेज़ों से जानकारी रिट्रीव करता है और उनके बीच तार्किक कड़ियाँ बनाकर जटिल क्वेरियों का उत्तर देता है।
सामान्य RAG चुनौतियों का समाधान
जहाँ RAG सिस्टम सूचना रिट्रीवल और टेक्स्ट जेनरेशन के लिए शक्तिशाली समाधान प्रदान करते हैं, वहीं वे कुछ विशिष्ट चुनौतियाँ भी पेश करते हैं जिनका समाधान आवश्यक है।
जेनरेशन में बायस से निपटना
बायस भाषा मॉडलों में, जिनमें RAG सिस्टम भी शामिल हैं, एक ज्ञात समस्या है जो जनरेटेड आउटपुट की निष्पक्षता और सटीकता को नकारात्मक रूप से प्रभावित कर सकती है। बायस रिट्रीवल और जेनरेशन दोनों चरणों से सिस्टम में प्रवेश कर सकता है, जिससे अंतर्निहित डेटासेट में मौजूद सामाजिक, सांस्कृतिक, या डोमेन-विशिष्ट पक्षपात को दर्शाने वाले विकृत या भेदभावपूर्ण आउटपुट उत्पन्न हो सकते हैं।
RAG सिस्टम में बायस को कम करने के लिए हम कई रणनीतियाँ अपना सकते हैं:
- बायस-अवेयर रिट्रीवल: रिट्रीवल चरण में बायस तब उत्पन्न हो सकता है जब रिट्रीव्ड दस्तावेज़ असंतुलित रूप से कुछ दृष्टिकोणों, जनसांख्यिकी या परिप्रेक्ष्यों का प्रतिनिधित्व करें। लेखन, तारीख सीमा या भौगोलिकता के आधार पर स्रोतों के संतुलन जैसे फ़िल्टरिंग तकनीकें लागू करके, RAG सिस्टम पक्षपाती रिट्रीवल की संभावना को घटा सकते हैं।
- जेनरेशन में निष्पक्षता: जेनरेशन चरण में बायस तब हो सकता है जब भाषा मॉडल पक्षपाती कंटेंट पर प्रशिक्षित हो या कुछ दृष्टिकोणों को बढ़ा-चढ़ाकर पेश करे। इसे कम करने का एक तरीका यह है कि मॉडल को क्यूरेटेड, निम्न-बायस डेटासेट पर फाइन-ट्यून किया जाए, ताकि जनरेटेड उत्तर यथासंभव तटस्थ और निष्पक्ष हों।
- पोस्ट-जेनरेशन फ़िल्टरिंग: जनरेटेड आउटपुट का विश्लेषण कर पक्षपाती या हानिकारक कंटेंट को पकड़ने वाले पोस्ट-प्रोसेसिंग कदम और फ़िल्टर लागू करना बायस को और कम कर सकता है। ये फ़िल्टर समस्याग्रस्त आउटपुट को उपयोगकर्ता के सामने आने से पहले फ़्लैग या संशोधित कर सकते हैं, ताकि अंतिम आउटपुट निष्पक्षता के मानदंडों को पूरा करे।
कम्प्यूटेशनल ओवरहेड
जैसे-जैसे उन्नत रिट्रीवल और जेनरेशन तकनीकों का एकीकरण होता है, RAG सिस्टम की कम्प्यूटेशनल मांगें भी बढ़ती हैं। यह चुनौती मॉडल आकार, प्रोसेसिंग गति और लेटेंसी जैसे क्षेत्रों में प्रकट होती है, जो सिस्टम की दक्षता और स्केलेबिलिटी को प्रभावित कर सकती है।
कम्प्यूटेशनल ओवरहेड को प्रबंधित करने के लिए, डेवलपर्स निम्न ऑप्टिमाइज़ेशन का सहारा ले सकते हैं:
- दक्ष रिट्रीवल तकनीकें: अधिक दक्ष इंडेक्सिंग और सर्च एल्गोरिद्म (जैसे approximate nearest neighbors) का उपयोग करके रिट्रीवल चरण का अनुकूलन, प्रासंगिक दस्तावेज़ ढूँढने के लिए आवश्यक समय और संसाधनों को काफी कम कर सकता है।
- मॉडल संपीड़न और अनुकूलन: RAG सिस्टम में उपयोग किए जाने वाले भाषा मॉडल कम्प्यूटेशनली भारी हो सकते हैं, खासकर बड़े पैमाने या डोमेन-विशिष्ट क्वेरियों के लिए। मॉडल डिस्टिलेशन, क्वांटाइज़ेशन और प्रूनिंग जैसी तकनीकें आकार और कम्प्यूटेशनल लागत को घटा सकती हैं, बिना प्रदर्शन में अधिक गिरावट के।
डेटा सीमाएँ
RAG सिस्टम रिट्रीव और जेनरेट किए जाने वाले डेटा की गुणवत्ता और दायरे पर बहुत निर्भर होते हैं। डोमेन-विशिष्ट अनुप्रयोगों में, जब उपलब्ध ट्रेनिंग डेटा अपर्याप्त, पुराना, या निम्न-गुणवत्ता का हो, तो डेटा सीमाएँ एक बड़ी चुनौती हो सकती हैं।
हम RAG सिस्टम में डेटा सीमाओं का समाधान कुछ तरीकों से कर सकते हैं।
डेटा ऑग्मेंटेशन
जब डोमेन-विशिष्ट ट्रेनिंग डेटा सीमित हो, तो डेटा ऑग्मेंटेशन तकनीकें डेटासेट का कृत्रिम रूप से विस्तार करने में मदद कर सकती हैं। इसमें सिंथेटिक डेटा बनाना, मौजूदा दस्तावेज़ों का पैराफ्रेज़ करना, या मूल डेटासेट को पूरा करने के लिए बाहरी स्रोतों का उपयोग करना शामिल हो सकता है। डेटा ऑग्मेंटेशन मॉडल को उदाहरणों की व्यापक श्रृंखला तक पहुँच सुनिश्चित करता है, जिससे विविध क्वेरियों को संभालने की क्षमता बढ़ती है।
डोमेन एडेप्टेशन
प्री-ट्रेंड भाषा मॉडलों को छोटे, डोमेन-विशिष्ट डेटासेट पर फाइन-ट्यून करना, सीमित डेटा के बावजूद, RAG सिस्टम को विशेष उपयोग-प्रकरणों के अनुकूल बनाने में मदद करता है। डोमेन एडेप्टेशन मॉडल को उद्योग-विशिष्ट शब्दावली और बारीकियों को बेहतर समझने देता है, जिससे जनरेटेड उत्तरों की गुणवत्ता बढ़ती है।
एक्टिव लर्निंग
जहाँ उच्च-गुणवत्ता वाले ट्रेनिंग डेटा की कमी हो, वहाँ एक्टिव लर्निंग का उपयोग करके डेटासेट को क्रमिक रूप से बेहतर बनाया जा सकता है। सबसे सूचनात्मक डेटा पॉइंट्स की पहचान कर, उन पर एनोटेशन प्रयास केंद्रित करके, डेवलपर्स विशाल लेबल्ड डेटा के बिना भी धीरे-धीरे डेटासेट को संवर्धित कर सकते हैं।
RAG में उन्नत तकनीकें लागू करना
RAG सिस्टम में उन्नत तकनीकें लागू करने के लिए उपलब्ध टूल, फ़्रेमवर्क, और रणनीतियों की ठोस समझ आवश्यक है। जैसे-जैसे ये तकनीकें अधिक जटिल होती हैं, विशेष लाइब्रेरी और फ़्रेमवर्क का लाभ उठाना परिष्कृत रिट्रीवल और जेनरेशन वर्कफ़्लो को एकीकृत करना सरल बनाता है।
टूल और लाइब्रेरी
कई फ़्रेमवर्क और लाइब्रेरी उन्नत RAG तकनीकों के इम्प्लीमेंटेशन का समर्थन करने के लिए सामने आए हैं, जो डेवलपर्स और शोधकर्ताओं के लिए मॉड्यूलर और स्केलेबल समाधान प्रदान करते हैं। ये टूल रिट्रीवल, रैंकिंग, फ़िल्टरिंग, और जेनरेशन के कंपोनेंट उपलब्ध कराकर RAG सिस्टम बनाने की प्रक्रिया में सुधार करते हैं।
LangChain
LangChain एक लोकप्रिय फ़्रेमवर्क है जो विशेष रूप से भाषा मॉडलों के साथ काम करने और उन्हें बाहरी डेटा स्रोतों के साथ एकीकृत करने के लिए डिज़ाइन किया गया है। यह दस्तावेज़ इंडेक्सिंग, क्वेरीइंग, और विभिन्न प्रोसेसिंग चरणों (रिट्रीवल, जेनरेशन, और रीजनिंग) की चेनिंग सहित उन्नत रिट्रीवल-ऑग्मेंटेड तकनीकों का समर्थन करता है।
LangChain वेक्टर डेटाबेस और विभिन्न रिट्रीवर्स के साथ आउट-ऑफ-द-बॉक्स इंटीग्रेशन भी प्रदान करता है, जिससे कस्टम RAG सिस्टम बनाने के लिए यह बहुमुखी विकल्प बनता है।
LangChain और RAG के बारे में इस कोर्स में और जानें: LangChain के साथ RAG सिस्टम बनाएं
Haystack
Haystack एक ओपन-सोर्स फ़्रेमवर्क है जो प्रोडक्शन उपयोग के लिए RAG सिस्टम बनाने में विशेषज्ञता रखता है। यह घनी रिट्रीवल, दस्तावेज़ रैंकिंग और फ़िल्टरिंग, साथ ही प्राकृतिक भाषा जेनरेशन के लिए टूल प्रदान करता है।
Haystack विशेष रूप से उन अनुप्रयोगों में शक्तिशाली है जहाँ डोमेन-विशिष्ट सर्च, प्रश्नोत्तर, या दस्तावेज़ सार-संक्षेप आवश्यक हों। विभिन्न बैकएंड्स के समर्थन और लोकप्रिय भाषा मॉडलों के साथ एकीकरण के साथ, Haystack वास्तविक-world परिदृश्यों में RAG सिस्टम की तैनाती को सरल बनाता है।
OpenAI API
OpenAI API डेवलपर्स को GPT-4 जैसी शक्तिशाली भाषा मॉडलों को RAG वर्कफ़्लो में एकीकृत करने देता है। हालाँकि यह विशेष रूप से रिट्रीवल-ऑग्मेंटेड कार्यों के लिए नहीं है, पर OpenAI के मॉडल रिट्रीवल फ़्रेमवर्क के साथ मिलकर रिट्रीव्ड जानकारी के आधार पर उत्तर जनरेट करने में उपयोग किए जा सकते हैं, जिससे उन्नत जेनरेशन क्षमताएँ सक्षम होती हैं।
इम्प्लीमेंटेशन रणनीतियाँ
मौजूदा RAG सिस्टम में उन्नत तकनीकों को एकीकृत करने के लिए, एक संरचित दृष्टिकोण अपनाना आवश्यक है।
उचित फ़्रेमवर्क चुनें
अपने उपयोग-प्रकरण के अनुरूप फ़्रेमवर्क या लाइब्रेरी का चयन करके शुरू करें। उदाहरण के लिए, यदि आपको उच्च स्केलेबिलिटी वाला, घनी रिट्रीवल क्षमताओं के साथ सिस्टम चाहिए, तो LangChain या Haystack जैसे फ़्रेमवर्क आदर्श हैं।
दस्तावेज़ रिट्रीवल सेटअप करें
पहला कदम रिट्रीवल कंपोनेंट सेटअप करना है, जिसमें आपके डेटा स्रोत का इंडेक्सिंग और रिट्रीवल विधि का कॉन्फ़िगरेशन शामिल है। उपयोग-प्रकरण के अनुसार, आप घनी रिट्रीवल (वेक्टर एम्बेडिंग का उपयोग) या हाइब्रिड सर्च (स्पार्स और डेंस तरीकों का संयोजन) चुन सकते हैं। उदाहरण के लिए, LangChain या Haystack का उपयोग करके रिट्रीवल पाइपलाइन बनाई जा सकती है।
री-रैंकिंग और फ़िल्टरिंग लागू करें
रिट्रीवल सिस्टम चालू होने के बाद, अगला कदम री-रैंकिंग और फ़िल्टरिंग तकनीकों के माध्यम से प्रासंगिकता बढ़ाना है। यह Haystack के बिल्ट-इन री-रैंकिंग मॉड्यूल्स का उपयोग करके या आपके विशिष्ट क्वेरी प्रकारों के अनुसार कस्टम री-रैंकिंग मॉडल बनाकर किया जा सकता है।
उन्नत जेनरेशन तकनीकें शामिल करें
रिट्रीवल के बाद, प्रॉम्प्ट इंजीनियरिंग, कॉन्टेक्स्ट डिस्टिलेशन, और मल्टी-स्टेप रीजनिंग का लाभ लेकर जेनरेशन प्रक्रिया को ऑप्टिमाइज़ करें। LangChain के साथ, आप मल्टी-स्टेप क्वेरियों को संभालने के लिए रिट्रीवल और जेनरेशन चरणों को चेन कर सकते हैं या अधिक सटीक जेनरेशन के लिए प्रॉम्प्ट टेम्पलेट्स का उपयोग कर सकते हैं।
यदि हेल्यूसिनेशन समस्या है, तो जेनरेशन को रिट्रीव्ड दस्तावेज़ों पर ग्राउंड करने पर ध्यान दें, यह सुनिश्चित करते हुए कि मॉडल उन्हीं दस्तावेज़ों की सामग्री के आधार पर आउटपुट जनरेट करे।
टेस्ट और मूल्यांकन करें
RAG सिस्टम के प्रदर्शन को परिष्कृत करने के लिए नियमित परीक्षण महत्वपूर्ण है। सटीकता, प्रासंगिकता, और उपयोगकर्ता संतुष्टि जैसे मूल्यांकन मेट्रिक्स का उपयोग करके री-रैंकिंग और कॉन्टेक्स्ट डिस्टिलेशन जैसी उन्नत तकनीकों की प्रभावशीलता का आकलन करें। विभिन्न तरीकों की तुलना के लिए A/B टेस्ट चलाएँ और फीडबैक के आधार पर सिस्टम को फाइन-ट्यून करें।
स्केलेबिलिटी के लिए ऑप्टिमाइज़ करें
जैसे-जैसे सिस्टम बढ़ता है, कम्प्यूटेशनल ओवरहेड चिंता का विषय बन सकता है। इसे प्रबंधित करने के लिए, मॉडल डिस्टिलेशन या क्वांटाइज़ेशन जैसी तकनीकों का उपयोग करें, और सुनिश्चित करें कि रिट्रीवल प्रक्रियाएँ दक्ष हों। GPU एक्सेलेरेशन या पैरेललाइज़ेशन का उपयोग भी बड़े पैमाने पर प्रदर्शन बनाए रखने में मदद कर सकता है।
मॉनिटर करें और अपडेट करें
RAG सिस्टम को नई क्वेरियों और डेटा के अनुरूप विकसित होना चाहिए। रियल-टाइम में सिस्टम के प्रदर्शन को ट्रैक करने के लिए मॉनिटरिंग टूल सेटअप करें, और उभरते रुझानों और आवश्यकताओं को संभालने के लिए मॉडल और रिट्रीवल इंडेक्स को लगातार अपडेट करें।
उन्नत RAG तकनीकों का मूल्यांकन
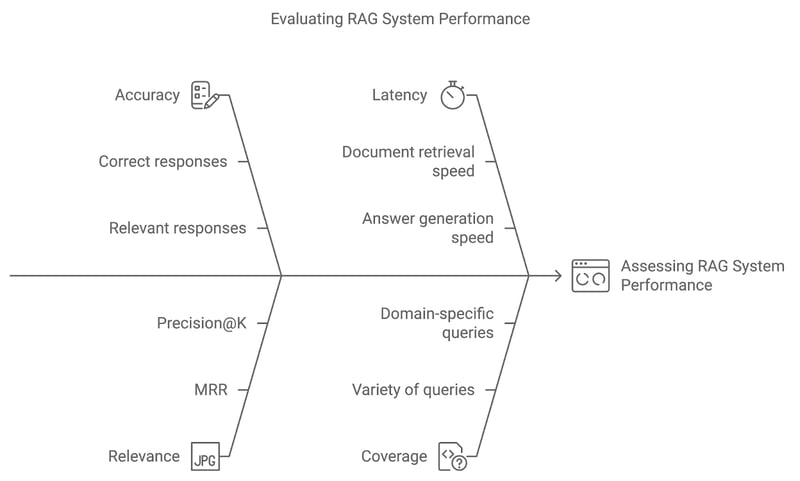
RAG सिस्टम में उन्नत तकनीकों को लागू करना केवल शुरुआत है। उपयुक्त मूल्यांकन मेट्रिक्स और A/B टेस्टिंग जैसी परीक्षण विधियों का उपयोग करके, हम आकलन कर सकते हैं कि सिस्टम उपयोगकर्ता क्वेरियों का कितना अच्छा उत्तर देता है और समय के साथ कैसे सुधरता है।
सटीकता
सटीकता मापती है कि सिस्टम कितनी बार सही या प्रासंगिक उत्तर रिट्रीव और जेनरेट करता है। प्रश्नोत्तर सिस्टम के लिए, इसमें जनरेटेड उत्तरों की ग्राउंड-ट्रुथ डेटा से प्रत्यक्ष तुलना शामिल हो सकती है। सटीकता में वृद्धि संकेत देती है कि सिस्टम क्वेरियों की सही व्याख्या कर रहा है और सटीक परिणाम दे रहा है।
प्रासंगिकता
यह मेट्रिक रिट्रीव किए गए दस्तावेज़ों की प्रासंगिकता और जनरेटेड उत्तर की गुणवत्ता का मूल्यांकन करती है कि वे उपयोगकर्ता की क्वेरी का कितना अच्छा उत्तर देते हैं। Mean Reciprocal Rank (MRR) या Precision@K जैसे मेट्रिक्स प्रासंगिकता को मापने के लिए सामान्यतः उपयोग होते हैं, जो आकलन करते हैं कि सबसे प्रासंगिक दस्तावेज़ रैंकिंग में कितना ऊपर दिखता है।
लेटेंसी
जहाँ सटीकता और प्रासंगिकता महत्वपूर्ण हैं, वहीं रियल-टाइम प्रदर्शन भी मायने रखता है। लेटेंसी सिस्टम की प्रतिक्रिया समय को संदर्भित करती है—सिस्टम दस्तावेज़ों को कितनी तेजी से रिट्रीव करता है और उत्तर जनरेट करता है। कम लेटेंसी उन अनुप्रयोगों में विशेष रूप से महत्वपूर्ण है जहाँ समय पर उत्तर आवश्यक हैं, जैसे ग्राहक सहायता या लाइव Q&A सिस्टम।
कवरेज
कवरेज मापता है कि RAG सिस्टम विभिन्न प्रकार की क्वेरियों को कितना अच्छी तरह संभालता है। डोमेन-विशिष्ट अनुप्रयोगों में, यह सुनिश्चित करना कि सिस्टम संभावित उपयोगकर्ता क्वेरियों के पूरे दायरे को संभाल सके, व्यापक समर्थन देने के लिए महत्वपूर्ण है।
आरेख napkin.ai से जनरेट किया गया
उन्नत RAG तकनीकों के उपयोग-प्रकरण
उन्नत RAG तकनीकें विभिन्न उद्योगों और अनुप्रयोगों में व्यापक संभावनाएँ खोलती हैं।
जटिल प्रश्नोत्तर सिस्टम
उन्नत RAG तकनीकों का सबसे प्रभावशाली उपयोग-प्रकरण जटिल प्रश्नोत्तर (QA) सिस्टम हैं। इन सिस्टमों को केवल साधारण दस्तावेज़ रिट्रीवल से अधिक की आवश्यकता होती है—उन्हें संदर्भ समझना, मल्टी-स्टेप क्वेरियों को तोड़ना, और रिट्रीव्ड दस्तावेज़ों के आधार पर व्यापक उत्तर देना होता है।
डोमेन-विशिष्ट नॉलेज रिट्रीवल
जहाँ डोमेन-विशिष्ट नॉलेज महत्वपूर्ण है, वहाँ उन्नत RAG सिस्टम अत्यधिक विशेषज्ञतापूर्ण कंटेंट रिट्रीव और जेनरेट कर सकते हैं। कुछ उल्लेखनीय अनुप्रयोग हैं:
- हेल्थकेयर: चिकित्सक निर्णय लेते समय अद्यतन शोध, क्लीनिकल दिशानिर्देश, और रोगी रिकॉर्ड पर निर्भर होते हैं। उन्नत RAG सिस्टम मेडिकल पेपर रिट्रीव कर सकते हैं, रोगी इतिहास का सार प्रस्तुत कर सकते हैं, और उपचार विकल्प जेनरेट कर सकते हैं। फ़िल्टरिंग और री-रैंकिंग यह सुनिश्चित करने में विशेष रूप से महत्वपूर्ण हैं कि रिट्रीव्ड कंटेंट हालिया, सटीक और रोगी की स्थिति से अत्यधिक प्रासंगिक हो।
- वित्तीय सेवाएँ: वित्तीय क्षेत्र में, RAG सिस्टम मार्केट रिपोर्ट, नियामकीय फाइलिंग, और आर्थिक पूर्वानुमान रिट्रीव कर, विश्लेषकों को सटीक, डेटा-आधारित अंतर्दृष्टि बनाने में मदद कर सकते हैं। क्वेरी एक्सपैंशन और घनी रिट्रीवल सुनिश्चित कर सकते हैं कि विश्लेषकों को सबसे प्रासंगिक और व्यापक डेटा मिले।
व्यक्तिकृत सिफारिशें
व्यक्तिकृत सिफारिशी सिस्टम उन्नत RAG तकनीकों का एक और प्रमुख उपयोग-प्रकरण हैं। उपयोगकर्ता की पसंद, व्यवहार, और बाहरी डेटा स्रोतों को मिलाकर, RAG सिस्टम उत्पाद, सेवाएँ, या कंटेंट के लिए व्यक्तिगत सिफारिशें जनरेट कर सकते हैं, जिनमें शामिल हैं:
- ई-कॉमर्स: RAG सिस्टम उत्पाद विवरण, ग्राहक समीक्षाएँ, और उपयोगकर्ता प्रोफाइल रिट्रीव करके व्यक्तिगत सुझाव दे सकते हैं। हाइब्रिड सर्च (कीवर्ड-आधारित और वेक्टर-आधारित रिट्रीवल का संयोजन) और री-रैंकिंग इन सिफारिशों की प्रासंगिकता बढ़ाने के लिए आवश्यक हैं।
- कंटेंट प्लेटफ़ॉर्म: स्ट्रीमिंग या न्यूज़ प्लेटफ़ॉर्म पर, RAG सिस्टम उपयोगकर्ता की पसंद और हालिया रुझानों के आधार पर कंटेंट की सिफारिश कर सकते हैं। क्वेरी एक्सपैंशन और कॉन्टेक्स्ट डिस्टिलेशन अधिक सूक्ष्म सिफारिशें देने में मदद करते हैं, पिछली गतिविधि और मौजूदा रुचियों के आधार पर सुझावों को तैयार करते हुए।
RAG सिस्टम का भविष्य
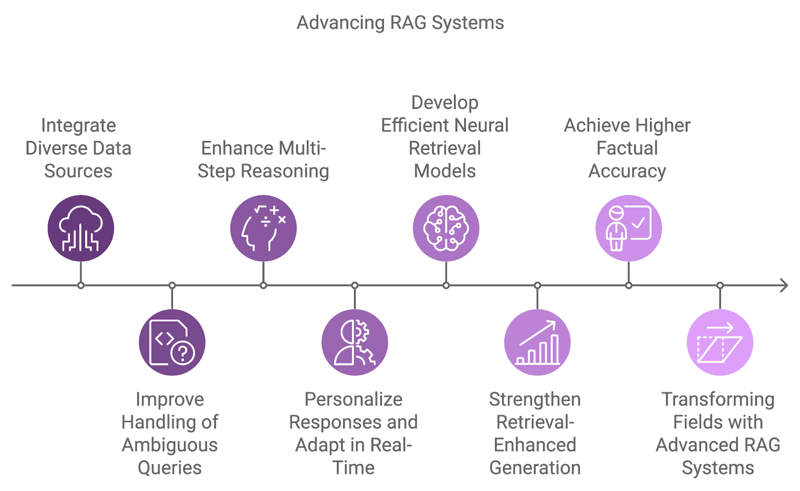
अगली पीढ़ी के RAG सिस्टम अधिक विविध डेटा स्रोतों का एकीकरण, बेहतर रीजनिंग क्षमताएँ, और अस्पष्टता व जटिल क्वेरियों के हैंडलिंग जैसी वर्तमान सीमाओं को संबोधित करेगी।
एक प्रमुख विकास क्षेत्र विभिन्न डेटा स्रोतों का एकीकरण है, जो एकल डेटासेट पर निर्भरता से आगे बढ़ेगा। भविष्य के सिस्टम डेटाबेस, API, और रियल-टाइम फ़ीड जैसे विविध स्रोतों की जानकारी को मिलाएँगे, जिससे जटिल क्वेरियों के लिए अधिक व्यापक और बहुआयामी उत्तर संभव होंगे।
अस्पष्ट या अपूर्ण क्वेरियों को संभालना एक और चुनौती है जिसे भविष्य के RAG सिस्टम संबोधित करेंगे। प्रायिकतामूलक तर्क और बेहतर संदर्भ समझ को मिलाकर, ये सिस्टम अनिश्चितता को अधिक प्रभावी ढंग से प्रबंधित करेंगे।
इसके अलावा, मल्टी-स्टेप रीजनिंग जटिल क्वेरियों को प्रोसेस करने के तरीके का अधिक अभिन्न हिस्सा बनेगा—उन्हें छोटे घटकों में तोड़कर और कई दस्तावेज़ों या चरणों में परिणामों का संश्लेषण करके। यह विशेष रूप से कानूनी शोध, वैज्ञानिक खोज, और ग्राहक सहायता जैसे क्षेत्रों में फायदेमंद होगा, जहाँ क्वेरियों में अक्सर विविध सूचनाओं को जोड़ना पड़ता है।
जैसे-जैसे व्यक्तिकरण और संदर्भ-जागरूकता में सुधार होता जाएगा, भविष्य के RAG सिस्टम उपयोगकर्ता के इतिहास, पसंद और पिछली इंटरैक्शन के आधार पर अपने उत्तरों को ट्यून करेंगे। नई जानकारी के लिए रियल-टाइम अनुकूलन अधिक गतिशील और उत्पादक बातचीत की अनुमति देगा।
आरेख napkin.ai से जनरेट किया गया
वर्तमान घनी रिट्रीवल मॉडल अत्यंत प्रभावी हैं, लेकिन और भी दक्ष और सटीक न्यूरल रिट्रीवल मॉडलों के विकास पर शोध जारी है। इन मॉडलों का लक्ष्य व्यापक क्वेरी-दस्तावेज़ जोड़ियों में सिमेंटिक समानताओं को बेहतर ढंग से पकड़ना और बड़े पैमाने के रिट्रीवल कार्यों में दक्षता सुधारना है।
जैसे Karpukhin et al. (2020) जैसे पेपर ने ओपन-डोमेन प्रश्नोत्तर के लिए Dense Passage Retrieval (DPR) को एक मुख्य विधि के रूप में प्रस्तुत किया, जबकि हालिया अध्ययन जैसे Izacard et al. (2022) डोमेन-विशिष्ट कार्यों के लिए RAG सिस्टम को अनुकूलित करने हेतु फ्यू-शॉट लर्निंग पर केंद्रित हैं।
एक और उभरता शोध क्षेत्र रिट्रीवल और जेनरेशन के बीच संबंध को रिट्रीवल-एन्हांस्ड जेनरेशन मॉडलों के माध्यम से सुधारने पर केंद्रित है। इन मॉडलों का लक्ष्य रिट्रीव्ड दस्तावेज़ों को जेनरेशन प्रक्रिया में सहजता से एकीकृत करना है, जिससे भाषा मॉडल अपने आउटपुट को रिट्रीव्ड कंटेंट पर अधिक प्रत्यक्ष रूप से कंडीशन कर सके।
यह हेल्यूसिनेशन को घटा सकता है और जनरेटेड उत्तरों की तथ्यात्मक सटीकता में सुधार कर सकता है, जिससे सिस्टम अधिक विश्वसनीय बनता है। उल्लेखनीय कार्यों में Huang et al. (2023) का RAVEN मॉडल शामिल है, जो रिट्रीवल-ऑग्मेंटेड एन्कोडर-डिकोडर मॉडलों का उपयोग करके इन-कॉन्टेक्स्ट लर्निंग में सुधार करता है।
निष्कर्ष
घनी रिट्रीवल, री-रैंकिंग, और मल्टी-स्टेप रीजनिंग जैसी उन्नत RAG तकनीकों का एकीकरण सुनिश्चित करता है कि RAG सिस्टम हेल्थकेयर से लेकर व्यक्तिकृत सिफारिशों तक वास्तविक-world अनुप्रयोगों की माँगों को पूरा कर सकें।
आगे देखते हुए, RAG सिस्टम का विकास क्रॉस-लिंगुअल क्षमताओं, व्यक्तिकृत जेनरेशन, और अधिक विविध डेटा स्रोतों के हैंडलिंग जैसी नवाचारों से प्रेरित होगा।
यदि आप सीखना जारी रखना चाहते हैं और RAG सिस्टम पर अधिक हैंड्स-ऑन होना चाहते हैं, तो मैं ये ट्यूटोरियल सुझाता हूँ:


रीट्रीवल-ऑग्मेंटेड जेनरेशन (RAG) दस्तावेज़ रिट्रीवल को प्राकृतिक भाषा जेनरेशन से जोड़ता है, जिससे अधिक सटीक और संदर्भ-संवेदी उत्तर मिलते हैं।
बेसिक RAG प्रभावी है, लेकिन यह जटिल क्वेरी, हेल्यूसिनेशन, और मल्टी-टर्न बातचीत में संदर्भ बनाए रखने में संघर्ष करता है।
इस ब्लॉग में, मैं उन्नत तकनीकों का अन्वेषण करूँगा जो रिट्रीवल सटीकता, जेनरेशन गुणवत्ता, और समग्र सिस्टम प्रदर्शन में सुधार करके इन चुनौतियों का समाधान करती हैं।
यदि आप इसे इंटरव्यू की तैयारी में पढ़ रहे हैं, तो टॉप 30 RAG इंटरव्यू प्रश्न और उत्तर वाला लेख अवश्य देखें।
बेसिक RAG सिस्टम की सीमाएँ
बेसिक RAG इम्प्लीमेंटेशन उपयोगी हो सकते हैं, लेकिन अधिक मांग वाले संदर्भों में इनकी कुछ सीमाएँ होती हैं।
हेल्यूसिनेशन
सबसे प्रमुख समस्याओं में से एक हेल्यूसिनेशन है, जहाँ मॉडल तथ्यात्मक रूप से गलत या रिट्रीव किए गए दस्तावेज़ों द्वारा असमर्थित सामग्री बना देता है। यह सिस्टम की विश्वसनीयता को कमजोर कर सकता है, खासकर उन क्षेत्रों में जहाँ उच्च सटीकता आवश्यक है, जैसे चिकित्सा या कानून।
डोमेन-विशिष्टता की कमी
मानक RAG मॉडल डोमेन-विशिष्ट क्वेरियों को संभालते समय संघर्ष कर सकते हैं। यदि रिट्रीवल और जेनरेशन प्रक्रियाओं को विशेष डोमेनों की बारीकियों के अनुसार नहीं ढाला गया, तो सिस्टम अप्रासंगिक या गलत जानकारी रिट्रीव करने का जोखिम उठाता है।
जटिल या मल्टी-टर्न बातचीत को संभालना
एक अन्य चुनौती जटिल, मल्टी-स्टेप क्वेरियों या मल्टी-टर्न बातचीत का प्रबंधन है। बेसिक RAG सिस्टम अक्सर इंटरैक्शन में संदर्भ बनाए रखने में चूकते हैं, जिससे बिखरे हुए या अधूरे उत्तर मिलते हैं। जैसे-जैसे उपयोगकर्ता क्वेरियाँ अधिक जटिल होती जाती हैं, RAG सिस्टम को इस बढ़ती जटिलता को संभालने के लिए विकसित होना होगा।
आरेख napkin.ai से जनरेट किया गया
उन्नत रिट्रीवल तकनीकें
उन्नत रिट्रीवल तकनीकें रिट्रीव किए गए दस्तावेज़ों की प्रासंगिकता और दायरे दोनों को बढ़ाने पर केंद्रित हैं। घनी रिट्रीवल, हाइब्रिड सर्च, री-रैंकिंग, और क्वेरी एक्सपैंशन जैसी तकनीकें कीवर्ड-आधारित रिट्रीवल की सीमाओं को संबोधित करती हैं।
घनी रिट्रीवल और हाइब्रिड सर्च
घनी रिट्रीवल और हाइब्रिड सर्च रिट्रीवल सटीकता और प्रासंगिकता में सुधार के लिए प्रमुख तकनीकें हैं। TF-IDF या BM25 जैसे तरीके तब अर्थ-समझ में चूकते हैं जब क्वेरियाँ दस्तावेज़ों से अलग तरीके से लिखी जाती हैं।
DPR (Dense Passage Retrieval) जैसी घनी रिट्रीवल डीप लर्निंग का उपयोग करके क्वेरियों और दस्तावेज़ों को घने वेक्टर निरूपण में मैप करती है, जिससे सटीक कीवर्ड से आगे जाकर अर्थ पकड़ा जाता है।
हाइब्रिड सर्च स्पार्स और डेंस रिट्रीवल को मिलाकर, कीवर्ड-आधारित मैचिंग और सिमेंटिक समानता को संयोजित करता है, जिससे सटीकता और रिकॉल में संतुलन बनता है और जटिल क्वेरियों के लिए यह प्रभावी बनता है।
री-रैंकिंग
री-रैंकिंग एक उन्नत तकनीक है जिसका उपयोग जेनरेशन कंपोनेंट तक भेजने से पहले रिट्रीव किए गए दस्तावेज़ों की सूची को परिष्कृत करने के लिए किया जाता है। एक सामान्य RAG सिस्टम में, शुरुआती रिट्रीवल चरण में प्रासंगिकता में भिन्नता वाले दस्तावेज़ों का बड़ा सेट आ सकता है।
री-रैंकिंग का काम इन दस्तावेज़ों को फिर से क्रमित करना है ताकि सबसे प्रासंगिक दस्तावेज़ों को भाषा मॉडल द्वारा उपयोग के लिए प्राथमिकता दी जाए। री-रैंकिंग क्वेरी-दस्तावेज़ समानता पर आधारित साधारण स्कोरिंग से लेकर प्रत्येक दस्तावेज़ की प्रासंगिकता की भविष्यवाणी करने के लिए प्रशिक्षित जटिल मशीन लर्निंग मॉडलों तक से की जा सकती है।
आप इस ट्यूटोरियल में RankGPT के साथ री-रैंकिंग लागू करना सीख सकते हैं।
क्वेरी एक्सपैंशन
क्वेरी एक्सपैंशन में उपयोगकर्ता की क्वेरी को अतिरिक्त शब्दों से समृद्ध करना शामिल है, जिससे प्रासंगिक दस्तावेज़ों के रिट्रीवल की संभावना बढ़ जाती है। यह इन तरीकों से किया जा सकता है:
उदाहरण के लिए, यदि मूल क्वेरी “स्वास्थ्य सेवा में आर्टिफिशियल इंटेलिजेंस” है, तो क्वेरी एक्सपैंशन में “AI”, “मशीन लर्निंग” या “हेल्थ टेक” जैसे संबंधित शब्द शामिल हो सकते हैं, जिससे रिट्रीवल का दायरा बढ़ जाए।
RAG सिस्टम में प्रासंगिकता और गुणवत्ता का अनुकूलन
RAG सिस्टम में केवल दस्तावेज़ रिट्रीव करना पर्याप्त नहीं है; इन दस्तावेज़ों की प्रासंगिकता और गुणवत्ता सुनिश्चित करना अंतिम आउटपुट को बेहतर बनाने की कुंजी है। इसके लिए रिट्रीव की गई सामग्री को परिष्कृत और फ़िल्टर करने वाली उन्नत तकनीकें आवश्यक हैं।
ये तरीके शोर को कम करते हैं, प्रासंगिकता बढ़ाते हैं, और जेनरेशन के दौरान भाषा मॉडल का ध्यान सबसे महत्वपूर्ण जानकारी पर केंद्रित करते हैं।
उन्नत फ़िल्टरिंग तकनीकें
उन्नत फ़िल्टरिंग तकनीकें मेटाडेटा या कंटेंट-आधारित नियमों का उपयोग करके अप्रासंगिक या निम्न-गुणवत्ता वाले दस्तावेज़ों को बाहर करती हैं, जिससे केवल सबसे प्रासंगिक परिणाम आगे भेजे जाते हैं।
कॉन्टेक्स्ट डिस्टिलेशन
कॉन्टेक्स्ट डिस्टिलेशन रिट्रीव किए गए दस्तावेज़ों का सार-संक्षेप या संकुचन करने की प्रक्रिया है, ताकि भाषा मॉडल का ध्यान सबसे महत्वपूर्ण सूचनाओं पर रहे। यह तब उपयोगी है जब रिट्रीव की गई सामग्री में बहुत अधिक अप्रासंगिक भाग हों या क्वेरी में जटिल, मल्टी-स्टेप तर्क शामिल हो।
संदर्भ को डिस्टिल करके, सिस्टम रिट्रीव किए गए दस्तावेज़ों से प्रमुख अंतर्दृष्टि और सबसे प्रासंगिक अंश निकालता है, जिससे भाषा मॉडल के पास काम करने के लिए सबसे स्पष्ट और उपयुक्त जानकारी रहती है।
जेनरेशन प्रक्रिया का अनुकूलन
एक बार प्रासंगिक दस्तावेज़ रिट्रीव और परिष्कृत हो जाएँ, तो RAG सिस्टम में अगला कदम जेनरेशन प्रक्रिया है। भाषा मॉडल द्वारा उत्तर जनरेट करने के तरीके का अनुकूलन सटीकता, सामंजस्य और प्रासंगिकता स्थापित करने के लिए आवश्यक है।
प्रॉम्प्ट इंजीनियरिंग
प्रॉम्प्ट इंजीनियरिंग उस प्रक्रिया को संदर्भित करता है जिसमें भाषा मॉडल को दिए जाने वाले प्रॉम्प्ट डिज़ाइन और संरचित किए जाते हैं। प्रॉम्प्ट की गुणवत्ता सीधे मॉडल के जनरेटेड आउटपुट की गुणवत्ता को प्रभावित करती है, क्योंकि प्रॉम्प्ट जेनरेशन कार्य के लिए शुरुआती निर्देश या संदर्भ प्रदान करता है।
आरेख napkin.ai से जनरेट किया गया
प्रॉम्प्ट को ऑप्टिमाइज़ करने के लिए, डेवलपर्स कुछ अलग-अलग तरीकों के साथ प्रयोग कर सकते हैं।
अधिक संदर्भ प्रदान करना
स्पष्ट निर्देश या प्रमुख शब्दों जैसी अतिरिक्त जानकारी शामिल करना मॉडल को अधिक सटीक और संदर्भानुकूल उत्तरों की ओर मार्गदर्शन कर सकता है। उदाहरण के लिए, एक चिकित्सा RAG सिस्टम में, प्रॉम्प्ट स्पष्ट रूप से रिट्रीव किए गए दस्तावेज़ों के आधार पर निदान सारांश देने का अनुरोध कर सकता है।
स्पष्टता के लिए क्वेरियों की संरचना
अच्छी तरह संरचित प्रॉम्प्ट, जिनमें स्पष्ट और संक्षिप्त निर्देश हों, अस्पष्टता को कम करते हैं और अधिक केंद्रित जेनरेशन परिणाम देते हैं। प्रॉम्प्ट को सीधे प्रश्न या अनुरोध के रूप में व्यक्त करना अक्सर बेहतर परिणाम देता है।
विभिन्न प्रॉम्प्ट फ़ॉर्मैट का परीक्षण
प्रश्नों को पुनः व्यक्त करना, विशिष्टता के स्तर को समायोजित करना, या उदाहरण प्रदान करना जैसी प्रॉम्प्ट शैलियों पर पुनरावृत्ति करके, किसी विशेष उपयोग-प्रकरण के लिए सर्वोत्तम परिणाम देने वाले फ़ॉर्मैट की पहचान की जा सकती है।
इस ब्लॉग में और जानें: प्रॉम्प्ट ऑप्टिमाइज़ेशन तकनीकें।
मल्टी-स्टेप रीजनिंग
कई क्वेरियाँ, खासकर शोध, कानून या तकनीकी सहायता जैसे क्षेत्रों में, एक से अधिक चरणों में होती हैं या जटिल तर्क की मांग करती हैं। मल्टी-स्टेप रीजनिंग वह प्रक्रिया है जिसमें सिस्टम एक जटिल क्वेरी को प्रबंधनीय उप-कार्यों में तोड़ता है और व्यापक उत्तर तक पहुँचने के लिए उन्हें क्रमिक रूप से संसाधित करता है।
हम RAG सिस्टम के भीतर मल्टी-स्टेप रीजनिंग को कई तरीकों से लागू कर सकते हैं:
हेल्यूसिनेशन का समाधान
संक्षेप में बताया गया था कि जेनरेशन मॉडलों, जिनमें RAG सिस्टम भी शामिल हैं, की मुख्य चुनौतियों में से एक हेल्यूसिनेशन है। RAG सिस्टम में हेल्यूसिनेशन को कम करने के कई तरीके हैं:
जटिल क्वेरी और बातचीत को संभालना
जैसे-जैसे RAG सिस्टम वास्तविक-world कार्यों में अधिक उपयोग हो रहे हैं, उन्हें जटिल, मल्टी-टर्न इंटरैक्शन और अस्पष्ट क्वेरियों को संभालने में सक्षम होना चाहिए।
मल्टी-टर्न बातचीत का प्रबंधन
कन्वर्सेशनल RAG सिस्टम में प्रमुख चुनौतियों में से एक कई इंटरैक्शन के दौरान जानकारी के प्रवाह का प्रबंधन करना है। कई रोज़मर्रा के परिदृश्यों, जैसे ग्राहक सहायता या चल रही तकनीकी चर्चाओं में, उपयोगकर्ता मल्टी-टर्न बातचीत में शामिल होते हैं जहाँ संदर्भ को कई एक्सचेंजों में बनाए रखना पड़ता है।
सिस्टम द्वारा बातचीत के प्रासंगिक हिस्सों का ट्रैक और स्मरण रखना सुसंगत और एकरूप उत्तर देने की कुंजी है। मल्टी-टर्न बातचीत को प्रभावी ढंग से संभालने के लिए, RAG सिस्टम निम्न तकनीकों का उपयोग कर सकते हैं:
अस्पष्ट या जटिल क्वेरियों को संभालना
उपयोगकर्ता क्वेरियाँ हमेशा सीधी नहीं होतीं; कई बार वे अस्पष्ट, दोअर्थी, या जटिल तर्क सहित होती हैं जो RAG सिस्टम की क्षमताओं को चुनौती देती हैं।
स्पष्टीकरण के माध्यम से डिसऐम्बिगुएशन
अस्पष्टता दूर करने का एक तरीका यह है कि सिस्टम उपयोगकर्ता से स्पष्टीकरण माँगे। उदाहरण के लिए, यदि क्वेरी बहुत धुंधली है, तो सिस्टम अधिक विशिष्टताओं के लिए फॉलो-अप प्रश्न जनरेट कर सकता है। यह इंटरैक्टिव प्रक्रिया रिट्रीवल और जेनरेशन चरणों पर आगे बढ़ने से पहले उपयोगकर्ता के इरादे को सीमित करने में मदद करती है।
बहुमुखी क्वेरी प्रोसेसिंग
ऐसी जटिल क्वेरियों के लिए जिनमें कई पहलू या उप-विषय शामिल हों, सिस्टम क्वेरी को छोटे, अधिक प्रबंधनीय भागों में तोड़ सकता है। इसमें चरणों में जानकारी रिट्रीव करना शामिल है, जहाँ हर चरण क्वेरी के एक विशिष्ट पहलू को संबोधित करता है। अंतिम आउटपुट कई रिट्रीवल और जेनरेशन चरणों से संश्लेषित होता है, जिससे क्वेरी के सभी घटक कवर हो सकें।
संदर्भ संकेतों का उपयोग
अस्पष्टता को संभालने के लिए, सिस्टम क्वेरी या बातचीत इतिहास से संदर्भ संकेतों का उपयोग कर सकता है। पिछली इंटरैक्शन या संबंधित विषयों का विश्लेषण करके, RAG सिस्टम उपयोगकर्ता के इरादे का अधिक सटीक अनुमान लगा सकता है, जिससे अप्रासंगिक या गलत उत्तरों की संभावना कम होती है।
जटिल क्वेरियों के लिए उन्नत रिट्रीवल तकनीकें
विशेष रूप से चुनौतीपूर्ण क्वेरियों के लिए, RAG सिस्टम मल्टी-हॉप प्रश्नोत्तर जैसी उन्नत रिट्रीवल विधियाँ लागू कर सकते हैं, जहाँ सिस्टम कई दस्तावेज़ों से जानकारी रिट्रीव करता है और उनके बीच तार्किक कड़ियाँ बनाकर जटिल क्वेरियों का उत्तर देता है।
सामान्य RAG चुनौतियों का समाधान
जहाँ RAG सिस्टम सूचना रिट्रीवल और टेक्स्ट जेनरेशन के लिए शक्तिशाली समाधान प्रदान करते हैं, वहीं वे कुछ विशिष्ट चुनौतियाँ भी पेश करते हैं जिनका समाधान आवश्यक है।
जेनरेशन में बायस से निपटना
बायस भाषा मॉडलों में, जिनमें RAG सिस्टम भी शामिल हैं, एक ज्ञात समस्या है जो जनरेटेड आउटपुट की निष्पक्षता और सटीकता को नकारात्मक रूप से प्रभावित कर सकती है। बायस रिट्रीवल और जेनरेशन दोनों चरणों से सिस्टम में प्रवेश कर सकता है, जिससे अंतर्निहित डेटासेट में मौजूद सामाजिक, सांस्कृतिक, या डोमेन-विशिष्ट पक्षपात को दर्शाने वाले विकृत या भेदभावपूर्ण आउटपुट उत्पन्न हो सकते हैं।
RAG सिस्टम में बायस को कम करने के लिए हम कई रणनीतियाँ अपना सकते हैं:
कम्प्यूटेशनल ओवरहेड
जैसे-जैसे उन्नत रिट्रीवल और जेनरेशन तकनीकों का एकीकरण होता है, RAG सिस्टम की कम्प्यूटेशनल मांगें भी बढ़ती हैं। यह चुनौती मॉडल आकार, प्रोसेसिंग गति और लेटेंसी जैसे क्षेत्रों में प्रकट होती है, जो सिस्टम की दक्षता और स्केलेबिलिटी को प्रभावित कर सकती है।
कम्प्यूटेशनल ओवरहेड को प्रबंधित करने के लिए, डेवलपर्स निम्न ऑप्टिमाइज़ेशन का सहारा ले सकते हैं:
डेटा सीमाएँ
RAG सिस्टम रिट्रीव और जेनरेट किए जाने वाले डेटा की गुणवत्ता और दायरे पर बहुत निर्भर होते हैं। डोमेन-विशिष्ट अनुप्रयोगों में, जब उपलब्ध ट्रेनिंग डेटा अपर्याप्त, पुराना, या निम्न-गुणवत्ता का हो, तो डेटा सीमाएँ एक बड़ी चुनौती हो सकती हैं।
हम RAG सिस्टम में डेटा सीमाओं का समाधान कुछ तरीकों से कर सकते हैं।
डेटा ऑग्मेंटेशन
जब डोमेन-विशिष्ट ट्रेनिंग डेटा सीमित हो, तो डेटा ऑग्मेंटेशन तकनीकें डेटासेट का कृत्रिम रूप से विस्तार करने में मदद कर सकती हैं। इसमें सिंथेटिक डेटा बनाना, मौजूदा दस्तावेज़ों का पैराफ्रेज़ करना, या मूल डेटासेट को पूरा करने के लिए बाहरी स्रोतों का उपयोग करना शामिल हो सकता है। डेटा ऑग्मेंटेशन मॉडल को उदाहरणों की व्यापक श्रृंखला तक पहुँच सुनिश्चित करता है, जिससे विविध क्वेरियों को संभालने की क्षमता बढ़ती है।
डोमेन एडेप्टेशन
प्री-ट्रेंड भाषा मॉडलों को छोटे, डोमेन-विशिष्ट डेटासेट पर फाइन-ट्यून करना, सीमित डेटा के बावजूद, RAG सिस्टम को विशेष उपयोग-प्रकरणों के अनुकूल बनाने में मदद करता है। डोमेन एडेप्टेशन मॉडल को उद्योग-विशिष्ट शब्दावली और बारीकियों को बेहतर समझने देता है, जिससे जनरेटेड उत्तरों की गुणवत्ता बढ़ती है।
एक्टिव लर्निंग
जहाँ उच्च-गुणवत्ता वाले ट्रेनिंग डेटा की कमी हो, वहाँ एक्टिव लर्निंग का उपयोग करके डेटासेट को क्रमिक रूप से बेहतर बनाया जा सकता है। सबसे सूचनात्मक डेटा पॉइंट्स की पहचान कर, उन पर एनोटेशन प्रयास केंद्रित करके, डेवलपर्स विशाल लेबल्ड डेटा के बिना भी धीरे-धीरे डेटासेट को संवर्धित कर सकते हैं।
RAG में उन्नत तकनीकें लागू करना
RAG सिस्टम में उन्नत तकनीकें लागू करने के लिए उपलब्ध टूल, फ़्रेमवर्क, और रणनीतियों की ठोस समझ आवश्यक है। जैसे-जैसे ये तकनीकें अधिक जटिल होती हैं, विशेष लाइब्रेरी और फ़्रेमवर्क का लाभ उठाना परिष्कृत रिट्रीवल और जेनरेशन वर्कफ़्लो को एकीकृत करना सरल बनाता है।
टूल और लाइब्रेरी
कई फ़्रेमवर्क और लाइब्रेरी उन्नत RAG तकनीकों के इम्प्लीमेंटेशन का समर्थन करने के लिए सामने आए हैं, जो डेवलपर्स और शोधकर्ताओं के लिए मॉड्यूलर और स्केलेबल समाधान प्रदान करते हैं। ये टूल रिट्रीवल, रैंकिंग, फ़िल्टरिंग, और जेनरेशन के कंपोनेंट उपलब्ध कराकर RAG सिस्टम बनाने की प्रक्रिया में सुधार करते हैं।
LangChain
LangChain एक लोकप्रिय फ़्रेमवर्क है जो विशेष रूप से भाषा मॉडलों के साथ काम करने और उन्हें बाहरी डेटा स्रोतों के साथ एकीकृत करने के लिए डिज़ाइन किया गया है। यह दस्तावेज़ इंडेक्सिंग, क्वेरीइंग, और विभिन्न प्रोसेसिंग चरणों (रिट्रीवल, जेनरेशन, और रीजनिंग) की चेनिंग सहित उन्नत रिट्रीवल-ऑग्मेंटेड तकनीकों का समर्थन करता है।
LangChain वेक्टर डेटाबेस और विभिन्न रिट्रीवर्स के साथ आउट-ऑफ-द-बॉक्स इंटीग्रेशन भी प्रदान करता है, जिससे कस्टम RAG सिस्टम बनाने के लिए यह बहुमुखी विकल्प बनता है।
LangChain और RAG के बारे में इस कोर्स में और जानें: LangChain के साथ RAG सिस्टम बनाएं
Haystack
Haystack एक ओपन-सोर्स फ़्रेमवर्क है जो प्रोडक्शन उपयोग के लिए RAG सिस्टम बनाने में विशेषज्ञता रखता है। यह घनी रिट्रीवल, दस्तावेज़ रैंकिंग और फ़िल्टरिंग, साथ ही प्राकृतिक भाषा जेनरेशन के लिए टूल प्रदान करता है।
Haystack विशेष रूप से उन अनुप्रयोगों में शक्तिशाली है जहाँ डोमेन-विशिष्ट सर्च, प्रश्नोत्तर, या दस्तावेज़ सार-संक्षेप आवश्यक हों। विभिन्न बैकएंड्स के समर्थन और लोकप्रिय भाषा मॉडलों के साथ एकीकरण के साथ, Haystack वास्तविक-world परिदृश्यों में RAG सिस्टम की तैनाती को सरल बनाता है।
OpenAI API
OpenAI API डेवलपर्स को GPT-4 जैसी शक्तिशाली भाषा मॉडलों को RAG वर्कफ़्लो में एकीकृत करने देता है। हालाँकि यह विशेष रूप से रिट्रीवल-ऑग्मेंटेड कार्यों के लिए नहीं है, पर OpenAI के मॉडल रिट्रीवल फ़्रेमवर्क के साथ मिलकर रिट्रीव्ड जानकारी के आधार पर उत्तर जनरेट करने में उपयोग किए जा सकते हैं, जिससे उन्नत जेनरेशन क्षमताएँ सक्षम होती हैं।
इम्प्लीमेंटेशन रणनीतियाँ
मौजूदा RAG सिस्टम में उन्नत तकनीकों को एकीकृत करने के लिए, एक संरचित दृष्टिकोण अपनाना आवश्यक है।
उचित फ़्रेमवर्क चुनें
अपने उपयोग-प्रकरण के अनुरूप फ़्रेमवर्क या लाइब्रेरी का चयन करके शुरू करें। उदाहरण के लिए, यदि आपको उच्च स्केलेबिलिटी वाला, घनी रिट्रीवल क्षमताओं के साथ सिस्टम चाहिए, तो LangChain या Haystack जैसे फ़्रेमवर्क आदर्श हैं।
दस्तावेज़ रिट्रीवल सेटअप करें
पहला कदम रिट्रीवल कंपोनेंट सेटअप करना है, जिसमें आपके डेटा स्रोत का इंडेक्सिंग और रिट्रीवल विधि का कॉन्फ़िगरेशन शामिल है। उपयोग-प्रकरण के अनुसार, आप घनी रिट्रीवल (वेक्टर एम्बेडिंग का उपयोग) या हाइब्रिड सर्च (स्पार्स और डेंस तरीकों का संयोजन) चुन सकते हैं। उदाहरण के लिए, LangChain या Haystack का उपयोग करके रिट्रीवल पाइपलाइन बनाई जा सकती है।
री-रैंकिंग और फ़िल्टरिंग लागू करें
रिट्रीवल सिस्टम चालू होने के बाद, अगला कदम री-रैंकिंग और फ़िल्टरिंग तकनीकों के माध्यम से प्रासंगिकता बढ़ाना है। यह Haystack के बिल्ट-इन री-रैंकिंग मॉड्यूल्स का उपयोग करके या आपके विशिष्ट क्वेरी प्रकारों के अनुसार कस्टम री-रैंकिंग मॉडल बनाकर किया जा सकता है।
उन्नत जेनरेशन तकनीकें शामिल करें
रिट्रीवल के बाद, प्रॉम्प्ट इंजीनियरिंग, कॉन्टेक्स्ट डिस्टिलेशन, और मल्टी-स्टेप रीजनिंग का लाभ लेकर जेनरेशन प्रक्रिया को ऑप्टिमाइज़ करें। LangChain के साथ, आप मल्टी-स्टेप क्वेरियों को संभालने के लिए रिट्रीवल और जेनरेशन चरणों को चेन कर सकते हैं या अधिक सटीक जेनरेशन के लिए प्रॉम्प्ट टेम्पलेट्स का उपयोग कर सकते हैं।
यदि हेल्यूसिनेशन समस्या है, तो जेनरेशन को रिट्रीव्ड दस्तावेज़ों पर ग्राउंड करने पर ध्यान दें, यह सुनिश्चित करते हुए कि मॉडल उन्हीं दस्तावेज़ों की सामग्री के आधार पर आउटपुट जनरेट करे।
टेस्ट और मूल्यांकन करें
RAG सिस्टम के प्रदर्शन को परिष्कृत करने के लिए नियमित परीक्षण महत्वपूर्ण है। सटीकता, प्रासंगिकता, और उपयोगकर्ता संतुष्टि जैसे मूल्यांकन मेट्रिक्स का उपयोग करके री-रैंकिंग और कॉन्टेक्स्ट डिस्टिलेशन जैसी उन्नत तकनीकों की प्रभावशीलता का आकलन करें। विभिन्न तरीकों की तुलना के लिए A/B टेस्ट चलाएँ और फीडबैक के आधार पर सिस्टम को फाइन-ट्यून करें।
स्केलेबिलिटी के लिए ऑप्टिमाइज़ करें
जैसे-जैसे सिस्टम बढ़ता है, कम्प्यूटेशनल ओवरहेड चिंता का विषय बन सकता है। इसे प्रबंधित करने के लिए, मॉडल डिस्टिलेशन या क्वांटाइज़ेशन जैसी तकनीकों का उपयोग करें, और सुनिश्चित करें कि रिट्रीवल प्रक्रियाएँ दक्ष हों। GPU एक्सेलेरेशन या पैरेललाइज़ेशन का उपयोग भी बड़े पैमाने पर प्रदर्शन बनाए रखने में मदद कर सकता है।
मॉनिटर करें और अपडेट करें
RAG सिस्टम को नई क्वेरियों और डेटा के अनुरूप विकसित होना चाहिए। रियल-टाइम में सिस्टम के प्रदर्शन को ट्रैक करने के लिए मॉनिटरिंग टूल सेटअप करें, और उभरते रुझानों और आवश्यकताओं को संभालने के लिए मॉडल और रिट्रीवल इंडेक्स को लगातार अपडेट करें।
उन्नत RAG तकनीकों का मूल्यांकन
RAG सिस्टम में उन्नत तकनीकों को लागू करना केवल शुरुआत है। उपयुक्त मूल्यांकन मेट्रिक्स और A/B टेस्टिंग जैसी परीक्षण विधियों का उपयोग करके, हम आकलन कर सकते हैं कि सिस्टम उपयोगकर्ता क्वेरियों का कितना अच्छा उत्तर देता है और समय के साथ कैसे सुधरता है।
सटीकता
सटीकता मापती है कि सिस्टम कितनी बार सही या प्रासंगिक उत्तर रिट्रीव और जेनरेट करता है। प्रश्नोत्तर सिस्टम के लिए, इसमें जनरेटेड उत्तरों की ग्राउंड-ट्रुथ डेटा से प्रत्यक्ष तुलना शामिल हो सकती है। सटीकता में वृद्धि संकेत देती है कि सिस्टम क्वेरियों की सही व्याख्या कर रहा है और सटीक परिणाम दे रहा है।
प्रासंगिकता
यह मेट्रिक रिट्रीव किए गए दस्तावेज़ों की प्रासंगिकता और जनरेटेड उत्तर की गुणवत्ता का मूल्यांकन करती है कि वे उपयोगकर्ता की क्वेरी का कितना अच्छा उत्तर देते हैं। Mean Reciprocal Rank (MRR) या Precision@K जैसे मेट्रिक्स प्रासंगिकता को मापने के लिए सामान्यतः उपयोग होते हैं, जो आकलन करते हैं कि सबसे प्रासंगिक दस्तावेज़ रैंकिंग में कितना ऊपर दिखता है।
लेटेंसी
जहाँ सटीकता और प्रासंगिकता महत्वपूर्ण हैं, वहीं रियल-टाइम प्रदर्शन भी मायने रखता है। लेटेंसी सिस्टम की प्रतिक्रिया समय को संदर्भित करती है—सिस्टम दस्तावेज़ों को कितनी तेजी से रिट्रीव करता है और उत्तर जनरेट करता है। कम लेटेंसी उन अनुप्रयोगों में विशेष रूप से महत्वपूर्ण है जहाँ समय पर उत्तर आवश्यक हैं, जैसे ग्राहक सहायता या लाइव Q&A सिस्टम।
कवरेज
कवरेज मापता है कि RAG सिस्टम विभिन्न प्रकार की क्वेरियों को कितना अच्छी तरह संभालता है। डोमेन-विशिष्ट अनुप्रयोगों में, यह सुनिश्चित करना कि सिस्टम संभावित उपयोगकर्ता क्वेरियों के पूरे दायरे को संभाल सके, व्यापक समर्थन देने के लिए महत्वपूर्ण है।
आरेख napkin.ai से जनरेट किया गया
उन्नत RAG तकनीकों के उपयोग-प्रकरण
उन्नत RAG तकनीकें विभिन्न उद्योगों और अनुप्रयोगों में व्यापक संभावनाएँ खोलती हैं।
जटिल प्रश्नोत्तर सिस्टम
उन्नत RAG तकनीकों का सबसे प्रभावशाली उपयोग-प्रकरण जटिल प्रश्नोत्तर (QA) सिस्टम हैं। इन सिस्टमों को केवल साधारण दस्तावेज़ रिट्रीवल से अधिक की आवश्यकता होती है—उन्हें संदर्भ समझना, मल्टी-स्टेप क्वेरियों को तोड़ना, और रिट्रीव्ड दस्तावेज़ों के आधार पर व्यापक उत्तर देना होता है।
डोमेन-विशिष्ट नॉलेज रिट्रीवल
जहाँ डोमेन-विशिष्ट नॉलेज महत्वपूर्ण है, वहाँ उन्नत RAG सिस्टम अत्यधिक विशेषज्ञतापूर्ण कंटेंट रिट्रीव और जेनरेट कर सकते हैं। कुछ उल्लेखनीय अनुप्रयोग हैं:
व्यक्तिकृत सिफारिशें
व्यक्तिकृत सिफारिशी सिस्टम उन्नत RAG तकनीकों का एक और प्रमुख उपयोग-प्रकरण हैं। उपयोगकर्ता की पसंद, व्यवहार, और बाहरी डेटा स्रोतों को मिलाकर, RAG सिस्टम उत्पाद, सेवाएँ, या कंटेंट के लिए व्यक्तिगत सिफारिशें जनरेट कर सकते हैं, जिनमें शामिल हैं:
RAG सिस्टम का भविष्य
अगली पीढ़ी के RAG सिस्टम अधिक विविध डेटा स्रोतों का एकीकरण, बेहतर रीजनिंग क्षमताएँ, और अस्पष्टता व जटिल क्वेरियों के हैंडलिंग जैसी वर्तमान सीमाओं को संबोधित करेगी।
एक प्रमुख विकास क्षेत्र विभिन्न डेटा स्रोतों का एकीकरण है, जो एकल डेटासेट पर निर्भरता से आगे बढ़ेगा। भविष्य के सिस्टम डेटाबेस, API, और रियल-टाइम फ़ीड जैसे विविध स्रोतों की जानकारी को मिलाएँगे, जिससे जटिल क्वेरियों के लिए अधिक व्यापक और बहुआयामी उत्तर संभव होंगे।
अस्पष्ट या अपूर्ण क्वेरियों को संभालना एक और चुनौती है जिसे भविष्य के RAG सिस्टम संबोधित करेंगे। प्रायिकतामूलक तर्क और बेहतर संदर्भ समझ को मिलाकर, ये सिस्टम अनिश्चितता को अधिक प्रभावी ढंग से प्रबंधित करेंगे।
इसके अलावा, मल्टी-स्टेप रीजनिंग जटिल क्वेरियों को प्रोसेस करने के तरीके का अधिक अभिन्न हिस्सा बनेगा—उन्हें छोटे घटकों में तोड़कर और कई दस्तावेज़ों या चरणों में परिणामों का संश्लेषण करके। यह विशेष रूप से कानूनी शोध, वैज्ञानिक खोज, और ग्राहक सहायता जैसे क्षेत्रों में फायदेमंद होगा, जहाँ क्वेरियों में अक्सर विविध सूचनाओं को जोड़ना पड़ता है।
जैसे-जैसे व्यक्तिकरण और संदर्भ-जागरूकता में सुधार होता जाएगा, भविष्य के RAG सिस्टम उपयोगकर्ता के इतिहास, पसंद और पिछली इंटरैक्शन के आधार पर अपने उत्तरों को ट्यून करेंगे। नई जानकारी के लिए रियल-टाइम अनुकूलन अधिक गतिशील और उत्पादक बातचीत की अनुमति देगा।
आरेख napkin.ai से जनरेट किया गया
वर्तमान घनी रिट्रीवल मॉडल अत्यंत प्रभावी हैं, लेकिन और भी दक्ष और सटीक न्यूरल रिट्रीवल मॉडलों के विकास पर शोध जारी है। इन मॉडलों का लक्ष्य व्यापक क्वेरी-दस्तावेज़ जोड़ियों में सिमेंटिक समानताओं को बेहतर ढंग से पकड़ना और बड़े पैमाने के रिट्रीवल कार्यों में दक्षता सुधारना है।
जैसे Karpukhin et al. (2020) जैसे पेपर ने ओपन-डोमेन प्रश्नोत्तर के लिए Dense Passage Retrieval (DPR) को एक मुख्य विधि के रूप में प्रस्तुत किया, जबकि हालिया अध्ययन जैसे Izacard et al. (2022) डोमेन-विशिष्ट कार्यों के लिए RAG सिस्टम को अनुकूलित करने हेतु फ्यू-शॉट लर्निंग पर केंद्रित हैं।
एक और उभरता शोध क्षेत्र रिट्रीवल और जेनरेशन के बीच संबंध को रिट्रीवल-एन्हांस्ड जेनरेशन मॉडलों के माध्यम से सुधारने पर केंद्रित है। इन मॉडलों का लक्ष्य रिट्रीव्ड दस्तावेज़ों को जेनरेशन प्रक्रिया में सहजता से एकीकृत करना है, जिससे भाषा मॉडल अपने आउटपुट को रिट्रीव्ड कंटेंट पर अधिक प्रत्यक्ष रूप से कंडीशन कर सके।
यह हेल्यूसिनेशन को घटा सकता है और जनरेटेड उत्तरों की तथ्यात्मक सटीकता में सुधार कर सकता है, जिससे सिस्टम अधिक विश्वसनीय बनता है। उल्लेखनीय कार्यों में Huang et al. (2023) का RAVEN मॉडल शामिल है, जो रिट्रीवल-ऑग्मेंटेड एन्कोडर-डिकोडर मॉडलों का उपयोग करके इन-कॉन्टेक्स्ट लर्निंग में सुधार करता है।
निष्कर्ष
घनी रिट्रीवल, री-रैंकिंग, और मल्टी-स्टेप रीजनिंग जैसी उन्नत RAG तकनीकों का एकीकरण सुनिश्चित करता है कि RAG सिस्टम हेल्थकेयर से लेकर व्यक्तिकृत सिफारिशों तक वास्तविक-world अनुप्रयोगों की माँगों को पूरा कर सकें।
आगे देखते हुए, RAG सिस्टम का विकास क्रॉस-लिंगुअल क्षमताओं, व्यक्तिकृत जेनरेशन, और अधिक विविध डेटा स्रोतों के हैंडलिंग जैसी नवाचारों से प्रेरित होगा।
यदि आप सीखना जारी रखना चाहते हैं और RAG सिस्टम पर अधिक हैंड्स-ऑन होना चाहते हैं, तो मैं ये ट्यूटोरियल सुझाता हूँ: