
Last chance! 50% off DataCamp Premium
Sale ends in
Jika saya boleh menyarankan satu hal untuk dipelajari secara mendalam agar menjadi analis data atau data scientist yang lebih baik, itu adalah regresi. Dan satu bagian kunci dari mempelajari regresi adalah memahami dengan tepat apa itu heteroskedastisitas.
Dalam artikel ini, kita akan melihat fenomena heteroskedastisitas, mempelajari mengapa ini penting, cara mengidentifikasinya, dan langkah-langkah untuk menanganinya. Saya akan bersifat komprehensif namun tetap ringkas. Jadi, baik Anda analis berpengalaman maupun baru memulai, saya harap Anda menemukan sesuatu yang menarik dan bermanfaat di sini. Untuk informasi lebih lanjut dan memulai jalan menjadi ahli, ikuti Intro to Regression in R kami atau Intro to Regression in Python. Saya juga memiliki tutorial tentang regresi linear sederhana, jika Anda memerlukan ringkasan cepat.
Jadi, sebenarnya, apa itu heteroskedastisitas? Mari kita tuntaskan dulu definisi teknisnya sebelum melihat beberapa contoh. Jika Anda sulit menyebutkannya seperti saya, Anda bisa mengatakan “varian tidak sama” untuk menyampaikan maksudnya.
Heteroskedastisitas merujuk pada situasi di mana variabilitas variabel dependen tidak sama di seluruh rentang nilai variabel independen. Atau, untuk definisi yang lebih berlandaskan pada pembangunan model, kita bisa mengatakan bahwa heteroskedastisitas terjadi ketika sebaran atau dispersi residual tidak konstan, seperti yang kadang kita lihat pada model seperti model regresi atau model deret waktu.
Dalam arti tertentu, saya lebih menyukai definisi kedua karena mengingatkan kita bahwa heteroskedastisitas sebenarnya adalah aspek umum (meski juga masalah umum) dalam pemodelan statistik. Namun untuk memperjelas, meskipun heteroskedastisitas paling sering dibahas dalam konteks model seperti regresi, hal ini bisa jadi merupakan fitur spesifikasi model atau sifat dari data itu sendiri.
Mari lihat beberapa contoh menggunakan R dan memilih satu bidang — misalnya, keuangan rumah tangga. FSebagai awal, saya akan menunjukkan bentuk corong atau kipas klasik yang paling terlintas di benak saya saat memikirkan varian yang tidak sama.
Versi heteroskedastisitas ini dapat terjadi, misalnya, pada data pendapatan vs. pengeluaran: Keluarga berpendapatan rendah sering memiliki pengeluaran bulanan yang konsisten berfokus pada kebutuhan pokok seperti sewa dan makanan, sehingga variabilitasnya rendah; sementara keluarga berpendapatan lebih tinggi mungkin memiliki variabilitas pengeluaran yang lebih besar karena hanya sebagian rumah tangga berpendapatan tinggi yang memilih pembelian diskresioner mahal seperti liburan atau barang mewah, sementara yang lain menabung. Jadi, dalam contoh ini, saat pendapatan meningkat, variabilitas pengeluaran bulanan juga meningkat, sehingga membentuk pola kipas.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)y_inverse_funnel <- x + rnorm(length(x), mean = 0, sd = (1 / x) * 20)y_cyclical <- x + rnorm(length(x), mean = 0, sd = 10 * abs(sin(x / 5)))heteroscedasticity_data <- data.frame(x, y_funnel, y_inverse_funnel, y_cyclical)library(ggplot2)ggplot(heteroscedasticity_data, aes(x = x, y = y_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Funnel Shape", x = "X Values", y = "Y Values" )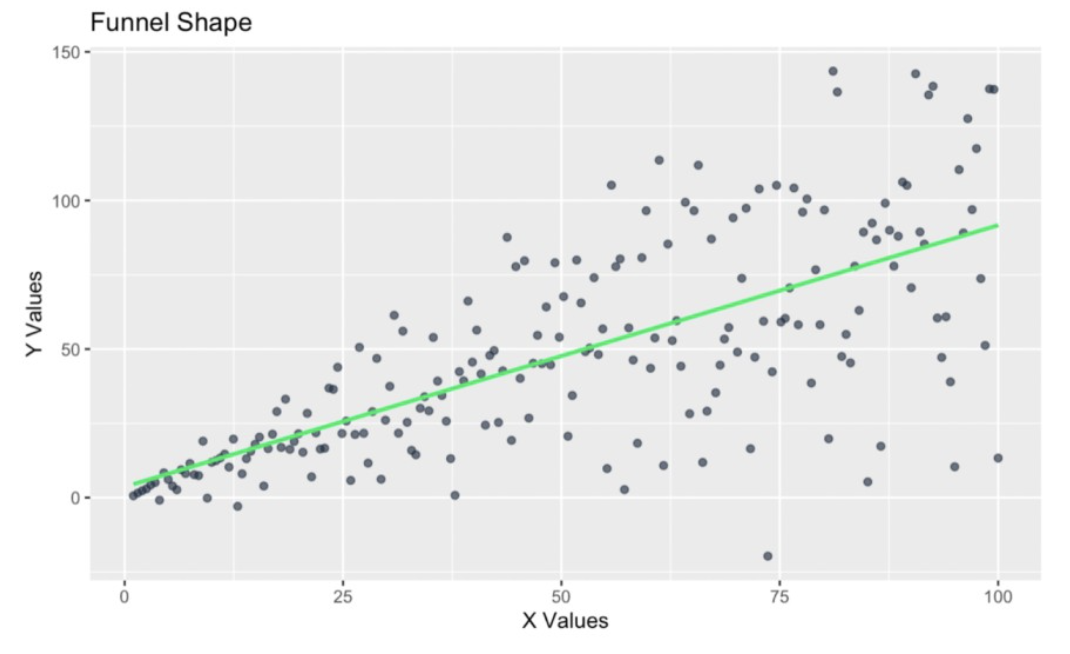
Bentuk corong pada residual. Gambar oleh Penulis
Mari coba contoh lain, juga dalam ranah keuangan rumah tangga. Bayangkan kini kita membuat model regresi untuk menunjukkan variabilitas tabungan terhadap usia anggota rumah tangga.
Kita menduga data ini akan menunjukkan heteroskedastisitas karena rumah tangga yang lebih muda mungkin memiliki variabilitas tabungan yang tinggi akibat pendapatan tidak teratur, seperti pekerjaan gig dan magang, atau pengeluaran tak terduga, seperti pinjaman pendidikan atau memulai keluarga. Namun seiring bertambahnya usia rumah tangga dan stabilnya kondisi finansial, perilaku menabung menjadi lebih konsisten, menciptakan bentuk corong terbalik di mana variabilitas menurun seiring bertambahnya usia.
ggplot(heteroscedasticity_data, aes(x = x, y = y_inverse_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Inverse Funnel Shape", x = "X Values", y = "Y Values" )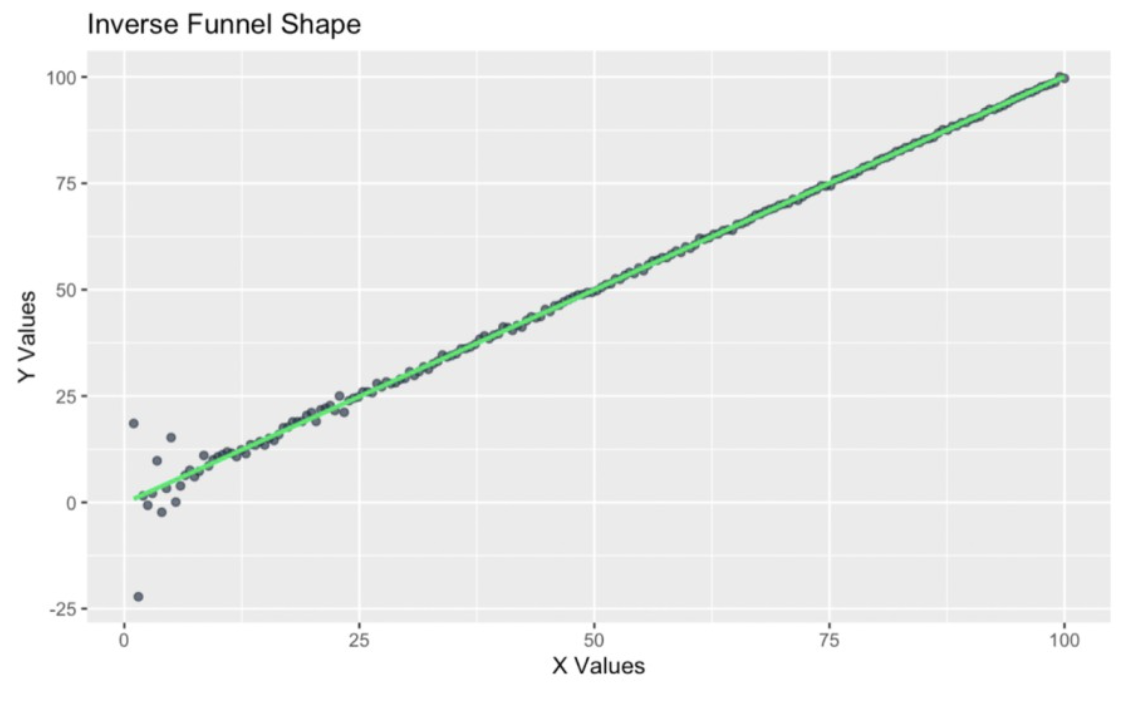
Bentuk corong terbalik pada residual. Gambar oleh Penulis
Mari lihat contoh terakhir dengan pendapatan rumah tangga. Di sini, kita melihat varians siklis, khususnya varians pengeluaran lintas musim. Anda mungkin mengenali pola seperti ini jika Anda mengikuti salah satu kursus peramalan kami, seperti Forecasting in R yang sangat populer.
Kita tahu bahwa pengeluaran rumah tangga sering berfluktuasi secara siklis sepanjang tahun. Misalnya, varians bisa meningkat selama musim liburan karena kita membeli hadiah atau bepergian untuk bertemu keluarga, dan varians menurun pada bulan-bulan lain yang lebih sedikit hari liburnya, mungkin Maret atau September. Grafik berikut menunjukkan heteroskedastisitas namun dengan cara yang lebih rumit, di mana varians meningkat dan menurun pada periode yang berbeda.
ggplot(heteroscedasticity_data, aes(x = x, y = y_cyclical)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Cyclical Pattern", x = "X Values", y = "Y Values" )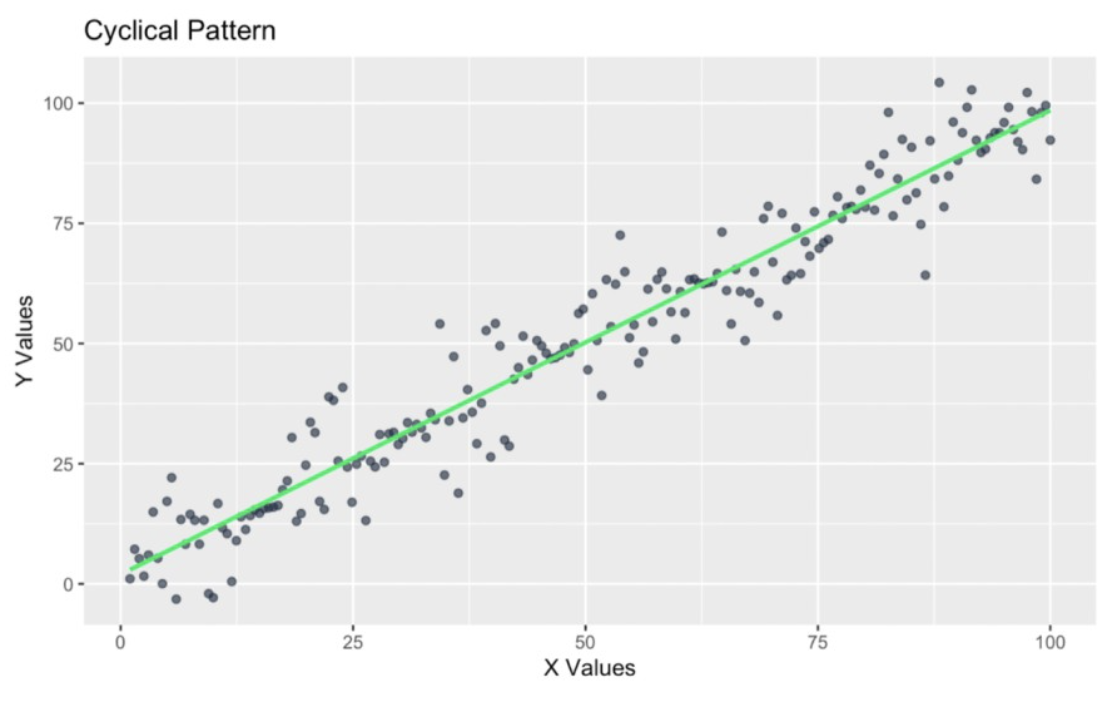
Pola siklis pada residual. Gambar oleh Penulis
Jadi, seperti yang Anda lihat, heteroskedastisitas dapat berbentuk beragam. Sekarang mari lihat mengapa semua ini penting.
Saya berani mengatakan bahwa, secara umum, Anda tidak dapat melakukan regresi dengan benar tanpa memahami sesuatu tentang heteroskedastisitas karena heteroskedastisitas sangat umum dan dapat sangat memengaruhi serta mendistorsi hasil kita.
Mungkin karena alasan inilah homoskedastisitas — kebalikan dari heteroskedastisitas — sebenarnya merupakan salah satu asumsi utama model regresi, bersama dengan linearitas, kemandirian galat, normalitas residual, dan ketiadaan multikolinearitas.
Asumsi-asumsi regresi ini penting karena membantu memastikan prediksi dan inferensi model kita bermakna. Ketika asumsi-asumsi ini dilanggar, keandalan estimasi kita, termasuk galat baku dan interval kepercayaan, dapat menurun, dan uji hipotesis kita menjadi kurang valid.
Heteroskedastisitas tidak muncul begitu saja. Akar masalahnya sering terletak pada cara data dikumpulkan atau ditransformasikan. Mari kita lihat baik isu transformasi data maupun pengumpulan data.
Terkadang, langkah-langkah yang kita ambil untuk menyiapkan data justru dapat memperkenalkan heteroskedastisitas. Saya memikirkan bagaimana penskalaan yang tidak tepat atau transformasi nonlinier dapat menciptakan variabilitas yang tidak diinginkan.
Untuk memikirkannya, bayangkan kita sedang mempelajari hubungan antara ukuran apartemen dan sewa bulanannya. Biasanya, kita mungkin mengharapkan hubungan linear antara ukuran dan sewa karena apartemen yang lebih besar biayanya lebih tinggi, dan varians sewa mungkin tidak serta merta meningkat seiring ukuran karena hubungan (mungkin) proporsional. Kira-kira seperti inilah tampilannya:
set.seed(1024)size <- runif(1000, 500, 2000) # Random sizes between 500 and 2000 sq ftrent <- 20 * size + rnorm(100, mean = 0, sd = 5000) # Linear relation with added noiseunequal_variance_df <- data.frame(size = size, rent = rent)ggplot(unequal_variance_df, aes(x = size, y = rent)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent", x = "Size (sq ft)", y = "Rent")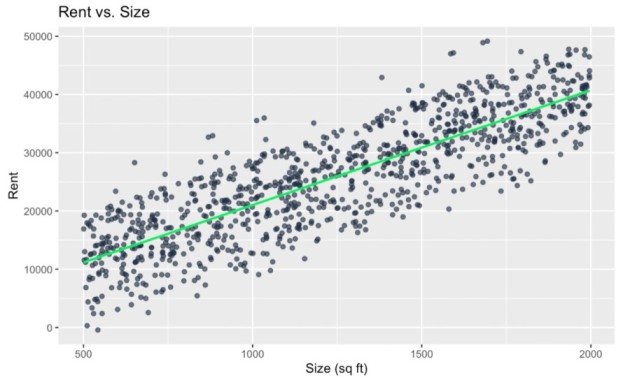
Tidak ada heteroskedastisitas. Gambar oleh Penulis
Jika kita menskalakan sewa berdasarkan ukuran untuk menghitung "sewa per kaki persegi", kita membuat metrik baru. Jika kemudian kita mencoba memprediksi sewa per kaki persegi berdasarkan sewa, kita mungkin melihat bahwa transformasi ini menciptakan atau membesar-besarkan heteroskedastisitas. Untuk memperjelas, secara umum, saya mengakui ini bukan ide yang baik — membagi variabel independen dengan variabel dependen — karena kita menciptakan situasi di mana y sudah dipengaruhi oleh x dan dengan demikian menciptakan korelasi semu. Jadi, saya sadar ini menimbulkan tantangan konseptual dan statistik. Tetapi (mohon maklum) saya menggunakan ini sebagai contoh untuk mengilustrasikan poinnya:
unequal_variance_df$rent_per_sqft <- unequal_variance_df$rent / unequal_variance_df$sizeggplot(unequal_variance_df, aes(x = size, y = rent_per_sqft)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent per Square Foot", x = "Size (sq ft)", y = "Rent per Sq Ft")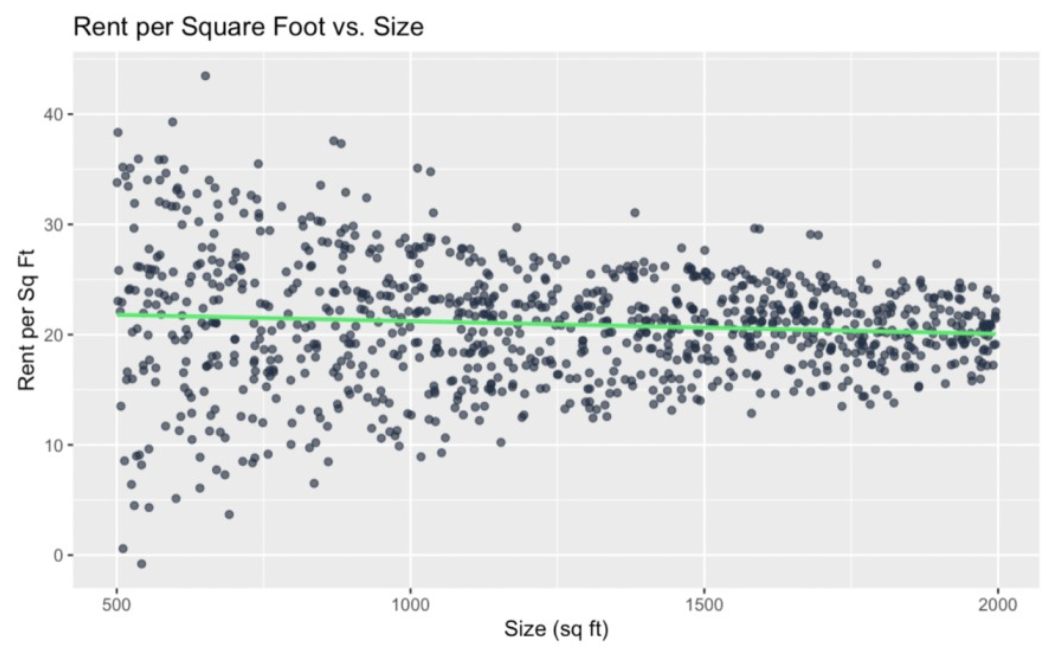
Heteroskedastisitas yang diinduksi akibat ketergantungan fungsional. Gambar oleh Penulis
Kita dapat melihat grafik ini memiliki bentuk corong di mana variabilitas sewa per kaki persegi menurun seiring bertambahnya ukuran. Jadi, kita menciptakan heteroskedastisitas dari ketiadaan. Untuk contoh lain, kita dapat mengkuadratkan kedua variabel:
unequal_variance_df$size_squared <- unequal_variance_df$size^2ggplot(unequal_variance_df, aes(x = size ^ 2, y = rent ^ 2)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size Squared vs. Rent Squared", x = "Size Squared", y = "Rent Squared")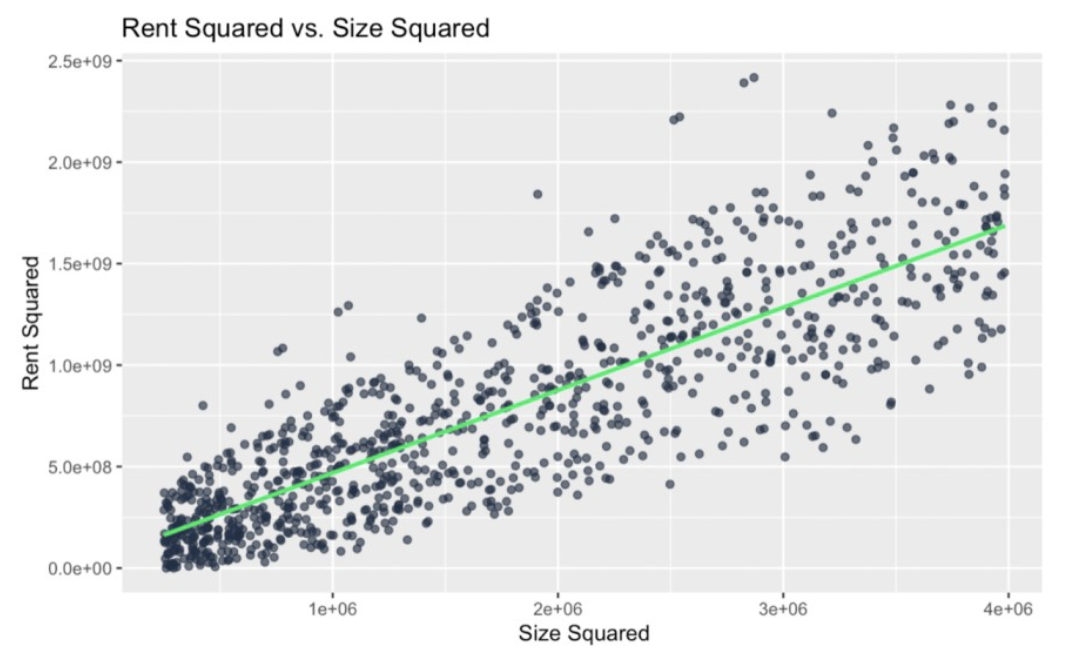
Heteroskedastisitas yang diinduksi akibat penguadratan. Gambar oleh Penulis
Sekali lagi, kita menciptakan heteroskedastisitas di mana sebelumnya tidak ada, karena kita bersikeras menguadratkan x dan y. Dalam beberapa konteks, ini tidak masalah, tetapi di sini saya menduga bahwa menguadratkan kedua variabel akan menimbulkan heteroskedastisitas karena saya pikir transformasi tersebut akan memperbesar perbedaan varians seiring meningkatnya nilai variabel.
Contoh kedua ini juga agak dibuat-buat karena kita sebaiknya tidak membuat model ini. Kita tidak akan membuat model ini karena akan sulit diinterpretasikan tanpa alasan. Namun, dalam alur kerja pemodelan dunia nyata, transformasi yang tanpa sengaja menciptakan heteroskedastisitas bisa lebih halus. Anda mungkin melewatkannya jika prosesnya melibatkan banyak langkah.
Lebih tepatnya, dalam kasus ini, heteroskedastisitas muncul akibat rekayasa fitur dengan rasio. Rasio seperti "sewa per kaki persegi" memang umum dalam rekayasa fitur. Namun, variabel-variabel ini dapat memperkenalkan heteroskedastisitas jika penyebutnya, khususnya, bervariasi secara signifikan antarobservasi. Transformasi logaritmik atau eksponensial juga sering digunakan untuk menstabilkan varians atau melinierkan hubungan. Namun, menerapkannya secara tidak konsisten dapat berbalik arah. Misalkan Anda memiliki model di mana Anda mentransformasi log pendapatan tetapi gagal menyesuaikan fitur terkait seperti pengeluaran. Ketidakselarasan seperti ini adalah sumber umum heteroskedastisitas, jadi pastikan semuanya selaras agar Anda tidak menimbulkan dinamika semu.
Heteroskedastisitas juga bisa muncul dari praktik pengumpulan data yang tidak konsisten. Misalnya, mengganti alat ukur di tengah studi dapat memperkenalkan heteroskedastisitas. Memiliki kelompok berukuran berbeda dan, karenanya, ukuran sampel berbeda dalam sebuah studi juga dapat menciptakan heteroskedastisitas. Konsisten dengan satu pendekatan adalah penting.
Mendeteksi heteroskedastisitas adalah langkah pertama untuk menanganinya, dan untungnya, ada alat visual dan statistik yang dapat membantu.
Diagram sebar dapat mengungkap pola dalam data Anda yang membantu menemukan heteroskedastisitas. Saya menyukai plot nilai terpasang vs. residual untuk ini. Perlu dicatat, histogram residual atau plot q-q residual tidak cukup untuk mendeteksi heteroskedastisitas karena kedua plot ini paling baik digunakan untuk menguji normalitas.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)heteroscedasticity_data <- data.frame(x, y_funnel)unequal_variance_model <- lm(y_funnel ~ x, heteroscedasticity_data)fitted_values_vs_residuals <- ggplot(data = unequal_variance_model, aes(x = .fitted, y = .resid)) + geom_point(color = '#203147') + geom_hline(yintercept = 0, linetype = "dashed", color = '#01ef63', size = 1) + xlab("fitted values") + ylab("residuals") + labs(title = "Heteroscedasticity Data") + labs(subtitle = "Fitted Values vs Residuals")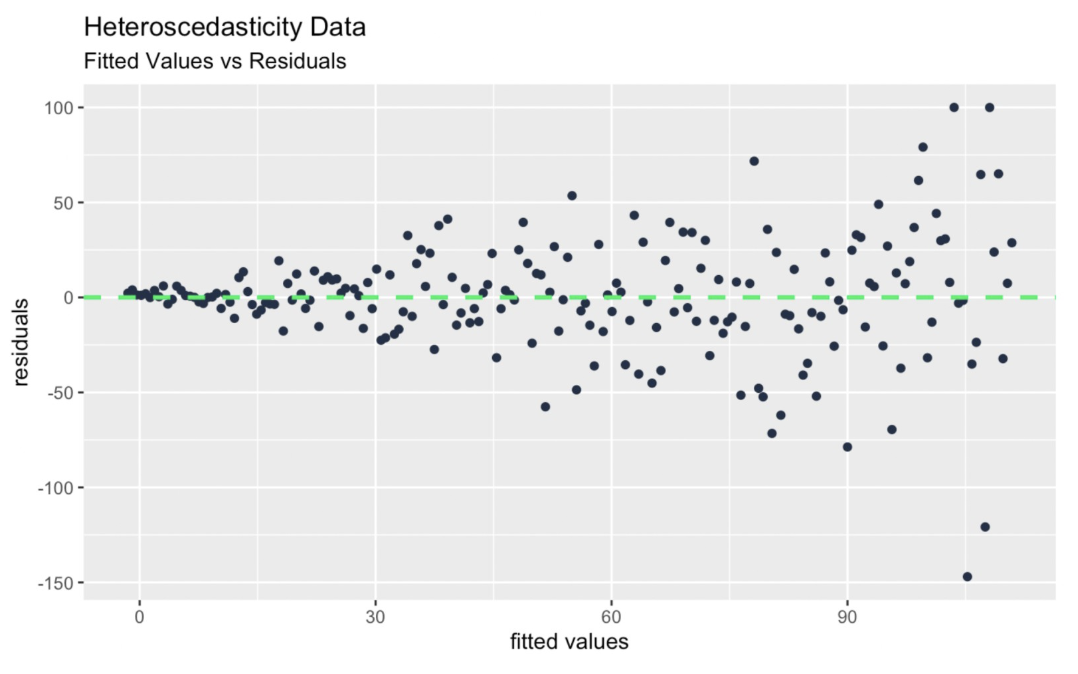 Plot diagnostik nilai terpasang vs. residual. Gambar oleh Penulis
Uji statistik seperti uji Breusch–Pagan menawarkan pendekatan yang lebih kuantitatif. Breusch–Pagan bekerja dengan melihat apakah residual kuadrat dari model berhubungan dengan prediktor. Untuk melakukan uji ini, kita mencocokkan model dan menggunakan fungsi bptest() dari pustaka lmtest. Perlu diketahui uji ini mengasumsikan residual berdistribusi normal.
library(lmtest)model <- lm(rent ~ size, data = unequal_variance_df)bp_test <- bptest(model)print(bp_test)Setelah Anda mengidentifikasi heteroskedastisitas, langkah berikutnya adalah mengatasinya dengan teknik-teknik yang telah teruji.
Transformasi sederhana, seperti menerapkan logaritma, sering kali dapat mengurangi atau menghilangkan heteroskedastisitas. Sebelumnya, kita mengambil model tanpa varian tidak sama, menerapkan transformasi dan menimbulkan masalah, tetapi lebih lazim yang terjadi sebaliknya: Kita menggunakan transformasi seperti logaritma, akar kuadrat, atau resiprok untuk memampatkan nilai besar sekaligus memperluas nilai kecil. Misalnya, jika sewa justru tumbuh secara eksponensial terhadap ukuran, mengambil log sewa akan meratakan pertumbuhan eksponensial dan membuat hubungan menjadi linear dengan (mungkin) varians yang sama.
Selain itu, saya ingin menekankan bahwa saat menyiapkan data, kita sering berpikir untuk memperbaiki kemencengan. Misalnya, jika kita memiliki data menceng ke kanan, kita mungkin menggunakan transformasi akar kuadrat untuk membuat data menjadi Gaussian. Namun yang mungkin kurang kita sadari adalah bahwa pada data yang menceng, nilai yang lebih besar juga cenderung memiliki variabilitas lebih tinggi, yang juga merupakan pelanggaran asumsi homoskedastisitas.
Ketika transformasi tidak cukup, metode regresi robust seperti weighted least squares (WLS) dapat membantu. Weighted least squares sangat menarik di sini karena dirancang untuk menangani masalah data seperti heteroskedastisitas dan pencilan. Secara khusus, WLS memberikan bobot pada observasi berdasarkan variansnya, sehingga mengurangi pengaruh titik data dengan variabilitas lebih tinggi, dan dengan demikian memberikan estimasi yang lebih stabil. Catatan, dengan WLS, kita berasumsi bobotnya diketahui atau diestimasi dengan baik.
Mengabaikan heteroskedastisitas mungkin tampak tidak berbahaya, tetapi dapat menimbulkan masalah.
Heteroskedastisitas dapat mendistorsi bagaimana model menafsirkan pentingnya fitur. Misalnya, dalam model pengeluaran, fitur seperti pendapatan mungkin tampak lebih penting jika terkait dengan kelompok ber-variabilitas tinggi, seperti rumah tangga berpendapatan tinggi dengan pembelian diskresioner. Representasi yang keliru ini dapat membuat kita terlalu menekankan prediktor yang kurang andal sambil meremehkan yang lebih konsisten, sehingga memengaruhi kegunaan model.
Heteroskedastisitas dapat menggugurkan penggunaan uji statistik umum seperti uji t atau uji F jika Anda mengasumsikan varians yang sama dan asumsi ini tidak terpenuhi. Varians yang tidak sama juga bermasalah dalam data deret waktu, di mana pola variabilitas berkembang dari waktu ke waktu, yang menimbulkan kebingungan saat menganalisis tren musiman. Heteroscedasticity-consistent standard errors (HCSE) dapat digunakan untuk membantu memungkinkan inferensi statistik yang lebih andal.
Dalam artikel ini, kita telah mempelajari situasi di mana varians residual tidak konstan di berbagai tingkat variabel independen dalam sebuah model. Di sini, saya ingin membahas secara singkat gagasan terkait, yaitu heterogenitas varians tingkat kelompok, yang mengacu pada variabilitas di seluruh kelompok yang telah ditentukan, yang kurang merupakan isu statistik yang terkait dengan asumsi model dan lebih merupakan pengamatan deskriptif terhadap data.
Saya akan menunjukkan dengan contoh terakhir. Di sini, saya akan menggunakan simulasi data survei. Saya mempertimbangkan skenario di mana data pendapatan dikumpulkan menggunakan dua metode berbeda: survei dan catatan administrasi. Metode ini mungkin memiliki tingkat ketelitian yang berbeda (Bukankah survei terkenal akan hal ini?). Kita dapat melihat bahwa besaran variasi dalam setiap kelompok tidak konsisten, yang dapat menjadi masalah untuk sesuatu seperti ANOVA.
set.seed(1024)income_admin <- rnorm(500, mean = 50000, sd = 2000) spending_admin <- income_admin * 0.3 + rnorm(500, mean = 0, sd = 1000)income_survey <- rnorm(500, mean = 50000, sd = 8000) # Same mean, higher SDspending_survey <- income_survey * 0.3 + rnorm(500, mean = 0, sd = 5000)income <- c(income_admin, income_survey)spending <- c(spending_admin, spending_survey)method <- rep(c("Administrative Records", "Survey"), each = 500)survey_and_admin_data <- data.frame(income = income, spending = spending, method = method) # Plot the datacustom_colors <- c("Administrative Records" ='#01ef63', "Survey" = '#203147')ggplot(survey_and_admin_data, aes(x = income, y = spending, color = method)) + geom_point(alpha = 0.7) + labs( title = "Variability in Data Collection", x = "Income", y = "Spending")+ scale_color_manual(values = custom_colors)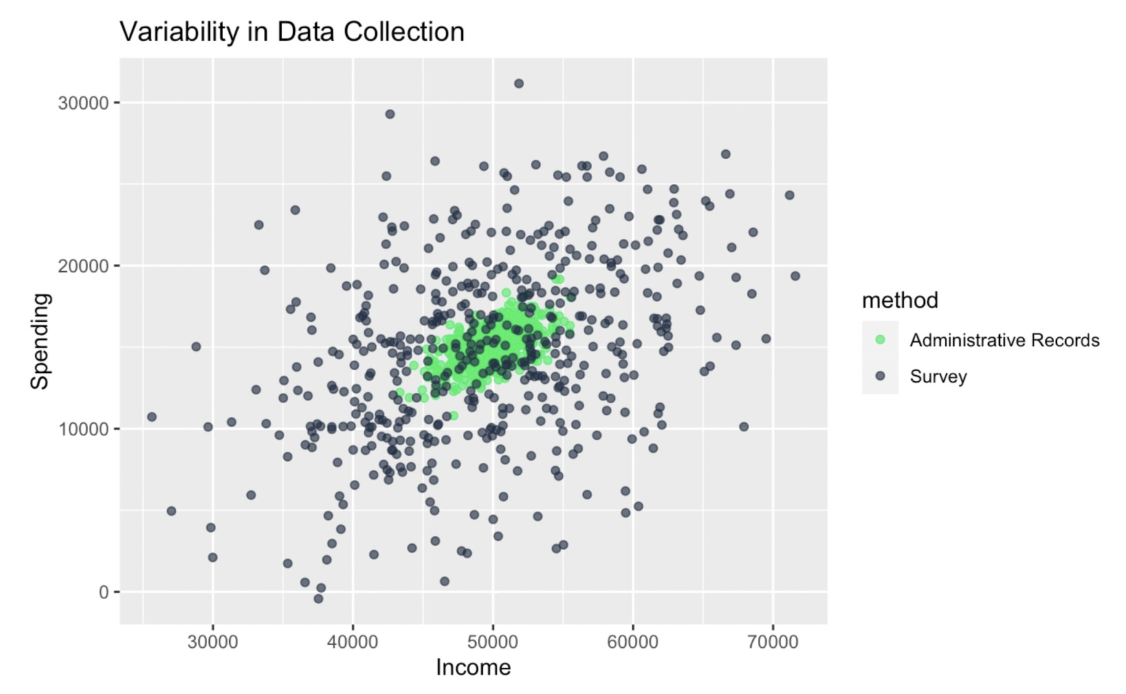
Heterogenitas varians tingkat kelompok. Gambar oleh Penulis
Menangani heteroskedastisitas bukan sekadar tentang memperbaiki model regresi Anda. Ini tentang memastikan pekerjaan Anda tahan uji. Untuk terus belajar dan menjadi ahli, ikuti jalur Statistical Inference in R dan kursus Foundations of Inference in R. Saya juga berpikir jalur Statistician in R kami merupakan opsi hebat lainnya untuk pembelajaran dan pengembangan karier.
Pelajari Regresi bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt




