
{count, plural, one {Kursus} other {Kursus}}
Perancangan Basis Data
{hours} jam
131.1K
Saya telah menjadi engineer full-stack selama beberapa tahun ketika saya mendapatkan proyek rekayasa data pertama saya. Sampai saat itu, saya mengerjakan frontend, mengembangkan API, serta mengelola dan melakukan deploy infrastruktur cloud cukup rutin.
Seperti banyak engineer di startup tahap awal, saya juga bersentuhan dengan database, merancang tabel atau skema baru di sana-sini, dan memigrasikan sejumlah kecil data. Namun kemudian, perusahaan tempat saya bekerja mulai mengumpulkan data dalam jumlah besar, dan kinerja database mulai menurun.
Aplikasi kami melambat, latensi meningkat, dan kami bahkan mengalami downtime saat beban puncak. Itu masalah yang sangat membuat frustrasi dan tim saya bekerja keras untuk memperbaikinya. Saat itulah saya belajar banyak tentang database, cara kerjanya, dan cara mengoptimalkannya.
Dalam blog ini, saya akan menjelaskan salah satu konsep yang benar-benar membuat perbedaan saat itu dan berkali-kali lagi selama beberapa tahun terakhir: sharding database.
Sharding database adalah praktik membagi sebuah database menjadi subset yang lebih kecil, atau shard, di mana setiap shard berfungsi sebagai database independen. Anggap saja seperti memecah satu spreadsheet raksasa menjadi beberapa lembar yang lebih kecil dan lebih mudah dikelola, masing-masing menangani bagiannya sendiri dari beban kerja.
Sharding BUKAN jawaban untuk setiap masalah database.
Ada metode penskalaan horizontal lain, seperti replikasi, atau metode penskalaan vertikal, yang jauh lebih mudah diterapkan. Pertimbangkan ini terlebih dahulu sebelum terjun ke sharding!
Sharding berperan ketika database Anda mulai kesulitan mengikuti kebutuhan aplikasi yang berkembang. Mungkin basis pengguna Anda melonjak, atau aplikasi Anda menghasilkan data dalam jumlah besar setiap detik. Jika Anda melihat kueri lambat, latensi meningkat, atau sering downtime saat lalu lintas puncak, itu mungkin tanda bahwa database Anda mencapai batasnya.
Salah satu alasan besar untuk sharding adalah skalabilitas. Saat data Anda tumbuh, menambah perangkat keras pada satu server database (penskalaan vertikal) hanya dapat membantu sampai batas tertentu, dan bisa sangat mahal. Di sisi lain, sharding memungkinkan Anda melakukan penskalaan horizontal dengan mendistribusikan data ke beberapa server, masing-masing menangani sebagian beban.
Alasan lain memilih sharding adalah kinerja. Bahkan jika database Anda dapat menangani volume data, melakukan kueri melalui jumlah informasi yang sangat besar memerlukan waktu. Dengan sharding, Anda bekerja dengan dataset yang lebih kecil dan lebih fokus, yang berarti kueri lebih cepat dan persaingan sumber daya berkurang.
Adapun kapan harus melakukan sharding, biasanya yang terbaik adalah mempertimbangkannya ketika aplikasi Anda mulai melampaui apa yang dapat ditangani oleh satu database. Waktu pastinya bergantung pada banyak variabel, seperti sumber daya dan proyeksi pertumbuhan Anda, dan ini butuh pertimbangan yang cermat. Menerapkan sharding terlalu dini dapat menambah kompleksitas yang tidak perlu ketika satu database atau pengoptimalan sederhana sudah cukup, tetapi menunggu terlalu lama dapat membuat transisi menjadi menyakitkan.
Patokan yang baik adalah memantau metrik kinerja database Anda dengan saksama dan merencanakan ke depan. Jika Anda melihat bottleneck atau pertumbuhan data yang cepat yang dapat menimbulkan masalah dalam waktu dekat, mungkin saatnya mengeksplorasi sharding. Percayalah, mengantisipasi masalah akan menyelamatkan Anda dari banyak sakit kepala di kemudian hari!
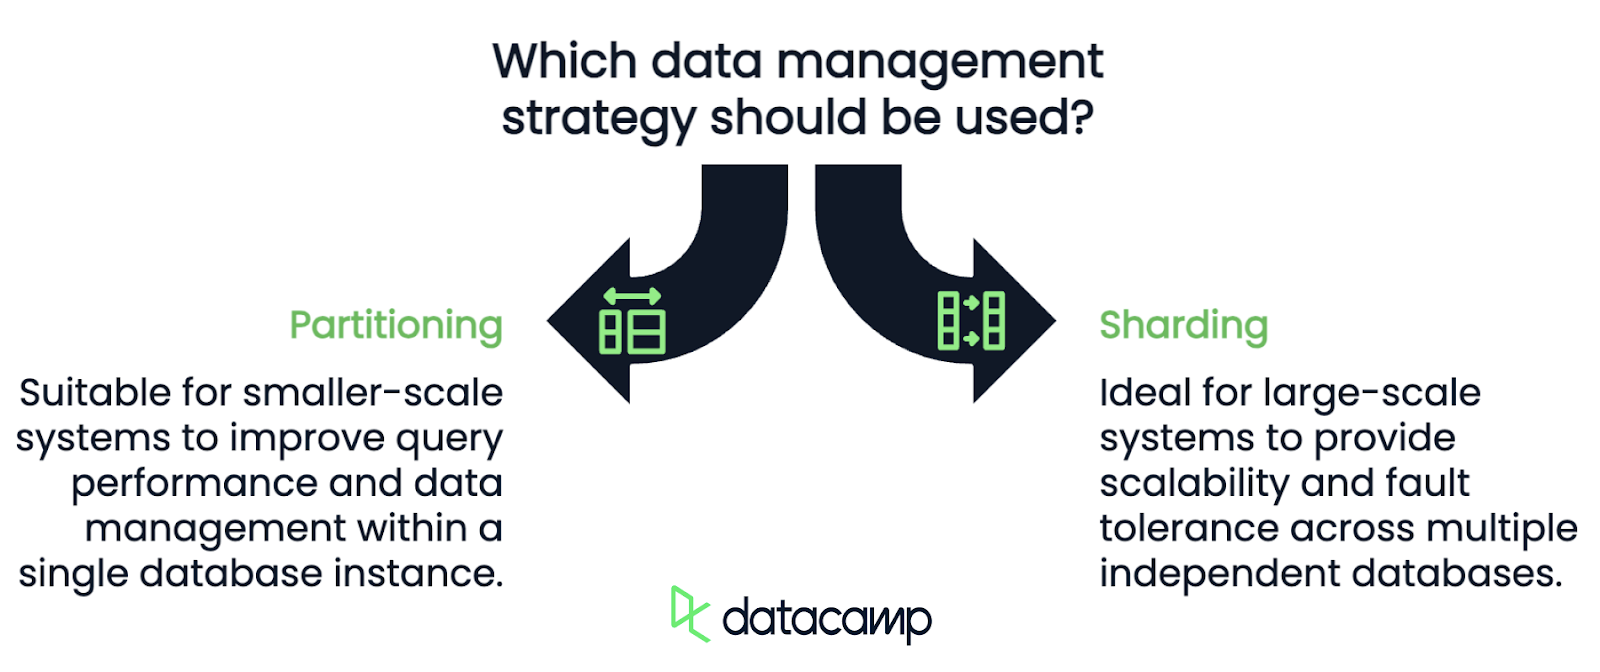
Sekilas, sharding dan partisi tampak seperti konsep yang sama karena keduanya melibatkan pemecahan data menjadi bagian-bagian lebih kecil untuk organisasi dan kinerja yang lebih baik. Namun keduanya memiliki tujuan berbeda dan cocok untuk skala operasi yang berbeda.
Partisi adalah proses membagi data menjadi segmen logis dalam instance database yang sama. Segmen-segmen ini, sering disebut partisi, dapat didasarkan pada kriteria seperti rentang, daftar, atau hash. Misalnya, dalam database pengguna, Anda dapat menyimpan pengguna yang lahir pada Januari dalam satu partisi, Februari di partisi lain, semuanya dalam database yang sama.
Partisi adalah pilihan yang sangat baik untuk sistem skala kecil yang belum perlu melakukan penskalaan horizontal. Ini meningkatkan kinerja kueri dengan membatasi jumlah data yang dipindai saat kueri dan membuat pengelolaan data lebih efisien.
Sharding, di sisi lain, membawa partisi ke tingkat berikutnya dengan mendistribusikan segmen logis ini ke beberapa database independen. Setiap shard adalah database mandiri yang menangani data dan kuerinya sendiri.
Pendekatan ini ideal untuk sistem skala besar di mana satu database tidak lagi dapat menangani beban. Sharding menyediakan skalabilitas dan toleransi kesalahan karena setiap shard beroperasi secara independen.
Berdasarkan pengalaman saya, partisi sering menjadi batu loncatan menuju sharding. Jika Anda mulai melihat masalah kinerja namun database Anda belum mencapai batasnya, partisi dapat memberi Anda waktu sambil mempersiapkan solusi skala lebih besar seperti sharding.
Jika Anda tertarik pada desain database, lihat kursus desain database lengkap ini. Anda akan mempelajari cara mengatur, mengelola, dan mengoptimalkan database SQL, serta cara menyiapkan berbagai jenis partisi.
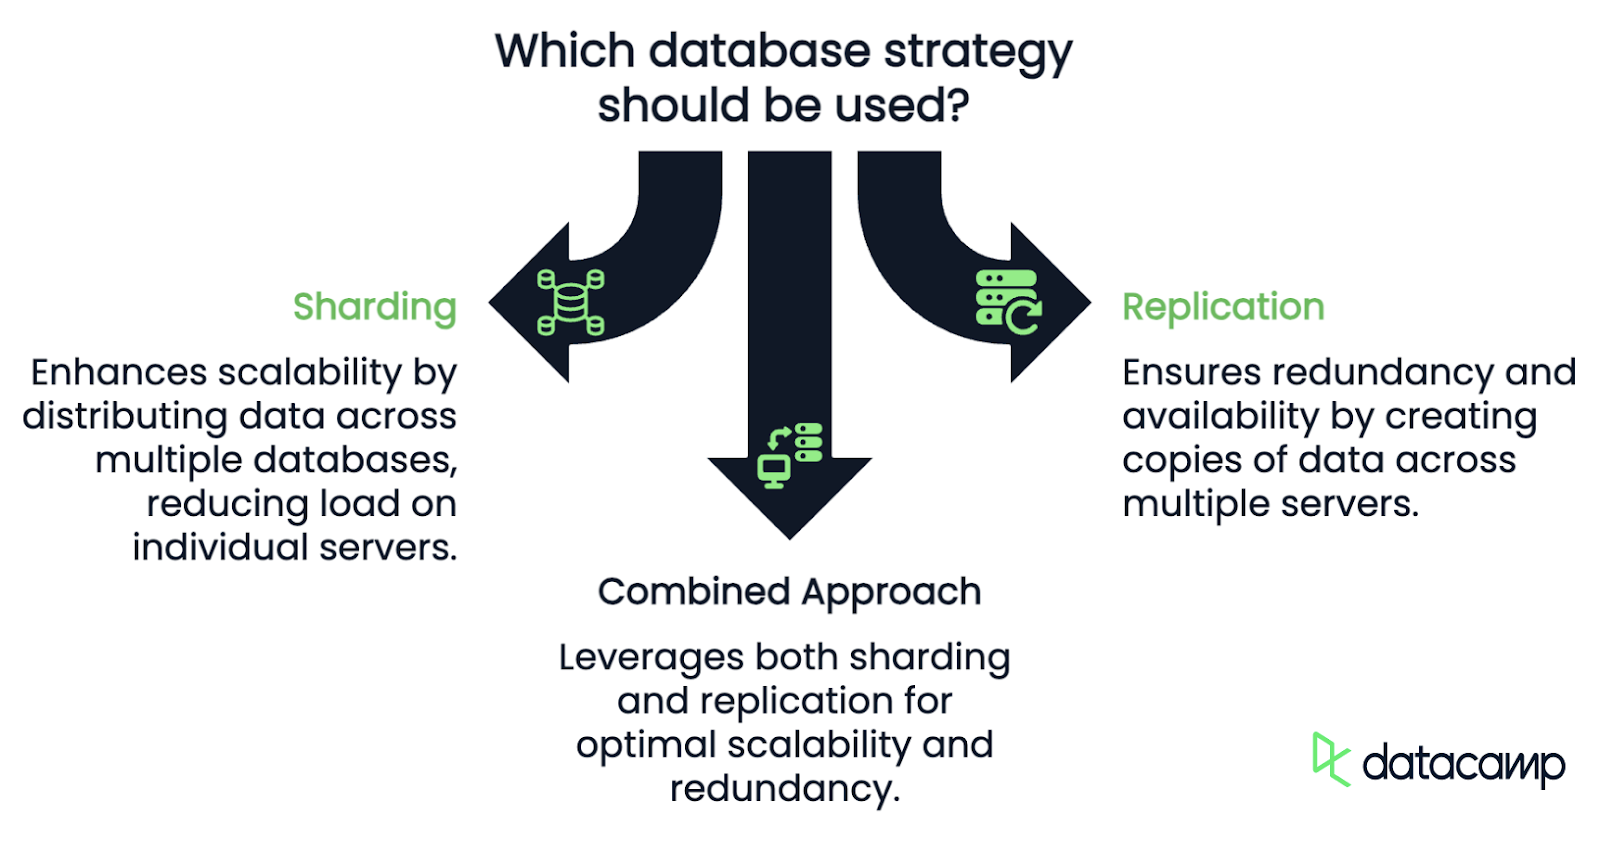
Mirip seperti di atas, sharding dan replikasi sering dibahas berdampingan, tetapi keduanya menangani masalah yang berbeda dan memiliki use case yang berbeda.
Tujuan utama sharding adalah skalabilitas. Dengan membagi data dan beban kerja ke beberapa database, Anda mengurangi beban pada satu database. Sharding memastikan bahwa saat data Anda tumbuh, Anda dapat menambahkan lebih banyak shard untuk menampungnya, menjaga kinerja dan mengurangi risiko membebani satu database.
Replikasi, di sisi lain, melibatkan pembuatan salinan data yang sama di beberapa server. Setiap replika berisi seluruh dataset dan dapat secara independen menangani operasi baca, yang berarti replikasi berfokus pada redundansi dan ketersediaan alih-alih skalabilitas.
Dengan memiliki beberapa salinan database, Anda terlindungi dari kehilangan data dan memastikan sistem tetap online bahkan jika satu server down, tetapi ini tidak menyelesaikan masalah pertumbuhan volume data. Faktanya, karena setiap replika menyimpan seluruh dataset, kebutuhan penyimpanan tumbuh sebanding dengan jumlah replika. Selain itu, operasi tulis dapat menjadi bottleneck, karena harus diterapkan ke semua replika untuk menjaga konsistensi data.
Intinya, ini tidak harus salah satu atau yang lain. Dalam praktiknya, banyak sistem skala besar menggunakan sharding dan replikasi secara bersamaan. Misalnya, database yang di-shard juga bisa memiliki replika untuk setiap shard.
Jadi, bagaimana tepatnya sharding bekerja? Mari kita uraikan menjadi tiga komponen utama.
Langkah pertama dalam sharding adalah mencari cara membagi data Anda. Logika partisi adalah seperangkat aturan yang menentukan bagaimana data dibagi ke shard. Ada beberapa cara umum untuk melakukannya:
Pilihan logika partisi bergantung pada data dan kebutuhan aplikasi Anda. Saya pribadi melihat partisi berbasis rentang bekerja baik untuk data kronologis, seperti riwayat transaksi, sementara metode berbasis hash lebih baik pada sistem dengan beban kerja yang tidak terduga.
Setelah data Anda dipartisi, Anda memerlukan cara untuk memetakan setiap partisi ke shard yang sesuai.
Beberapa sistem menggunakan pemetaan statis, di mana data ditetapkan ke shard berdasarkan aturan tetap. Yang lain menggunakan pemetaan dinamis, sering dikelola oleh layanan metadata pusat, yang memudahkan penambahan atau penghapusan shard sesuai kebutuhan. Apa pun pilihannya, tujuannya adalah memastikan sistem Anda tahu persis di mana menemukan setiap potongan data.
Terakhir, Anda memerlukan mekanisme untuk memastikan kueri dikirim ke shard yang benar. Ini disebut perutean kueri, dan ini penting agar sharding berjalan pada aplikasi Anda. Saat aplikasi mengirimkan kueri, logika perutean menentukan shard mana (atau shard mana saja) yang menyimpan data terkait dan mengirimkan permintaan ke sana.
Dalam beberapa kasus, ini sesederhana aplikasi itu sendiri mengetahui ke mana mengirim setiap kueri berdasarkan logika partisi. Dalam pengaturan lain, lapisan proxy atau middleware menangani perutean, sehingga kerumitan tidak terlihat oleh aplikasi. Saya pernah menggunakan kedua pendekatan ini, dan meskipun proxy menambah sedikit overhead, proxy dapat menghemat banyak upaya pada sistem yang lebih besar.
Tidak ada satu pendekatan tunggal untuk sharding. Strategi yang Anda pilih sangat bergantung pada struktur data Anda dan bagaimana Anda menggunakannya. Saya akan membahas beberapa yang paling umum, tetapi ada lebih dari tiga.
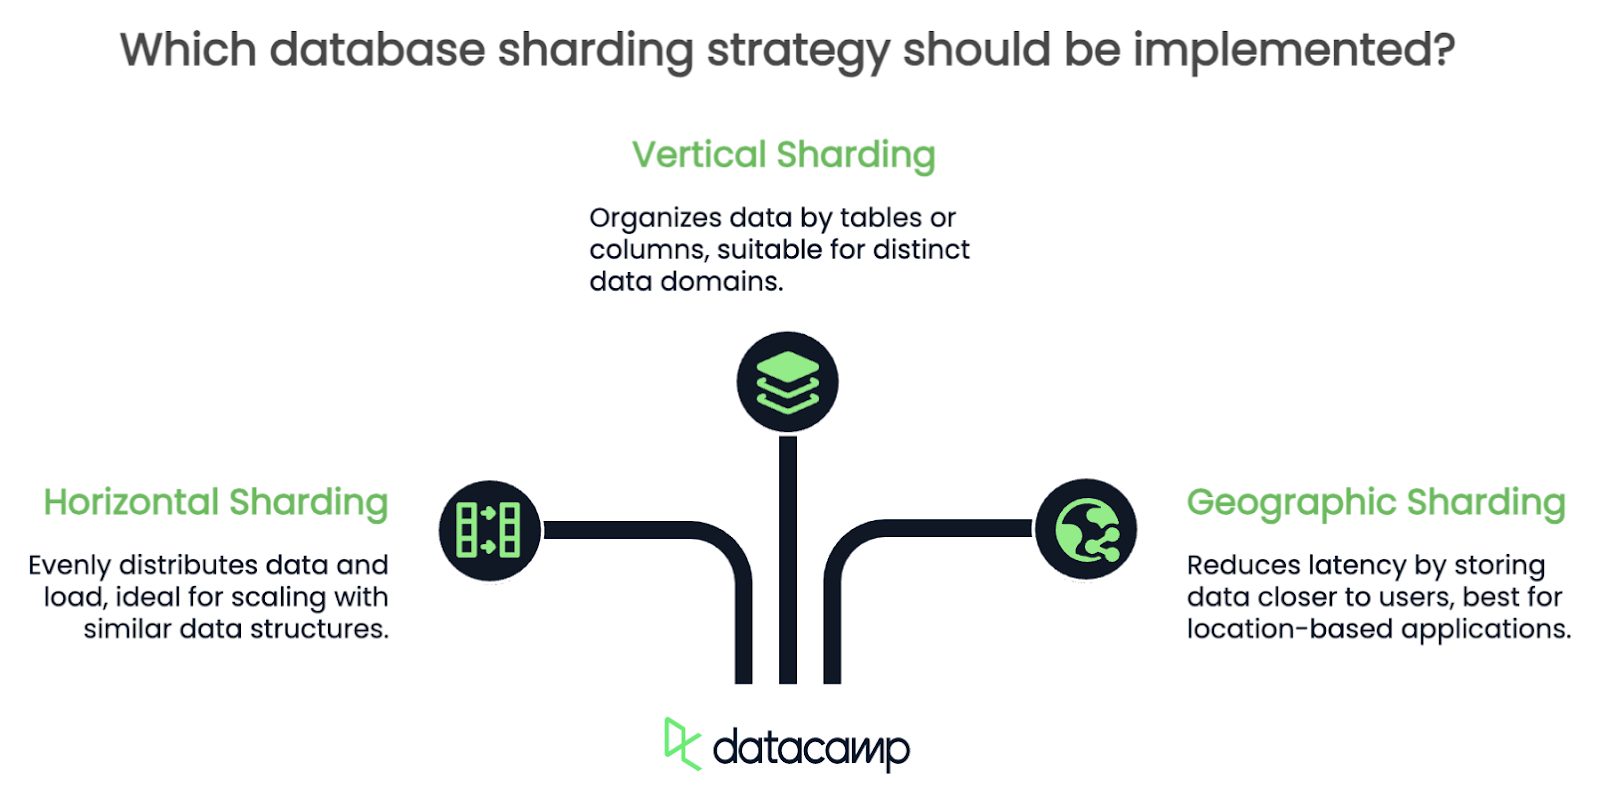
Sharding horizontal membagi baris sebuah tabel ke beberapa shard. Misalnya, jika Anda mengelola database pengguna, Anda dapat membagi pengguna ke shard berdasarkan ID-nya: pengguna 1–1000 di satu shard, 1001–2000 di shard lain, dan seterusnya.
Pendekatan ini adalah salah satu yang paling populer karena mendistribusikan data dan beban secara merata, sehingga memudahkan penskalaan horizontal seiring pertumbuhan aplikasi Anda. Ini sangat efektif ketika tabel Anda memiliki banyak baris dengan struktur serupa.
Saat menggunakan sharding horizontal, Anda harus sangat berhati-hati saat memilih logika partisi. Distribusi data yang buruk berarti beban kerja sangat tidak merata, dan beberapa shard akan kelebihan beban sementara yang lain menganggur.
Dalam sharding vertikal, Anda membagi database berdasarkan tabel atau kolom. Misalnya, Anda dapat menempatkan profil pengguna di satu shard, data transaksi di shard lain, dan log di shard ketiga. Setiap shard pada dasarnya bertanggung jawab atas subset data tertentu.
Strategi ini bekerja baik ketika aplikasi Anda memiliki domain data yang jelas dan terpisah yang tidak banyak berinteraksi, tetapi satu hal yang perlu diwaspadai adalah kueri lintas shard. Jika aplikasi Anda sering perlu menggabungkan data dari shard yang berbeda, sharding vertikal justru dapat menciptakan lebih banyak bottleneck kinerja daripada sebelumnya!
Sharding geografis mengatur data berdasarkan lokasi pengguna. Misalnya, semua data pengguna Eropa dapat berada di satu shard, sementara data Amerika Utara berada di shard lain. Strategi ini mengurangi latensi dengan memastikan data pengguna disimpan lebih dekat ke lokasi aksesnya.
Namun, sharding geografis memiliki tantangannya sendiri. Anda perlu menangani dengan hati-hati pengguna yang bepergian antarwilayah atau yang datanya mencakup beberapa lokasi. Menjaga konsistensi data di seluruh shard juga bisa menjadi rumit.
Terkadang, menggabungkan beberapa strategi bisa menjadi solusi terbaik—misalnya, menggunakan sharding horizontal di dalam shard geografis. Kuncinya adalah menyeimbangkan kesederhanaan, skalabilitas, dan kinerja. Anda harus memelihara database setelah membuat shard ini, jadi permudah diri Anda di masa depan!
Anda tidak perlu memulai dari nol dan menerapkan sharding sendiri. Ada banyak alat dan framework yang memudahkan sharding dan menawarkan fitur bawaan untuk menangani kompleksitasnya bagi Anda.
ProxySQL bertindak sebagai lapisan proxy cerdas dan menangani perutean kueri serta penyeimbangan beban untuk database MySQL yang di-shard. Ia mempertahankan pemetaan shard mana yang menyimpan data apa, dan ketika sebuah kueri masuk, ia secara otomatis merutekannya ke shard yang sesuai sehingga aplikasi Anda tidak perlu menangani logikanya.
Saya belum pernah bekerja langsung dengan ProxySQL, tetapi seorang teman bersaksi bahwa kemampuannya menangani perutean kueri menghemat berjam-jam konfigurasi manual!
MongoDB memiliki dukungan sharding bawaan, yang membuatnya menjadi opsi populer untuk menangani dataset tidak terstruktur yang besar. MongoDB menggunakan kunci sharding untuk menentukan bagaimana dokumen didistribusikan ke shard, jadi Anda harus memilihnya dengan cermat. Pilihan yang buruk dapat menyebabkan distribusi data tidak merata dan masalah kinerja!
MongoDB kemudian menangani sisanya: partisi, penyeimbangan data, dan perutean kueri secara otomatis.
Citus adalah opsi hebat bagi mereka yang lebih menyukai database relasional. Citus pada dasarnya adalah ekstensi yang mengubah PostgreSQL menjadi database terdistribusi.
Saya pernah bekerja dalam tim yang menggunakan Citus untuk melakukan skala sebuah aplikasi SaaS, dan ini memungkinkan kami mempertahankan ketangguhan PostgreSQL dan tabel terstruktur sekaligus menangani data dalam jumlah besar.
Citus menggunakan perencana kueri terdistribusi untuk menangani kueri kompleks lintas shard, dan sangat berguna untuk aplikasi dengan beban analitik tinggi di mana Anda perlu menggabungkan data dari beberapa shard. Kurva belajarnya lebih curam dibandingkan sharding bawaan MongoDB, tetapi hasilnya sepadan!
Saya harap panduan ini memberi Anda bekal untuk mengeksplorasi sharding di sistem Anda sendiri (atau keyakinan untuk mengatakan bahwa itu belum menjadi solusi yang tepat untuk Anda saat ini!). Ingat, ini bukan solusi serba cocok, tetapi bila digunakan dengan bijak, ini adalah alat yang ampuh untuk menciptakan arsitektur yang skalabel dan efisien.
Dan sebagai seseorang yang belajar melalui cara yang sulit, saran saya adalah: jangan menunggu sampai database Anda kewalahan untuk mulai memikirkan sharding. Rencanakan ke depan, bereksperimenlah, dan beradaptasilah! Diri Anda di masa depan (dan pengguna Anda) akan berterima kasih.
Pelajari data engineering dengan kursus-kursus ini!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



