
Last chance! 50% off DataCamp Premium
Sale ends in
Facevo l'ingegnere full-stack da un paio d'anni quando mi assegnarono il mio primo progetto di data engineering. Fino a quel momento avevo scritto codice per il frontend, sviluppato API e gestito e distribuito con una certa regolarità l'infrastruttura cloud.
Come molti ingegneri nelle startup nelle prime fasi, avevo messo mano anche ai database, progettando ogni tanto una nuova tabella o uno schema e migrando piccole quantità di dati. Poi, però, l'azienda per cui lavoravo ha iniziato a raccogliere enormi quantità di dati e le prestazioni del database hanno iniziato a calare.
Le nostre applicazioni rallentavano, la latenza aumentava e capitava perfino di avere downtime durante i picchi di carico. È stato un problema molto frustrante su cui il mio team ha lavorato sodo. È allora che ho imparato un sacco sui database, su come funzionano e su come ottimizzarli.
In questo blog ti spiegherò uno dei concetti che allora ha fatto davvero la differenza e che mi è tornato utile molte altre volte negli ultimi anni: lo sharding del database.
Lo sharding del database è la pratica di suddividere un database in sottoinsiemi più piccoli, o shard, ognuno dei quali funziona come un database indipendente. È un po' come spezzare un gigantesco foglio di calcolo in diversi fogli più piccoli e gestibili, ognuno con la propria parte di carico di lavoro.
Lo sharding NON è la risposta a ogni problema di database.
Esistono altri metodi di scalabilità orizzontale, come la replica, o metodi di scalabilità verticale, molto più semplici da implementare. Dai un'occhiata prima a questi, prima di buttarti nello sharding!
Lo sharding entra in gioco quando il tuo database inizia a faticare a tenere il passo con le richieste di un'applicazione in crescita. Magari la tua base utenti è esplosa o la tua applicazione genera enormi quantità di dati ogni secondo. Se noti query lente, latenza in aumento o frequenti downtime durante il traffico di punta, probabilmente è un segno che il tuo database sta raggiungendo i suoi limiti.
Un grande motivo per fare sharding è la scalabilità. Con la crescita dei dati, aggiungere più hardware a un singolo server di database (scalabilità verticale) ti porta solo fino a un certo punto e può diventare molto costoso. Lo sharding, invece, ti consente di scalare orizzontalmente distribuendo i dati su più server, ognuno dei quali gestisce una parte del carico.
Un altro motivo per scegliere lo sharding è la performance. Anche se il tuo database può gestire il volume di dati, interrogare quantità enormi di informazioni può richiedere tempo. Con lo sharding lavori con dataset più piccoli e mirati, il che significa query più rapide e minore contesa delle risorse.
Quanto al momento giusto per fare sharding, di solito è meglio considerarlo quando la tua applicazione sta iniziando a superare ciò che un singolo database può gestire. Il timing esatto dipende da molte variabili, come le tue risorse e la crescita prevista, e richiede un certo equilibrio. Implementare lo sharding troppo presto può introdurre complessità inutile quando un singolo database o semplici ottimizzazioni sarebbero bastati, ma aspettare troppo può rendere la transizione dolorosa.
Una buona regola pratica è monitorare da vicino le metriche di performance del database e pianificare in anticipo. Se noti colli di bottiglia o una rapida crescita dei dati che potrebbe causare problemi a breve, probabilmente è il momento di esplorare lo sharding. Fidati, giocare d'anticipo ti risparmierà un sacco di grattacapi in futuro!
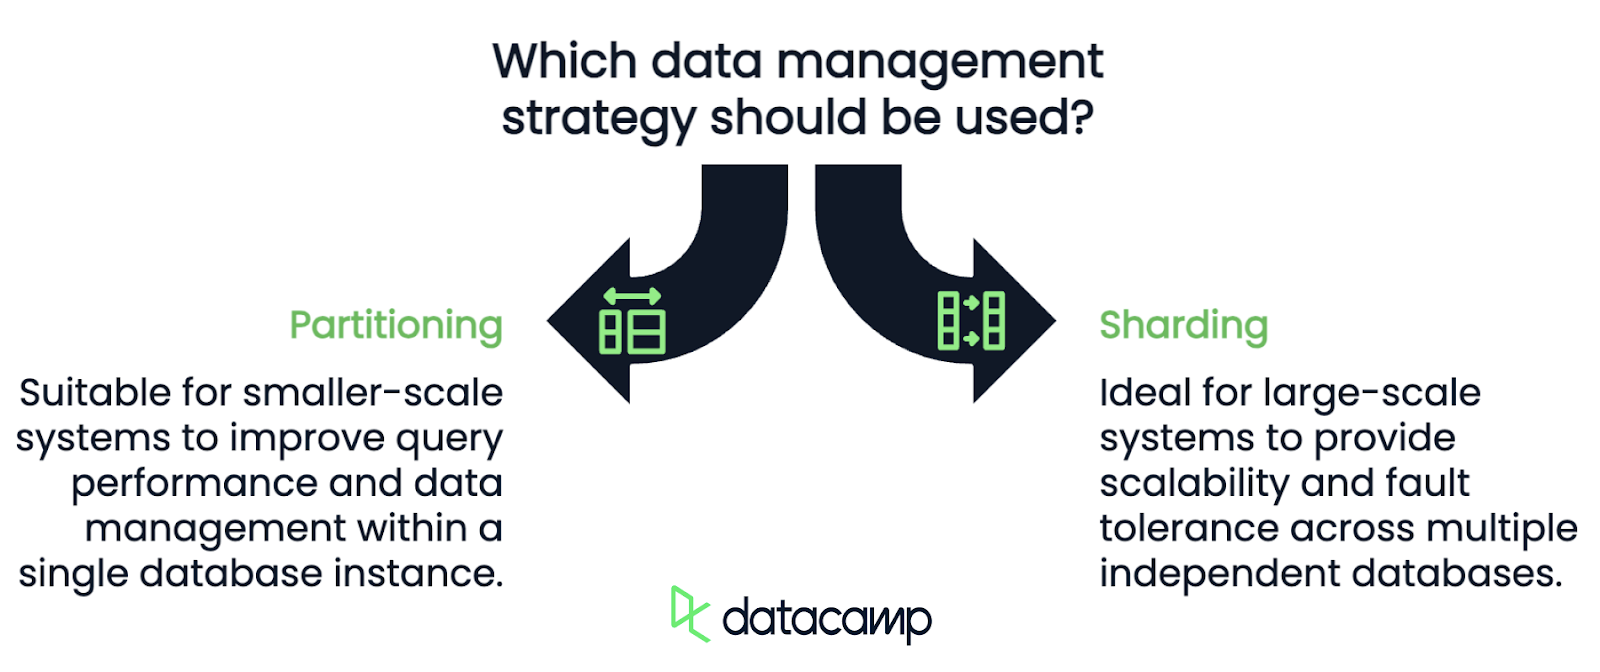
A prima vista, sharding e partizionamento possono sembrare lo stesso concetto perché entrambi prevedono di suddividere i dati in parti più piccole per una migliore organizzazione e prestazioni. Ma servono scopi diversi e sono adatti a scale operative differenti.
Il partizionamento è il processo di divisione dei dati in segmenti logici all'interno della stessa istanza di database. Questi segmenti, spesso chiamati partizioni, possono basarsi su criteri come range, lista o hash. Ad esempio, in un database utenti, potresti memorizzare gli utenti nati a gennaio in una partizione, quelli di febbraio in un'altra, il tutto nello stesso database.
Il partizionamento è un'ottima scelta per sistemi su scala ridotta che non devono ancora scalare orizzontalmente. Migliora le prestazioni delle query limitando la quantità di dati scansionati durante le interrogazioni e rende la gestione dei dati più efficiente.
Lo sharding, invece, porta il partizionamento al livello successivo distribuendo questi segmenti logici su più database indipendenti. Ogni shard è un database autonomo che gestisce i propri dati e le proprie query.
Questo approccio è ideale per sistemi su larga scala in cui un singolo database non riesce più a reggere il carico. Lo sharding offre sia scalabilità che tolleranza ai guasti, poiché ogni shard opera in modo indipendente.
Per esperienza, il partizionamento è spesso un trampolino verso lo sharding. Se inizi a vedere problemi di performance ma il tuo database non è ancora al limite, il partizionamento può farti guadagnare tempo mentre prepari una soluzione su scala maggiore come lo sharding.
Se ti interessa il design dei database, dai un'occhiata a questo corso completo di database design. Imparerai a organizzare, gestire e ottimizzare database SQL e anche a impostare diversi tipi di partizionamento.
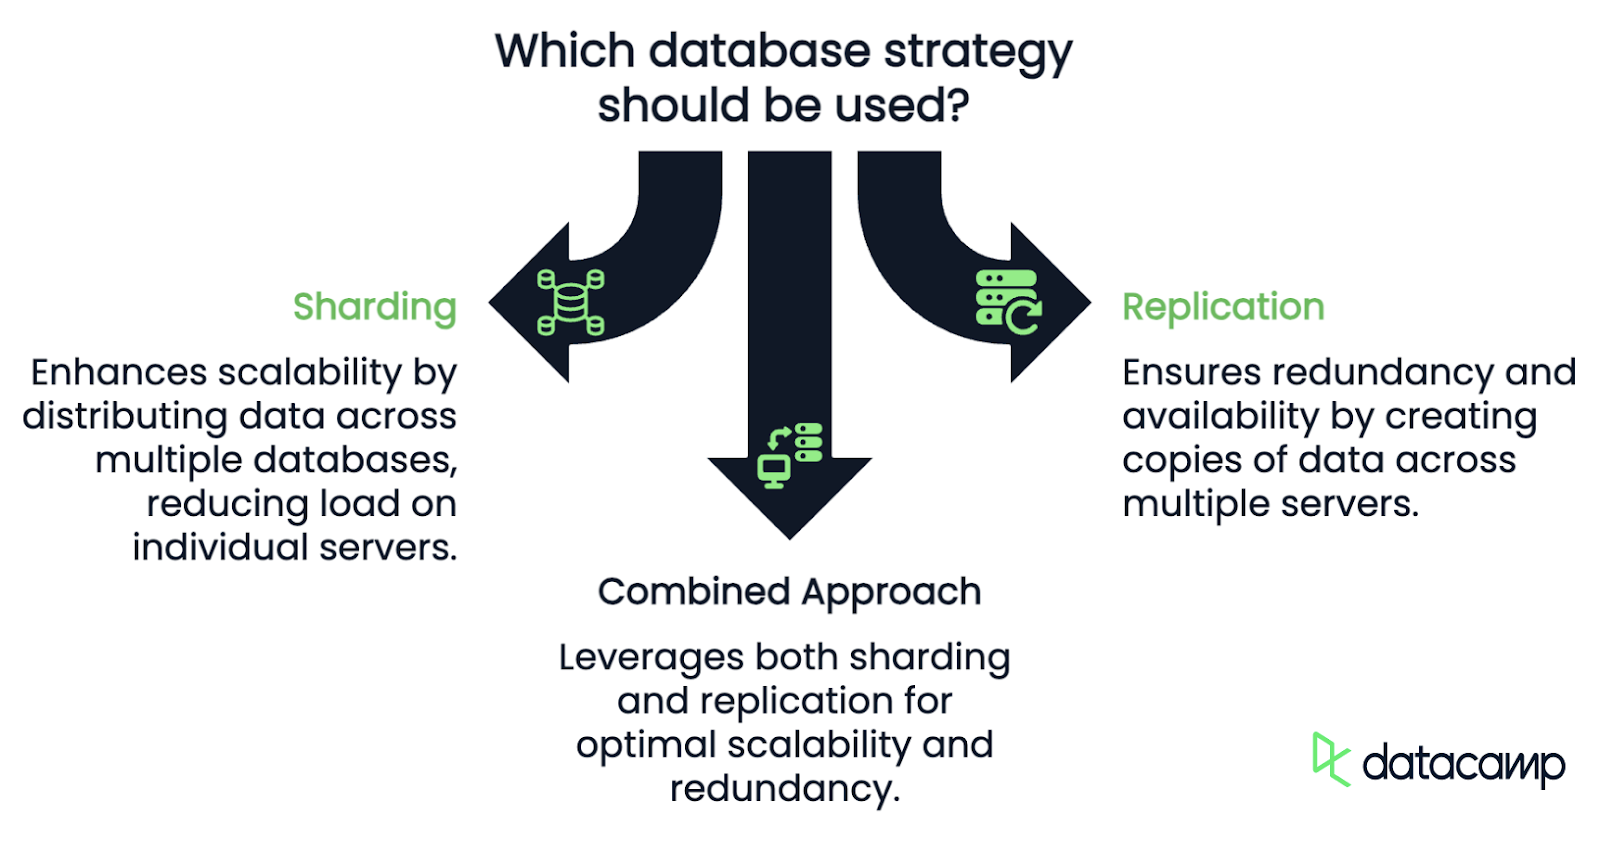
Analogamente a quanto sopra, sharding e replica vengono spesso discussi insieme, ma affrontano problemi diversi e hanno casi d'uso distinti.
L'obiettivo principale dello sharding è la scalabilità. Dividendo i dati e il carico di lavoro su più database, riduci il carico su un singolo database. Lo sharding garantisce che, man mano che i tuoi dati crescono, tu possa aggiungere più shard per accoglierli, mantenendo le prestazioni e riducendo il rischio di sovraccaricare un singolo database.
La replica, invece, consiste nel creare copie degli stessi dati su più server. Ogni replica contiene l'intero dataset e può gestire in modo indipendente le operazioni di lettura, il che significa che la replica è focalizzata su ridondanza e disponibilità più che su scalabilità.
Avere più copie del database ti protegge dalla perdita di dati e assicura che il sistema resti online anche se un server va giù, ma non risolve il problema della crescita dei volumi di dati. Anzi, dato che ogni replica memorizza l'intero dataset, i requisiti di storage crescono in proporzione al numero di repliche. In più, le operazioni di scrittura possono diventare un collo di bottiglia, poiché devono essere applicate a tutte le repliche per mantenere i dati consistenti.
La verità è che non è per forza una scelta esclusiva. Nella pratica, molti sistemi su larga scala usano insieme sia sharding che replica. Per esempio, un database shardato può avere anche repliche di ciascuno shard.
Ok, ma come funziona esattamente lo sharding? Vediamolo in tre componenti chiave.
Il primo passo nello sharding è capire come dividere i dati. La tua logica di partizionamento è l'insieme di regole che determinano come i dati vengono suddivisi tra gli shard. Ci sono diversi modi comuni per farlo:
La scelta della logica di partizionamento dipende dai tuoi dati e dalle esigenze dell'applicazione. Personalmente ho visto funzionare bene il partizionamento per range con dati cronologici, come le cronologie delle transazioni, mentre i metodi basati su hash hanno reso meglio in sistemi con carichi di lavoro imprevedibili.
Una volta partizionati i dati, ti serve un modo per mappare ogni partizione al relativo shard.
Alcuni sistemi usano una mappatura statica, in cui i dati vengono assegnati agli shard in base a regole fisse. Altri usano una mappatura dinamica, spesso gestita da un servizio centrale di metadati, che facilita l'aggiunta o la rimozione di shard secondo necessità. In ogni caso, l'obiettivo è garantire che il sistema sappia esattamente dove trovare qualsiasi dato.
Infine, ti serve un meccanismo che assicuri che le query vengano inviate allo shard corretto. Questo è l'instradamento delle query ed è fondamentale per far funzionare lo sharding nella tua applicazione. Quando un'applicazione invia una query, la logica di routing determina quale shard (o quali shard) contiene i dati rilevanti e invia lì la richiesta.
In alcuni casi, può essere semplice come far sì che l'applicazione stessa sappia dove inviare ogni query in base alla logica di partizionamento. In altri setup, un livello di proxy o middleware gestisce l'instradamento, astraendo la complessità lontano dall'applicazione. Ho lavorato con entrambi gli approcci e, sebbene i proxy aggiungano un po' di overhead, possono farti risparmiare molto sforzo nei sistemi più grandi.
Non esiste un unico approccio allo sharding. La strategia che scegli dipende molto dalla struttura dei tuoi dati e da come li usi. Passerò in rassegna alcune delle più comuni, ma ce ne sono molte più di tre.
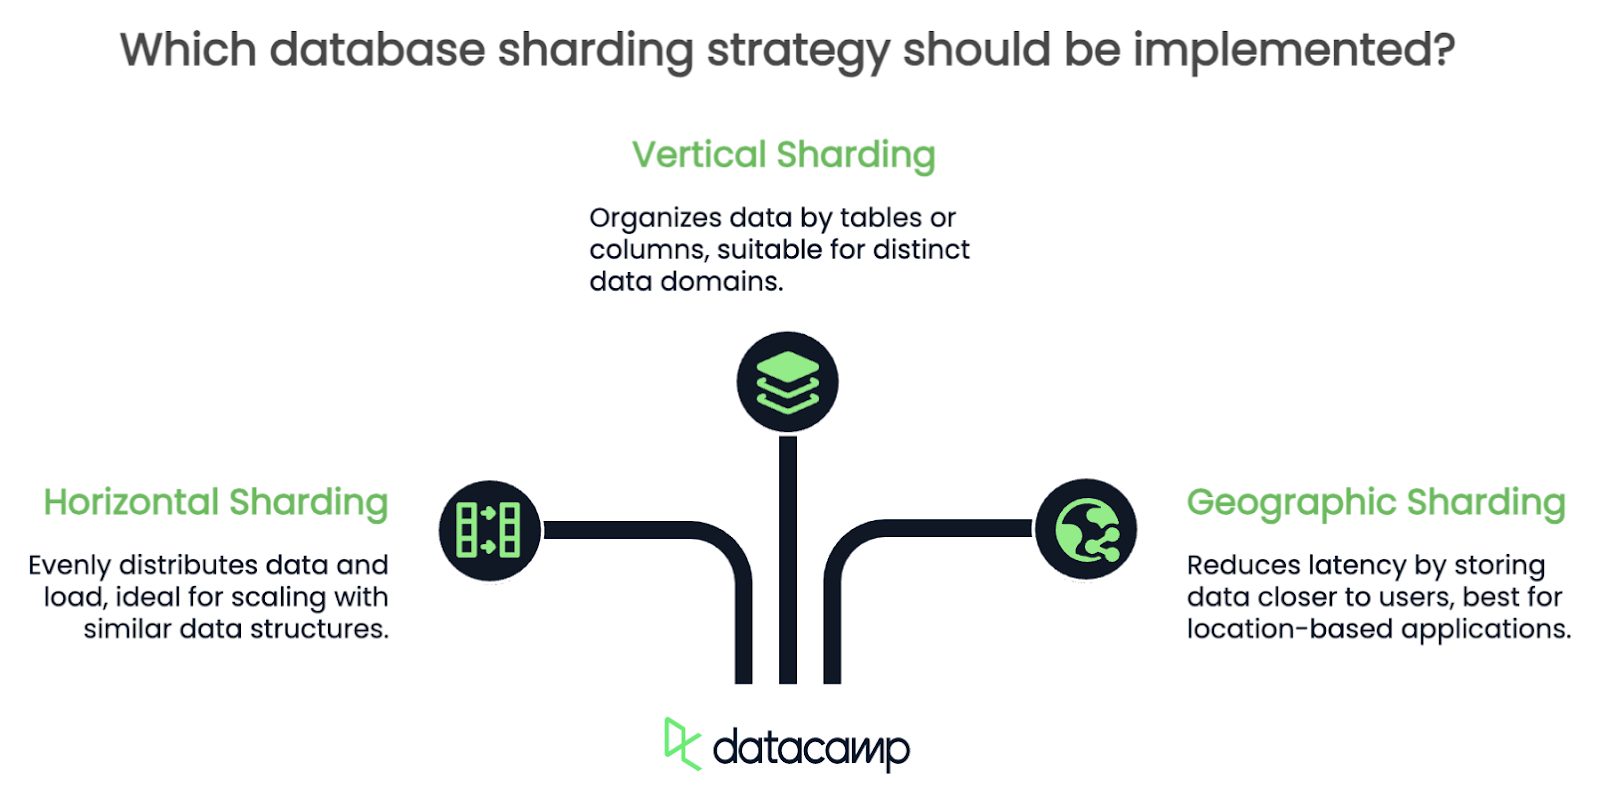
Lo sharding orizzontale suddivide le righe di una tabella su più shard. Ad esempio, se gestisci un database utenti, potresti suddividere gli utenti negli shard in base al loro ID: utenti 1-1000 in uno shard, 1001-2000 in un altro e così via.
Questo approccio è tra i più popolari perché distribuisce uniformemente dati e carico, rendendo più semplice scalare orizzontalmente man mano che l'applicazione cresce. È particolarmente efficace quando le tue tabelle hanno molte righe con strutture simili.
Quando usi lo sharding orizzontale, devi fare molta attenzione nella scelta della logica di partizionamento. Dati distribuiti male significano carichi di lavoro drasticamente non uniformi, e alcuni shard saranno sovraccarichi mentre altri resteranno inattivi.
Nello sharding verticale, suddividi il database per tabelle o colonne. Per esempio, potresti mettere i profili utente in uno shard, i dati delle transazioni in un altro e i log in un terzo. Ogni shard è sostanzialmente responsabile di uno specifico sottoinsieme di dati.
Questa strategia funziona bene quando l'applicazione ha domini di dati chiari e distinti che interagiscono poco, ma c'è una cosa a cui prestare attenzione: le query cross-shard. Se la tua applicazione deve spesso combinare dati provenienti da shard diversi, lo sharding verticale può in realtà creare più colli di bottiglia di quanti ne avessi all'inizio!
Lo sharding geografico organizza i dati in base alla posizione dell'utente. Ad esempio, tutti i dati degli utenti europei potrebbero risiedere in uno shard, mentre i dati nordamericani in un altro. Questa strategia riduce la latenza assicurando che i dati degli utenti siano memorizzati più vicino al luogo da cui vi accedono.
Tuttavia, lo sharding geografico comporta sfide proprie. Dovrai gestire con attenzione gli utenti che viaggiano tra regioni o i cui dati si estendono su più località. Mantenere i dati consistenti tra gli shard può diventare complicato.
A volte, combinare più strategie può essere la soluzione migliore, ad esempio usando lo sharding orizzontale all'interno di shard geografici. La chiave è bilanciare semplicità, scalabilità e performance. Dovrai mantenere il database dopo aver creato questi shard, quindi rendi la vita facile al tuo te futuro!
Non devi partire da zero e implementare lo sharding tutto da solo. Ci sono molti strumenti e framework che semplificano lo sharding e offrono funzionalità integrate per gestire la complessità al posto tuo.
ProxySQL funge da livello di proxy intelligente e gestisce l'instradamento delle query e il bilanciamento del carico per database MySQL shardati. Mantiene una mappatura di quale shard contiene quali dati e, quando arriva una query, la instrada automaticamente allo shard appropriato così che la tua applicazione non debba gestire la logica.
Io non ho mai lavorato direttamente con ProxySQL, ma un mio amico ha raccontato che la sua capacità di gestire l'instradamento delle query gli ha fatto risparmiare ore di configurazione manuale!
MongoDB ha il supporto integrato per lo sharding, il che lo rende un'opzione popolare per gestire grandi dataset non strutturati. MongoDB usa una chiave di sharding per determinare come i documenti vengono distribuiti tra gli shard, quindi va scelta con attenzione. Una scelta sbagliata può portare a distribuzione non uniforme dei dati e problemi di performance!
MongoDB poi si occupa del resto: partizionamento, bilanciamento dei dati e instradamento delle query in automatico.
Citus è un'ottima opzione per chi preferisce i database relazionali. Citus è sostanzialmente un'estensione che trasforma PostgreSQL in un database distribuito.
Ho lavorato in un team che ha usato Citus per scalare un'applicazione SaaS e ci ha permesso di mantenere la robustezza di PostgreSQL e delle tabelle strutturate, gestendo al contempo enormi quantità di dati.
Citus usa un query planner distribuito per gestire query complesse tra shard, ed è particolarmente utile per applicazioni ricche di analytics in cui devi combinare dati da più shard. La curva di apprendimento è stata più ripida rispetto allo sharding integrato di MongoDB, ma i risultati sono valsi la pena!
Spero che questa guida ti abbia dato gli strumenti per esplorare lo sharding nei tuoi sistemi (o la sicurezza per dire che non è la soluzione giusta per te in questo momento!). Ricorda, non è una soluzione valida per tutti, ma se usato con criterio è uno strumento potente per creare architetture scalabili ed efficienti.
E da persona che queste lezioni le ha imparate sulla propria pelle, il mio consiglio è: non aspettare che il tuo database sia in ginocchio per iniziare a pensare allo sharding. Pianifica in anticipo, sperimenta e adatta! Il tuo te futuro (e i tuoi utenti) ti ringrazieranno.
Impara il data engineering con questi corsi!
Corso
Programma
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min




