Tôi làm kỹ sư full-stack được vài năm thì nhận dự án kỹ thuật dữ liệu đầu tiên. Trước đó, tôi lập trình frontend, phát triển API, và quản lý, triển khai hạ tầng đám mây khá thường xuyên.
Như nhiều kỹ sư ở startup giai đoạn đầu, tôi cũng đụng đến cơ sở dữ liệu, thiết kế vài bảng hay schema, và di chuyển một lượng dữ liệu nhỏ. Nhưng rồi công ty tôi bắt đầu thu thập lượng dữ liệu khổng lồ, và hiệu năng của cơ sở dữ liệu giảm dần.
Ứng dụng chậm lại, độ trễ tăng, thậm chí còn bị downtime trong giờ cao điểm. Đó là vấn đề cực kỳ khó chịu mà đội tôi đã nỗ lực khắc phục. Khi ấy, tôi học được rất nhiều về cơ sở dữ liệu, cách chúng vận hành và cách tối ưu.
Trong bài blog này, tôi sẽ giải thích một khái niệm đã tạo ra khác biệt khi đó và còn nhiều lần sau này: database sharding.
Sharding Cơ Sở Dữ Liệu Là Gì?
Sharding cơ sở dữ liệu là việc tách một cơ sở dữ liệu thành các tập con nhỏ hơn, gọi là shard, mỗi shard hoạt động như một cơ sở dữ liệu độc lập. Hãy tưởng tượng bạn chia một bảng tính khổng lồ thành nhiều bảng nhỏ, dễ quản lý hơn, mỗi bảng đảm nhận một phần khối lượng công việc.
Tại sao và khi nào nên shard cơ sở dữ liệu?
Sharding KHÔNG phải là lời giải cho mọi vấn đề của cơ sở dữ liệu.
Có các phương pháp mở rộng ngang khác như sao chép (replication) hoặc mở rộng dọc, dễ triển khai hơn nhiều. Hãy xem xét những phương án này trước khi lao vào sharding!
Sharding phát huy tác dụng khi cơ sở dữ liệu bắt đầu chật vật trước nhu cầu của ứng dụng đang tăng trưởng. Có thể số người dùng bùng nổ, hoặc ứng dụng tạo ra lượng dữ liệu khổng lồ mỗi giây. Nếu bạn thấy truy vấn chậm, độ trễ tăng, hoặc downtime thường xuyên trong giờ cao điểm, rất có thể cơ sở dữ liệu đã chạm ngưỡng.
Một lý do lớn cho sharding là khả năng mở rộng. Khi dữ liệu tăng, bổ sung phần cứng cho một máy chủ cơ sở dữ liệu đơn (mở rộng dọc) chỉ giúp được đến mức nào đó, lại rất tốn kém. Ngược lại, sharding cho phép mở rộng ngang bằng cách phân phối dữ liệu lên nhiều máy chủ, mỗi máy xử lý một phần tải.
Một lý do khác là hiệu năng. Dù cơ sở dữ liệu có thể chứa được khối lượng dữ liệu, việc truy vấn qua lượng thông tin khổng lồ cũng tốn thời gian. Với sharding, bạn làm việc với các tập dữ liệu nhỏ, tập trung hơn, giúp truy vấn nhanh hơn và giảm tranh chấp tài nguyên.
Về thời điểm sharding, thường nên cân nhắc khi ứng dụng bắt đầu vượt quá khả năng của một cơ sở dữ liệu đơn. Thời điểm chính xác tùy vào nhiều biến số như nguồn lực và dự báo tăng trưởng. Triển khai sharding quá sớm sẽ tăng độ phức tạp không cần thiết khi một cơ sở dữ liệu đơn hoặc vài tối ưu đơn giản là đủ; chờ quá lâu thì việc chuyển đổi sẽ rất đau đầu.
Một nguyên tắc hay là theo dõi sát các chỉ số hiệu năng cơ sở dữ liệu và lập kế hoạch trước. Nếu bạn thấy nút thắt cổ chai hoặc dữ liệu tăng nhanh có thể gây vấn đề sớm, có lẽ đã đến lúc khám phá sharding. Tin tôi đi, đi trước vấn đề sẽ giúp bạn đỡ đau đầu về sau!
Sharding so với Phân vùng (Partitioning)
Thoạt nhìn, sharding và phân vùng có vẻ giống nhau vì đều chia dữ liệu thành các phần nhỏ hơn để tổ chức và tối ưu hiệu năng. Nhưng chúng phục vụ mục đích khác nhau và phù hợp với các quy mô vận hành khác nhau.
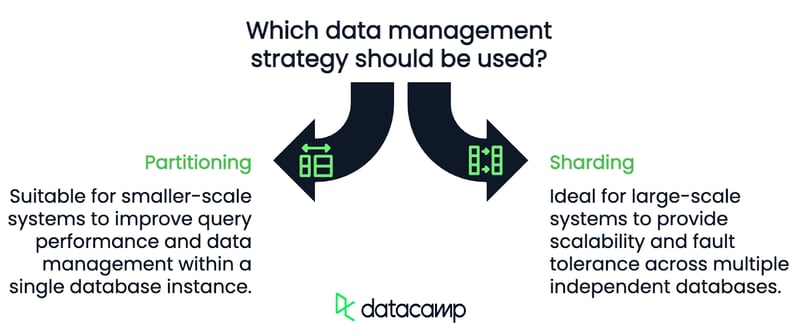
Phân vùng là chia dữ liệu thành các phân đoạn logic trong cùng một phiên bản cơ sở dữ liệu. Các phân đoạn này, thường gọi là partition, có thể dựa trên tiêu chí như khoảng (range), danh sách (list), hoặc băm (hash). Ví dụ, trong cơ sở dữ liệu người dùng, bạn có thể lưu người sinh tháng 1 vào một partition, tháng 2 vào partition khác, tất cả trong cùng cơ sở dữ liệu.
Phân vùng là lựa chọn tuyệt vời cho hệ thống quy mô nhỏ chưa cần mở rộng ngang. Nó cải thiện hiệu năng truy vấn bằng cách giới hạn lượng dữ liệu cần quét và giúp quản lý dữ liệu hiệu quả hơn.
Sharding, ngược lại, đưa phân vùng lên cấp độ cao hơn bằng cách phân phối các phân đoạn logic này lên nhiều cơ sở dữ liệu độc lập. Mỗi shard là một cơ sở dữ liệu độc lập, xử lý dữ liệu và truy vấn của chính nó.
Cách tiếp cận này lý tưởng cho hệ thống quy mô lớn nơi một cơ sở dữ liệu đơn không còn chịu tải nổi. Sharding mang lại cả khả năng mở rộng và khả năng chịu lỗi vì mỗi shard hoạt động độc lập.
Theo kinh nghiệm của tôi, phân vùng thường là bước đệm trước sharding. Nếu bạn bắt đầu thấy vấn đề hiệu năng nhưng cơ sở dữ liệu chưa tới ngưỡng, phân vùng có thể “mua thời gian” trong khi bạn chuẩn bị cho giải pháp quy mô lớn hơn như sharding.
Nếu bạn hứng thú với thiết kế cơ sở dữ liệu, hãy xem khóa học thiết kế cơ sở dữ liệu đầy đủ này. Bạn sẽ học cách tổ chức, quản lý, tối ưu cơ sở dữ liệu SQL, và cách thiết lập các kiểu phân vùng khác nhau.
Sharding so với Sao chép (Replication)
Tương tự trên, sharding và sao chép thường được bàn song song, nhưng chúng giải quyết các vấn đề khác nhau và có tình huống sử dụng riêng.
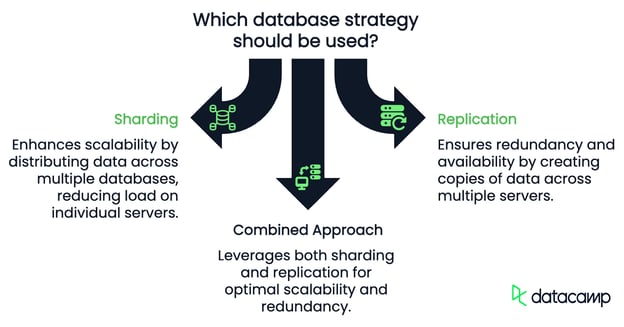
Mục tiêu chính của sharding là khả năng mở rộng. Bằng cách chia dữ liệu và tải công việc lên nhiều cơ sở dữ liệu, bạn giảm tải cho từng cơ sở dữ liệu đơn. Khi dữ liệu tăng, bạn có thể thêm shard để đáp ứng, duy trì hiệu năng và giảm rủi ro quá tải một cơ sở dữ liệu duy nhất.
Sao chép, ngược lại, là tạo các bản sao của cùng dữ liệu trên nhiều máy chủ. Mỗi bản sao chứa toàn bộ tập dữ liệu và có thể xử lý tác vụ đọc độc lập, nghĩa là sao chép tập trung vào dư thừa và tính sẵn sàng hơn là mở rộng.
Có nhiều bản sao giúp bạn chống mất dữ liệu và giữ hệ thống trực tuyến ngay cả khi một máy chủ gặp sự cố, nhưng nó không giải quyết vấn đề dữ liệu tăng trưởng. Thực tế, vì mỗi bản sao lưu toàn bộ dữ liệu, nhu cầu lưu trữ tăng theo số lượng bản sao. Thêm vào đó, thao tác ghi có thể trở thành nút thắt vì phải áp dụng cho tất cả bản sao để giữ dữ liệu nhất quán.
Thực tế thì không nhất thiết phải chọn một trong hai. Nhiều hệ thống quy mô lớn dùng cả sharding và sao chép. Ví dụ, một cơ sở dữ liệu sharded có thể có các bản sao cho từng shard.
Sharding Cơ Sở Dữ Liệu Hoạt Động Thế Nào?
Vậy cụ thể sharding hoạt động ra sao? Hãy chia thành ba thành phần chính.
Logic phân vùng
Bước đầu tiên là xác định cách chia dữ liệu. Logic phân vùng là bộ quy tắc quyết định dữ liệu được phân bổ vào các shard như thế nào. Có một số cách phổ biến:
- Phân vùng theo khoảng (range-based): Chia dữ liệu theo khoảng giá trị, như ID người dùng hoặc dấu thời gian. Ví dụ, người dùng có ID 1–1000 vào một shard, 1001–2000 vào shard khác. Cách này đơn giản nhưng có thể gây phân bổ không đều nếu dữ liệu không trải đều.
- Phân vùng theo băm (hash-based): Gán dữ liệu vào shard dựa trên kết quả của một hàm băm. Cách này phân phối dữ liệu khá đều nhưng việc cân bằng lại sẽ phức tạp khi cần thêm hoặc bớt shard.
- Phân vùng theo địa lý: Chia dữ liệu theo vị trí của người dùng, chẳng hạn gán người dùng châu Âu vào một shard, Bắc Mỹ vào shard khác. Cách này hữu ích để giảm độ trễ cho ứng dụng dựa trên vị trí.
Lựa chọn logic phân vùng phụ thuộc vào dữ liệu và nhu cầu ứng dụng. Tôi từng thấy phân vùng theo khoảng hoạt động tốt với dữ liệu theo thời gian, như lịch sử giao dịch, trong khi theo băm phù hợp hơn với hệ thống có tải công việc khó đoán.
Ánh xạ shard
Sau khi phân vùng dữ liệu, bạn cần cách ánh xạ mỗi phân vùng tới shard tương ứng.
Một số hệ thống dùng ánh xạ tĩnh, nơi dữ liệu được gán vào shard dựa trên quy tắc cố định. Số khác dùng ánh xạ động, thường do một dịch vụ siêu dữ liệu trung tâm quản lý, giúp dễ thêm hoặc bớt shard khi cần. Dù theo cách nào, mục tiêu là đảm bảo hệ thống biết chính xác nơi chứa mỗi mẩu dữ liệu.
Định tuyến truy vấn
Cuối cùng, bạn cần cơ chế đảm bảo truy vấn được gửi tới đúng shard. Đây là định tuyến truy vấn, rất quan trọng để sharding vận hành cho ứng dụng của bạn. Khi ứng dụng gửi truy vấn, logic định tuyến sẽ xác định shard (hoặc các shard) chứa dữ liệu liên quan và gửi yêu cầu đến đó.
Đôi khi, đơn giản là bản thân ứng dụng biết gửi truy vấn đi đâu dựa trên logic phân vùng. Ở các thiết lập khác, một lớp proxy hoặc middleware xử lý định tuyến, che giấu độ phức tạp khỏi ứng dụng. Tôi từng dùng cả hai cách; proxy có thêm overhead, nhưng ở hệ thống lớn, chúng tiết kiệm cho bạn rất nhiều công sức.
Chiến Lược Sharding Cơ Sở Dữ Liệu
Không có một cách tiếp cận duy nhất cho sharding. Chiến lược bạn chọn phụ thuộc nhiều vào cấu trúc dữ liệu và cách sử dụng. Tôi sẽ điểm qua vài cách phổ biến nhất, nhưng còn nhiều hơn ba.
Sharding ngang
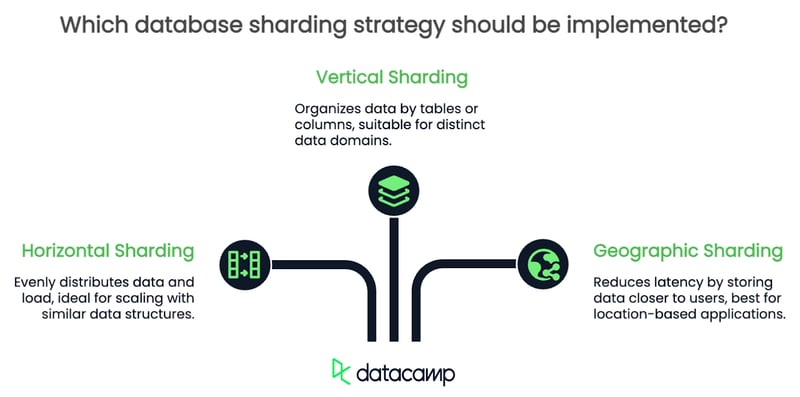
Sharding ngang chia các hàng của một bảng lên nhiều shard. Ví dụ, với cơ sở dữ liệu người dùng, bạn có thể chia theo ID: người dùng 1–1000 ở một shard, 1001–2000 ở shard khác, v.v.
Cách này rất phổ biến vì phân phối dữ liệu và tải tương đối đều, giúp mở rộng ngang dễ dàng khi ứng dụng tăng trưởng. Đặc biệt hiệu quả khi bảng có nhiều hàng với cấu trúc tương tự.
Khi dùng sharding ngang, bạn phải cực kỳ cẩn trọng khi chọn logic phân vùng. Phân phối dữ liệu kém dẫn tới tải việc rất lệch, một số shard quá tải trong khi shard khác nhàn rỗi.
Sharding dọc
Với sharding dọc, bạn chia cơ sở dữ liệu theo bảng hoặc cột. Chẳng hạn, đưa hồ sơ người dùng vào một shard, dữ liệu giao dịch vào shard khác, nhật ký vào shard thứ ba. Mỗi shard chịu trách nhiệm cho một tập dữ liệu cụ thể.
Chiến lược này phù hợp khi ứng dụng có các miền dữ liệu tách bạch, ít tương tác. Tuy nhiên, hãy cẩn trọng với truy vấn xuyên shard. Nếu ứng dụng thường xuyên cần kết hợp dữ liệu từ nhiều shard, sharding dọc có thể tạo thêm nút thắt hiệu năng so với ban đầu!
Sharding theo địa lý
Sharding theo địa lý tổ chức dữ liệu theo vị trí người dùng. Ví dụ, toàn bộ dữ liệu người dùng châu Âu nằm ở một shard, Bắc Mỹ ở shard khác. Chiến lược này giảm độ trễ bằng cách lưu dữ liệu gần nơi người dùng truy cập hơn.
Tuy nhiên, sharding theo địa lý có các thách thức riêng. Bạn cần xử lý cẩn thận người dùng di chuyển giữa các vùng hoặc có dữ liệu trải rộng nhiều vị trí. Giữ dữ liệu nhất quán giữa các shard cũng có thể phức tạp.
Đôi khi, kết hợp nhiều chiến lược là tốt nhất — ví dụ, dùng sharding ngang trong từng shard địa lý. Mấu chốt là cân bằng giữa đơn giản, khả năng mở rộng và hiệu năng. Bạn sẽ phải bảo trì cơ sở dữ liệu sau khi tạo các shard, nên hãy làm cho “bản thân tương lai” của bạn dễ thở!
Công Cụ và Framework cho Sharding Cơ Sở Dữ Liệu
Bạn không cần bắt đầu từ con số 0 và tự triển khai sharding. Có nhiều công cụ và framework giúp sharding dễ hơn và cung cấp tính năng tích hợp để xử lý độ phức tạp cho bạn.
MySQL với ProxySQL
ProxySQL hoạt động như một lớp proxy thông minh, xử lý định tuyến truy vấn và cân bằng tải cho cơ sở dữ liệu MySQL đã sharding. Nó duy trì ánh xạ shard nào chứa dữ liệu gì và khi có truy vấn đến, sẽ tự động định tuyến tới shard phù hợp để ứng dụng của bạn không phải tự xử lý logic.
Tôi chưa từng dùng ProxySQL trực tiếp, nhưng một người bạn xác nhận khả năng định tuyến truy vấn của nó đã giúp anh ấy tiết kiệm hàng giờ cấu hình thủ công!
MongoDB
MongoDB có hỗ trợ sharding tích hợp, nên rất phổ biến khi xử lý dữ liệu phi cấu trúc lớn. MongoDB dùng khóa sharding để xác định cách phân phối tài liệu qua các shard, nên bạn cần chọn thật cẩn thận. Chọn sai có thể dẫn đến phân phối dữ liệu không đều và vấn đề hiệu năng!
Phần còn lại MongoDB sẽ lo: phân vùng, cân bằng dữ liệu và định tuyến truy vấn tự động.
PostgreSQL với Citus
Citus là lựa chọn tuyệt vời cho ai ưa cơ sở dữ liệu quan hệ. Về cơ bản, Citus là một extension biến PostgreSQL thành một cơ sở dữ liệu phân tán.
Tôi từng làm trong một đội dùng Citus để mở rộng một ứng dụng SaaS, và nó cho phép chúng tôi giữ được độ bền vững của PostgreSQL và các bảng có cấu trúc trong khi xử lý lượng dữ liệu khổng lồ.
Citus dùng bộ lập kế hoạch truy vấn phân tán để xử lý truy vấn phức tạp trên nhiều shard, đặc biệt hữu ích cho ứng dụng thiên về phân tích, nơi bạn cần kết hợp dữ liệu từ nhiều shard. Đường cong học tập dốc hơn so với sharding tích hợp của MongoDB, nhưng kết quả rất xứng đáng!
Kết luận
Hy vọng hướng dẫn này giúp bạn có công cụ để khám phá sharding trong hệ thống của riêng mình (hoặc đủ tự tin để nói rằng hiện giờ nó chưa phù hợp!). Hãy nhớ, đây không phải giải pháp “một cỡ cho tất cả”, nhưng nếu dùng đúng chỗ, nó là công cụ mạnh mẽ để xây dựng kiến trúc mở rộng và hiệu quả.
Và với tư cách người đã học những bài học này theo cách khó khăn, lời khuyên của tôi là: đừng đợi đến khi cơ sở dữ liệu “quỵ ngã” mới nghĩ về sharding. Hãy lên kế hoạch trước, thử nghiệm và thích nghi! Bản thân bạn trong tương lai (và người dùng của bạn) sẽ biết ơn.


Tôi làm kỹ sư full-stack được vài năm thì nhận dự án kỹ thuật dữ liệu đầu tiên. Trước đó, tôi lập trình frontend, phát triển API, và quản lý, triển khai hạ tầng đám mây khá thường xuyên.
Như nhiều kỹ sư ở startup giai đoạn đầu, tôi cũng đụng đến cơ sở dữ liệu, thiết kế vài bảng hay schema, và di chuyển một lượng dữ liệu nhỏ. Nhưng rồi công ty tôi bắt đầu thu thập lượng dữ liệu khổng lồ, và hiệu năng của cơ sở dữ liệu giảm dần.
Ứng dụng chậm lại, độ trễ tăng, thậm chí còn bị downtime trong giờ cao điểm. Đó là vấn đề cực kỳ khó chịu mà đội tôi đã nỗ lực khắc phục. Khi ấy, tôi học được rất nhiều về cơ sở dữ liệu, cách chúng vận hành và cách tối ưu.
Trong bài blog này, tôi sẽ giải thích một khái niệm đã tạo ra khác biệt khi đó và còn nhiều lần sau này: database sharding.
Sharding Cơ Sở Dữ Liệu Là Gì?
Sharding cơ sở dữ liệu là việc tách một cơ sở dữ liệu thành các tập con nhỏ hơn, gọi là shard, mỗi shard hoạt động như một cơ sở dữ liệu độc lập. Hãy tưởng tượng bạn chia một bảng tính khổng lồ thành nhiều bảng nhỏ, dễ quản lý hơn, mỗi bảng đảm nhận một phần khối lượng công việc.
Tại sao và khi nào nên shard cơ sở dữ liệu?
Sharding KHÔNG phải là lời giải cho mọi vấn đề của cơ sở dữ liệu.
Có các phương pháp mở rộng ngang khác như sao chép (replication) hoặc mở rộng dọc, dễ triển khai hơn nhiều. Hãy xem xét những phương án này trước khi lao vào sharding!
Sharding phát huy tác dụng khi cơ sở dữ liệu bắt đầu chật vật trước nhu cầu của ứng dụng đang tăng trưởng. Có thể số người dùng bùng nổ, hoặc ứng dụng tạo ra lượng dữ liệu khổng lồ mỗi giây. Nếu bạn thấy truy vấn chậm, độ trễ tăng, hoặc downtime thường xuyên trong giờ cao điểm, rất có thể cơ sở dữ liệu đã chạm ngưỡng.
Một lý do lớn cho sharding là khả năng mở rộng. Khi dữ liệu tăng, bổ sung phần cứng cho một máy chủ cơ sở dữ liệu đơn (mở rộng dọc) chỉ giúp được đến mức nào đó, lại rất tốn kém. Ngược lại, sharding cho phép mở rộng ngang bằng cách phân phối dữ liệu lên nhiều máy chủ, mỗi máy xử lý một phần tải.
Một lý do khác là hiệu năng. Dù cơ sở dữ liệu có thể chứa được khối lượng dữ liệu, việc truy vấn qua lượng thông tin khổng lồ cũng tốn thời gian. Với sharding, bạn làm việc với các tập dữ liệu nhỏ, tập trung hơn, giúp truy vấn nhanh hơn và giảm tranh chấp tài nguyên.
Về thời điểm sharding, thường nên cân nhắc khi ứng dụng bắt đầu vượt quá khả năng của một cơ sở dữ liệu đơn. Thời điểm chính xác tùy vào nhiều biến số như nguồn lực và dự báo tăng trưởng. Triển khai sharding quá sớm sẽ tăng độ phức tạp không cần thiết khi một cơ sở dữ liệu đơn hoặc vài tối ưu đơn giản là đủ; chờ quá lâu thì việc chuyển đổi sẽ rất đau đầu.
Một nguyên tắc hay là theo dõi sát các chỉ số hiệu năng cơ sở dữ liệu và lập kế hoạch trước. Nếu bạn thấy nút thắt cổ chai hoặc dữ liệu tăng nhanh có thể gây vấn đề sớm, có lẽ đã đến lúc khám phá sharding. Tin tôi đi, đi trước vấn đề sẽ giúp bạn đỡ đau đầu về sau!
Sharding so với Phân vùng (Partitioning)
Thoạt nhìn, sharding và phân vùng có vẻ giống nhau vì đều chia dữ liệu thành các phần nhỏ hơn để tổ chức và tối ưu hiệu năng. Nhưng chúng phục vụ mục đích khác nhau và phù hợp với các quy mô vận hành khác nhau.
Phân vùng là chia dữ liệu thành các phân đoạn logic trong cùng một phiên bản cơ sở dữ liệu. Các phân đoạn này, thường gọi là partition, có thể dựa trên tiêu chí như khoảng (range), danh sách (list), hoặc băm (hash). Ví dụ, trong cơ sở dữ liệu người dùng, bạn có thể lưu người sinh tháng 1 vào một partition, tháng 2 vào partition khác, tất cả trong cùng cơ sở dữ liệu.
Phân vùng là lựa chọn tuyệt vời cho hệ thống quy mô nhỏ chưa cần mở rộng ngang. Nó cải thiện hiệu năng truy vấn bằng cách giới hạn lượng dữ liệu cần quét và giúp quản lý dữ liệu hiệu quả hơn.
Sharding, ngược lại, đưa phân vùng lên cấp độ cao hơn bằng cách phân phối các phân đoạn logic này lên nhiều cơ sở dữ liệu độc lập. Mỗi shard là một cơ sở dữ liệu độc lập, xử lý dữ liệu và truy vấn của chính nó.
Cách tiếp cận này lý tưởng cho hệ thống quy mô lớn nơi một cơ sở dữ liệu đơn không còn chịu tải nổi. Sharding mang lại cả khả năng mở rộng và khả năng chịu lỗi vì mỗi shard hoạt động độc lập.
Theo kinh nghiệm của tôi, phân vùng thường là bước đệm trước sharding. Nếu bạn bắt đầu thấy vấn đề hiệu năng nhưng cơ sở dữ liệu chưa tới ngưỡng, phân vùng có thể “mua thời gian” trong khi bạn chuẩn bị cho giải pháp quy mô lớn hơn như sharding.
Nếu bạn hứng thú với thiết kế cơ sở dữ liệu, hãy xem khóa học thiết kế cơ sở dữ liệu đầy đủ này. Bạn sẽ học cách tổ chức, quản lý, tối ưu cơ sở dữ liệu SQL, và cách thiết lập các kiểu phân vùng khác nhau.
Sharding so với Sao chép (Replication)
Tương tự trên, sharding và sao chép thường được bàn song song, nhưng chúng giải quyết các vấn đề khác nhau và có tình huống sử dụng riêng.
Mục tiêu chính của sharding là khả năng mở rộng. Bằng cách chia dữ liệu và tải công việc lên nhiều cơ sở dữ liệu, bạn giảm tải cho từng cơ sở dữ liệu đơn. Khi dữ liệu tăng, bạn có thể thêm shard để đáp ứng, duy trì hiệu năng và giảm rủi ro quá tải một cơ sở dữ liệu duy nhất.
Sao chép, ngược lại, là tạo các bản sao của cùng dữ liệu trên nhiều máy chủ. Mỗi bản sao chứa toàn bộ tập dữ liệu và có thể xử lý tác vụ đọc độc lập, nghĩa là sao chép tập trung vào dư thừa và tính sẵn sàng hơn là mở rộng.
Có nhiều bản sao giúp bạn chống mất dữ liệu và giữ hệ thống trực tuyến ngay cả khi một máy chủ gặp sự cố, nhưng nó không giải quyết vấn đề dữ liệu tăng trưởng. Thực tế, vì mỗi bản sao lưu toàn bộ dữ liệu, nhu cầu lưu trữ tăng theo số lượng bản sao. Thêm vào đó, thao tác ghi có thể trở thành nút thắt vì phải áp dụng cho tất cả bản sao để giữ dữ liệu nhất quán.
Thực tế thì không nhất thiết phải chọn một trong hai. Nhiều hệ thống quy mô lớn dùng cả sharding và sao chép. Ví dụ, một cơ sở dữ liệu sharded có thể có các bản sao cho từng shard.
Sharding Cơ Sở Dữ Liệu Hoạt Động Thế Nào?
Vậy cụ thể sharding hoạt động ra sao? Hãy chia thành ba thành phần chính.
Logic phân vùng
Bước đầu tiên là xác định cách chia dữ liệu. Logic phân vùng là bộ quy tắc quyết định dữ liệu được phân bổ vào các shard như thế nào. Có một số cách phổ biến:
Lựa chọn logic phân vùng phụ thuộc vào dữ liệu và nhu cầu ứng dụng. Tôi từng thấy phân vùng theo khoảng hoạt động tốt với dữ liệu theo thời gian, như lịch sử giao dịch, trong khi theo băm phù hợp hơn với hệ thống có tải công việc khó đoán.
Ánh xạ shard
Sau khi phân vùng dữ liệu, bạn cần cách ánh xạ mỗi phân vùng tới shard tương ứng.
Một số hệ thống dùng ánh xạ tĩnh, nơi dữ liệu được gán vào shard dựa trên quy tắc cố định. Số khác dùng ánh xạ động, thường do một dịch vụ siêu dữ liệu trung tâm quản lý, giúp dễ thêm hoặc bớt shard khi cần. Dù theo cách nào, mục tiêu là đảm bảo hệ thống biết chính xác nơi chứa mỗi mẩu dữ liệu.
Định tuyến truy vấn
Cuối cùng, bạn cần cơ chế đảm bảo truy vấn được gửi tới đúng shard. Đây là định tuyến truy vấn, rất quan trọng để sharding vận hành cho ứng dụng của bạn. Khi ứng dụng gửi truy vấn, logic định tuyến sẽ xác định shard (hoặc các shard) chứa dữ liệu liên quan và gửi yêu cầu đến đó.
Đôi khi, đơn giản là bản thân ứng dụng biết gửi truy vấn đi đâu dựa trên logic phân vùng. Ở các thiết lập khác, một lớp proxy hoặc middleware xử lý định tuyến, che giấu độ phức tạp khỏi ứng dụng. Tôi từng dùng cả hai cách; proxy có thêm overhead, nhưng ở hệ thống lớn, chúng tiết kiệm cho bạn rất nhiều công sức.
Chiến Lược Sharding Cơ Sở Dữ Liệu
Không có một cách tiếp cận duy nhất cho sharding. Chiến lược bạn chọn phụ thuộc nhiều vào cấu trúc dữ liệu và cách sử dụng. Tôi sẽ điểm qua vài cách phổ biến nhất, nhưng còn nhiều hơn ba.
Sharding ngang
Sharding ngang chia các hàng của một bảng lên nhiều shard. Ví dụ, với cơ sở dữ liệu người dùng, bạn có thể chia theo ID: người dùng 1–1000 ở một shard, 1001–2000 ở shard khác, v.v.
Cách này rất phổ biến vì phân phối dữ liệu và tải tương đối đều, giúp mở rộng ngang dễ dàng khi ứng dụng tăng trưởng. Đặc biệt hiệu quả khi bảng có nhiều hàng với cấu trúc tương tự.
Khi dùng sharding ngang, bạn phải cực kỳ cẩn trọng khi chọn logic phân vùng. Phân phối dữ liệu kém dẫn tới tải việc rất lệch, một số shard quá tải trong khi shard khác nhàn rỗi.
Sharding dọc
Với sharding dọc, bạn chia cơ sở dữ liệu theo bảng hoặc cột. Chẳng hạn, đưa hồ sơ người dùng vào một shard, dữ liệu giao dịch vào shard khác, nhật ký vào shard thứ ba. Mỗi shard chịu trách nhiệm cho một tập dữ liệu cụ thể.
Chiến lược này phù hợp khi ứng dụng có các miền dữ liệu tách bạch, ít tương tác. Tuy nhiên, hãy cẩn trọng với truy vấn xuyên shard. Nếu ứng dụng thường xuyên cần kết hợp dữ liệu từ nhiều shard, sharding dọc có thể tạo thêm nút thắt hiệu năng so với ban đầu!
Sharding theo địa lý
Sharding theo địa lý tổ chức dữ liệu theo vị trí người dùng. Ví dụ, toàn bộ dữ liệu người dùng châu Âu nằm ở một shard, Bắc Mỹ ở shard khác. Chiến lược này giảm độ trễ bằng cách lưu dữ liệu gần nơi người dùng truy cập hơn.
Tuy nhiên, sharding theo địa lý có các thách thức riêng. Bạn cần xử lý cẩn thận người dùng di chuyển giữa các vùng hoặc có dữ liệu trải rộng nhiều vị trí. Giữ dữ liệu nhất quán giữa các shard cũng có thể phức tạp.
Đôi khi, kết hợp nhiều chiến lược là tốt nhất — ví dụ, dùng sharding ngang trong từng shard địa lý. Mấu chốt là cân bằng giữa đơn giản, khả năng mở rộng và hiệu năng. Bạn sẽ phải bảo trì cơ sở dữ liệu sau khi tạo các shard, nên hãy làm cho “bản thân tương lai” của bạn dễ thở!
Công Cụ và Framework cho Sharding Cơ Sở Dữ Liệu
Bạn không cần bắt đầu từ con số 0 và tự triển khai sharding. Có nhiều công cụ và framework giúp sharding dễ hơn và cung cấp tính năng tích hợp để xử lý độ phức tạp cho bạn.
MySQL với ProxySQL
ProxySQL hoạt động như một lớp proxy thông minh, xử lý định tuyến truy vấn và cân bằng tải cho cơ sở dữ liệu MySQL đã sharding. Nó duy trì ánh xạ shard nào chứa dữ liệu gì và khi có truy vấn đến, sẽ tự động định tuyến tới shard phù hợp để ứng dụng của bạn không phải tự xử lý logic.
Tôi chưa từng dùng ProxySQL trực tiếp, nhưng một người bạn xác nhận khả năng định tuyến truy vấn của nó đã giúp anh ấy tiết kiệm hàng giờ cấu hình thủ công!
MongoDB
MongoDB có hỗ trợ sharding tích hợp, nên rất phổ biến khi xử lý dữ liệu phi cấu trúc lớn. MongoDB dùng khóa sharding để xác định cách phân phối tài liệu qua các shard, nên bạn cần chọn thật cẩn thận. Chọn sai có thể dẫn đến phân phối dữ liệu không đều và vấn đề hiệu năng!
Phần còn lại MongoDB sẽ lo: phân vùng, cân bằng dữ liệu và định tuyến truy vấn tự động.
PostgreSQL với Citus
Citus là lựa chọn tuyệt vời cho ai ưa cơ sở dữ liệu quan hệ. Về cơ bản, Citus là một extension biến PostgreSQL thành một cơ sở dữ liệu phân tán.
Tôi từng làm trong một đội dùng Citus để mở rộng một ứng dụng SaaS, và nó cho phép chúng tôi giữ được độ bền vững của PostgreSQL và các bảng có cấu trúc trong khi xử lý lượng dữ liệu khổng lồ.
Citus dùng bộ lập kế hoạch truy vấn phân tán để xử lý truy vấn phức tạp trên nhiều shard, đặc biệt hữu ích cho ứng dụng thiên về phân tích, nơi bạn cần kết hợp dữ liệu từ nhiều shard. Đường cong học tập dốc hơn so với sharding tích hợp của MongoDB, nhưng kết quả rất xứng đáng!
Kết luận
Hy vọng hướng dẫn này giúp bạn có công cụ để khám phá sharding trong hệ thống của riêng mình (hoặc đủ tự tin để nói rằng hiện giờ nó chưa phù hợp!). Hãy nhớ, đây không phải giải pháp “một cỡ cho tất cả”, nhưng nếu dùng đúng chỗ, nó là công cụ mạnh mẽ để xây dựng kiến trúc mở rộng và hiệu quả.
Và với tư cách người đã học những bài học này theo cách khó khăn, lời khuyên của tôi là: đừng đợi đến khi cơ sở dữ liệu “quỵ ngã” mới nghĩ về sharding. Hãy lên kế hoạch trước, thử nghiệm và thích nghi! Bản thân bạn trong tương lai (và người dùng của bạn) sẽ biết ơn.