
{count, plural, one {कोर्स} other {कोर्स}}
डेटाबेस डिज़ाइन
{hours} घंटा
131.1K
मैं कुछ वर्षों से फुल-स्टैक इंजीनियर था, जब मुझे अपना पहला डेटा इंजीनियरिंग प्रोजेक्ट सौंपा गया। उस समय तक मैं फ्रंटएंड पर कोड करता, APIs विकसित करता, और क्लाउड इंफ्रास्ट्रक्चर को नियमित रूप से प्रबंधित व डिप्लॉय करता आया था।
शुरुआती चरण के स्टार्टअप्स में कई इंजीनियरों की तरह, मैंने डेटाबेस के साथ भी काम किया था—कहीं-कहीं नई टेबल या स्कीमा डिज़ाइन करना और थोड़े-बहुत डेटा माइग्रेट करना। लेकिन फिर, जिस कंपनी में मैं काम करता था उसने बहुत बड़े पैमाने पर डेटा इकट्ठा करना शुरू किया, और डेटाबेस का प्रदर्शन गिरने लगा।
हमारे एप्लिकेशन सुस्त होने लगे, लेटेंसी बढ़ रही थी, और पीक लोड के दौरान हमें डाउनटाइम भी झेलना पड़ रहा था। यह एक बेहद निराशाजनक समस्या थी, जिसे ठीक करने के लिए मेरी टीम ने कड़ी मेहनत की। तभी मुझे डेटाबेस, उनके काम करने के तरीके और उन्हें ऑप्टिमाइज़ करने के बारे में बहुत कुछ सीखने को मिला।
इस ब्लॉग में, मैं उन अवधारणाओं में से एक समझाऊंगा, जिसने तब वास्तविक फर्क डाला था—और पिछले कुछ वर्षों में कई बार किया है: डेटाबेस शार्डिंग।
डेटाबेस शार्डिंग एक डेटाबेस को छोटे-छोटे सबसेट्स, या शार्ड्स में बाँटने की प्रक्रिया है, जहाँ प्रत्येक शार्ड अपना स्वतंत्र डेटाबेस की तरह काम करता है। इसे ऐसे समझें जैसे एक विशाल स्प्रेडशीट को कई छोटी, अधिक प्रबंधनीय शीट्स में बाँट देना, जिनमें से प्रत्येक अपना हिस्सा संभालती है।
शार्डिंग हर डेटाबेस समस्या का हल नहीं है।
अन्य हॉरिजॉन्टल स्केलिंग तरीके, जैसे रेप्लिकेशन, या वर्टिकल स्केलिंग तरीके, लागू करना कहीं आसान होते हैं। शार्डिंग पर कूदने से पहले इन्हें ज़रूर देखें!
शार्डिंग तब काम आती है जब आपका डेटाबेस बढ़ते एप्लिकेशन की मांगों के साथ तालमेल बिठाने में जूझने लगता है। शायद आपके उपयोगकर्ताओं की संख्या उछाल पर है, या एप्लिकेशन हर सेकंड बड़े पैमाने पर डेटा जनरेट कर रहा है। अगर आपको धीमी क्वेरीज़, बढ़ती लेटेंसी, या पीक ट्रैफिक के दौरान बार-बार डाउनटाइम दिख रहा है, तो संभवतः आपका डेटाबेस अपनी सीमा छू रहा है।
शार्डिंग का एक बड़ा कारण स्केलेबिलिटी है। जैसे-जैसे आपका डेटा बढ़ता है, एक ही डेटाबेस सर्वर में अधिक हार्डवेयर जोड़ना (वर्टिकल स्केलिंग) एक सीमा तक ही मदद करता है—और यह बहुत महंगा भी हो सकता है। दूसरी ओर, शार्डिंग आपको डेटा को कई सर्वर्स में वितरित करके हॉरिजॉन्टली स्केल करने देती है, जहाँ हर सर्वर लोड का एक हिस्सा संभालता है।
शार्डिंग चुनने का एक और कारण प्रदर्शन है। भले ही आपका डेटाबेस डेटा वॉल्यूम संभाल ले, बहुत बड़े डेटा पर क्वेरी करना समय ले सकता है। शार्डिंग से आप छोटे, अधिक केंद्रित डेटासेट्स पर काम करते हैं, जिससे क्वेरी तेज़ होती हैं और संसाधनों पर टकराव कम होता है।
जहाँ तक शार्ड करने के समय की बात है, आम तौर पर तब सोचना बेहतर होता है जब आपका एप्लिकेशन एकल डेटाबेस की क्षमता से बड़ा होने लगता है। सही समय कई कारकों—आपके संसाधनों और अनुमानित वृद्धि—पर निर्भर करता है और संतुलन साधने जैसा है। बहुत जल्दी शार्डिंग लागू करने से अनावश्यक जटिलता आ सकती है जब एकल डेटाबेस या साधारण ऑप्टिमाइज़ेशन काफी होते, जबकि बहुत देर करने से ट्रांज़िशन दर्दनाक हो सकता है।
एक अच्छा नियम यह है कि अपने डेटाबेस के प्रदर्शन मेट्रिक्स पर क़रीबी नज़र रखें और पहले से योजना बनाएं। यदि आपको बॉटलनेक्स दिख रहे हैं या तेज़ी से बढ़ता डेटा निकट भविष्य में समस्या पैदा कर सकता है, तो संभवतः शार्डिंग तलाशने का समय आ गया है। मुझ पर भरोसा करें—समस्या से आगे रहना आगे चलकर बहुत सिरदर्द बचा देगा!
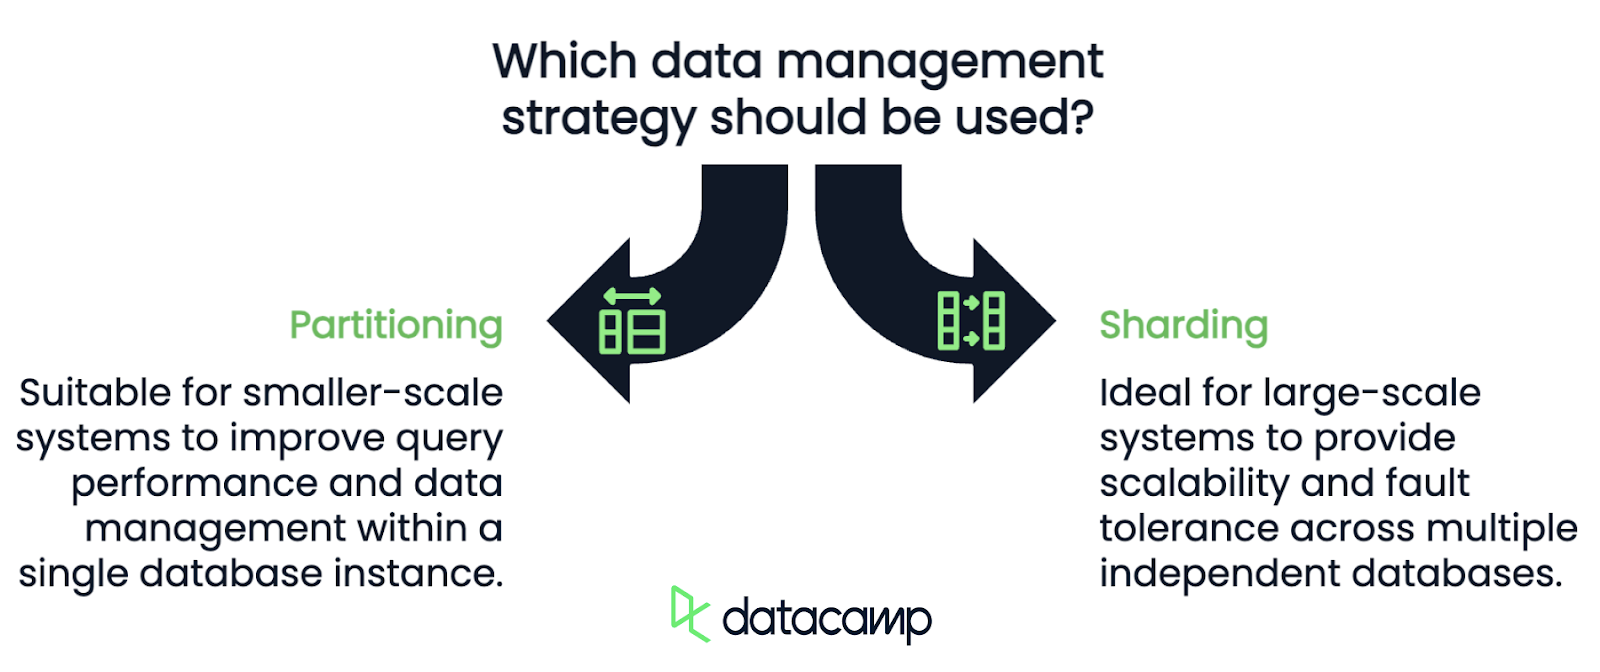
पहली नज़र में, शार्डिंग और पार्टिशनिंग एक जैसे लग सकते हैं क्योंकि दोनों ही बेहतर संगठन और प्रदर्शन के लिए डेटा को छोटे हिस्सों में बाँटते हैं। लेकिन इनके उद्देश्य अलग हैं और ये अलग पैमानों पर उपयुक्त होते हैं।
पार्टिशनिंग उसी डेटाबेस इंस्टेंस के भीतर डेटा को तार्किक सेगमेंट्स में विभाजित करने की प्रक्रिया है। इन सेगमेंट्स को अक्सर पार्टिशन कहा जाता है और ये रेंज, लिस्ट या हैश जैसी कसौटियों पर आधारित हो सकते हैं। उदाहरण के लिए, एक यूज़र डेटाबेस में, आप जनवरी में जन्मे यूज़र्स को एक पार्टिशन में और फरवरी वालों को दूसरे में रख सकते हैं—सभी एक ही डेटाबेस के भीतर।
पार्टिशनिंग उन छोटे पैमाने के सिस्टम्स के लिए उत्कृष्ट है जिन्हें अभी हॉरिजॉन्टल स्केल करने की ज़रूरत नहीं है। यह क्वेरी के दौरान स्कैन किए जाने वाले डेटा को सीमित करके क्वेरी प्रदर्शन में सुधार करती है और डेटा प्रबंधन को अधिक कुशल बनाती है।
दूसरी ओर, शार्डिंग इन तार्किक सेगमेंट्स को कई स्वतंत्र डेटाबेसों में वितरित करके पार्टिशनिंग को अगले स्तर पर ले जाती है। हर शार्ड एक स्टैंडअलोन डेटाबेस है जो अपना डेटा और क्वेरीज़ खुद संभालता है।
यह तरीका बड़े पैमाने के सिस्टम्स के लिए आदर्श है, जहाँ एकल डेटाबेस अब लोड नहीं संभाल सकता। चूँकि हर शार्ड स्वतंत्र रूप से काम करता है, शार्डिंग स्केलेबिलिटी और फॉल्ट-टॉलरेंस दोनों देती है।
मेरे अनुभव में, पार्टिशनिंग अक्सर शार्डिंग तक पहुँचने का एक चरण होता है। यदि आपको प्रदर्शन संबंधी समस्याएँ दिखने लगी हैं लेकिन आपका डेटाबेस अभी अपनी सीमा पर नहीं पहुँचा, तो पार्टिशनिंग आपको समय दिला सकती है, जबकि आप शार्डिंग जैसी बड़े पैमाने की व्यवस्था की तैयारी करें।
यदि आप डेटाबेस डिज़ाइन में रुचि रखते हैं, तो इस पूर्ण डेटाबेस डिज़ाइन कोर्स पर नज़र डालें। आप जानेंगे कि SQL डेटाबेस को कैसे व्यवस्थित, प्रबंधित और ऑप्टिमाइज़ किया जाए, और अलग-अलग प्रकार की पार्टिशनिंग कैसे सेटअप की जाए।
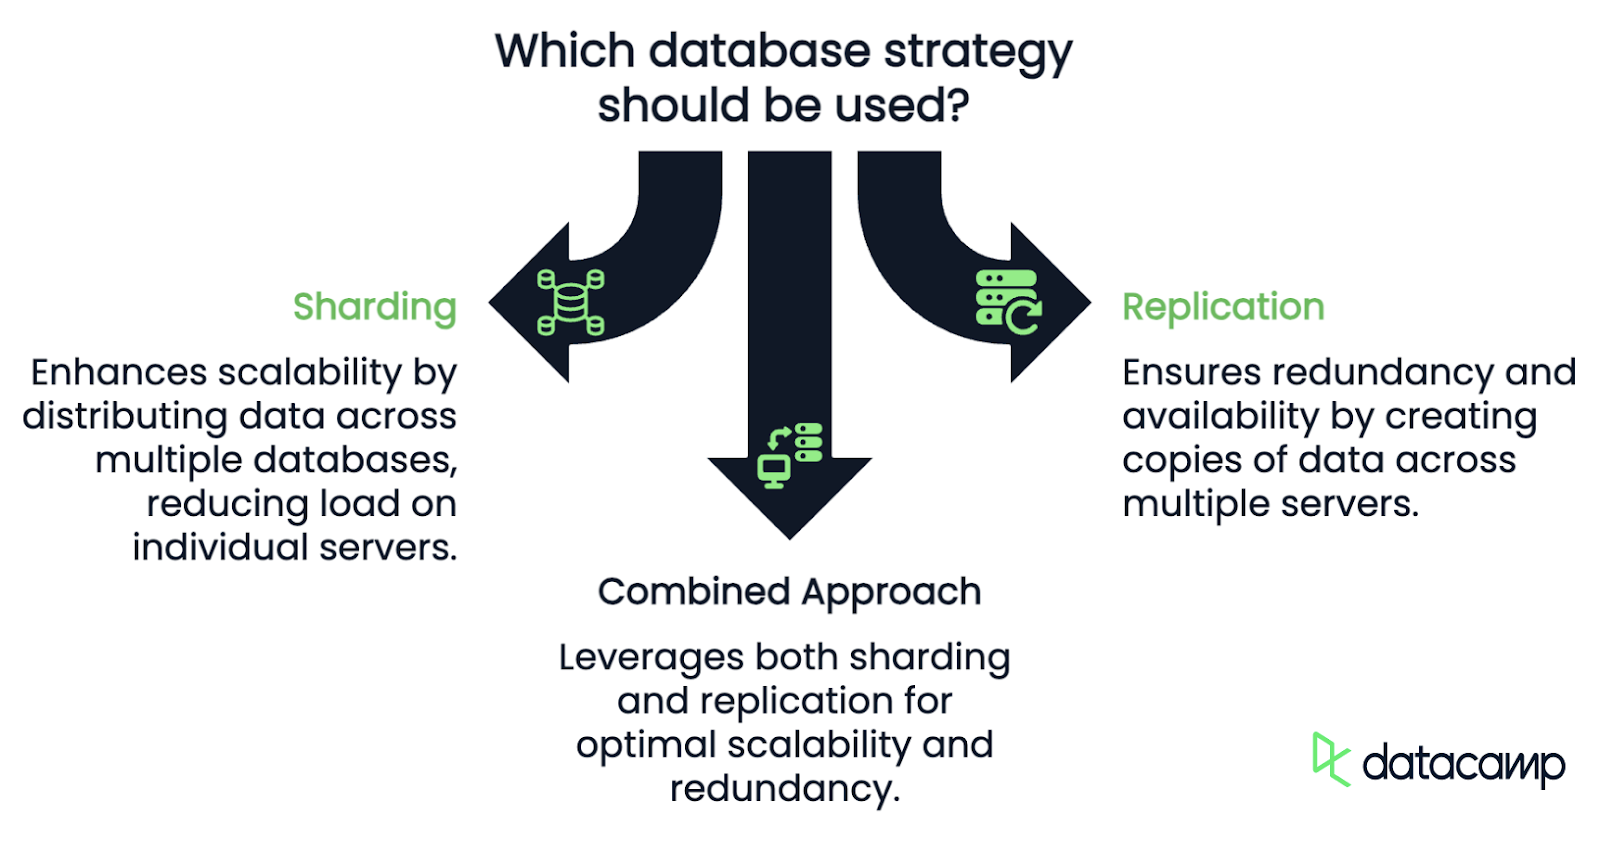
इसी तरह, शार्डिंग और रेप्लिकेशन को अक्सर साथ में चर्चा की जाती है, लेकिन ये अलग समस्याएँ हल करते हैं और इनके उपयोग के मामले अलग होते हैं।
शार्डिंग का प्राथमिक लक्ष्य स्केलेबिलिटी है। डेटा और वर्कलोड को कई डेटाबेसों में बाँटकर, आप किसी एक डेटाबेस पर लोड कम कर देते हैं। जैसे-जैसे आपका डेटा बढ़ता है, शार्डिंग यह सुनिश्चित करती है कि आप प्रदर्शन बनाए रखते हुए अधिक शार्ड्स जोड़ सकें और किसी एक डेटाबेस के ओवरलोड होने का जोखिम कम करें।
दूसरी ओर, रेप्लिकेशन में एक ही डेटा की प्रतियाँ कई सर्वर्स पर बनाना शामिल है। हर रेप्लिका में पूरा डेटासेट होता है और वह स्वतंत्र रूप से रीड ऑपरेशंस संभाल सकता है—इसका फोकस स्केलेबिलिटी नहीं बल्कि रेडंडेंसी और उपलब्धता है।
कई प्रतियों के होने से आप डेटा लॉस से बचते हैं और यह सुनिश्चित करते हैं कि कोई सर्वर डाउन होने पर भी सिस्टम ऑनलाइन रहे, लेकिन यह बढ़ते डेटा वॉल्यूम की समस्या नहीं सुलझाता। वास्तव में, चूँकि हर रेप्लिका पूरा डेटासेट संग्रहीत करता है, रेप्लिकाओं की संख्या के साथ स्टोरेज आवश्यकताएँ समानुपाती रूप से बढ़ती हैं। इसके अलावा, राइट ऑपरेशंस बॉटलनेक बन सकते हैं, क्योंकि डेटा सुसंगत रखने के लिए उन्हें सभी रेप्लिकाओं पर लागू करना होता है।
बात यह है कि यह जरूरी नहीं कि एक या दूसरा ही हो। व्यवहार में, कई बड़े पैमाने के सिस्टम शार्डिंग और रेप्लिकेशन दोनों साथ में उपयोग करते हैं। उदाहरण के लिए, एक शार्डेड डेटाबेस में प्रत्येक शार्ड के रेप्लिका भी हो सकते हैं।
तो, शार्डिंग वास्तव में कैसे काम करती है? आइए इसे तीन प्रमुख घटकों में तोड़ते हैं।
शार्डिंग का पहला कदम यह तय करना है कि डेटा को कैसे बाँटना है। आपका पार्टिशनिंग लॉजिक उन नियमों का सेट है जो निर्धारित करता है कि डेटा शार्ड्स में कैसे विभाजित होगा। इसे करने के कुछ आम तरीके हैं:
पार्टिशनिंग लॉजिक का चुनाव आपके डेटा और एप्लिकेशन की ज़रूरतों पर निर्भर करता है। मैंने व्यक्तिगत रूप से समय-क्रमबद्ध डेटा, जैसे ट्रांज़ैक्शन हिस्ट्री, के लिए रेंज-आधारित पार्टिशनिंग को अच्छा काम करते देखा है, जबकि अप्रत्याशित वर्कलोड वाले सिस्टम्स में हैश-आधारित तरीके बेहतर रहे हैं।
एक बार डेटा पार्टिशन हो जाए, तो हर पार्टिशन को उसके संबंधित शार्ड से मैप करने का तरीका चाहिए।
कुछ सिस्टम्स स्टैटिक मैपिंग का उपयोग करते हैं, जहाँ डेटा तय नियमों के आधार पर शार्ड्स को सौंपा जाता है। अन्य डायनेमिक मैपिंग का उपयोग करते हैं, जिसे अक्सर एक सेंट्रल मेटाडेटा सर्विस मैनेज करती है—इससे ज़रूरत पड़ने पर शार्ड्स जोड़ना या हटाना आसान हो जाता है। किसी भी तरह, लक्ष्य यह सुनिश्चित करना है कि आपका सिस्टम ठीक-ठीक जानता हो कि कोई भी विशिष्ट डेटा कहाँ मिलेगा।
अंततः, आपको ऐसा मैकेनिज़्म चाहिए जो सुनिश्चित करे कि क्वेरी सही शार्ड तक पहुँचे। इसे क्वेरी रूटिंग कहते हैं, और यह शार्डिंग को आपके एप्लिकेशन के लिए कारगर बनाने में अहम है। जब कोई एप्लिकेशन क्वेरी भेजता है, तो रूटिंग लॉजिक तय करता है कि कौन सा शार्ड (या कौन-कौन से शार्ड) सम्बंधित डेटा रखते हैं और अनुरोध वहीं भेजता है।
कई मामलों में, यह इतना सरल हो सकता है कि एप्लिकेशन खुद पार्टिशनिंग लॉजिक के आधार पर जानता हो कि किस क्वेरी को कहाँ भेजना है। अन्य सेटअप्स में, कोई प्रॉक्सी या मिडलवेयर लेयर रूटिंग संभालती है और एप्लिकेशन से जटिलता दूर रखती है। मैंने दोनों तरीकों के साथ काम किया है—प्रॉक्सी कुछ ओवरहेड जोड़ती हैं, लेकिन बड़े सिस्टम्स में यह आपके बहुत से प्रयास बचा सकती हैं।
शार्डिंग का कोई एकमात्र तरीका नहीं है। आपकी चुनी हुई रणनीति आपके डेटा की संरचना और उसके उपयोग पर निर्भर करती है। मैं कुछ सबसे आम तरीकों पर जाऊँगा, लेकिन तीन से कहीं अधिक विकल्प मौजूद हैं।
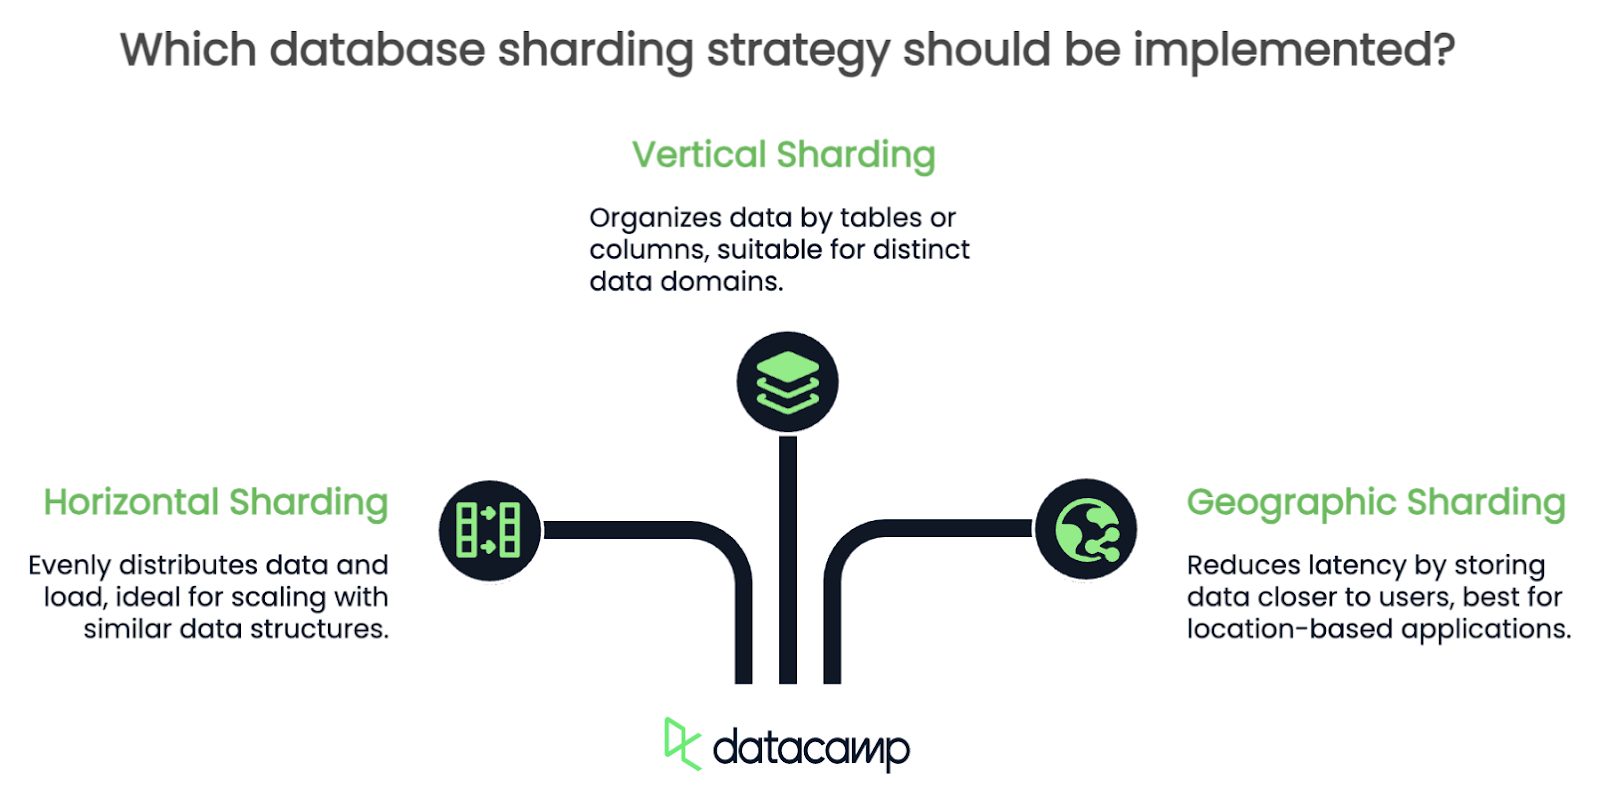
हॉरिजॉन्टल शार्डिंग में किसी टेबल की पंक्तियाँ कई शार्ड्स में बाँटी जाती हैं। उदाहरण के लिए, यदि आप यूज़र डेटाबेस मैनेज कर रहे हैं, तो आप यूज़र्स को उनकी ID के आधार पर शार्ड्स में बाँट सकते हैं: यूज़र 1–1000 एक शार्ड में, 1001–2000 दूसरे में, इत्यादि।
यह तरीका सबसे लोकप्रिय में से एक है क्योंकि यह डेटा और लोड को समान रूप से वितरित करता है, जिससे आपके एप्लिकेशन के बढ़ने पर हॉरिजॉन्टली स्केल करना आसान हो जाता है। जब आपकी टेबल्स में समान संरचना वाली बहुत सारी पंक्तियाँ हों, तब यह विशेष रूप से प्रभावी है।
हॉरिजॉन्टल शार्डिंग का उपयोग करते समय, पार्टिशनिंग लॉजिक चुनते वक्त बहुत सावधानी जरूरी है। खराब वितरित डेटा का मतलब है बहुत असमान वर्कलोड—कुछ शार्ड्स पर ओवरलोड होगा जबकि अन्य खाली बैठे रहेंगे।
वर्टिकल शार्डिंग में, आप डेटाबेस को टेबल्स या कॉलम्स के आधार पर बाँटते हैं। उदाहरण के लिए, यूज़र प्रोफ़ाइल्स को एक शार्ड में, ट्रांज़ैक्शन डेटा को दूसरे में और लॉग्स को तीसरे में रखा जा सकता है। हर शार्ड मूलतः किसी विशिष्ट डेटा सबसेट के लिए जिम्मेदार होता है।
यह रणनीति तब अच्छी तरह काम करती है जब आपके एप्लिकेशन में स्पष्ट, अलग-अलग डेटा डोमेन्स हों जो आपस में अधिक इंटरैक्ट न करते हों। लेकिन एक चीज़ पर ध्यान दें—क्रॉस-शार्ड क्वेरीज़। यदि आपके एप्लिकेशन को अक्सर अलग-अलग शार्ड्स से डेटा मिलाना पड़ता है, तो वर्टिकल शार्डिंग शुरुआती स्थिति से भी अधिक परफॉर्मेंस बॉटलनेक्स पैदा कर सकती है!
भौगोलिक शार्डिंग उपयोगकर्ता के लोकेशन के आधार पर डेटा को व्यवस्थित करती है। उदाहरण के लिए, सभी यूरोपीय उपयोगकर्ताओं का डेटा एक शार्ड में हो सकता है, जबकि उत्तरी अमेरिकी डेटा दूसरे में। यह रणनीति उपयोगकर्ताओं का डेटा उनके पास ही संग्रहीत करके लेटेंसी कम करती है।
हालाँकि, भौगोलिक शार्डिंग अपनी चुनौतियों के साथ आती है। आपको उन उपयोगकर्ताओं को सावधानी से संभालना होगा जो क्षेत्रों के बीच यात्रा करते हैं या जिनका डेटा कई लोकेशनों में फैला है। शार्ड्स के बीच डेटा सुसंगत रखना भी पेचीदा हो सकता है।
कभी-कभी, कई रणनीतियों को मिलाना सबसे अच्छा समाधान होता है—जैसे भौगोलिक शार्ड्स के भीतर हॉरिजॉन्टल शार्डिंग का उपयोग करना। कुंजी है सादगी, स्केलेबिलिटी और प्रदर्शन के बीच संतुलन। इन शार्ड्स को बनाने के बाद आपको अपने डेटाबेस को बनाए रखना होगा, इसलिए अपने भविष्य के लिए इसे आसान बनाएँ!
आपको शून्य से शुरू करके खुद ही शार्डिंग लागू करने की ज़रूरत नहीं है। कई टूल्स और फ्रेमवर्क्स उपलब्ध हैं जो शार्डिंग को आसान बनाते हैं और जटिलता को संभालने के लिए बिल्ट-इन फ़ीचर्स देते हैं।
ProxySQL एक स्मार्ट प्रॉक्सी लेयर की तरह काम करता है और शार्डेड MySQL डेटाबेसों के लिए क्वेरी रूटिंग और लोड बैलेंसिंग संभालता है। यह कौन सा शार्ड कौन सा डेटा रखता है, इसकी मैपिंग बनाए रखता है और क्वेरी आते ही उसे उपयुक्त शार्ड पर स्वतः रूट कर देता है, ताकि आपका एप्लिकेशन यह लॉजिक न संभाले।
मैंने स्वयं ProxySQL के साथ काम नहीं किया है, लेकिन मेरे एक मित्र ने बताया कि इसकी क्वेरी रूटिंग संभालने की क्षमता ने उन्हें घंटों की मैन्युअल कॉन्फ़िगरेशन से बचा लिया!
MongoDB में बिल्ट-इन शार्डिंग सपोर्ट है, जो बड़े असंरचित डेटासेट्स को संभालने के लिए इसे लोकप्रिय विकल्प बनाता है। MongoDB शार्ड्स में डॉक्यूमेंट्स को कैसे वितरित किया जाए, यह तय करने के लिए शार्डिंग की का उपयोग करता है, इसलिए इसे बहुत सोच-समझकर चुनना चाहिए। गलत चुनाव असमान डेटा वितरण और प्रदर्शन समस्याओं का कारण बन सकता है!
इसके बाद MongoDB बाकी सब—पार्टिशनिंग, डेटा बैलेंसिंग और क्वेरी रूटिंग—ऑटोमैटिकली संभाल लेता है।
जो लोग रिलेशनल डेटाबेस पसंद करते हैं, उनके लिए Citus एक बेहतरीन विकल्प है। Citus मूलतः एक एक्सटेंशन है जो PostgreSQL को एक डिस्ट्रीब्यूटेड डेटाबेस में बदल देता है।
मैंने ऐसी टीम में काम किया है जिसने एक SaaS एप्लिकेशन को स्केल करने के लिए Citus का उपयोग किया, और इससे हमें PostgreSQL की मजबूती और स्ट्रक्चर्ड टेबल्स बरकरार रखते हुए विशाल डेटा संभालने में मदद मिली।
Citus एक डिस्ट्रीब्यूटेड क्वेरी प्लानर का उपयोग करता है जो शार्ड्स में फैली जटिल क्वेरीज़ को संभालता है, और यह विशेष रूप से उन एनालिटिक्स-हेवी एप्लिकेशनों के लिए उपयोगी है जहाँ आपको कई शार्ड्स से डेटा जोड़ना होता है। सीखने की कर्व MongoDB की बिल्ट-इन शार्डिंग से अधिक तीखी थी, लेकिन नतीजे इसके काबिल थे!
आशा है इस गाइड ने आपको अपने सिस्टम्स में शार्डिंग तलाशने के उपकरण दिए होंगे (या यह भरोसा कि अभी आपके लिए यह सही समाधान नहीं है!)। याद रखें, यह वन-साइज़-फिट्स-ऑल समाधान नहीं है, लेकिन सोच-समझकर उपयोग करने पर यह स्केलेबल और कुशल आर्किटेक्चर बनाने का एक शक्तिशाली साधन है।
और एक ऐसे व्यक्ति के रूप में जिसने ये सबक कठिन तरीक़े से सीखे, मेरी सलाह है: शार्डिंग के बारे में सोचने के लिए तब तक इंतज़ार न करें जब तक आपका डेटाबेस घुटनों पर न आ जाए। पहले से योजना बनाएँ, प्रयोग करें, और अनुकूलित हों! आपका भविष्य का स्वयं (और आपके उपयोगकर्ता) आपको धन्यवाद देंगे।
इन कोर्सेज़ के साथ डेटा इंजीनियरिंग सीखें!
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}