İlk veri mühendisliği projem bana verildiğinde birkaç yıldır full-stack mühendis olarak çalışıyordum. O zamana kadar düzenli olarak frontend tarafında kod yazmış, API’ler geliştirmiş ve bulut altyapısını yönetip dağıtmıştım.
Erken aşama girişimlerdeki birçok mühendis gibi ben de veritabanlarına dokunmuş, ara sıra yeni bir tablo veya şema tasarlamış ve küçük miktarlarda veriyi taşımıştım. Derken çalıştığım şirket büyük miktarlarda veri toplamaya başladı ve veritabanı performansı düşüşe geçti.
Uygulamalarımız yavaşlıyordu, gecikme artıyordu ve hatta tepe yüklerde kesinti yaşıyorduk. Ekip olarak çözmek için çok uğraştığımız, oldukça can sıkıcı bir sorundu. İşte o zaman veritabanları hakkında, nasıl çalıştıkları ve nasıl optimize edildikleri konusunda çok şey öğrendim.
Bu blogda, o dönemde gerçekten fark yaratan ve son birkaç yılda defalarca işime yarayan kavramlardan birini açıklayacağım: veritabanı sharding’i.
Veritabanı Sharding’i Nedir?
Veritabanı sharding’i, bir veritabanını daha küçük alt kümelere, yani shard’lara bölme uygulamasıdır; her shard kendi başına bağımsız bir veritabanı gibi çalışır. Bunu, dev bir hesap tablosunu iş yükünün payını üstlenen, daha küçük ve yönetilebilir birkaç tabloya bölmek gibi düşünebilirsiniz.
Bir veritabanı neden ve ne zaman shard edilir?
Sharding her veritabanı sorununun cevabı DEĞİLDİR.
Uygulaması çok daha kolay olan başka yatay ölçekleme yöntemleri (ör. çoğaltma) ya da dikey ölçekleme yöntemleri vardır. Sharding’e atlamadan önce bunlara mutlaka göz atın!
Sharding, veritabanınız büyüyen bir uygulamanın taleplerine ayak uydurmakta zorlanmaya başladığında devreye girer. Belki kullanıcı tabanınız patladı ya da uygulamanız her saniye devasa miktarda veri üretiyor. Yavaş sorgular, artan gecikme veya yoğun trafik sırasında sık kesinti fark ediyorsanız, veritabanınızın sınırlarına dayandığının işareti olabilir.
Sharding’in büyük bir nedeni ölçeklenebilirliktir. Veriniz büyüdükçe tek bir veritabanı sunucusuna daha fazla donanım eklemek (dikey ölçekleme) bir yere kadar işe yarar ve çok pahalı olabilir. Sharding ise verileri birden çok sunucu arasında dağıtarak yatayda ölçeklemenize imkân tanır; her sunucu yükün bir kısmını üstlenir.
Sharding tercih etmenin bir diğer nedeni performanstır. Veritabanınız veri hacmini kaldırsa bile, muazzam miktarda bilgi üzerinde sorgu çalıştırmak zaman alabilir. Sharding ile daha küçük ve odaklı veri kümeleriyle çalışırsınız; bu da daha hızlı sorgular ve kaynaklar için daha az çekişme demektir.
Ne zaman shard edileceğine gelince, genellikle uygulamanız tek bir veritabanının kaldırabileceğinin ötesine geçmeye başladığında bunu düşünmek en iyisidir. Tam zamanlama kaynaklarınıza ve öngörülen büyümeye göre değişir ve ince bir denge gerektirir. Sharding’i çok erken uygulamak, tek bir veritabanının ya da basit iyileştirmelerin yeterli olacağı durumda gereksiz karmaşıklık getirir; çok geç kalmak ise geçişi sancılı hâle getirebilir.
İyi bir kural, veritabanı performans metriklerinizi yakından izlemek ve önceden plan yapmaktır. Yakın gelecekte sorun yaratabilecek darboğazlar veya hızlı veri büyümesi görüyorsanız, muhtemelen sharding’i araştırmanın zamanı gelmiştir. Bana güvenin, sorunun önüne geçmek, ileride sizi büyük dertlerden kurtarır!
Veritabanı Sharding’i ve Bölümleme (Partitioning)
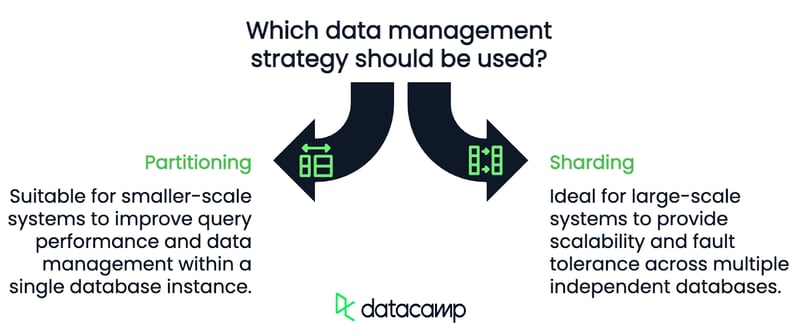
İlk bakışta sharding ve bölümleme benzer görünebilir; çünkü her ikisi de verileri daha iyi düzenleme ve performans için daha küçük parçalara ayırmayı içerir. Ancak amaçları farklıdır ve farklı ölçeklerdeki çalışmalara uygundurlar.
Bölümleme, verilerin aynı veritabanı örneği içinde mantıksal segmentlere ayrılmasıdır. Bu segmentler genellikle aralık, liste veya karma (hash) gibi ölçütlere dayanır. Örneğin, bir kullanıcı veritabanında ocak ayında doğan kullanıcıları bir bölümde, şubatta doğanları başka bir bölümde tutabilirsiniz; hepsi aynı veritabanında kalır.
Bölümleme, henüz yatay ölçeklemeye ihtiyaç duymayan daha küçük ölçekli sistemler için mükemmel bir seçimdir. Sorgular sırasında taranan veri miktarını sınırlayarak sorgu performansını iyileştirir ve veri yönetimini daha verimli kılar.
Sharding ise bu mantıksal segmentleri birden çok bağımsız veritabanına dağıtarak bölümlemeyi bir üst seviyeye taşır. Her shard, kendi verilerini ve sorgularını yöneten bağımsız bir veritabanıdır.
Bu yaklaşım, tek bir veritabanının artık yükü kaldıramadığı büyük ölçekli sistemler için idealdir. Sharding, her shard bağımsız çalıştığı için hem ölçeklenebilirlik hem de hata toleransı sağlar.
Deneyimlerime göre bölümleme, çoğu zaman sharding’e giden bir basamaktır. Performans sorunları görmeye başladıysanız ancak veritabanınız henüz tıkanmadıysa, bölümleme size zaman kazandırır; bu arada sharding gibi daha büyük ölçekli bir çözüme hazırlanabilirsiniz.
Veritabanı tasarımına ilgi duyuyorsanız, şu tam kapsamlı veritabanı tasarımı kursuna göz atın. SQL veritabanlarını nasıl düzenleyeceğinizi, yöneteceğinizi ve optimize edeceğinizi; hatta farklı türde bölümlemeleri nasıl kuracağınızı öğreneceksiniz.
Veritabanı Sharding’i ve Çoğaltma (Replication)
Benzer şekilde, sharding ve çoğaltma sık sık yan yana tartışılır; ancak farklı sorunları ele alırlar ve farklı kullanım alanları vardır.
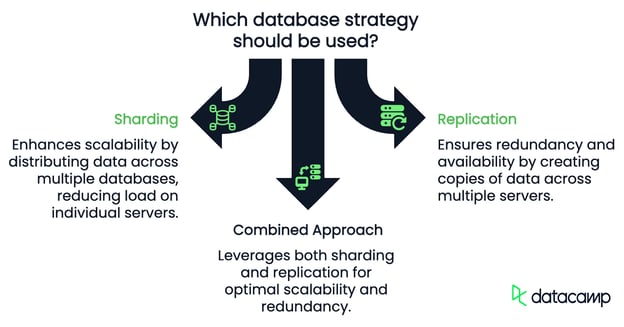
Sharding’in birincil amacı ölçeklenebilirliktir. Veriyi ve iş yükünü birden çok veritabanına bölerek tek bir veritabanındaki yükü azaltırsınız. Veriniz büyüdükçe daha fazla shard ekleyerek performansı koruyabilir ve tek bir veritabanını aşırı yükleme riskini azaltabilirsiniz.
Çoğaltma ise aynı verinin birden çok sunucuda kopyalarını oluşturmayı içerir. Her kopya tüm veri kümesini barındırır ve okuma işlemlerini bağımsız şekilde karşılayabilir; yani çoğaltma, ölçeklenebilirlikten ziyade yedeklilik ve erişilebilirliğe odaklanır.
Birden fazla veritabanı kopyasına sahip olarak veri kaybına karşı korunur ve bir sunucu devre dışı kalsa bile sisteminizi çevrimiçi tutarsınız; ancak bu, büyüyen veri hacmi sorununu çözmez. Hatta, her kopya tüm veri kümesini sakladığı için, kopya sayısıyla orantılı şekilde depolama gereksinimi artar. Üstüne üstlük, yazma işlemleri veri tutarlılığını korumak için tüm kopyalara uygulanmak zorunda olduğundan darboğaza dönüşebilir.
Mesele şu ki, bu ikisi birbirini dışlayan şeyler olmak zorunda değil. Pratikte, birçok büyük ölçekli sistem sharding ve çoğaltmayı birlikte kullanır. Örneğin, shard edilmiş bir veritabanında her shard’ın ayrıca kopyaları olabilir.
Veritabanı Sharding’i Nasıl Çalışır?
Peki sharding tam olarak nasıl çalışır? Bunu üç ana bileşene ayıralım.
Bölümleme mantığı
Sharding’de ilk adım, verinizi nasıl böleceğinizi belirlemektir. Bölümleme mantığı, verinin shard’lar arasında nasıl paylaştırılacağını belirleyen kural setidir. Bunu yapmanın birkaç yaygın yolu vardır:
- Aralık tabanlı bölümleme: Veriler, kullanıcı kimlikleri veya zaman damgaları gibi değer aralıklarına göre bölünür. Örneğin, kimliği 1-1000 olan kullanıcılar bir shard’a, 1001-2000 olanlar başka bir shard’a gider. Bu yaklaşım basittir ancak veriniz eşit dağılmamışsa dengesiz dağılıma yol açabilir.
- Karma (hash) tabanlı bölümleme: Veriler, bir karma fonksiyonunun çıktısına göre shard’lara atanır. Veriyi eşit dağıtmak için harikadır; ancak shard ekleyip çıkarmanız gerektiğinde yeniden dengeleme zorlaşabilir.
- Coğrafi bölümleme: Veriler, kullanıcının konumuna göre bölünür; örneğin tüm Avrupa kullanıcıları bir shard’a, Kuzey Amerika kullanıcıları başka bir shard’a atanır. Bu yaklaşım, konuma dayalı uygulamalarda gecikmeyi azaltmak için özellikle yararlıdır.
Bölümleme mantığının seçimi verilerinize ve uygulama ihtiyaçlarınıza bağlıdır. Kişisel olarak, işlem geçmişleri gibi kronolojik verilerde aralık tabanlı bölümlemenin iyi çalıştığını; öngörülemeyen iş yüklerine sahip sistemlerde ise karma tabanlı yöntemlerin daha iyi sonuç verdiğini gördüm.
Shard eşlemesi
Veriniz bölümledikten sonra, her bölümün karşılık gelen shard’a nasıl eşleneceğini belirlemeniz gerekir.
Bazı sistemler, verilerin sabit kurallara göre shard’lara atandığı statik eşleme kullanır. Diğerleri ise genellikle merkezi bir meta veri hizmeti tarafından yönetilen dinamik eşleme kullanır; bu da gerektiğinde shard eklemeyi veya çıkarmayı kolaylaştırır. Her iki durumda da amaç, sisteminizin herhangi bir veriyi tam olarak nerede bulacağını bilmesini sağlamaktır.
Sorgu yönlendirme
Son olarak, sorguların doğru shard’a gönderilmesini sağlayacak bir mekanizmaya ihtiyacınız var. Buna sorgu yönlendirme denir ve sharding’in uygulamanız için çalışmasını sağlamak açısından önemlidir. Uygulama bir sorgu gönderdiğinde, yönlendirme mantığı ilgili verileri hangi shard’ın (veya shard’ların) tuttuğunu belirler ve isteği oraya iletir.
Bazı durumlarda bu, uygulamanın bölümleme mantığına göre her sorguyu nereye göndereceğini bilmesi kadar basit olabilir. Diğer kurulumlarda, bir proxy veya ara katman yönlendirmeyi üstlenir ve karmaşıklığı uygulamadan soyutlar. Her iki yaklaşımı da kullandım; proxy’ler biraz ek yük getirse de büyük sistemlerde size ciddi emek tasarrufu sağlayabilirler.
Veritabanı Sharding Stratejileri
Sharding için tek bir yaklaşım yoktur. Seçeceğiniz strateji büyük ölçüde verinizin yapısına ve onu nasıl kullandığınıza bağlıdır. En yaygın olanlardan bazılarını ele alacağım; ama üçten çok daha fazlası vardır.
Yatay sharding
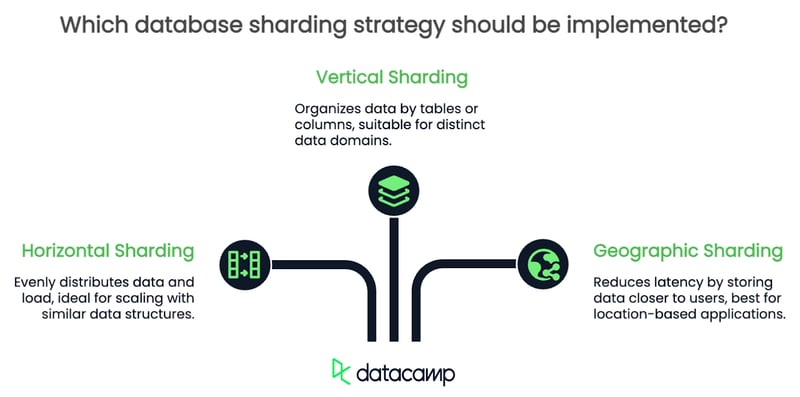
Yatay sharding, bir tablonun satırlarını birden çok shard arasında böler. Örneğin, bir kullanıcı veritabanı yönetiyorsanız, kullanıcıları kimliklerine göre shard’lara ayırabilirsiniz: 1-1000 bir shard’da, 1001-2000 başka bir shard’da, vb.
Bu yaklaşım, veriyi ve yükü eşit dağıttığı için en popüler olanlardan biridir; uygulamanız büyüdükçe yatayda ölçekleme yapmayı kolaylaştırır. Özellikle benzer yapıda çok sayıda satıra sahip tablolarınız olduğunda etkilidir.
Yatay sharding kullanırken bölümleme mantığınızı seçerken çok dikkatli olmanız gerekir. Kötü dağıtılmış veri, ciddi derecede dengesiz iş yükleri demektir; bazı shard’lar aşırı yüklenirken diğerleri boşta kalır.
Dikey sharding
Dikey sharding’de veritabanınızı tablolara veya sütunlara göre bölersiniz. Örneğin, kullanıcı profillerini bir shard’a, işlem verilerini başka birine, günlükleri (log) üçüncüsüne koyabilirsiniz. Her shard, özünde belirli bir veri alt kümesinden sorumludur.
Bu strateji, uygulamanızın çok fazla etkileşimi olmayan, net ve ayrı veri alanlarına sahip olduğu durumlarda işe yarar; ancak dikkat edilmesi gereken nokta shard’lar arası sorgulardır. Uygulamanız sık sık farklı shard’lardaki verileri birleştirmeye ihtiyaç duyuyorsa, dikey sharding başlangıçtakinden daha fazla performans darboğazı yaratabilir!
Coğrafi sharding
Coğrafi sharding, verileri kullanıcının konumuna göre düzenler. Örneğin, tüm Avrupa kullanıcı verileri bir shard’da bulunurken, Kuzey Amerika verileri başka bir shard’da tutulabilir. Bu strateji, kullanıcıların verilerinin eriştikleri yere daha yakın saklanmasını sağlayarak gecikmeyi azaltır.
Ancak coğrafi sharding kendi zorluklarıyla gelir. Bölgeler arasında seyahat eden veya verileri birden çok konuma yayılan kullanıcıları dikkatle ele almanız gerekir. Shard’lar arasında veri tutarlılığını sağlamak da zorlaşabilir.
Bazen birden fazla stratejiyi birleştirmek en iyi çözüm olabilir—örneğin coğrafi shard’lar içinde yatay sharding kullanmak. Önemli olan, sadelik, ölçeklenebilirlik ve performans arasında denge kurmaktır. Bu shard’ları oluşturduktan sonra veritabanını siz yöneteceksiniz; gelecekteki kendinize işi kolaylaştırın!
Veritabanı Sharding’i için Araçlar ve Çatılar
Sıfırdan başlamanıza ve sharding’i tek başınıza uygulamanıza gerek yok. Sharding’i kolaylaştıran ve yerleşik özelliklerle karmaşıklığı sizin yerinize yöneten birçok araç ve çatı var.
ProxySQL ile MySQL
ProxySQL akıllı bir proxy katmanı olarak hareket eder ve shard edilmiş MySQL veritabanları için sorgu yönlendirme ve yük dengelemesini üstlenir. Hangi shard’ın hangi veriyi tuttuğuna ilişkin bir eşleme tutar ve bir sorgu geldiğinde, uygulamanızın bu mantığı üstlenmesine gerek kalmadan onu otomatik olarak uygun shard’a yönlendirir.
Ben ProxySQL ile bizzat çalışmadım; fakat bir arkadaşım, sorgu yönlendirme yeteneklerinin ona saatlerce sürecek manuel yapılandırmadan tasarruf sağladığına kefil oldu!
MongoDB
MongoDB yerleşik sharding desteğine sahiptir; bu da onu büyük yapılandırılmamış veri kümelerini yönetmek için popüler bir seçenek yapar. MongoDB, belgelerin shard’lar arasında nasıl dağıtılacağını belirlemek için bir sharding anahtarı kullanır; bu nedenle bunu dikkatle seçmeniz gerekir. Kötü bir seçim, dengesiz veri dağılımına ve performans sorunlarına yol açabilir!
Sonrasında MongoDB, bölümleme, veriyi dengeleme ve sorguları otomatik yönlendirme gibi işleri üstlenir.
Citus ile PostgreSQL
İlişkisel veritabanlarını tercih edenler için Citus harika bir seçenektir. Citus, PostgreSQL’i dağıtık bir veritabanına dönüştüren bir eklenti gibidir.
Citus’u bir SaaS uygulamasını ölçeklemek için kullanan bir ekipte çalıştım; PostgreSQL’in sağlamlığını ve yapılandırılmış tablolarını korurken muazzam miktarda veriyi yönetmemizi sağladı.
Citus, shard’lar arasında karmaşık sorguları yönetmek için dağıtık bir sorgu planlayıcı kullanır ve özellikle birden çok shard’dan veri birleştirmeniz gereken analitik ağırlıklı uygulamalar için faydalıdır. Öğrenme eğrisi MongoDB’nin yerleşik sharding’ine kıyasla daha diktir; ancak sonuçlar buna değer!
Sonuç
Umarım bu rehber, kendi sistemlerinizde sharding’i keşfetmeniz için gereken araçları (veya şu anda sizin için doğru çözüm olmadığını söyleme özgüvenini) size kazandırmıştır. Unutmayın, bu tek bedene uyan bir çözüm değildir; ancak dikkatle kullanıldığında, ölçeklenebilir ve verimli mimariler oluşturmak için güçlü bir araçtır.
Ve bu dersleri zor yoldan öğrenmiş biri olarak tavsiyem şu: sharding hakkında düşünmeye veritabanınız çökmeye yüz tuttuğunda başlamayın. Önden plan yapın, deneyin, uyarlayın! Gelecekteki siz (ve kullanıcılarınız) minnettar olacaktır.





İlk veri mühendisliği projem bana verildiğinde birkaç yıldır full-stack mühendis olarak çalışıyordum. O zamana kadar düzenli olarak frontend tarafında kod yazmış, API’ler geliştirmiş ve bulut altyapısını yönetip dağıtmıştım.
Erken aşama girişimlerdeki birçok mühendis gibi ben de veritabanlarına dokunmuş, ara sıra yeni bir tablo veya şema tasarlamış ve küçük miktarlarda veriyi taşımıştım. Derken çalıştığım şirket büyük miktarlarda veri toplamaya başladı ve veritabanı performansı düşüşe geçti.
Uygulamalarımız yavaşlıyordu, gecikme artıyordu ve hatta tepe yüklerde kesinti yaşıyorduk. Ekip olarak çözmek için çok uğraştığımız, oldukça can sıkıcı bir sorundu. İşte o zaman veritabanları hakkında, nasıl çalıştıkları ve nasıl optimize edildikleri konusunda çok şey öğrendim.
Bu blogda, o dönemde gerçekten fark yaratan ve son birkaç yılda defalarca işime yarayan kavramlardan birini açıklayacağım: veritabanı sharding’i.
Veritabanı Sharding’i Nedir?
Veritabanı sharding’i, bir veritabanını daha küçük alt kümelere, yani shard’lara bölme uygulamasıdır; her shard kendi başına bağımsız bir veritabanı gibi çalışır. Bunu, dev bir hesap tablosunu iş yükünün payını üstlenen, daha küçük ve yönetilebilir birkaç tabloya bölmek gibi düşünebilirsiniz.
Bir veritabanı neden ve ne zaman shard edilir?
Sharding her veritabanı sorununun cevabı DEĞİLDİR.
Uygulaması çok daha kolay olan başka yatay ölçekleme yöntemleri (ör. çoğaltma) ya da dikey ölçekleme yöntemleri vardır. Sharding’e atlamadan önce bunlara mutlaka göz atın!
Sharding, veritabanınız büyüyen bir uygulamanın taleplerine ayak uydurmakta zorlanmaya başladığında devreye girer. Belki kullanıcı tabanınız patladı ya da uygulamanız her saniye devasa miktarda veri üretiyor. Yavaş sorgular, artan gecikme veya yoğun trafik sırasında sık kesinti fark ediyorsanız, veritabanınızın sınırlarına dayandığının işareti olabilir.
Sharding’in büyük bir nedeni ölçeklenebilirliktir. Veriniz büyüdükçe tek bir veritabanı sunucusuna daha fazla donanım eklemek (dikey ölçekleme) bir yere kadar işe yarar ve çok pahalı olabilir. Sharding ise verileri birden çok sunucu arasında dağıtarak yatayda ölçeklemenize imkân tanır; her sunucu yükün bir kısmını üstlenir.
Sharding tercih etmenin bir diğer nedeni performanstır. Veritabanınız veri hacmini kaldırsa bile, muazzam miktarda bilgi üzerinde sorgu çalıştırmak zaman alabilir. Sharding ile daha küçük ve odaklı veri kümeleriyle çalışırsınız; bu da daha hızlı sorgular ve kaynaklar için daha az çekişme demektir.
Ne zaman shard edileceğine gelince, genellikle uygulamanız tek bir veritabanının kaldırabileceğinin ötesine geçmeye başladığında bunu düşünmek en iyisidir. Tam zamanlama kaynaklarınıza ve öngörülen büyümeye göre değişir ve ince bir denge gerektirir. Sharding’i çok erken uygulamak, tek bir veritabanının ya da basit iyileştirmelerin yeterli olacağı durumda gereksiz karmaşıklık getirir; çok geç kalmak ise geçişi sancılı hâle getirebilir.
İyi bir kural, veritabanı performans metriklerinizi yakından izlemek ve önceden plan yapmaktır. Yakın gelecekte sorun yaratabilecek darboğazlar veya hızlı veri büyümesi görüyorsanız, muhtemelen sharding’i araştırmanın zamanı gelmiştir. Bana güvenin, sorunun önüne geçmek, ileride sizi büyük dertlerden kurtarır!
Veritabanı Sharding’i ve Bölümleme (Partitioning)
İlk bakışta sharding ve bölümleme benzer görünebilir; çünkü her ikisi de verileri daha iyi düzenleme ve performans için daha küçük parçalara ayırmayı içerir. Ancak amaçları farklıdır ve farklı ölçeklerdeki çalışmalara uygundurlar.
Bölümleme, verilerin aynı veritabanı örneği içinde mantıksal segmentlere ayrılmasıdır. Bu segmentler genellikle aralık, liste veya karma (hash) gibi ölçütlere dayanır. Örneğin, bir kullanıcı veritabanında ocak ayında doğan kullanıcıları bir bölümde, şubatta doğanları başka bir bölümde tutabilirsiniz; hepsi aynı veritabanında kalır.
Bölümleme, henüz yatay ölçeklemeye ihtiyaç duymayan daha küçük ölçekli sistemler için mükemmel bir seçimdir. Sorgular sırasında taranan veri miktarını sınırlayarak sorgu performansını iyileştirir ve veri yönetimini daha verimli kılar.
Sharding ise bu mantıksal segmentleri birden çok bağımsız veritabanına dağıtarak bölümlemeyi bir üst seviyeye taşır. Her shard, kendi verilerini ve sorgularını yöneten bağımsız bir veritabanıdır.
Bu yaklaşım, tek bir veritabanının artık yükü kaldıramadığı büyük ölçekli sistemler için idealdir. Sharding, her shard bağımsız çalıştığı için hem ölçeklenebilirlik hem de hata toleransı sağlar.
Deneyimlerime göre bölümleme, çoğu zaman sharding’e giden bir basamaktır. Performans sorunları görmeye başladıysanız ancak veritabanınız henüz tıkanmadıysa, bölümleme size zaman kazandırır; bu arada sharding gibi daha büyük ölçekli bir çözüme hazırlanabilirsiniz.
Veritabanı tasarımına ilgi duyuyorsanız, şu tam kapsamlı veritabanı tasarımı kursuna göz atın. SQL veritabanlarını nasıl düzenleyeceğinizi, yöneteceğinizi ve optimize edeceğinizi; hatta farklı türde bölümlemeleri nasıl kuracağınızı öğreneceksiniz.
Veritabanı Sharding’i ve Çoğaltma (Replication)
Benzer şekilde, sharding ve çoğaltma sık sık yan yana tartışılır; ancak farklı sorunları ele alırlar ve farklı kullanım alanları vardır.
Sharding’in birincil amacı ölçeklenebilirliktir. Veriyi ve iş yükünü birden çok veritabanına bölerek tek bir veritabanındaki yükü azaltırsınız. Veriniz büyüdükçe daha fazla shard ekleyerek performansı koruyabilir ve tek bir veritabanını aşırı yükleme riskini azaltabilirsiniz.
Çoğaltma ise aynı verinin birden çok sunucuda kopyalarını oluşturmayı içerir. Her kopya tüm veri kümesini barındırır ve okuma işlemlerini bağımsız şekilde karşılayabilir; yani çoğaltma, ölçeklenebilirlikten ziyade yedeklilik ve erişilebilirliğe odaklanır.
Birden fazla veritabanı kopyasına sahip olarak veri kaybına karşı korunur ve bir sunucu devre dışı kalsa bile sisteminizi çevrimiçi tutarsınız; ancak bu, büyüyen veri hacmi sorununu çözmez. Hatta, her kopya tüm veri kümesini sakladığı için, kopya sayısıyla orantılı şekilde depolama gereksinimi artar. Üstüne üstlük, yazma işlemleri veri tutarlılığını korumak için tüm kopyalara uygulanmak zorunda olduğundan darboğaza dönüşebilir.
Mesele şu ki, bu ikisi birbirini dışlayan şeyler olmak zorunda değil. Pratikte, birçok büyük ölçekli sistem sharding ve çoğaltmayı birlikte kullanır. Örneğin, shard edilmiş bir veritabanında her shard’ın ayrıca kopyaları olabilir.
Veritabanı Sharding’i Nasıl Çalışır?
Peki sharding tam olarak nasıl çalışır? Bunu üç ana bileşene ayıralım.
Bölümleme mantığı
Sharding’de ilk adım, verinizi nasıl böleceğinizi belirlemektir. Bölümleme mantığı, verinin shard’lar arasında nasıl paylaştırılacağını belirleyen kural setidir. Bunu yapmanın birkaç yaygın yolu vardır:
Bölümleme mantığının seçimi verilerinize ve uygulama ihtiyaçlarınıza bağlıdır. Kişisel olarak, işlem geçmişleri gibi kronolojik verilerde aralık tabanlı bölümlemenin iyi çalıştığını; öngörülemeyen iş yüklerine sahip sistemlerde ise karma tabanlı yöntemlerin daha iyi sonuç verdiğini gördüm.
Shard eşlemesi
Veriniz bölümledikten sonra, her bölümün karşılık gelen shard’a nasıl eşleneceğini belirlemeniz gerekir.
Bazı sistemler, verilerin sabit kurallara göre shard’lara atandığı statik eşleme kullanır. Diğerleri ise genellikle merkezi bir meta veri hizmeti tarafından yönetilen dinamik eşleme kullanır; bu da gerektiğinde shard eklemeyi veya çıkarmayı kolaylaştırır. Her iki durumda da amaç, sisteminizin herhangi bir veriyi tam olarak nerede bulacağını bilmesini sağlamaktır.
Sorgu yönlendirme
Son olarak, sorguların doğru shard’a gönderilmesini sağlayacak bir mekanizmaya ihtiyacınız var. Buna sorgu yönlendirme denir ve sharding’in uygulamanız için çalışmasını sağlamak açısından önemlidir. Uygulama bir sorgu gönderdiğinde, yönlendirme mantığı ilgili verileri hangi shard’ın (veya shard’ların) tuttuğunu belirler ve isteği oraya iletir.
Bazı durumlarda bu, uygulamanın bölümleme mantığına göre her sorguyu nereye göndereceğini bilmesi kadar basit olabilir. Diğer kurulumlarda, bir proxy veya ara katman yönlendirmeyi üstlenir ve karmaşıklığı uygulamadan soyutlar. Her iki yaklaşımı da kullandım; proxy’ler biraz ek yük getirse de büyük sistemlerde size ciddi emek tasarrufu sağlayabilirler.
Veritabanı Sharding Stratejileri
Sharding için tek bir yaklaşım yoktur. Seçeceğiniz strateji büyük ölçüde verinizin yapısına ve onu nasıl kullandığınıza bağlıdır. En yaygın olanlardan bazılarını ele alacağım; ama üçten çok daha fazlası vardır.
Yatay sharding
Yatay sharding, bir tablonun satırlarını birden çok shard arasında böler. Örneğin, bir kullanıcı veritabanı yönetiyorsanız, kullanıcıları kimliklerine göre shard’lara ayırabilirsiniz: 1-1000 bir shard’da, 1001-2000 başka bir shard’da, vb.
Bu yaklaşım, veriyi ve yükü eşit dağıttığı için en popüler olanlardan biridir; uygulamanız büyüdükçe yatayda ölçekleme yapmayı kolaylaştırır. Özellikle benzer yapıda çok sayıda satıra sahip tablolarınız olduğunda etkilidir.
Yatay sharding kullanırken bölümleme mantığınızı seçerken çok dikkatli olmanız gerekir. Kötü dağıtılmış veri, ciddi derecede dengesiz iş yükleri demektir; bazı shard’lar aşırı yüklenirken diğerleri boşta kalır.
Dikey sharding
Dikey sharding’de veritabanınızı tablolara veya sütunlara göre bölersiniz. Örneğin, kullanıcı profillerini bir shard’a, işlem verilerini başka birine, günlükleri (log) üçüncüsüne koyabilirsiniz. Her shard, özünde belirli bir veri alt kümesinden sorumludur.
Bu strateji, uygulamanızın çok fazla etkileşimi olmayan, net ve ayrı veri alanlarına sahip olduğu durumlarda işe yarar; ancak dikkat edilmesi gereken nokta shard’lar arası sorgulardır. Uygulamanız sık sık farklı shard’lardaki verileri birleştirmeye ihtiyaç duyuyorsa, dikey sharding başlangıçtakinden daha fazla performans darboğazı yaratabilir!
Coğrafi sharding
Coğrafi sharding, verileri kullanıcının konumuna göre düzenler. Örneğin, tüm Avrupa kullanıcı verileri bir shard’da bulunurken, Kuzey Amerika verileri başka bir shard’da tutulabilir. Bu strateji, kullanıcıların verilerinin eriştikleri yere daha yakın saklanmasını sağlayarak gecikmeyi azaltır.
Ancak coğrafi sharding kendi zorluklarıyla gelir. Bölgeler arasında seyahat eden veya verileri birden çok konuma yayılan kullanıcıları dikkatle ele almanız gerekir. Shard’lar arasında veri tutarlılığını sağlamak da zorlaşabilir.
Bazen birden fazla stratejiyi birleştirmek en iyi çözüm olabilir—örneğin coğrafi shard’lar içinde yatay sharding kullanmak. Önemli olan, sadelik, ölçeklenebilirlik ve performans arasında denge kurmaktır. Bu shard’ları oluşturduktan sonra veritabanını siz yöneteceksiniz; gelecekteki kendinize işi kolaylaştırın!
Veritabanı Sharding’i için Araçlar ve Çatılar
Sıfırdan başlamanıza ve sharding’i tek başınıza uygulamanıza gerek yok. Sharding’i kolaylaştıran ve yerleşik özelliklerle karmaşıklığı sizin yerinize yöneten birçok araç ve çatı var.
ProxySQL ile MySQL
ProxySQL akıllı bir proxy katmanı olarak hareket eder ve shard edilmiş MySQL veritabanları için sorgu yönlendirme ve yük dengelemesini üstlenir. Hangi shard’ın hangi veriyi tuttuğuna ilişkin bir eşleme tutar ve bir sorgu geldiğinde, uygulamanızın bu mantığı üstlenmesine gerek kalmadan onu otomatik olarak uygun shard’a yönlendirir.
Ben ProxySQL ile bizzat çalışmadım; fakat bir arkadaşım, sorgu yönlendirme yeteneklerinin ona saatlerce sürecek manuel yapılandırmadan tasarruf sağladığına kefil oldu!
MongoDB
MongoDB yerleşik sharding desteğine sahiptir; bu da onu büyük yapılandırılmamış veri kümelerini yönetmek için popüler bir seçenek yapar. MongoDB, belgelerin shard’lar arasında nasıl dağıtılacağını belirlemek için bir sharding anahtarı kullanır; bu nedenle bunu dikkatle seçmeniz gerekir. Kötü bir seçim, dengesiz veri dağılımına ve performans sorunlarına yol açabilir!
Sonrasında MongoDB, bölümleme, veriyi dengeleme ve sorguları otomatik yönlendirme gibi işleri üstlenir.
Citus ile PostgreSQL
İlişkisel veritabanlarını tercih edenler için Citus harika bir seçenektir. Citus, PostgreSQL’i dağıtık bir veritabanına dönüştüren bir eklenti gibidir.
Citus’u bir SaaS uygulamasını ölçeklemek için kullanan bir ekipte çalıştım; PostgreSQL’in sağlamlığını ve yapılandırılmış tablolarını korurken muazzam miktarda veriyi yönetmemizi sağladı.
Citus, shard’lar arasında karmaşık sorguları yönetmek için dağıtık bir sorgu planlayıcı kullanır ve özellikle birden çok shard’dan veri birleştirmeniz gereken analitik ağırlıklı uygulamalar için faydalıdır. Öğrenme eğrisi MongoDB’nin yerleşik sharding’ine kıyasla daha diktir; ancak sonuçlar buna değer!
Sonuç
Umarım bu rehber, kendi sistemlerinizde sharding’i keşfetmeniz için gereken araçları (veya şu anda sizin için doğru çözüm olmadığını söyleme özgüvenini) size kazandırmıştır. Unutmayın, bu tek bedene uyan bir çözüm değildir; ancak dikkatle kullanıldığında, ölçeklenebilir ve verimli mimariler oluşturmak için güçlü bir araçtır.
Ve bu dersleri zor yoldan öğrenmiş biri olarak tavsiyem şu: sharding hakkında düşünmeye veritabanınız çökmeye yüz tuttuğunda başlamayın. Önden plan yapın, deneyin, uyarlayın! Gelecekteki siz (ve kullanıcılarınız) minnettar olacaktır.