
Last chance! 50% off DataCamp Premium
Sale ends in
Ik was een paar jaar fullstack engineer toen ik mijn eerste data-engineeringproject kreeg toegewezen. Tot dat moment had ik aan de frontend geprogrammeerd, API’s ontwikkeld en regelmatig cloudinfrastructuur beheerd en uitgerold.
Zoals veel engineers bij startups in een vroege fase had ik ook met databases gewerkt: hier en daar een nieuwe tabel of schema ontworpen en kleine hoeveelheden data gemigreerd. Maar toen begon het bedrijf waarvoor ik werkte enorme hoeveelheden data te verzamelen, en de databaseprestaties gingen achteruit.
Onze applicaties werden trager, de latentie nam toe en we kregen zelfs downtime tijdens piekbelasting. Het was een enorm frustrerend probleem waar mijn team hard aan werkte om het op te lossen. Toen heb ik ontzettend veel geleerd over databases, hoe ze werken en hoe je ze optimaliseert.
In deze blog leg ik een van de concepten uit die toen echt het verschil maakten en sindsdien nog vaak: database-sharding.
Database-sharding is het opsplitsen van een database in kleinere subsets, of shards, waarbij elke shard als een onafhankelijke database functioneert. Zie het als het opdelen van één gigantische spreadsheet in meerdere kleinere, beter beheersbare varianten, die elk hun eigen deel van de werklast afhandelen.
Sharding is NIET het antwoord op elk databaseprobleem.
Er zijn andere methoden voor horizontale schaalvergroting, zoals replicatie, of verticale schaalvergroting, die veel eenvoudiger te implementeren zijn. Kijk daar eerst naar voordat je in sharding duikt!
Sharding komt in beeld wanneer je database moeite krijgt om gelijke tred te houden met de eisen van een groeiende applicatie. Misschien is je gebruikersbestand geëxplodeerd, of genereert je applicatie elke seconde enorme hoeveelheden data. Als je trage queries, hogere latentie of frequente downtime tijdens piekverkeer opmerkt, is dat waarschijnlijk een teken dat je database zijn grenzen bereikt.
Een grote reden voor sharding is schaalbaarheid. Naarmate je data groeit, kom je met extra hardware op één databaseserver (verticale schaalvergroting) maar tot zover, en het kan erg duur worden. Sharding daarentegen laat je horizontaal schalen door data over meerdere servers te verdelen, die elk een deel van de load dragen.
Een andere reden om voor sharding te kiezen, is performance. Zelfs als je database het datavolume aankan, kan het opvragen van enorme hoeveelheden informatie tijd kosten. Door te sharden werk je met kleinere, meer gerichte datasets, wat leidt tot snellere queries en minder concurrentie om resources.
Wat betreft het moment om te sharden: meestal kun je het beste overwegen zodra je applicatie groter wordt dan wat één database aankan. De exacte timing hangt van veel variabelen af, zoals je resources en verwachte groei, en blijft een dunne lijn. Te vroeg sharden introduceert onnodige complexiteit waar één database of simpele optimalisaties genoeg waren geweest, maar te lang wachten maakt de overgang pijnlijk.
Een goede vuistregel is om je databaseprestatiemetrics nauwlettend te monitoren en vooruit te plannen. Merk je knelpunten of snelle datagroei die op korte termijn problemen kan veroorzaken, dan is het waarschijnlijk tijd om sharding te verkennen. Geloof me, problemen vóór zijn bespaart je later heel wat hoofdpijn!
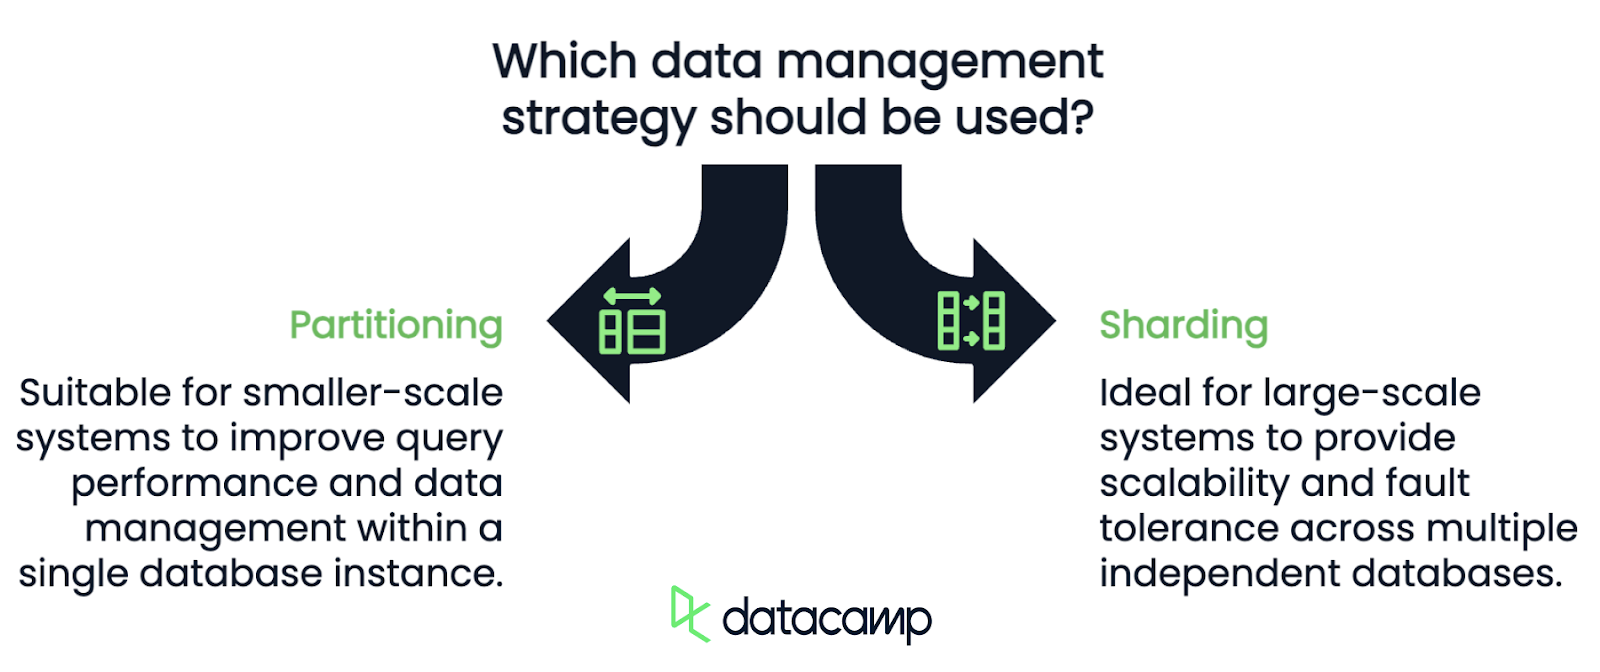
Op het eerste gezicht lijken sharding en partitionering hetzelfde, omdat beide data in kleinere stukken opsplitsen voor betere organisatie en performance. Maar ze dienen verschillende doelen en zijn geschikt voor uiteenlopende schalen.
Partitionering is het opdelen van data in logische segmenten binnen dezelfde database-instantie. Deze segmenten, vaak partities genoemd, kunnen gebaseerd zijn op criteria zoals range, lijst of hash. In een gebruikersdatabase kun je bijvoorbeeld gebruikers die in januari geboren zijn in één partitie opslaan en februari in een andere, allemaal binnen dezelfde database.
Partitionering is een uitstekende keuze voor systemen op kleinere schaal die nog niet horizontaal hoeven te schalen. Het verbetert de queryprestaties door de hoeveelheid gescande data te beperken en maakt datamanagement efficiënter.
Sharding tilt partitionering daarentegen naar een hoger niveau door deze logische segmenten over meerdere onafhankelijke databases te verdelen. Elke shard is een zelfstandige database die zijn eigen data en queries afhandelt.
Deze aanpak is ideaal voor grootschalige systemen waar één database de load niet meer aankan. Sharding biedt zowel schaalbaarheid als fouttolerantie, omdat elke shard onafhankelijk werkt.
Uit mijn ervaring is partitionering vaak een stap richting sharding. Als je performanceproblemen begint te zien maar je database nog niet aan zijn limiet zit, kan partitionering je tijd kopen terwijl je je voorbereidt op een grootschaligere oplossing zoals sharding.
Als je geïnteresseerd bent in databaseontwerp, bekijk dan deze volledige cursus databaseontwerp. Je leert hoe je SQL-databases ordent, beheert en optimaliseert, en zelfs hoe je verschillende vormen van partitionering inricht.
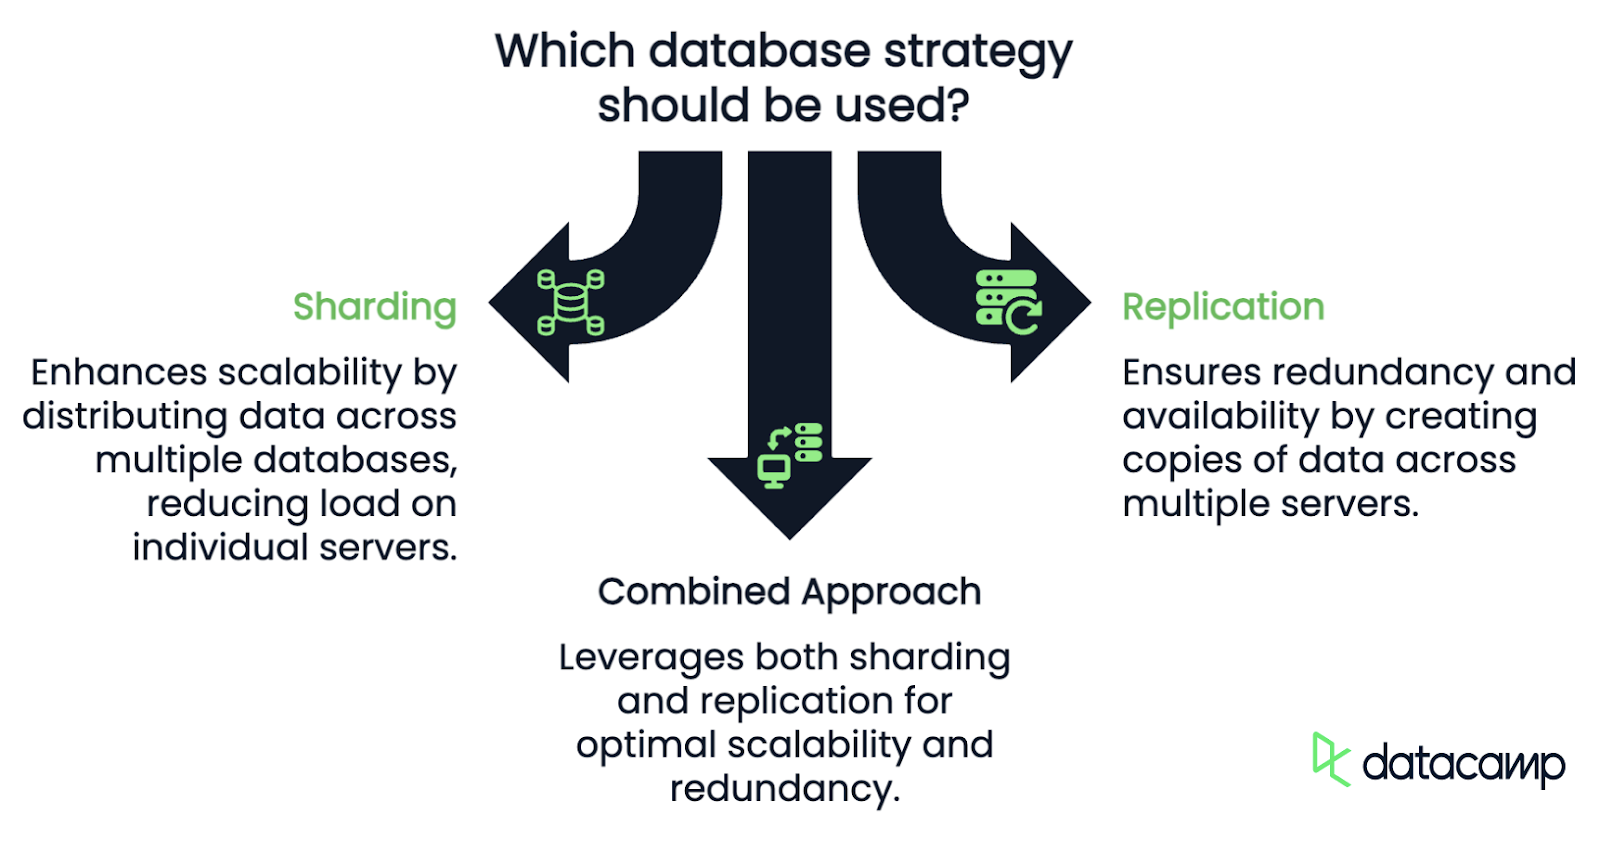
Net als hierboven worden sharding en replicatie vaak naast elkaar besproken, maar ze lossen verschillende problemen op en hebben andere use-cases.
Het primaire doel van sharding is schaalbaarheid. Door de data en werklast over meerdere databases te verdelen, verminder je de load op een enkele database. Sharding zorgt ervoor dat je, naarmate je data groeit, meer shards kunt toevoegen om dit op te vangen, met behoud van performance en minder risico op overbelasting van één database.
Replicatie daarentegen betekent dat je kopieën van dezelfde data op meerdere servers maakt. Elke replica bevat de volledige dataset en kan zelfstandig read-operaties afhandelen; replicatie is dus gericht op redundantie en beschikbaarheid in plaats van schaalbaarheid.
Met meerdere kopieën van je database bescherm je tegen dataverlies en blijft je systeem online als een server uitvalt, maar het lost het probleem van groeiende datavolumes niet op. Sterker nog, omdat elke replica de volledige dataset opslaat, groeien de opslagvereisten evenredig met het aantal replicas. Bovendien kunnen write-operaties een bottleneck worden, omdat ze op alle replicas moeten worden toegepast om de data consistent te houden.
Het is overigens niet per se het een of het ander. In de praktijk gebruiken veel grootschalige systemen zowel sharding als replicatie samen. Zo kan een geshardde database bijvoorbeeld replicas van elke shard hebben.
Oké, hoe werkt sharding nu precies? Laten we het opdelen in drie kerncomponenten.
De eerste stap bij sharding is bepalen hoe je je data verdeelt. Je partitioneringslogica is de set regels die bepaalt hoe data over shards wordt gespreid. Er zijn een paar gangbare manieren:
De keuze voor partitioneringslogica hangt af van je data en applicatiebehoeften. Ik heb zelf gezien dat range-gebaseerde partitionering goed werkt voor chronologische data, zoals transactiehistorie, terwijl hash-methodes beter werkten in systemen met onvoorspelbare workloads.
Zodra je data is gepartitioneerd, heb je een manier nodig om elke partitie aan de bijbehorende shard te koppelen.
Sommige systemen gebruiken statische mapping, waarbij data op basis van vaste regels aan shards wordt toegewezen. Andere gebruiken dynamische mapping, vaak beheerd door een centrale metadataservice, wat het gemakkelijker maakt om shards naar behoefte toe te voegen of te verwijderen. Hoe dan ook, het doel is dat je systeem precies weet waar een gegeven stuk data te vinden is.
Tot slot heb je een mechanisme nodig om ervoor te zorgen dat queries naar de juiste shard worden gestuurd. Dit heet queryrouting en is cruciaal om sharding voor je applicatie te laten werken. Wanneer een applicatie een query verstuurt, bepaalt de routinglogica welke shard(s) de relevante data bevat(ten) en stuurt de aanvraag daarheen.
Soms is dit zo eenvoudig als dat de applicatie zelf op basis van de partitioneringslogica weet waar elke query naartoe moet. In andere opzetten handelt een proxy- of middlewarelaag de routing af en schermt zo de complexiteit af voor de applicatie. Ik heb met beide gewerkt; proxies voegen wat overhead toe, maar kunnen je in grotere systemen veel werk besparen.
Er is niet één manier om te sharden. De strategie die je kiest, hangt sterk af van de structuur van je data en hoe je die gebruikt. Ik bespreek een paar van de meest gangbare, maar er zijn er meer dan drie.
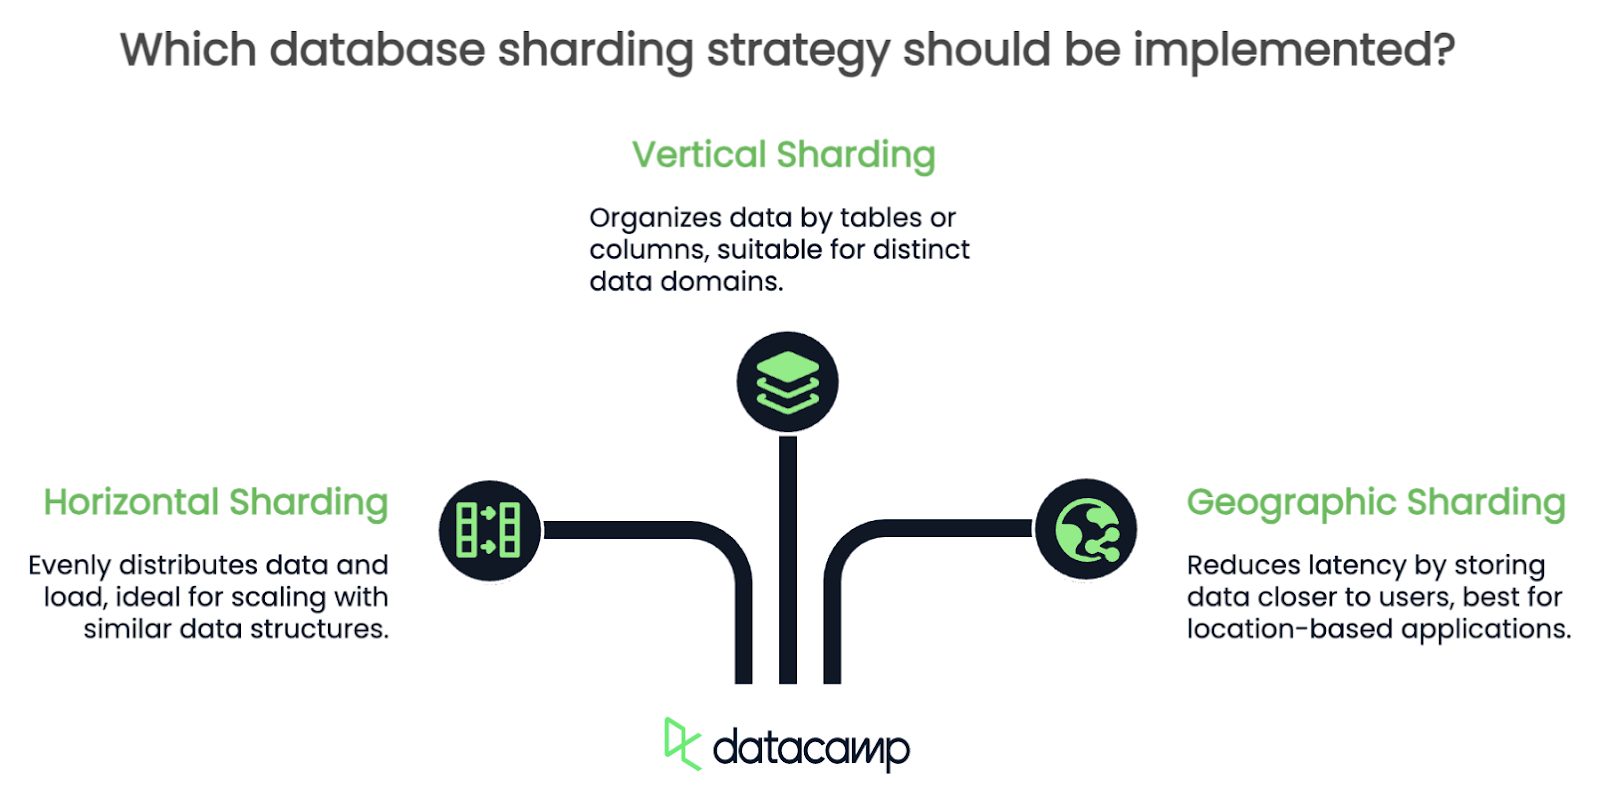
Horizontale sharding splitst rijen van een tabel over meerdere shards. Als je bijvoorbeeld een gebruikersdatabase beheert, kun je gebruikers op basis van hun ID over shards verdelen: gebruikers 1-1000 in één shard, 1001-2000 in een andere, enzovoort.
Deze aanpak is een van de populairste omdat hij data en load gelijkmatig verdeelt, waardoor horizontaal schalen gemakkelijker wordt naarmate je applicatie groeit. Het is vooral effectief wanneer je tabellen veel rijen met vergelijkbare structuur hebben.
Bij horizontale sharding moet je extra zorgvuldig zijn bij het kiezen van je partitioneringslogica. Slecht verdeelde data betekent sterk ongelijke workloads: sommige shards worden overladen terwijl andere niets te doen hebben.
Bij verticale sharding splits je je database op basis van tabellen of kolommen. Je kunt bijvoorbeeld gebruikersprofielen in één shard zetten, transactiegegevens in een andere en logs in een derde. Elke shard is in feite verantwoordelijk voor een specifieke subset van data.
Deze strategie werkt goed als je applicatie duidelijke, afzonderlijke datadomeinen heeft die weinig met elkaar interacteren. Let wel op cross-shard-queries. Als je applicatie vaak data uit verschillende shards moet combineren, kan verticale sharding juist meer bottlenecks creëren dan je in eerste instantie had!
Geografische sharding organiseert data op basis van de locatie van de gebruiker. Zo kan alle data van Europese gebruikers in één shard staan en Noord-Amerikaanse data in een andere. Deze strategie vermindert latentie doordat de data van gebruikers dichter bij de plek wordt opgeslagen waar ze die benaderen.
Geografische sharding kent echter eigen uitdagingen. Je moet zorgvuldig omgaan met gebruikers die tussen regio’s reizen of van wie de data meerdere locaties bestrijkt. Data consistent houden over shards heen kan ook lastig worden.
Soms is een combinatie van strategieën het beste—bijvoorbeeld horizontale sharding binnen geografische shards. De sleutel is een balans tussen eenvoud, schaalbaarheid en performance. Je moet je database ook na het aanmaken van shards blijven beheren, dus maak het je toekomstige zelf gemakkelijk!
Je hoeft niet vanaf nul te beginnen en sharding helemaal zelf te implementeren. Er zijn veel tools en frameworks die sharding eenvoudiger maken en ingebouwde features bieden om de complexiteit voor je af te handelen.
ProxySQL fungeert als een slimme proxylaag en verzorgt queryrouting en load balancing voor geshardde MySQL-databases. Het onderhoudt een mapping van welke shard welke data bevat en routeert inkomende queries automatisch naar de juiste shard, zodat je applicatie die logica niet zelf hoeft te doen.
Ik heb zelf nooit met ProxySQL gewerkt, maar een vriend van me vertelde dat de mogelijkheid om queryrouting af te handelen hem uren handmatige configuratie heeft bespaard!
MongoDB heeft ingebouwde ondersteuning voor sharding, wat het een populaire optie maakt voor grote ongestructureerde datasets. MongoDB gebruikt een sharding-sleutel om te bepalen hoe documenten over shards worden verdeeld, dus die moet je zorgvuldig kiezen. Een slechte keuze kan leiden tot een oneven dataverdeling en performanceproblemen!
MongoDB regelt de rest: partitionering, het balanceren van data en het automatisch routeren van queries.
Citus is een geweldige optie voor wie de voorkeur geeft aan relationele databases. Citus is in wezen een extensie die PostgreSQL transformeert in een gedistribueerde database.
Ik heb in een team gewerkt dat Citus gebruikte om een SaaS-applicatie te schalen, en daarmee konden we de robuustheid van PostgreSQL en gestructureerde tabellen behouden terwijl we enorme hoeveelheden data verwerkten.
Citus gebruikt een gedistribueerde queryplanner om complexe queries over shards te verwerken en is vooral handig voor analytics-intensieve applicaties waarbij je data uit meerdere shards moet combineren. De leercurve was steiler dan bij de ingebouwde sharding van MongoDB, maar het was het waard!
Ik hoop dat deze gids je de handvatten geeft om sharding in je eigen systemen te verkennen (of het vertrouwen om te zeggen dat het nu niet de juiste oplossing voor je is!). Onthoud: het is geen one-size-fits-all-oplossing, maar doordacht toegepast is het een krachtig middel om schaalbare en efficiënte architecturen te bouwen.
En als iemand die deze lessen op de harde manier geleerd heeft, is dit mijn advies: wacht niet tot je database op zijn knieën ligt voordat je aan sharding denkt. Plan vooruit, experimenteer en pas je aan! Je toekomstige zelf (en je gebruikers) zullen je dankbaar zijn.
Leer data engineering met deze cursussen!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min


