
Kursus
Membangun Agen AI dengan Google ADK
1 Hr
7.5K
Suara adalah arena perebutan bulan ini. Di Speech to Speech Index milik Artificial Analysis, GPT-Live-1 Astra dari OpenAI dan Grok Voice Think Fast 2.0 dari SpaceXAI hanya terpaut 0,2 poin di puncak, dan OpenAI merilis GPT-6 Astra pada awal September. Pada 15 September, Google menjawab dengan dua model speech-to-speech baru: Gemini 3.8 Live dan Gemini 3.8 Live Extended Thinking.
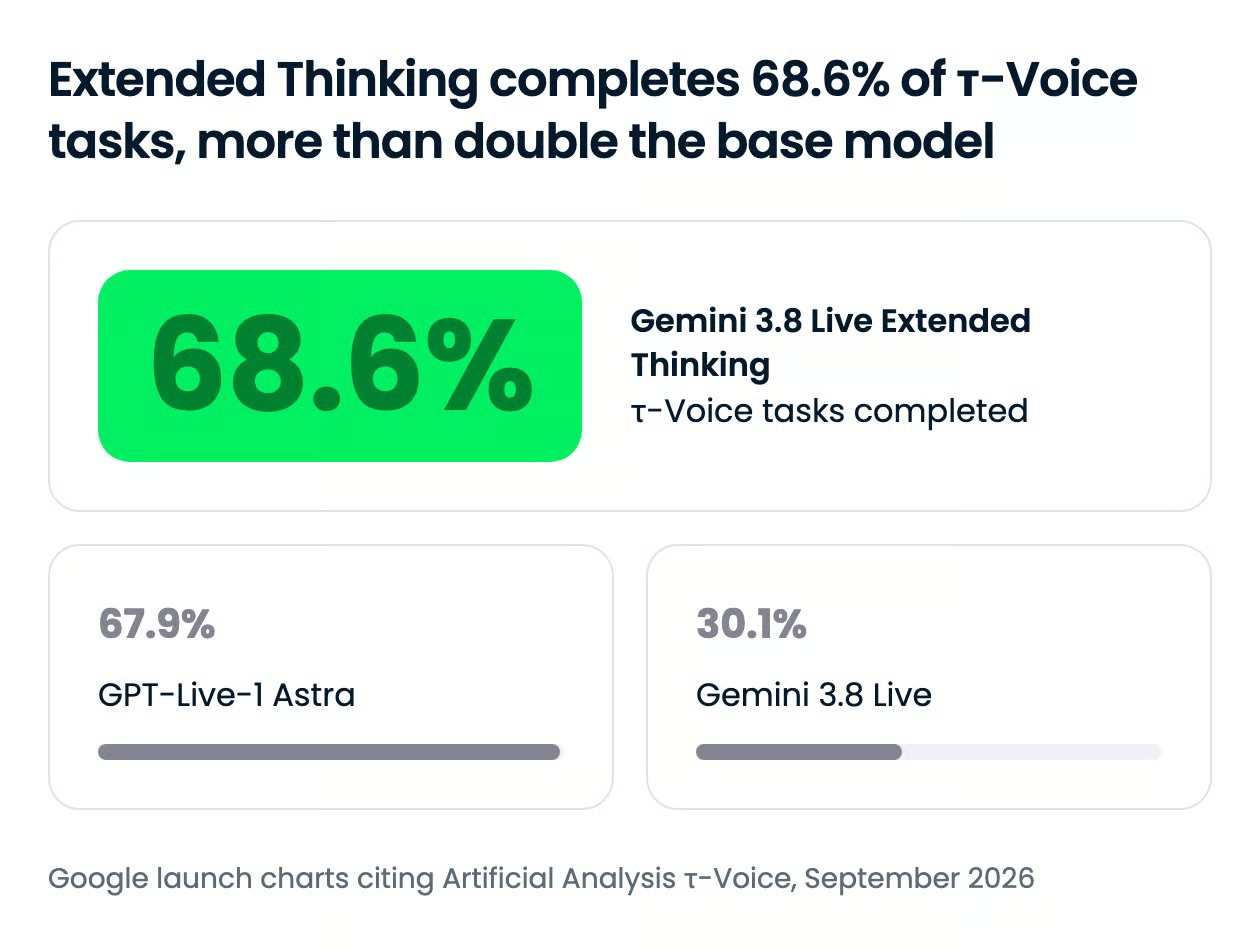
Extended Thinking menempati peringkat pertama pada indeks tersebut dengan skor 82,6 dan memimpin tolok ukur agen τ-Voice di 68,6%. Model 3.8 Live dasar adalah yang murah: dalam uji biaya Artificial Analysis model ini memproses satu jam audio masukan seharga $0,84, terendah di antara model apa pun yang dipublikasikan Google. Keduanya sudah tersedia umum di Gemini API hari ini dengan harga yang sama seperti pendahulunya, Gemini 3.1 Flash Live.
Dalam artikel ini, saya akan membahas semua yang baru dari Gemini 3.8 Live: fitur, tolok ukur, perbedaan kedua variannya, dan biaya operasionalnya. Anda juga bisa melihat panduan kami untuk mulai menggunakan Gemini Live API dan membangun asisten suara dengan GPT-Live-1.
Gemini 3.8 Live adalah model speech-to-speech native Google untuk agen suara real-time, dirilis pada 15 September 2026 bersamaan dengan saudaranya yang berpenalaran lebih tinggi, Gemini 3.8 Live Extended Thinking. Keduanya berjalan melalui Gemini Live API lewat koneksi WebSocket, menerima audio, video, gambar, dan teks sebagai masukan, serta mengembalikan audio. Google memosisikan 3.8 Live sebagai default untuk dialog ber-latensi rendah dan Extended Thinking sebagai pilihan untuk tugas kompleks multi-langkah.
Perubahan generasional dari Gemini 3.1 Flash Live ada pada cara model menangani pekerjaan selain berbicara. Panggilan alat dan API kini berjalan di latar secara default sementara model melanjutkan percakapan, dan Extended Thinking menambahkan penalaran latar belakang yang dapat dikonfigurasi di atasnya. Google menggambarkan pasangan ini sebagai lompatan dari model live sebelumnya dan sebagai pengganti pipa berantai yang menggabungkan speech-to-text, LLM, dan text-to-speech.
Google mencantumkan lima kapabilitas untuk model baru ini, dan yang paling penting bagi pembangun agen suara adalah dua hal yang mengubah siklus percakapan: pemanggilan alat asinkron dan penalaran latar belakang.
Kedua model mengeksekusi pemanggilan fungsi dan permintaan API di latar belakang sambil mengalirkan audio kembali ke pengguna. Pada Gemini 3.8 Live, eksekusi asinkron kini menjadi mode default untuk pemanggilan fungsi. Anda masih bisa memaksa perilaku sinkron lama dengan menyetel behavior: BLOCKING pada deklarasi alat, dan model mendukung penjadwalan fungsi dengan opsi SILENT, WHEN_IDLE, dan INTERRUPTED yang menentukan kapan hasil akan diucapkan.
Extended Thinking melangkah lebih jauh: model ini mewajibkan alat non-blocking dan akan mengembalikan error jika Anda mendeklarasikan alat blocking. Dampak praktisnya: penelepon yang meminta mengubah pemesanan akan langsung mendengar pengakuan, lalu pembaruan progres, lalu hasilnya, alih-alih keheningan yang dihasilkan pipa berantai saat menunggu API. Pada Gemini 3.1 Flash Live, pemanggilan fungsi hanya sekuensial, dan model tidak akan mulai merespons sampai Anda mengirimkan hasil alat kembali.
Gemini 3.8 Live Extended Thinking bernalar dan berbicara secara bersamaan. Dokumen Google menggambarkan model menggunakan isyarat verbal awal seperti "Saya cek dulu" untuk mengakui prompt, lalu menarasikan progres saat pekerjaan latar belakang multi-langkah berlangsung. Anda mengontrol kedalaman dengan thinking_level yang disetel ke low, medium, atau high; level MINIMAL yang ada pada 3.1 Flash Live sudah dihapus.
Ini mengubah protokol, dan menurut saya ini detail migrasi paling penting dalam rilis ini. Karena model dapat berbicara beberapa kali dalam satu permintaan, turnComplete: true tidak lagi berarti model sedang idle.
Klien Anda harus memantau field baru interaction_status, yang melaporkan IN_PROGRESS saat penalaran atau alat sedang berjalan dan IDLE saat seluruh tugas selesai. Jika dilewatkan, UI Anda akan kembali ke mode "mendengarkan" sementara model masih berada di tengah tugas.
Gemini 3.8 Live menautkan dialog dengan masukan visual langsung, memproses frame video hampir real-time sehingga agen dapat merespons apa yang dilihat pengguna sekaligus apa yang mereka ucapkan. Demo Google mencakup permainan catur langsung dan panduan onboarding karyawan di mana model menjawab pertanyaan tentang apa yang ada di layar.
Namun video tidak gratis. Cakupan giliran kini secara default mengirim aktivitas audio plus semua frame video ke model, jadi jika aplikasi Anda tidak membutuhkan visi, Anda sebaiknya mengirim frame hanya saat berguna, baik untuk anggaran konteks maupun biaya. Sesi audio-plus-video juga dibatasi 2 menit sebelum Anda perlu manajemen sesi untuk memperpanjangnya, dibanding 15 menit untuk sesi audio saja.
Google menyebutnya "presisi alfanumerik": mem-parsing secara akurat string seperti kode konfirmasi, nomor klaim, dan pengenal teknis yang diucapkan. Siapa pun yang membangun agen suara untuk dukungan atau logistik tahu ini titik rapuh tumpukan berantai, karena kesalahan speech-to-text di awal rantai tidak bisa dipulihkan di hilir. Model suara native yang mendengar keseluruhan ujaran dalam konteks punya keunggulan struktural di sini.
Gemini 3.8 Live mendeteksi dan beralih di antara 97 bahasa yang didukung selama percakapan, dengan apa yang disebut Google sebagai konsistensi aksen di antaranya. Kedua model juga mendukung apa yang disebut Google sebagai pembaruan konten inkremental: Anda dapat mengirim data terstruktur ke dalam sesi kapan saja, dengan peran user atau model secara eksplisit, dan model akan menggabungkannya dengan audio langsung. Inilah cara Anda memasukkan catatan pelanggan atau status pesanan ke panggilan yang sedang berlangsung tanpa memutus alur.
Dua perubahan kecil memengaruhi kode yang ada. Audio proaktif, di mana model dapat memutuskan untuk tidak merespons ucapan yang tidak ditujukan padanya, kini menyala permanen, dan menyetelnya ke false akan mengembalikan error. Dialog afektif telah dihapus sepenuhnya dari API, jadi konfigurasi enable_affective_dialog apa pun harus dihapus.
Extended Thinking memimpin semua papan kualitas dan keagenan yang dipublikasikan Google, tetapi dengan selisih tipis atas GPT-Live-1 Astra milik OpenAI, sementara model 3.8 Live dasar menang telak pada biaya namun kalah pada tugas agenik.
Angka indeks, τ-Voice, Big Bench Audio, dan biaya di bawah ini semuanya ada di leaderboard publik Artificial Analysis, jadi diukur secara independen, bukan laporan vendor. Angka τ³-Banking berasal dari grafik peluncuran Google yang mengutip Sierra, jadi perlakukan baris itu sebagai laporan vendor sampai papan Sierra menampilkan hal yang sama.
Gemini 3.8 Live Extended Thinking memimpin di τ-Voice, tolok ukur Sierra untuk menilai apakah agen suara menyelesaikan tugas multi-langkah dengan alat, sebagaimana diukur oleh Artificial Analysis. GPT-Live-1 Astra berada tak jauh di belakang, sementara kompetitor lainnya tertinggal:
Angka yang mengejutkan saya adalah skor model dasar pada τ-Voice berada di bawah pendahulunya sendiri. Google tegas bahwa 3.8 Live dibangun untuk skala dan efisiensi biaya alih-alih alur kerja kompleks, tetapi kesenjangan lebih dari 38 poin antara dua varian berarti pilihan tier bukan soal nuansa. Jika agen Anda merantai alat, model dasar adalah default yang keliru.
Pada leaderboard τ³-Banking milik Sierra, tolok ukur layanan pelanggan yang lebih sulit berbasis alur perbankan, Extended Thinking mencetak 35,1% dibanding 32,0% untuk GPT-Live-1 Astra, 16,5% untuk Grok Voice Think Fast 2.0 dari SpaceXAI, 11,3% untuk Gemini 3.1 Flash Live, dan 10,3% untuk GPT-Realtime 2. Setiap model di papan itu gagal sebagian besar waktu, yang menunjukkan betapa jauhnya agen suara dari pekerjaan perbankan tanpa pengawasan, tetapi peningkatan tiga kali lipat atas generasi Gemini sebelumnya adalah langkah nyata.
Pada Speech to Speech Index, Extended Thinking unggul tipis juga:
Keunggulan 1,1 poin atas OpenAI tetaplah keunggulan, tetapi saya tidak akan mendasarkan keputusan pembelian hanya pada itu.
Untuk penalaran murni atas masukan lisan, Google melaporkan 97,7% pada Big Bench Audio untuk Extended Thinking. Google juga melaporkan bahwa kedua model mendorong batas Pareto pada EVA-Bench milik ServiceNow untuk agen suara, menyeimbangkan akurasi dengan kualitas percakapan, meski pengujian itu dilakukan pada Live API melalui Gemini Enterprise Agent Platform, bukan API publik.
Ini grafik yang paling ingin ditunjukkan Google. Dalam uji biaya Artificial Analysis pada subset Big Bench Audio, Gemini 3.8 Live memproses satu jam audio masukan seharga $0,84.
Extended Thinking berharga $3,50 untuk jam yang sama, Grok Voice Think Fast 2.0 berharga $4,80, dan GPT-Live-1 Astra berharga $5,83. Gemini 3.1 Flash Live berada di $1,50 dan $1,75 tergantung tingkat thinking.
Baca dua batang Gemini bersama, dan strategi produk menjadi jelas. Model dasar mengalahkan semua di papan dengan selisih lebar, dan model penalaran yang menandingi OpenAI dalam kualitas tetap 40% lebih murah per jam input. Perlu dicatat bahwa model penalaran membakar lebih banyak token pada tingkat thinking yang lebih tinggi, itulah sebabnya biayanya kira-kira 4 kali lipat saudaranya meski berbagi tabel harga.
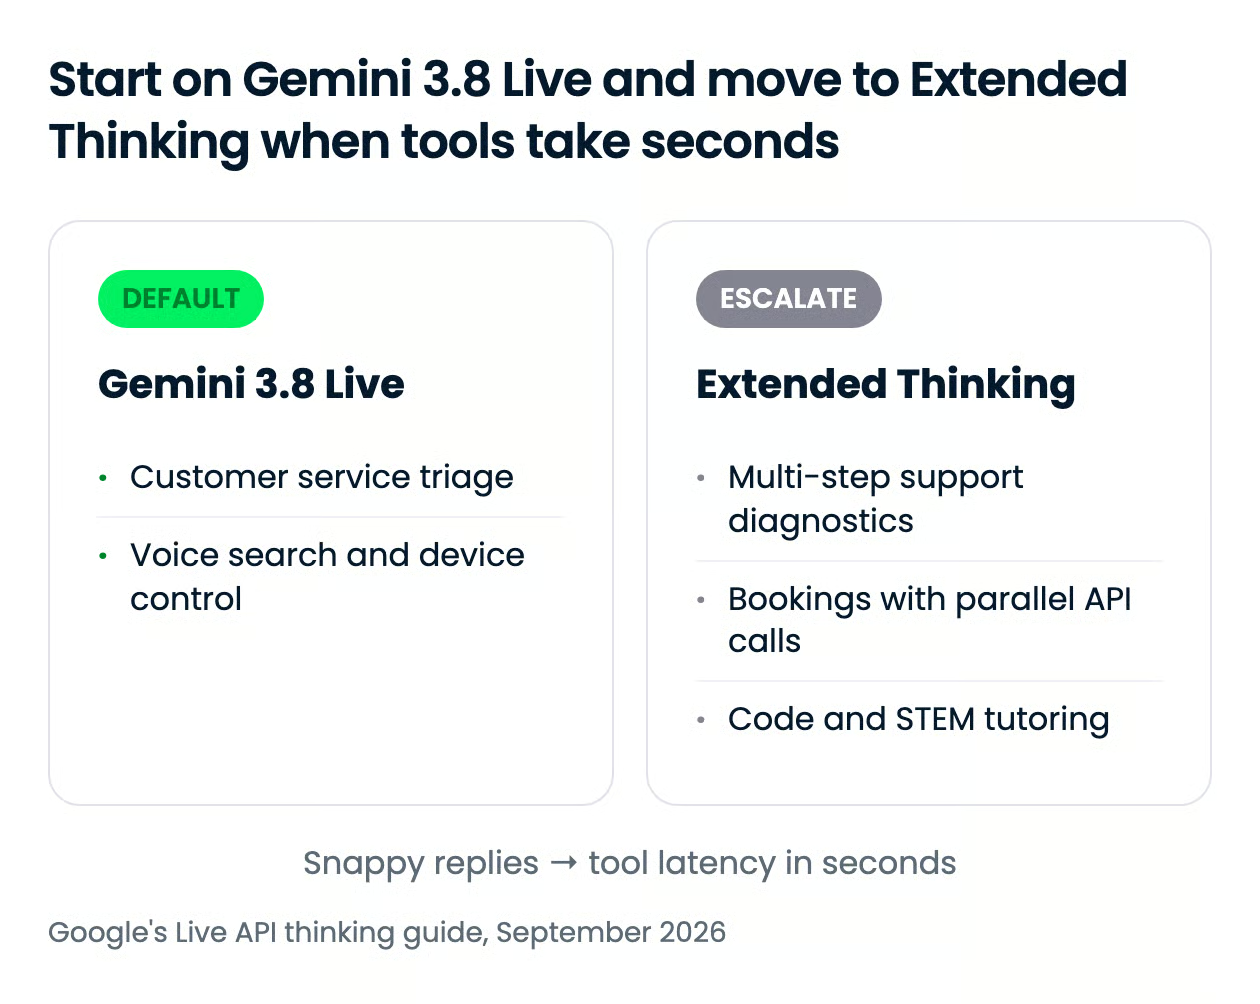
Gemini 3.8 Live adalah default yang tepat untuk sebagian besar agen suara, dan Extended Thinking layak dengan pembakaran token yang lebih tinggi hanya ketika agen harus merencanakan, membandingkan, atau menunggu alat yang lambat. Panduan Google sendiri menarik garis pada latensi alat: jika fungsi Anda kembali dalam hitungan milidetik, tetaplah pada model dasar.
Kedua varian berbagi tabel harga (yang akan saya bahas di bawah), batas token 131.072 input dan 65.536 output, serta endpoint WebSocket yang sama. Yang membedakan adalah arsitektur penalarannya.
Gemini 3.8 Live menggunakan penalaran terjalin dengan profil latensi tetap dan tanpa pengaturan thinking_level sama sekali. Extended Thinking mengekspos penalaran latar belakang low, medium, dan high, mengalirkan isian percakapan saat bekerja, dan mewajibkan alat asinkron. Tingkat thinking itulah satu-satunya kontrol usaha pada rilis ini.
| Use case | Pilihan | Alasan |
|---|---|---|
| Triage layanan pelanggan, penelusuran suara, latihan bahasa | Gemini 3.8 Live | Giliran respons segera lebih penting daripada kedalaman, dan setiap giliran pengguna mendapat satu respons |
| Kendali perangkat pintar, pembacaan nilai sensor | Gemini 3.8 Live | Alat merespons dalam milidetik, jadi tidak ada yang perlu ditutupi |
| Dukungan teknis lintas log, kode kesalahan, dan pemeriksaan konfigurasi | Extended Thinking | Diagnosa multi-langkah membutuhkan penalaran latar antarujaran |
| Agen perjalanan dan pemesanan yang menanyakan penerbangan dan hotel secara paralel | Extended Thinking | Panggilan async paralel dengan pembaruan progres terucap alih-alih keheningan |
| TUTORING STEM dan kode | Extended Thinking | Model memverifikasi rumus atau men-debug kode sebelum menyampaikan penjelasan |
Satu pertimbangan lagi: kompleksitas klien. Beralih ke Extended Thinking berarti menulis ulang penanganan state Anda di sekitar interaction_status, jadi jika Anda memiliki aplikasi 3.1 Flash Live yang berfungsi, model dasar adalah upgrade langsung, dan model penalaran adalah refaktor kecil.
Kedua model berbagi tabel harga Gemini 3.1 Flash Live Preview, jadi upgrade gratis. Pada tier berbayar, input audio dikenai biaya $3,00 per 1 juta token, yang oleh Google diperkirakan sekitar $0,005 per menit, dan output audio $12,00 per 1 juta token, atau sekitar $0,018 per menit. Token thinking ditagihkan dengan tarif output, yang menjadi sumber biaya berjalan lebih tinggi untuk Extended Thinking.
| Modality | Tier berbayar, per 1M token | Perkiraan per menit |
|---|---|---|
| Teks input | $0,75 | n/a |
| Audio input | $3,00 | $0,005/menit |
| Gambar dan video input | $1,00 | $0,002/menit |
| Teks output | $4,50 | n/a |
| Audio output (termasuk token thinking) | $12,00 | $0,018/menit |
Tier gratis mencakup kedua model tanpa biaya untuk input dan output, dengan catatan biasa bahwa data tier gratis digunakan Google untuk meningkatkan produknya; data tier berbayar tidak digunakan demikian.
Grounding dengan Google Search didukung di kedua tier, dengan 5.000 permintaan penelusuran gratis per bulan yang dibagi di semua model Gemini 3.x dan $14 per 1.000 permintaan setelah itu. Google belum menerbitkan batas laju spesifik untuk model-model ini, jadi periksa halaman batas laju Gemini API untuk tier Anda sebelum merencanakan peluncuran.
Ketersediaan dibagi tiga:
Setiap keluaran audio dari kedua model membawa watermark SynthID, dan kartu model Google terbuka soal batasannya: model masih mungkin berhalusinasi, ketahanan terhadap jailbreak masih ditingkatkan, dan mungkin ada kelambatan atau timeout sesekali. Catatan tersebut layak dibaca sebelum Anda menempatkan salah satu model di depan pelanggan.
ID modelnya adalah gemini-3.8-live dan gemini-3.8-live-extended-thinking, keduanya string stabil tanpa sufiks pratinjau.
Anda dapat mengaksesnya melalui Gemini Live API dengan SDK google-genai untuk Python atau JavaScript, melalui WebSocket mentah, atau secara interaktif di tampilan Stream milik Google AI Studio. Google juga mencantumkan Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel, dan Vision Agents sebagai mitra integrasi yang menangani lapisan streaming media, dan ada jalur streaming Agent Development Kit jika Anda sudah membangun di atas ADK.
Sesi Python minimal di bawah ini membuka koneksi, mengirim satu giliran teks, dan menyalakan transkrip output agar Anda bisa membaca apa yang diucapkan model:
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
Jika Anda bermigrasi dari gemini-3.1-flash-live-preview, ubah string model dan hapus thinking_level atau thinking_config dari pengaturan Anda; siklus hidup giliran selebihnya identik. Live API secara default adalah server-ke-server, jadi klien browser dan mobile memerlukan token sementara.
Untuk panduan lengkap penangkapan audio, pemutaran, dan manajemen sesi, lihat tutorial Gemini Live API kami, dan untuk sisi teks dari keluarga yang sama, tutorial Gemini 3.8 Flash API kami membahas tingkat thinking dan pemanggilan fungsi di Python.
Google membuat pernyataan pada harga, bukan pada kualitas mentah. Keunggulan Extended Thinking atas GPT-Live-1 Astra hanya satu-dua poin di setiap papan, tetapi Gemini 3.8 Live di $0,84 per jam audio masukan hampir 7 kali lebih murah daripada model OpenAI, dan itulah angka yang menentukan ke mana trafik suara produksi akan pergi.
Pandangan saya: jika Anda menjalankan apa pun di Gemini 3.1 Flash Live, lakukan upgrade minggu ini, karena harganya sama dan pemanggilan alat async saja sudah sepadan. Jika Anda menjalankan tumpukan realtime OpenAI, model dasar layak dicoba untuk alur triase dan penelusuran, dan Extended Thinking layak dicoba di mana pun alat Anda butuh detik. Skor 30,1% model dasar pada τ-Voice adalah alasan untuk tidak menggunakannya pada pekerjaan agenik.
Jika Anda ingin membangun sisi pemanggilan alat dari agen suara dengan benar, saya merekomendasikan kursus Building AI Agents with Google ADK kami, yang memasang Gemini ke agen dukungan pelanggan dengan alat, pagar pengaman, dan delegasi.
Pelajari Agentic AI Bersama DataCamp!
Kursus
Kursus
Kursus