Last chance! 50% off DataCamp Premium
Sale ends in
Selama bertahun-tahun, menskalakan model AI sebagian besar berarti menambah parameter dan data pelatihan.
Meskipun pendekatan ini meningkatkan kinerja, biayanya juga naik tajam. Mixture of Experts (MoE) muncul sebagai solusi menjanjikan untuk tantangan ini, dengan menggunakan modul pakar yang diaktifkan secara jarang alih-alih lapisan feed-forward padat tradisional.
MoE berfungsi dengan mendelegasikan tugas ke berbagai pakar berdasarkan keahliannya pada topik tertentu. Setiap pakar dilatih secara intensif pada dataset spesifik untuk tujuan tertentu, dan komponen lain, yaitu jaringan pengalih (gating network), bertanggung jawab untuk mendelegasikan tugas-tugas ini.
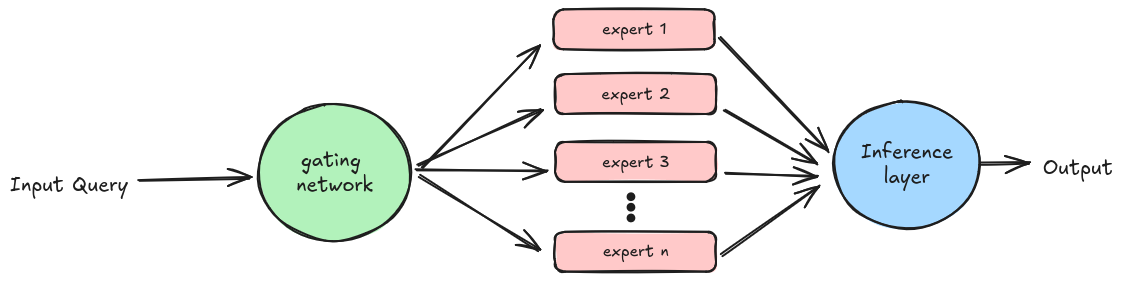
Meski model MoE mengungguli model tradisional dengan Feed-Forward Layers, efisiensinya bisa mencapai titik jenuh seiring pertumbuhan ukuran model karena keterbatasan penggunaan jumlah token pelatihan yang tetap.
Untuk mengatasi masalah ini dibutuhkan arsitektur berbutir halus dengan jumlah pakar yang besar. Namun, satu-satunya arsitektur yang ada yang mendukung lebih dari sepuluh ribu pakar, Mixture of Word Experts (MoWE), bersifat spesifik bahasa dan bergantung pada skema perutean yang tetap.
Mixture of A Million Experts (MoME), yang diperkenalkan dalam makalah ini, menanggapi tantangan tersebut dengan memperkenalkan arsitektur Parameter Efficient Expert Retrieval (PEER), yang menggunakan product key retrieval untuk perutean efisien ke sejumlah besar pakar.
Salah satu tantangan utama dalam menskalakan LLM terletak pada kebutuhan komputasi dan memori dari lapisan feedforward di dalam blok transformer. MoE mengatasinya dengan mengganti lapisan tersebut dengan modul pakar yang diaktifkan secara jarang, masing-masing mengkhusus pada aspek berbeda dari tugas. Pendekatan ini meningkatkan efisiensi dengan hanya mengaktifkan pakar yang relevan untuk masukan tertentu, sehingga mengurangi beban komputasi.
Pendekatan MoE saat ini memiliki keterbatasan, seperti router tetap yang perlu disesuaikan ulang ketika pakar baru ditambahkan. Karena itu, diperkenalkan pendekatan perutean baru dengan mengganti router tetap menggunakan indeks yang dipelajari.
Parameter Efficient Expert Retrieval (PEER) mengurangi jumlah parameter aktif di lapisan MoE, berdampak pada komputasi dan konsumsi memori aktivasi selama pra-pelatihan dan inferensi.
PEER menunjukkan bahwa dengan menerapkan mekanisme retrieval dan perutean yang tepat, MoE dapat diskalakan hingga jutaan pakar, sehingga menurunkan biaya dan kompleksitas pelatihan serta penyajian model bahasa yang sangat besar.
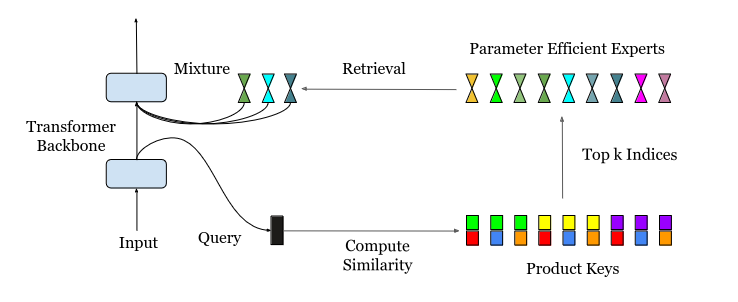
Pada diagram di atas, kueri masukan awalnya menjalani product key retrieval untuk mengidentifikasi k pakar teratas. Pakar yang dipilih ini kemudian memproses masukan berdasarkan pengetahuan spesialisnya, dan keluarannya dikombinasikan saat fase inferensi untuk menghasilkan keluaran akhir model.
Inovasi inti PEER adalah penggunaan product key retrieval. Tujuannya tetap sama seperti pada MoE tradisional: menemukan k pakar teratas yang paling cocok untuk tugas yang diberikan. Namun, dengan jumlah pakar yang sangat besar (berpotensi lebih dari satu juta), teknik sebelumnya menjadi mahal atau tidak efisien secara komputasi.
Bayangkan skenario dengan N pakar, masing-masing direpresentasikan oleh vektor berdimensi d. Menghitung langsung k pakar teratas akan melibatkan perhitungan kemiripan antara kueri masukan dan semua N kunci pakar, menghasilkan kompleksitas waktu sebesar O(Nd). Ketika N sangat besar (misalnya, N ≥ 10^6), ini menjadi sangat mahal.
PEER mengatasinya dengan strategi cerdas: alih-alih menggunakan N kunci pakar berdimensi d yang independen, setiap kunci dipecah menjadi dua subset independen, masing-masing berdimensi d/2. Demikian pula, vektor kueri dibagi menjadi dua sub-kueri. Operasi top-k kemudian diterapkan pada hasil kali dalam antara sub-kueri dan sub-kunci ini.
Struktur hasil kali Cartesian dari kunci-kunci ini secara drastis menurunkan kompleksitas komputasi dari O(Nd) menjadi O((N^.5+ k2)d), sehingga memungkinkan identifikasi k pakar teratas secara efisien bahkan dengan jumlah pakar yang masif.
Lapisan Parameter-Efficient Expert Retrieval (PEER) adalah arsitektur MoE yang menggunakan product key pada router dan MLP satu-neuron sebagai pakar.
Satu lapisan PEER terdiri dari tiga komponen:
Begini cara kerjanya:
Intinya, lapisan PEER secara efisien mengidentifikasi pakar yang paling relevan untuk masukan tertentu, sehingga memungkinkan pemanfaatan efektif jumlah pakar yang masif sambil menjaga keterkelolaan komputasi. Inovasi ini menjadi pemungkin kunci bagi penskalaan model MoE hingga jutaan pakar, membuka jalan bagi LLM yang lebih andal dan efisien.
PEER, bersama arsitektur MoME, menawarkan sejumlah keunggulan kuat dibanding pendekatan MoE tradisional, mendorong batas kapabilitas LLM:
Mixture-of-Experts sudah menjadi paradigma model yang banyak digunakan di industri, dengan perusahaan seperti YouTube yang mengintegrasikannya ke dalam sistem rekomendasi mereka. Masa depan MoME tampak serupa, dan sudah diisyaratkan di GTC 2024 milik Nvidia, saat mereka membahas model GPT 1,8 triliun.
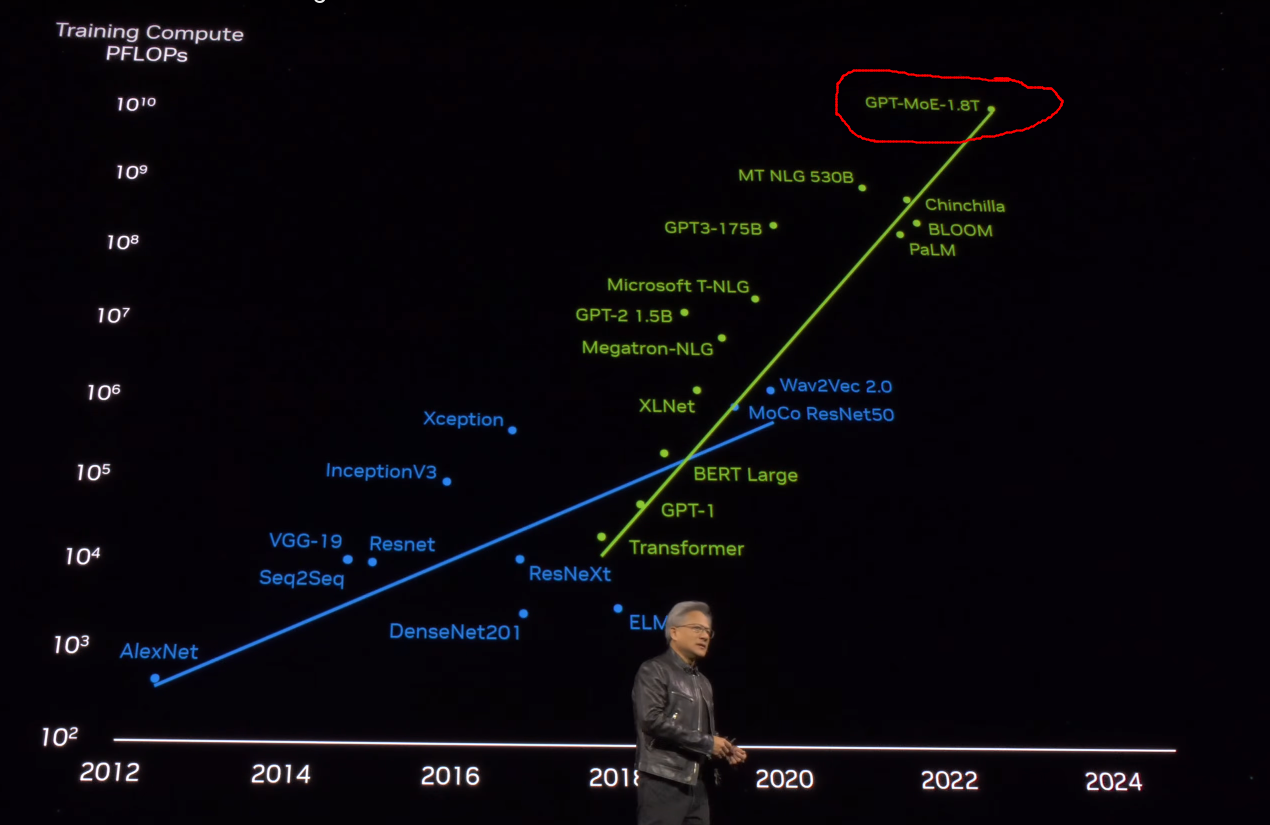
Mixture of Million Experts (MoME), dengan arsitektur PEER-nya, sangat menjanjikan untuk tugas NLP kompleks yang membutuhkan basis pengetahuan luas dan pengambilan respons yang cepat. Ini mengatasi tantangan skalabilitas yang melekat pada pelatihan dan penyajian model bahasa yang sangat besar, membuka kemungkinan baru untuk penggunaannya di bidang seperti visi komputer, pembuatan konten, sistem rekomendasi, dan komputasi cerdas.
Menskalakan model hingga sejuta pakar tampak menjanjikan dari sisi efisiensi, tetapi mengelola jaringan sebesar itu menghadirkan tantangan. Mari kita bahas beberapa di antaranya:
Dalam artikel ini, kita mengeksplorasi teknik Mixture of Million Experts (MoME), sebuah pendekatan yang dapat diskalakan untuk model bahasa besar.
MoME memanfaatkan jaringan pakar khusus dan mekanisme perutean PEER untuk meningkatkan efisiensi dan kinerja.
Kita membahas komponen inti, manfaat, dan aplikasi potensialnya. Untuk pendalaman lebih lanjut, rujuk ke makalah riset untuk detail teknis dan hasil benchmark.
Untuk informasi lebih lanjut, silakan merujuk ke makalah riset untuk detail teknis dan hasil benchmark.
Kembangkan aplikasi AI!
Program
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt