Last chance! 50% off DataCamp Premium
Sale ends in
Per anni, scalare i modelli di IA ha significato soprattutto aggiungere più parametri e dati di addestramento.
Se da un lato questo approccio migliora le prestazioni, dall'altro aumenta sensibilmente i costi computazionali. Mixture of Experts (MoE) è emersa come una soluzione promettente a questa sfida, usando moduli di esperti attivati in modo sparso al posto dei tradizionali strati feed-forward densi.
La MoE funziona delegando i compiti a diversi esperti in base alla loro competenza sull'argomento. Ogni esperto è addestrato in modo intensivo su un dataset specifico per svolgere un certo ruolo, e un altro componente, la rete di gating, si occupa di smistare questi compiti.
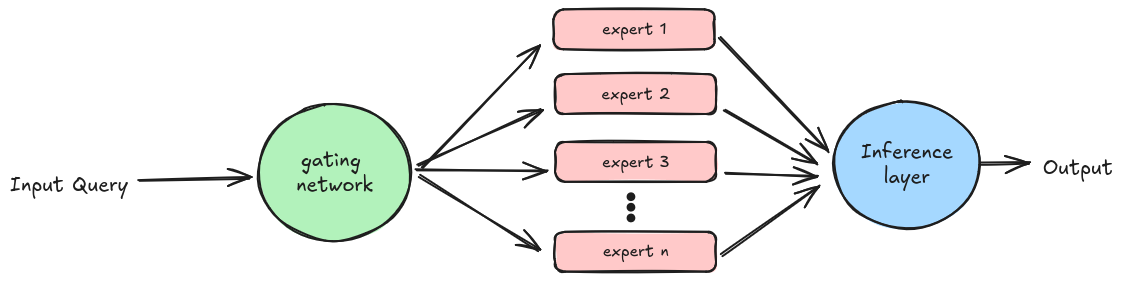
Sebbene i modelli MoE superino quelli tradizionali con strati Feed-Forward, la loro efficienza può appiattirsi man mano che le dimensioni del modello crescono, a causa dei limiti legati all'uso di un numero fisso di token di addestramento.
Per affrontare questo problema servono architetture ad alta granularità con un gran numero di esperti. Tuttavia, l'unica architettura esistente che supporta oltre diecimila esperti, la Mixture of Word Experts (MoWE), è specifica per la lingua e si basa su uno schema di instradamento fisso.
La Mixture of A Million Experts (MoME), introdotta in questo articolo, affronta la sfida introducendo l'architettura Parameter Efficient Expert Retrieval (PEER), che impiega il product key retrieval per instradare in modo efficiente verso un numero enorme di esperti.
Una delle principali sfide nello scalare gli LLM risiede nelle richieste computazionali e di memoria degli strati feedforward all'interno dei blocchi transformer. La MoE affronta questo problema sostituendo questi strati con moduli di esperti attivati in modo sparso, ognuno specializzato in aspetti diversi del compito. Questo approccio aumenta l'efficienza attivando solo gli esperti pertinenti per un determinato input, riducendo l'overhead computazionale.
Gli approcci attuali alla MoE presentano limiti, come router fissi che vanno riadattati quando si aggiungono nuovi esperti. Perciò viene introdotto un nuovo approccio all'instradamento, che sostituisce il router fisso con un indice appreso.
Parameter Efficient Expert Retrieval (PEER) riduce il numero di parametri attivi nello strato MoE, con impatto sul calcolo e sul consumo di memoria per le attivazioni durante il pre-training e l'inferenza.
PEER dimostra che, applicando i giusti meccanismi di retrieval e routing, la MoE può essere scalata fino a milioni di esperti, riducendo costi e complessità nell'addestramento e nel serving di modelli linguistici molto grandi.
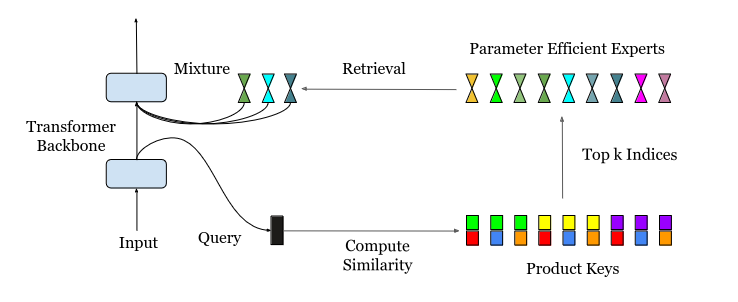
Nel diagramma sopra, la query in input inizialmente subisce il product key retrieval per identificare i migliori k esperti. Questi esperti selezionati poi elaborano l'input in base alle loro conoscenze specialistiche e, in fase di inferenza, i loro output vengono combinati per generare l'output finale del modello.
L'innovazione centrale di PEER è l'uso del product key retrieval. L'obiettivo resta quello della MoE tradizionale: trovare i migliori k esperti più adatti al compito dato. Tuttavia, con un numero enorme di esperti (potenzialmente superiore al milione), le tecniche precedenti diventano costose o inefficienti dal punto di vista computazionale.
Considera uno scenario con N esperti, ciascuno rappresentato da un vettore di dimensione d. Calcolare direttamente i migliori k esperti comporterebbe il calcolo della similarità tra la query in input e tutte le N chiavi degli esperti, con una complessità temporale di O(Nd). Quando N è molto grande (ad es., N ≥ 10^6), questo diventa proibitivo.
PEER affronta il problema con una strategia ingegnosa: invece di usare N chiavi di esperti d-dimensionali indipendenti, suddivide ciascuna chiave in due sottoinsiemi indipendenti, ciascuno di dimensionalità d/2. Analogamente, il vettore di query è diviso in due sotto-query. L'operazione di top-k viene quindi applicata ai prodotti interni tra queste sotto-query e le sotto-chiavi.
Questa struttura a prodotto cartesiano delle chiavi riduce drasticamente la complessità computazionale da O(Nd) a O((N^.5+ k2)d), rendendo praticabile l'identificazione efficiente dei migliori k esperti anche con un numero enorme di esperti.
Il livello Parameter-Efficient Expert Retrieval (PEER) è un'architettura MoE che usa product key nel router e MLP a singolo neurone come esperti.
Uno strato PEER è composto da tre componenti:
Ecco come funziona:
In sostanza, lo strato PEER identifica in modo efficiente gli esperti più rilevanti per un dato input, permettendo di sfruttare efficacemente un numero enorme di esperti mantenendo la trattabilità computazionale. Questa innovazione è un fattore chiave per scalare i modelli MoE a milioni di esperti, aprendo la strada a LLM più potenti ed efficienti.
PEER, insieme all'architettura MoME, offre diversi vantaggi convincenti rispetto agli approcci MoE tradizionali, spingendo oltre i confini delle capacità degli LLM:
La Mixture-of-Experts è già un paradigma di modello ampiamente utilizzato nel settore, con aziende come YouTube che l'hanno integrata nel loro sistema di raccomandazione. Il futuro di MoME sembra simile, e se ne è già accennato al GTC 2024 di Nvidia, quando si è parlato del modello da 1,8 trilioni di parametri di GPT.
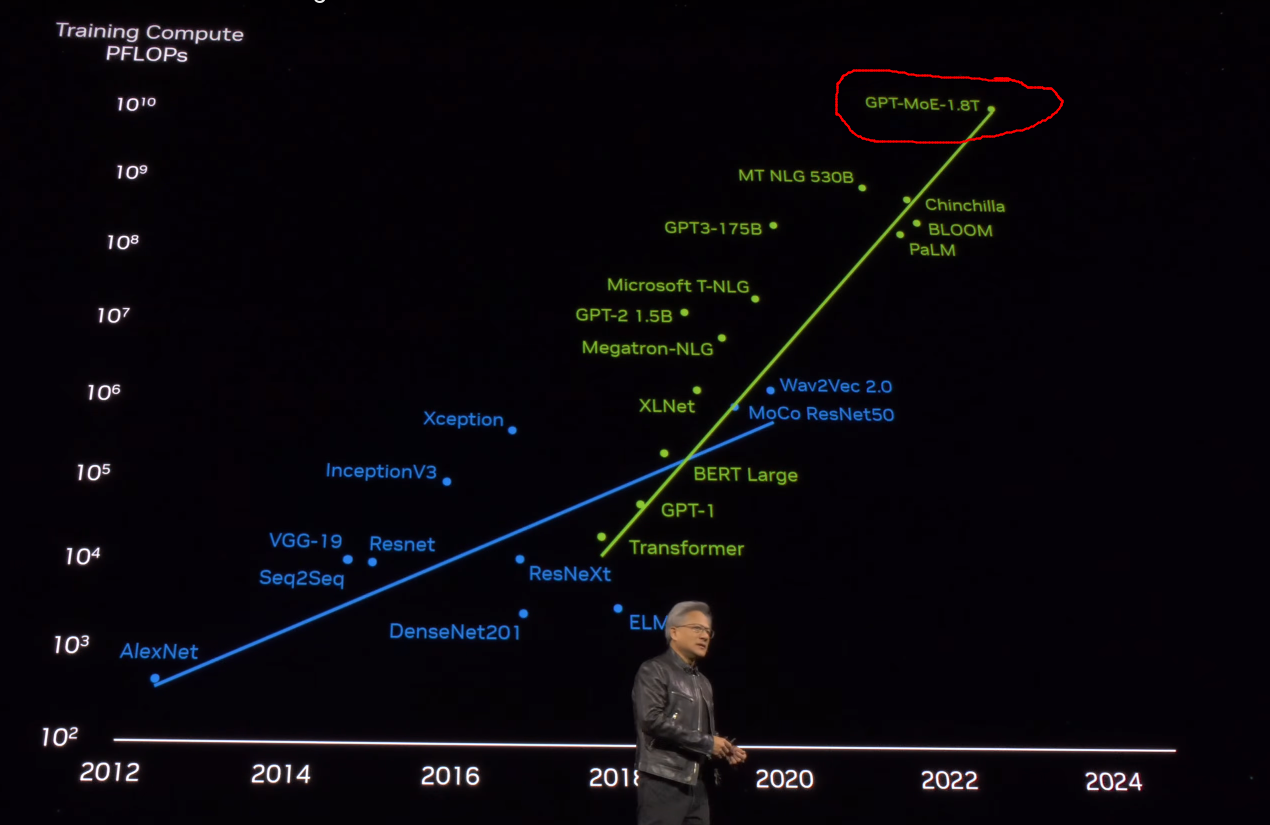
La Mixture of Million Experts (MoME), con la sua architettura PEER, mostra un potenziale particolare per compiti NLP complessi che richiedono un'ampia base di conoscenze e un recupero rapido delle risposte. Affronta le sfide di scalabilità insite nell'addestramento e nel serving di modelli linguistici molto grandi, aprendo nuove possibilità d'uso in ambiti come computer vision, generazione di contenuti, sistemi di raccomandazione e smart computing.
Scalare un modello fino a un milione di esperti è promettente in termini di efficienza, ma gestire una rete così grande comporta diverse sfide. Vediamone alcune:
In questo articolo abbiamo esplorato la tecnica Mixture of Million Experts (MoME), un approccio scalabile per i large language model.
MoME sfrutta reti di esperti specializzati e il meccanismo di routing PEER per migliorare efficienza e prestazioni.
Abbiamo discusso i suoi componenti principali, i vantaggi e le potenziali applicazioni. Per approfondire, consulta l'articolo di ricerca per i dettagli tecnici e i risultati dei benchmark.
Per ulteriori informazioni, fai riferimento all'articolo di ricerca per i dettagli tecnici e i risultati dei benchmark.
Sviluppa applicazioni di IA!
Programma
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min