Cursus
Développer des applications d'IA
21 h
Pendant des années, faire monter les modèles d’IA en puissance signifiait surtout ajouter des paramètres et des données d’entraînement.
Si cette approche améliore les performances, elle augmente aussi fortement les coûts de calcul. Mixture of Experts (MoE) s’impose comme une solution prometteuse à ce défi en remplaçant les couches denses feed-forward traditionnelles par des modules d’experts activés de façon clairsemée.
Le MoE fonctionne en déléguant les tâches à différents experts selon leur domaine de compétence. Chaque expert est fortement entraîné sur un jeu de données spécifique pour remplir un objectif précis, tandis qu’un autre composant, le réseau de contrôle (gating network), se charge de cette délégation.
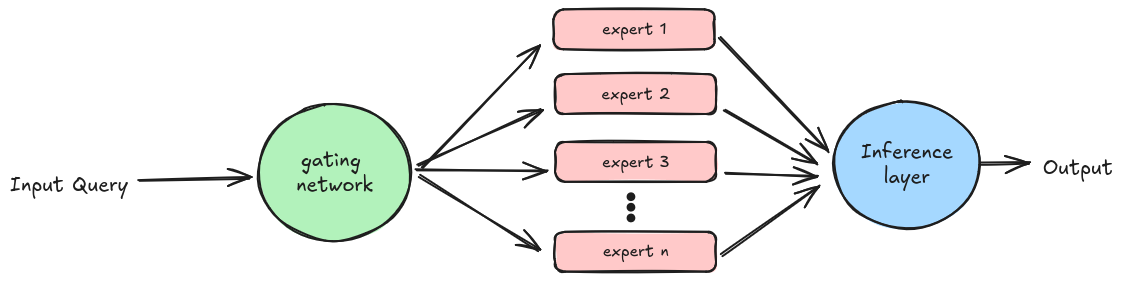
Si les modèles MoE surpassent les modèles traditionnels à couches feed-forward, leur efficacité peut plafonner à mesure que la taille du modèle croît, en raison des limites liées à un nombre fixe de jetons d’entraînement.
Pour y répondre, il faut des architectures à forte granularité avec un grand nombre d’experts. Or, la seule architecture existante prenant en charge plus de dix mille experts, la Mixture of Word Experts (MoWE), est spécifique à une langue et repose sur un schéma de routage fixe.
Mixture of A Million Experts (MoME), présenté dans cet article, relève ce défi en introduisant l’architecture Parameter Efficient Expert Retrieval (PEER), qui emploie une récupération par clés produits pour router efficacement vers un très grand nombre d’experts.
L’un des principaux défis de la mise à l’échelle des LLMs tient aux exigences de calcul et de mémoire des couches feed-forward au sein des blocs transformeurs. Le MoE y répond en remplaçant ces couches par des modules d’experts activés de manière clairsemée, chacun se spécialisant sur un aspect de la tâche. Cette approche gagne en efficacité en n’activant que les experts pertinents pour une entrée donnée, réduisant ainsi la charge de calcul.
Les approches MoE actuelles présentent des limites, comme des routeurs fixes qu’il faut réajuster à l’ajout de nouveaux experts. D’où une nouvelle approche de routage, qui remplace le routeur fixe par un index appris.
Parameter Efficient Expert Retrieval (PEER) réduit le nombre de paramètres actifs dans la couche MoE, affectant le calcul et la mémoire d’activation pendant le pré-entraînement et l’inférence.
PEER démontre qu’avec les bons mécanismes de récupération et de routage, le MoE peut passer à des millions d’experts, abaissant le coût et la complexité de l’entraînement et du déploiement de très grands modèles de langage.
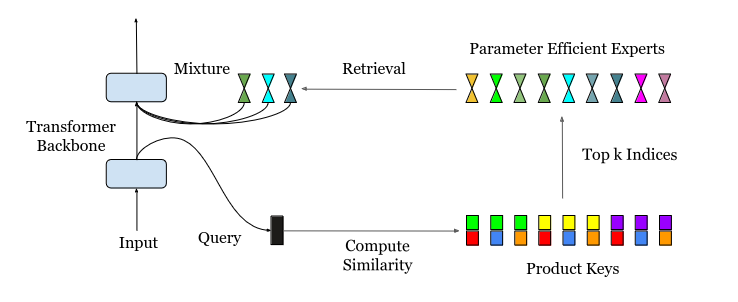
Dans le schéma ci-dessus, la requête d’entrée passe d’abord par la récupération par clés produits pour identifier les k meilleurs experts. Ces experts sélectionnés traitent ensuite l’entrée selon leur spécialité, et leurs sorties sont combinées lors de l’inférence pour produire la sortie finale du modèle.
L’innovation clé de PEER est l’usage de la récupération par clés produits. L’objectif reste le même que dans un MoE classique : trouver les k meilleurs experts pour la tâche donnée. Mais avec un nombre immense d’experts (potentiellement au-delà du million), les techniques précédentes deviennent coûteuses ou inefficaces.
Considérons un scénario avec N experts, chacun représenté par un vecteur de dimension d. Calculer directement les k meilleurs experts implique de mesurer la similarité entre la requête et les N clés d’experts, pour une complexité temporelle de O(Nd). Quand N est très grand (par ex. N ≥ 10^6), cela devient prohibitif.
PEER contourne ce problème par une stratégie astucieuse : plutôt que d’utiliser N clés d’experts indépendantes de dimension d, chaque clé est scindée en deux sous-ensembles indépendants de dimension d/2. De même, le vecteur de requête est divisé en deux sous-requêtes. L’opération top-k s’applique alors aux produits scalaires entre ces sous-requêtes et sous-clés.
Cette structure en produit cartésien des clés réduit fortement la complexité de O(Nd) à O((N^.5 + k2)d), rendant possible l’identification efficace des k meilleurs experts même avec un nombre massif d’experts.
La couche Parameter-Efficient Expert Retrieval (PEER) est une architecture MoE qui utilise des clés produits dans le routeur et des MLP à un seul neurone comme experts.
Une couche PEER comprend trois composants :
Fonctionnement :
En résumé, la couche PEER identifie efficacement les experts les plus pertinents pour une entrée donnée, permettant d’exploiter un nombre massif d’experts tout en restant calculatoirement maîtrisable. Cette innovation est un levier clé pour faire passer les modèles MoE à des millions d’experts et ouvrir la voie à des LLM plus puissants et plus efficients.
PEER, associé à l’architecture MoME, présente plusieurs avantages déterminants par rapport aux approches MoE classiques, repoussant les limites des LLM :
Le paradigme Mixture-of-Experts est déjà largement utilisé dans l’industrie ; YouTube, par exemple, l’intègre à son système de recommandation. L’avenir de MoME s’inscrit dans la même lignée, comme suggéré lors de Nvidia GTC 2024 avec la mention du modèle GPT à 1,8 billion de paramètres.
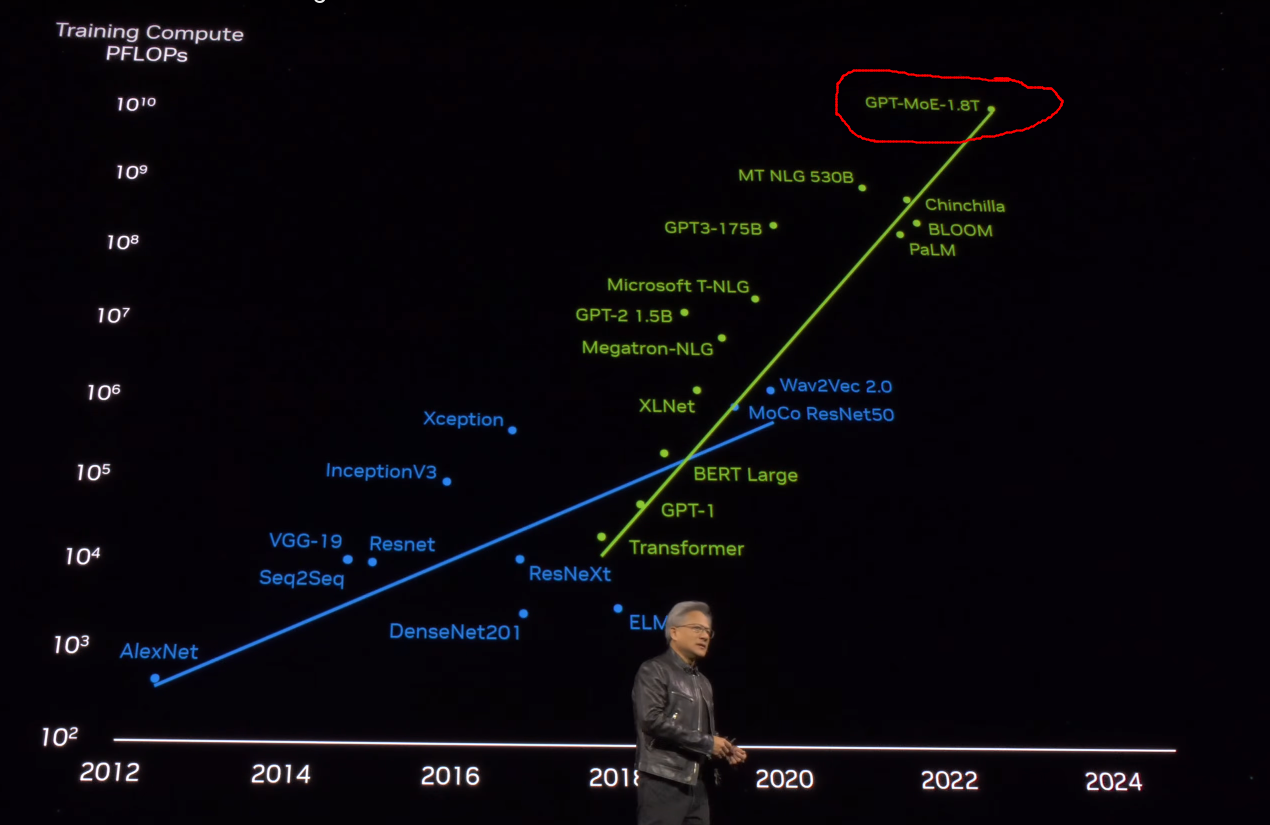
Mixture of Million Experts (MoME), avec son architecture PEER, est particulièrement prometteur pour des tâches NLP complexes nécessitant une base de connaissances étendue et une récupération rapide. Il répond aux défis de passage à l’échelle de l’entraînement et du service de très grands modèles de langage, et ouvre de nouvelles perspectives en vision par ordinateur, génération de contenu, systèmes de recommandation et informatique embarquée.
Faire grimper un modèle jusqu’à un million d’experts semble prometteur en termes d’efficacité, mais gérer un réseau d’une telle ampleur comporte des défis. En voici quelques-uns :
Dans cet article, nous avons exploré la technique Mixture of Million Experts (MoME), une approche extensible pour les grands modèles de langage.
MoME s’appuie sur des réseaux d’experts spécialisés et sur le mécanisme de routage PEER pour améliorer l’efficacité et les performances.
Nous avons passé en revue ses composants clés, ses bénéfices et ses applications potentielles. Pour aller plus loin, consultez l’article de recherche pour les détails techniques et les résultats de benchmarks.
Pour plus d’informations, reportez-vous à l’article de recherche pour les détails techniques et les résultats de benchmarks.
Concevez des applications d’IA !
Cursus
Cours
Cours