लर्निंग पाथ
एआई अनुप्रयोग विकसित करना
21 घंटा
कई वर्षों तक, AI मॉडलों को स्केल करने का अर्थ ज्यादातर अधिक पैरामीटर और प्रशिक्षण डेटा जोड़ना रहा है।
यह तरीका प्रदर्शन तो बेहतर करता है, लेकिन इसके साथ संगणनात्मक लागत भी काफी बढ़ जाती है। Mixture of Experts (MoE) इस चुनौती का समाधान पेश करने के लिए उभरा है, जो पारंपरिक सघन फीड-फॉरवर्ड लेयर्स की बजाय विरल रूप से सक्रिय विशेषज्ञ मॉड्यूल का इस्तेमाल करता है।
MoE, विषय में विशेषज्ञता के आधार पर कार्यों को अलग-अलग विशेषज्ञों को सौंपकर काम करता है। हर विशेषज्ञ किसी विशिष्ट डेटासेट पर गहन रूप से प्रशिक्षित होता है ताकि वह एक खास उद्देश्य की पूर्ति कर सके, और एक अन्य घटक, गेटिंग नेटवर्क, इन कार्यों के आवंटन के लिए जिम्मेदार होता है।
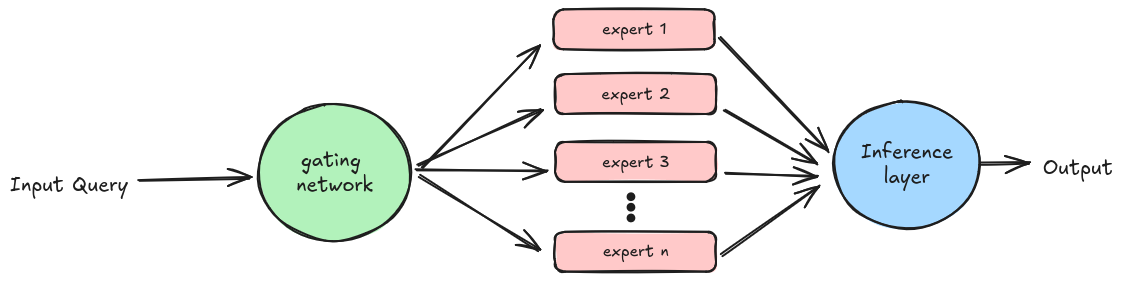
हालाँकि MoE मॉडल फीड-फॉरवर्ड लेयर्स वाले पारंपरिक मॉडलों से बेहतर प्रदर्शन करते हैं, लेकिन निश्चित संख्या के प्रशिक्षण टोकन के उपयोग की सीमा के कारण मॉडल का आकार बढ़ने पर उनकी कुशलता ठहर सकती है।
इस समस्या का समाधान उच्च-ग्रैन्युलैरिटी वाली आर्किटेक्चर के जरिए, अधिक संख्या में विशेषज्ञों के साथ, किया जा सकता है। लेकिन दस हजार से अधिक विशेषज्ञों का समर्थन करने वाली मौजूदा एकमात्र आर्किटेक्चर, Mixture of Word Experts (MoWE), भाषा-विशिष्ट है और एक तय रूटिंग योजना पर निर्भर करती है।
ए मिलियन एक्सपर्ट्स का मिश्रण (MoME), जिसे इस पेपर में पेश किया गया है, इस चुनौती का समाधान Parameter Efficient Expert Retrieval (PEER) आर्किटेक्चर के जरिए करता है, जो बड़े पैमाने पर विशेषज्ञों तक कुशल रूटिंग के लिए प्रोडक्ट-की रिट्रीवल का उपयोग करता है।
LLMs को स्केल करने में एक प्रमुख चुनौती ट्रांसफॉर्मर ब्लॉक्स के भीतर फीडफॉरवर्ड लेयर्स की संगणना और मेमोरी मांगों में निहित है। MoE इन लेयर्स को विरल रूप से सक्रिय विशेषज्ञ मॉड्यूल से प्रतिस्थापित करके इसका समाधान करता है, जिनमें से हर एक कार्य के अलग-अलग पहलुओं में विशेषज्ञता रखता है। यह तरीका किसी दिए गए इनपुट के लिए केवल प्रासंगिक विशेषज्ञों को सक्रिय करके दक्षता बढ़ाता है और संगणनात्मक ओवरहेड को घटाता है।
वर्तमान MoE तरीकों में सीमाएँ हैं, जैसे फिक्स्ड राउटर जिन्हें नए विशेषज्ञ जोड़ते समय दोबारा समायोजित करना पड़ता है। इसलिए, रूटिंग का एक नया तरीका पेश किया गया है, जो फिक्स्ड राउटर को एक लर्न्ड इंडेक्स से बदलता है।
Parameter Efficient Expert Retrieval (PEER) MoE लेयर में सक्रिय पैरामीटरों की संख्या कम करता है, जो प्री-ट्रेनिंग और इन्फरेंस के दौरान गणना और एक्टिवेशन मेमोरी खपत को प्रभावित करता है।
PEER दर्शाता है कि सही रिट्रीवल और रूटिंग मैकेनिज्म लागू करके, MoE को लाखों विशेषज्ञों तक स्केल किया जा सकता है, जिससे बहुत बड़े भाषा मॉडलों के प्रशिक्षण और परिनियोजन की लागत और जटिलता कम होती है।
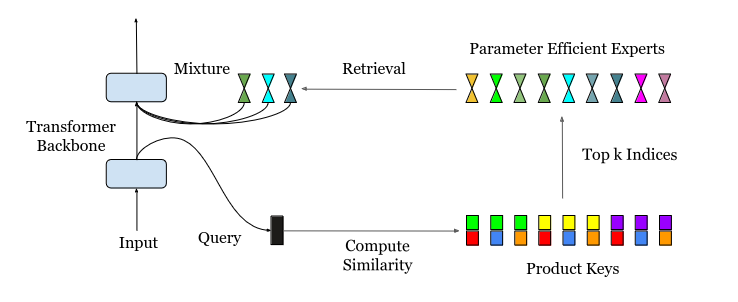
ऊपर दिए गए आरेख में, इनपुट क्वेरी पहले प्रोडक्ट-की रिट्रीवल से गुजरती है ताकि शीर्ष k विशेषज्ञों की पहचान की जा सके। ये चयनित विशेषज्ञ फिर अपनी विशिष्ट जानकारी के आधार पर इनपुट को संसाधित करते हैं, और इन्फरेंस चरण के दौरान उनके आउटपुट्स को मिलाकर अंतिम मॉडल आउटपुट उत्पन्न किया जाता है।
PEER का मूल नवाचार प्रोडक्ट-की रिट्रीवल का उपयोग है। लक्ष्य पारंपरिक MoE जैसा ही है: दिए गए कार्य के लिए सर्वाधिक उपयुक्त शीर्ष k विशेषज्ञों को खोजना। लेकिन जब विशेषज्ञों की संख्या बहुत अधिक हो जाती है (संभवतः एक मिलियन से भी अधिक), तो पिछली तकनीकें संगणनात्मक रूप से महंगी या अक्षम हो जाती हैं।
एक ऐसे परिदृश्य पर विचार करें जिसमें N विशेषज्ञ हों, जिनमें से प्रत्येक को d-आयामी वेक्टर द्वारा दर्शाया गया हो। सीधे शीर्ष k विशेषज्ञों की गणना के लिए इनपुट क्वेरी और सभी N विशेषज्ञ कीज के बीच समानता निकालनी होगी, जिसकी समय जटिलता O(Nd) होगी। जब N बहुत बड़ा हो (जैसे, N ≥ 10^6), तो यह लागत अत्यधिक हो जाती है।
PEER इस समस्या को एक चतुर रणनीति से हल करता है: N स्वतंत्र d-आयामी विशेषज्ञ कीज का उपयोग करने के बजाय, यह हर की को दो स्वतंत्र उप-समुच्चयों में बाँट देता है, जिनकी आयामिकता d/2 होती है। इसी तरह, क्वेरी वेक्टर को भी दो उप-क्वेरियों में विभाजित किया जाता है। फिर इन उप-क्वेरियों और उप-कीज के बीच के इनर प्रोडक्ट्स पर टॉप-k ऑपरेशन लागू किया जाता है।
कीज की यह कार्टेशियन प्रोडक्ट संरचना संगणनात्मक जटिलता को O(Nd) से घटाकर O((N^.5+ k2)d) कर देती है, जिससे बहुत बड़ी संख्या में विशेषज्ञों के बावजूद शीर्ष k विशेषज्ञों की कुशल पहचान संभव हो जाती है।
Parameter-Efficient Expert Retrieval (PEER) लेयर एक MoE आर्किटेक्चर है जो राउटर में प्रोडक्ट कीज और विशेषज्ञों के रूप में सिंगल-न्यूरॉन MLPs का उपयोग करता है।
एक PEER लेयर तीन घटकों से मिलकर बनी होती है:
यह ऐसे काम करता है:
सार रूप में, PEER लेयर किसी दिए गए इनपुट के लिए सबसे प्रासंगिक विशेषज्ञों की कुशल पहचान करती है, जिससे विशाल संख्या में विशेषज्ञों का प्रभावी उपयोग करते हुए संगणनात्मक व्यवहार्यता बनी रहती है। यह नवाचार MoE मॉडलों को लाखों विशेषज्ञों तक स्केल करने का प्रमुख साधन है, जो और अधिक शक्तिशाली और दक्ष LLMs का मार्ग प्रशस्त करता है।
MoME आर्किटेक्चर के साथ मिलकर PEER, पारंपरिक MoE तरीकों की तुलना में कई ठोस लाभ प्रदान करता है, जिससे LLM की क्षमताओं की सीमाएँ आगे बढ़ती हैं:
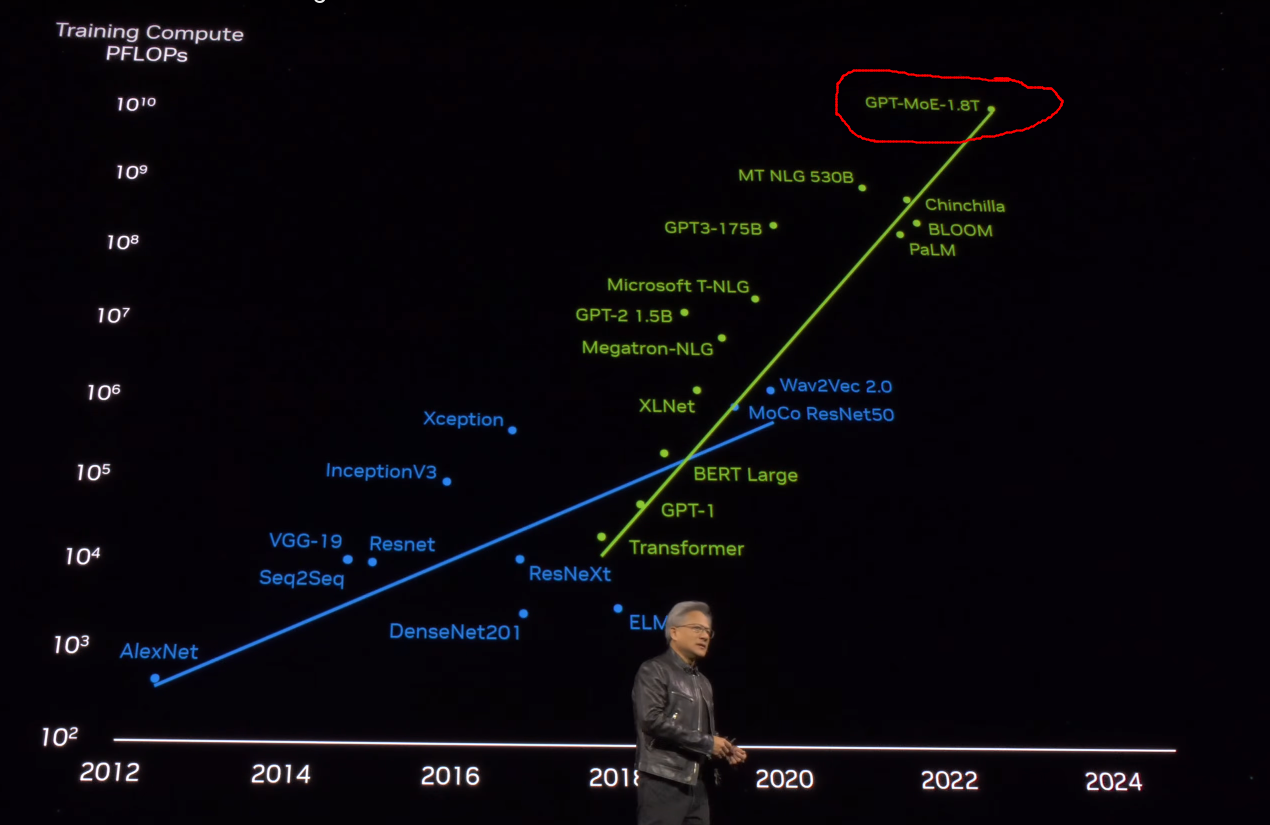
Mixture-of-Experts पहले से ही उद्योग में व्यापक रूप से प्रयुक्त मॉडल प्रतिमान है, जहाँ YouTube जैसी कंपनियाँ इसे अपनी अनुशंसा प्रणाली में एकीकृत कर रही हैं। MoME का भविष्य भी ऐसा ही दिखता है, और इसका संकेत Nvidia के GTC 2024 में तब मिला जब उन्होंने GPT के 1.8 ट्रिलियन मॉडल की बात की।
Mixture of Million Experts (MoME), अपनी PEER आर्किटेक्चर के साथ, उन जटिल NLP कार्यों के लिए विशेष रूप से आशाजनक है जिनमें व्यापक ज्ञान-आधार और तेज़ रेस्पॉन्स रिट्रीवल की आवश्यकता होती है। यह बहुत बड़े भाषा मॉडलों के प्रशिक्षण और परिनियोजन में निहित स्केलेबिलिटी चुनौतियों को संबोधित करता है, और कंप्यूटर विज़न, कंटेंट जनरेशन, अनुशंसा प्रणालियों और स्मार्ट कंप्यूटिंग जैसे क्षेत्रों में उनके उपयोग की नई संभावनाएँ खोलता है।
किसी मॉडल को एक मिलियन विशेषज्ञों तक स्केल करना दक्षता के दृष्टिकोण से आशाजनक लगता है, लेकिन इतने बड़े नेटवर्क का प्रबंधन अपनी चुनौतियाँ लेकर आता है। आइए इनमें से कुछ पर नज़र डालें:
इस लेख में, हमने Mixture of Million Experts (MoME) तकनीक का अध्ययन किया, जो बड़े भाषा मॉडलों के लिए एक स्केलेबल दृष्टिकोण है।
MoME विशिष्ट विशेषज्ञ नेटवर्क और PEER रूटिंग मैकेनिज्म का लाभ उठाकर दक्षता और प्रदर्शन में सुधार करता है।
हमने इसके मुख्य घटकों, फायदों और संभावित अनुप्रयोगों पर चर्चा की। और गहराई से जानने के लिए, तकनीकी विवरण और बेंचमार्क परिणामों हेतु शोध-पत्र देखें।
अधिक जानकारी के लिए, तकनीकी विवरण और बेंचमार्क परिणामों हेतु शोध-पत्र देखें।
AI एप्लिकेशन विकसित करें!
लर्निंग पाथ
कोर्स
कोर्स