Leerpad
AI-toepassingen ontwikkelen
21 uur
Jarenlang betekende het opschalen van AI-modellen vooral: meer parameters en meer trainingsdata toevoegen.
Hoewel deze aanpak de prestaties verbetert, verhoogt hij ook de rekenkosten aanzienlijk. Mixture of Experts (MoE) is naar voren gekomen als een veelbelovende oplossing voor deze uitdaging, door spaarzaam geactiveerde expertmodules te gebruiken in plaats van traditionele dichte feedforward-lagen.
MoE werkt door taken toe te wijzen aan verschillende experts op basis van hun expertise in het onderwerp. Elke expert is intensief getraind op een specifieke dataset voor een bepaald doel, en een ander onderdeel, het gating-netwerk, is verantwoordelijk voor het toewijzen van deze taken.
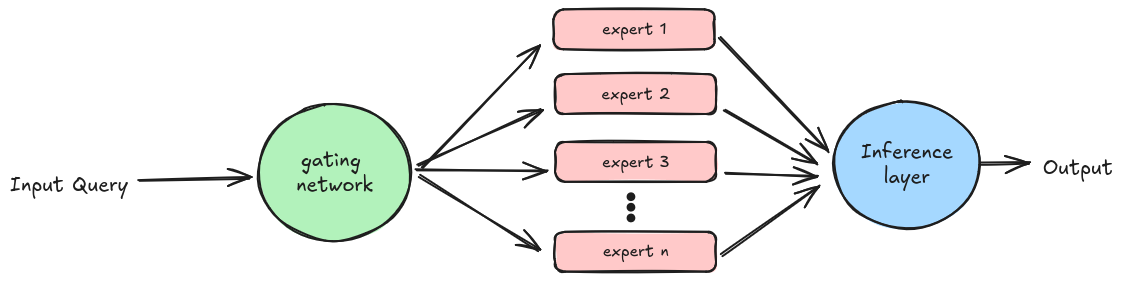
Hoewel MoE-modellen traditionele modellen met Feed-Forward Layers overtreffen, kan hun efficiëntie stagneren naarmate de modelgrootte toeneemt vanwege de beperkingen van een vast aantal trainingstokens.
Om dit aan te pakken zijn architecturen met hoge granulariteit en een groot aantal experts nodig. De enige bestaande architectuur die meer dan tienduizend experts ondersteunt, de Mixture of Word Experts (MoWE), is echter taalspecifiek en berust op een vast routeringsschema.
De Mixture of A Million Experts (MoME), geïntroduceerd in dit paper, pakt deze uitdaging aan met de Parameter Efficient Expert Retrieval (PEER)-architectuur, die product key retrieval inzet voor efficiënte routering naar een zeer groot aantal experts.
Een van de grootste uitdagingen bij het opschalen van LLM’s ligt in de reken- en geheugenvraag van feedforward-lagen binnen transformerblokken. MoE pakt dit aan door deze lagen te vervangen door spaarzaam geactiveerde expertmodules, die elk in verschillende aspecten van de taak zijn gespecialiseerd. Deze aanpak verhoogt de efficiëntie door alleen relevante experts voor een gegeven invoer te activeren, waardoor de rekenslast afneemt.
Huidige MoE-benaderingen hebben beperkingen, zoals vaste routers die opnieuw moeten worden afgesteld wanneer er nieuwe experts worden toegevoegd. Daarom wordt een nieuwe routeringsaanpak geïntroduceerd, waarbij de vaste router wordt vervangen door een geleerde index.
Parameter Efficient Expert Retrieval (PEER) vermindert het aantal actieve parameters in de MoE-laag, wat invloed heeft op de rekentijd en het activatiegeheugen tijdens pretraining en inferentie.
PEER laat zien dat MoE, met de juiste retrieval- en routeringsmechanismen, opgeschaald kan worden naar miljoenen experts, waardoor de kosten en complexiteit van het trainen en uitrollen van zeer grote taalmodellen dalen.
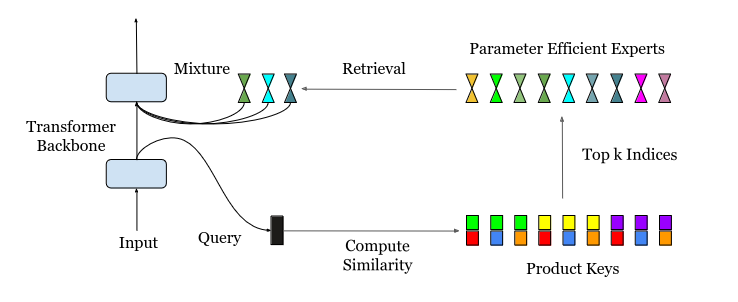
In het diagram hierboven ondergaat de invoervraag eerst product key retrieval om de beste k experts te identificeren. Deze geselecteerde experts verwerken vervolgens de invoer op basis van hun gespecialiseerde kennis, en hun outputs worden tijdens de inferentiefase gecombineerd om de uiteindelijke modeluitvoer te genereren.
De kerninnovatie van PEER is het gebruik van product key retrieval. Het doel blijft hetzelfde als bij traditionele MoE: de beste k experts vinden voor de gegeven taak. Maar met een enorm aantal experts (mogelijk meer dan een miljoen) worden eerdere technieken rekentechnisch duur of inefficiënt.
Stel een scenario voor met N experts, elk weergegeven door een d-dimensionale vector. Het direct bepalen van de top-k experts vereist het berekenen van de gelijkenis tussen de invoervraag en alle N experttokens, wat resulteert in een tijdcomplexiteit van O(Nd). Wanneer N zeer groot is (bijv. N ≥ 10^6), wordt dit onbetaalbaar duur.
PEER pakt dit aan met een slimme strategie: in plaats van N onafhankelijke d-dimensionale expertsleutels te gebruiken, splitst het elke sleutel in twee onafhankelijke deelsets met elk dimensionaliteit d/2. Ook de queryvector wordt opgedeeld in twee deelqueries. De top-k-bewerking wordt vervolgens toegepast op de inwendige producten tussen deze deelqueries en deelsleutels.
Deze Cartesiaanse productstructuur van de sleutels vermindert de rekencomplexiteit drastisch van O(Nd) naar O((N^.5+ k2)d), waardoor het haalbaar wordt om zelfs bij een enorme hoeveelheid experts efficiënt de top-k te vinden.
De Parameter-Efficient Expert Retrieval (PEER)-laag is een MoE-architectuur die product keys in de router gebruikt en MLP’s met één neuron als experts.
Een PEER-laag bestaat uit drie componenten:
Zo werkt het:
Kortom, de PEER-laag identificeert efficiënt de meest relevante experts voor een gegeven invoer, waardoor een enorme hoeveelheid experts effectief benut kan worden terwijl de rekentracteerbaarheid behouden blijft. Deze innovatie maakt het mogelijk MoE-modellen naar miljoenen experts op te schalen en effent de weg voor krachtigere en efficiëntere LLM’s.
PEER, in combinatie met de MoME-architectuur, biedt verschillende overtuigende voordelen ten opzichte van traditionele MoE-benaderingen en verlegt de grenzen van wat LLM’s kunnen:
Mixture-of-Experts is al een veelgebruikt modelparadigma in de industrie; zo heeft YouTube het geïntegreerd in zijn aanbevelingssysteem. De toekomst van MoME ziet er vergelijkbaar uit, en er werd al naar gehint tijdens Nvidia’s GTC 2024, toen ze spraken over GPT’s 1,8 biljoen-model.
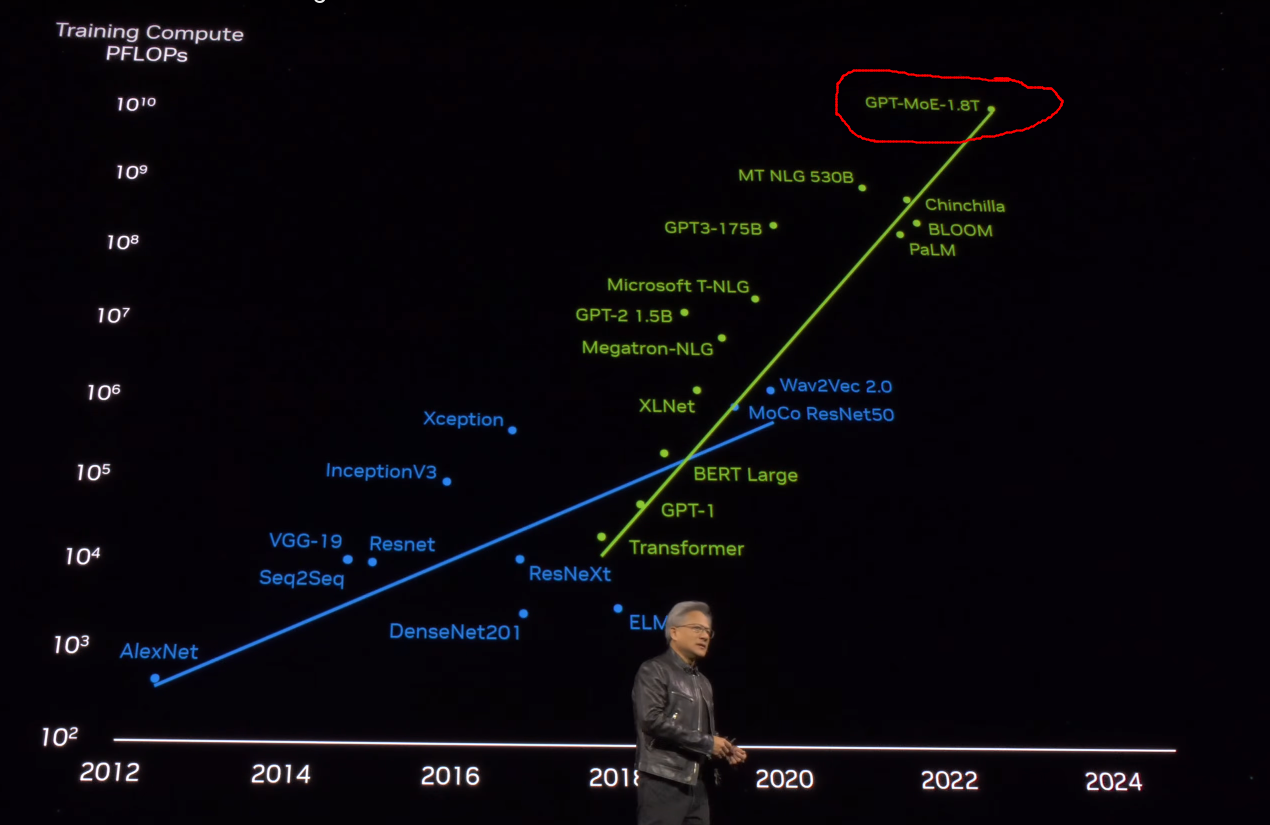
Mixture of Million Experts (MoME), met zijn PEER-architectuur, is veelbelovend voor complexe NLP-taken die een brede kennisbasis en snelle responsretrieval vereisen. Het pakt de schaalbaarheidsuitdagingen aan die inherent zijn aan het trainen en uitrollen van zeer grote taalmodellen, en opent nieuwe mogelijkheden voor gebruik in domeinen als computervisie, contentgeneratie, aanbevelingssystemen en smart computing.
Een model opschalen naar een miljoen experts lijkt veelbelovend qua efficiëntie, maar het beheren van zo’n groot netwerk brengt uitdagingen met zich mee. Laten we er een paar bekijken:
In dit artikel hebben we de Mixture of Million Experts (MoME)-techniek verkend, een schaalbare aanpak voor grote taalmodellen.
MoME benut gespecialiseerde expertnetwerken en het PEER-routeringsmechanisme om efficiëntie en prestaties te verbeteren.
We bespraken de kernonderdelen, voordelen en potentiële toepassingen. Voor meer diepgang kun je het onderzoekspaper raadplegen voor technische details en benchmarkresultaten.
Voor meer informatie, raadpleeg het onderzoekspaper voor technische details en benchmarkresultaten.
Ontwikkel AI-applicaties!
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

