
Lewati ke konten utama

14 Alat Penting untuk Data Engineering yang Digunakan pada 2026

Pelajari alat terbaik untuk kontainerisasi, infrastruktur sebagai kode (IaC), manajemen alur kerja, gudang data, rekayasa analitik, pemrosesan batch, dan streaming data.
Diperbarui 28 Sep 2026  · 10 mnt Baca

Jelajahi bersama AI

ChatGPTClaudePerplexity

Data engineer bertanggung jawab membuat pipeline data yang dapat mengumpulkan, memproses, dan mengirimkan data ke berbagai titik akhir, seperti database, gudang data, dan platform analitik. Dengan membangun dan memelihara pipeline data ini, data engineer memungkinkan data scientist dan analis mengakses data real-time untuk analisis dan pengambilan keputusan.

Data engineer modern diharapkan melakukan lebih banyak tugas. Mereka juga harus memelihara dan menerapkan solusi data, mengelola alur kerja, mengawasi gudang data, mentransformasi dan memvisualisasikan data, serta menggunakan berbagai alat pemrosesan batch dan streaming untuk mengoptimalkan, mengumpulkan, dan memproses berbagai jenis data.

Pelajari apa itu data engineering, bagaimana bedanya dengan data science, cakupannya, dan cara mempelajarinya dengan membaca panduan kami, What is Data Engineering?
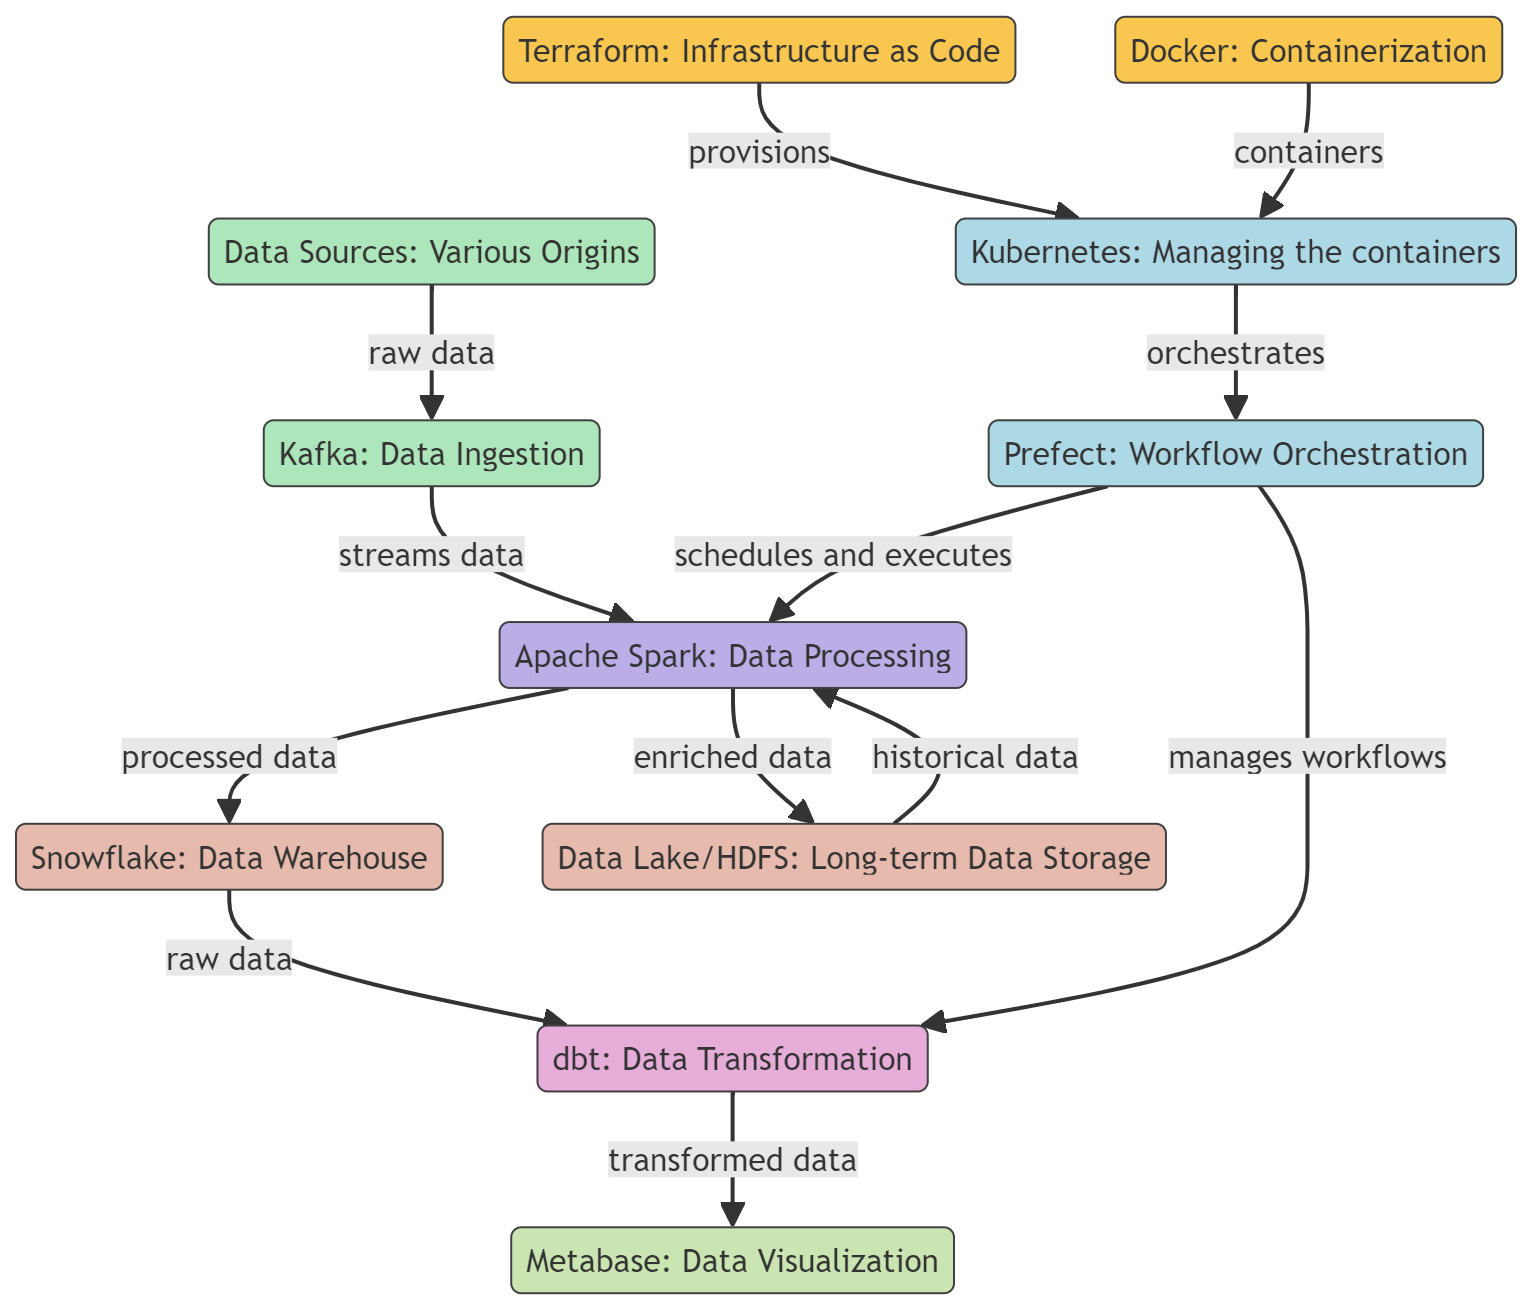
Alat Data Engineer

Dalam artikel ini, kita akan mempelajari alat-alat penting yang populer dan kadang diperlukan bagi data engineer. Alat-alat ini digunakan untuk pengambilan, pemrosesan, penyimpanan, transformasi, dan visualisasi data. Selain itu, kita juga akan melihat alat untuk kontainerisasi dan manajemen alur kerja.

Pelajari keterampilan inti data engineering dengan membaca blog kami How to Become a Data Engineer.

Alat Kontainerisasi

Alat kontainerisasi menyediakan cara standar untuk mengemas, mendistribusikan, dan mengelola aplikasi di berbagai lingkungan. Ini memastikan konsistensi, skalabilitas, dan efisiensi alur kerja data engineering.

1. Docker

Docker adalah platform kontainerisasi populer yang sering digunakan dalam data engineering untuk mengembangkan, mengirim, dan menjalankan alat serta aplikasi data. Ini menyediakan cara yang ringan, portabel, dan konsisten untuk mengemas dan menerapkan alat serta aplikasi data, sehingga menjadi pilihan ideal bagi data engineer.

Docker dapat digunakan untuk membuat dan mengelola container bagi berbagai alat data, seperti database, gudang data, kerangka kerja pemrosesan data, dan alat visualisasi data. Lihat tutorial Docker for Data Science kami untuk mempelajari lebih lanjut.

2. Kubernetes

Kubernetes adalah platform open-source untuk mengotomatiskan penerapan, penskalaan, dan pengelolaan aplikasi yang dikontainerisasi, termasuk yang dibangun menggunakan Docker.

Docker adalah alat yang dapat digunakan untuk mengemas aplikasi pemrosesan data, database, dan alat analitik ke dalam container. Ini memastikan konsistensi lingkungan dan mengisolasi aplikasi. Setelah container dibuat, Kubernetes mengambil alih untuk mengelolanya dengan menangani penerapan, penskalaan berdasarkan beban kerja, dan memastikan ketersediaan tinggi.

Pelajari lebih lanjut tentang Kontainerisasi menggunakan Docker dan Kubernetes dalam artikel terpisah.

Alat Infrastruktur sebagai Kode

Infrastructure as Code (IaC) menyederhanakan penerapan dan pemeliharaan infrastruktur cloud dengan memanfaatkan bahasa pemrograman tujuan umum atau konfigurasi YAML. Pendekatan ini mendorong terciptanya lingkungan yang konsisten, dapat diulang, dan otomatis, sehingga memudahkan transisi antara fase pengembangan, pengujian, dan produksi.

3. Terraform

Terraform adalah alat infrastruktur sebagai kode (IaC) open-source yang dibuat oleh HashiCorp. Ini memungkinkan data engineer mendefinisikan dan menerapkan infrastruktur data, seperti database dan pipeline data, secara konsisten dan andal menggunakan bahasa konfigurasi deklaratif, yang menggambarkan kondisi akhir infrastruktur yang diinginkan alih-alih langkah-langkah yang diperlukan untuk mencapainya.

Terraform mendukung kontrol versi, manajemen sumber daya melalui kode, kolaborasi tim, serta integrasi dengan berbagai alat dan platform.

4. Pulumi

Pulumi adalah alat infrastruktur sebagai kode open-source yang memungkinkan pengembang membuat, menerapkan, dan mengelola infrastruktur cloud menggunakan bahasa pemrograman tujuan umum seperti JavaScript, TypeScript, Java, Python, Go, dan C#. Ini mendukung beragam penyedia cloud, termasuk AWS, Azure, GCP, dan Kubernetes.

Kerangka kerja Pulumi menyediakan antarmuka baris perintah (CLI) yang dapat diunduh, perangkat pengembangan perangkat lunak (SDK), dan mesin penerapan untuk menghadirkan platform yang tangguh dalam penyediaan, pembaruan, dan pengelolaan infrastruktur cloud.

Alat Orkestrasi Alur Kerja

Alat orkestrasi alur kerja mengotomatiskan dan mengelola eksekusi alur kerja pemrosesan data yang kompleks, memastikan tugas dijalankan dalam urutan yang benar sambil mengelola ketergantungan.

5. Prefect

Prefect adalah alat orkestrasi alur kerja open-source untuk alur kerja data modern dan proses ETL (extract, transform, load). Ini membantu data engineer dan data scientist mengotomatiskan dan mengelola pipeline data yang kompleks, memastikan aliran data dari sumber ke tujuan berjalan mulus dengan andal dan efisien.

Prefect menawarkan model eksekusi hibrida yang menggabungkan keunggulan manajemen berbasis cloud dengan keamanan dan kontrol eksekusi lokal. UI yang ramah pengguna dan API yang kaya memudahkan pemantauan dan pemecahan masalah alur kerja data.

6. Luigi

Luigi adalah paket Python open-source yang membantu Anda membangun pipeline data yang kompleks untuk job batch berdurasi lama. Dikembangkan oleh Spotify untuk menangani resolusi ketergantungan, manajemen alur kerja, visualisasi, penanganan kegagalan, dan integrasi baris perintah.

Luigi dirancang untuk mengelola berbagai tugas, termasuk pemrosesan data, validasi data, dan agregasi data, dan dapat digunakan untuk membangun alur kerja data yang sederhana maupun canggih. Luigi dapat diintegrasikan dengan berbagai alat dan platform, seperti Apache Hadoop dan Apache Spark, memungkinkan pengguna membuat pipeline data untuk memproses dan menganalisis data dalam jumlah besar.

Alat Gudang Data

Gudang data menawarkan solusi berbasis cloud yang sangat skalabel untuk menyimpan, mengkueri, dan mengelola himpunan data besar.

7. Snowflake

Snowflake adalah gudang data berbasis cloud yang memungkinkan penyimpanan, pemrosesan, dan kueri analitik atas data dalam jumlah besar. Ini didasarkan pada arsitektur unik yang memisahkan storage dan compute, sehingga keduanya dapat diskalakan secara independen.

Snowflake dapat menyesuaikan jumlah sumber daya komputasi secara dinamis berdasarkan permintaan. Ini memastikan kueri diproses secara tepat waktu, efisien, dan hemat biaya. Kompatibel dengan penyedia cloud besar, seperti AWS, GCP, dan Azure.

Lihat kursus Introduction to Snowflake kami untuk menjelajahi alat ini lebih detail.

8. PostgreSQL

PostgreSQL adalah sistem manajemen basis data relasional (RDBMS) open-source yang tangguh dan juga dapat digunakan sebagai gudang data. Sebagai gudang data, PostgreSQL menyediakan repositori terpusat untuk menyimpan, mengelola, dan menganalisis data terstruktur dalam jumlah besar dari berbagai sumber.

PostgreSQL menawarkan fitur seperti partisi, pengindeksan, dan eksekusi kueri paralel yang memungkinkannya menangani kueri kompleks dan himpunan data besar secara efisien.

Ingat, gudang data PostgreSQL adalah solusi lokal yang mungkin tidak menskalakan sebaik beberapa solusi terkelola penuh. Solusi ini memerlukan administrasi dan pemeliharaan manual yang lebih banyak dibandingkan solusi tersebut.

Pelajari lebih lanjut di Panduan Pemula untuk PostgreSQL kami.

Alat Rekayasa Analitik

Alat rekayasa analitik menyederhanakan transformasi, pengujian, dan dokumentasi data di gudang data.

9. dbt

dbt (data build tool) adalah alat baris perintah dan kerangka kerja open-source yang dirancang untuk memfasilitasi alur kerja transformasi data dan pemodelan di lingkungan gudang data. Ini mendukung semua gudang data utama, termasuk Redshift, BigQuery, Snowflakes, dan PostgreSQL.

dbt dapat diakses melalui dbt Core atau dbt Cloud. dbt Cloud menawarkan antarmuka pengguna berbasis web, CLI bertenaga dbt Cloud, lingkungan terhosting, penjadwal job dalam aplikasi, dan integrasi dengan alat lain.

Anda dapat memahami dasar-dasar dbt melalui kursus Introduction to dbt kami.

10. Metabase

Metabase adalah alat business intelligence (BI) dan analitik open-source yang memungkinkan pengguna membuat dan membagikan dasbor interaktif dan laporan analitik. Dirancang agar mudah digunakan, memungkinkan pengguna non-teknis mengkueri data, memvisualisasikan hasil, dan memperoleh wawasan tanpa perlu mengetahui SQL atau bahasa kueri lainnya.

Ini menawarkan penyiapan yang mudah, dukungan untuk berbagai sumber data, antarmuka pengguna yang sederhana, fitur kolaborasi, notifikasi yang dapat disesuaikan, dan keamanan yang tangguh untuk eksplorasi, analisis, dan berbagi data.

Analitik data dan pembuatan dasbor merupakan bagian dari data science. Pelajari perbedaan antara Data Scientist dan Data Engineer dengan membaca artikel ini: Data Scientist vs Data Engineer.

Alat Pemrosesan Batch

Alat-alat data engineer ini memungkinkan pemrosesan data dalam jumlah besar secara efisien dalam batch, menjalankan tugas komputasi kompleks, analisis data, dan aplikasi machine learning di seluruh lingkungan komputasi terdistribusi.

11. Apache Spark

Apache Spark adalah kerangka kerja komputasi terdistribusi open-source yang kuat, dirancang untuk pemrosesan dan analisis data skala besar. Meskipun dikenal mampu menangani data streaming real-time, Spark juga unggul dalam pemrosesan batch, menjadikannya alat berharga dalam alur kerja data engineering.

Apache Spark menampilkan Resilient Distributed Datasets (RDD), API kaya untuk berbagai bahasa pemrograman, pemrosesan data di banyak node dalam klaster, dan integrasi mulus dengan alat lain. Ini sangat skalabel dan cepat, sehingga ideal untuk pemrosesan batch dalam tugas data engineering.

12. Apache Hadoop

Apache Hadoop adalah kerangka kerja open-source populer untuk penyimpanan dan pemrosesan terdistribusi atas himpunan data besar. Inti ekosistem Hadoop terdiri dari dua komponen kunci: Hadoop Distributed File System (HDFS) untuk penyimpanan dan model pemrograman MapReduce untuk pemrosesan.

Apache Hadoop adalah alat yang kuat dan skalabel bagi data engineer, menawarkan penyimpanan hemat biaya, toleransi kesalahan, kemampuan pemrosesan terdistribusi, dan integrasi mulus dengan alat pemrosesan data lainnya.

Alat Streaming

Alat streaming menyediakan cara kuat untuk membangun pipeline data real-time, memungkinkan pengambilan, pemrosesan, dan analisis data streaming secara berkelanjutan.

13. Apache Kafka

Apache Kafka adalah platform streaming peristiwa terdistribusi yang dirancang untuk pemrosesan data real-time berkinerja tinggi dan perampingan pipeline data skala besar. Alat ini digunakan untuk membangun pipeline data real-time, analitik streaming, integrasi data, dan aplikasi misi-kritis.

Kafka adalah sistem yang dapat menangani data dalam jumlah besar dengan latensi rendah. Ini menyimpan data secara terdistribusi dan tahan gangguan, memastikan data tetap tersedia bahkan jika terjadi kegagalan perangkat keras atau masalah jaringan.

Kafka sangat skalabel dan mendukung banyak pelanggan. Ini juga terintegrasi dengan baik dengan berbagai alat dan kerangka pemrosesan data, seperti Apache Spark, Apache Flink, dan Apache Storm.

Apache Flink adalah platform open-source untuk pemrosesan stream dan batch terdistribusi. Ini dapat memproses aliran data secara real-time, menjadikannya pilihan populer untuk membangun pipeline data streaming dan aplikasi analitik real-time.

Flink adalah alat pemrosesan data yang menyediakan kemampuan pemrosesan data real-time dan batch yang cepat dan efisien. Ini mendukung beberapa API (termasuk Java, Scala, dan Python), memungkinkan integrasi mulus dengan alat pemrosesan data lain, dan menawarkan manajemen state yang efisien. Oleh karena itu, ini menjadi pilihan populer untuk analitik real-time, deteksi penipuan, dan aplikasi IoT karena kemampuannya memproses data dengan throughput tinggi dan latensi rendah.

Kesimpulan

Daftar kita berakhir di sini, tetapi perjalanan data engineering Anda tidak harus berhenti. Daftarkan diri Anda pada Data Engineer in Python skill track untuk mempelajari Python, SQL, desain database, komputasi cloud, pembersihan data, dan visualisasi. Setelah menyelesaikan track tersebut, Anda dapat mengikuti ujian Data Engineer Career Certification dan menjadi Data Engineer profesional bersertifikat.

Data engineer berperan penting dalam membangun dan memelihara pipeline data yang mendukung analitik dan pengambilan keputusan di seluruh organisasi. Seiring volume dan kompleksitas data terus tumbuh secara eksponensial, data engineer harus memanfaatkan alat yang tepat untuk mengumpulkan, memproses, menyimpan, dan menyajikan data berkualitas secara efisien.

Kami telah membahas 14 alat data engineering teratas untuk kontainerisasi, penyediaan infrastruktur, otomatisasi alur kerja, gudang data, rekayasa analitik, pemrosesan batch, dan streaming real-time.

Jika Anda baru dalam data engineering, mulailah dengan mempelajari Docker, Kubernetes, Terraform, Prefect, Snowflake, dbt, Apache Spark, Apache Kafka, dan lainnya.

Setelah menguasai alat-alat ini, Anda sebaiknya meninjau The Top 21 Data Engineering Interview Questions, Answers, and Examples untuk mempersiapkan langkah karier berikutnya.


Abid Ali Awan's photo
Author
Abid Ali Awan
LinkedIn
Twitter

Sebagai data scientist tersertifikasi, saya bersemangat memanfaatkan teknologi mutakhir untuk menciptakan aplikasi machine learning yang inovatif. Dengan latar belakang kuat di pengenalan ucapan, analisis dan pelaporan data, MLOps, conversational AI, dan NLP, saya mengasah keterampilan dalam mengembangkan sistem cerdas yang berdampak nyata. Selain keahlian teknis, saya juga komunikator andal yang mampu menyederhanakan konsep kompleks menjadi bahasa yang jelas dan ringkas. Karena itu, saya menjadi blogger yang dicari di bidang data science, membagikan wawasan dan pengalaman kepada komunitas profesional data yang terus berkembang. Saat ini, saya berfokus pada pembuatan dan penyuntingan konten, bekerja dengan large language model untuk mengembangkan konten yang kuat dan menarik agar membantu bisnis dan individu memaksimalkan data mereka.

Topik
Rekayasa Data

Mulai Perjalanan Data Engineer Anda Hari Ini!

Program

Data Engineer dalam Python

40 jam
Dapatkan keterampilan yang sangat dicari untuk mengelola data dengan efisien, termasuk mengimpor, membersihkan, mengelola data, serta menjadwalkan dan memantau pipeline, sehingga Anda dapat menonjol di bidang data engineering.
Lihat DetailRight Arrow
Mulai Kursus
Lihat SelengkapnyaRight Arrow
Terkait

blogs

40 Pertanyaan Wawancara DBMS Teratas di 2026

Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Dario Radečić's photo

Dario Radečić

15 mnt

blogs

12 Alternatif ChatGPT Terbaik yang Bisa Anda Coba pada 2026

Artikel ini menyajikan daftar alternatif ChatGPT yang akan meningkatkan produktivitas Anda.
Javier Canales Luna's photo

Javier Canales Luna

14 mnt

blogs

Tutorial Korelasi di R

Dapatkan pengenalan dasar-dasar korelasi di R: pelajari lebih lanjut tentang koefisien korelasi, matriks korelasi, plotting korelasi, dan sebagainya.
David Woods's photo

David Woods

13 mnt

blogs

Spaghetti Plot dan Jalur Badai

Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Hugo Bowne-Anderson's photo

Hugo Bowne-Anderson

13 mnt

Lihat SelengkapnyaLihat Selengkapnya
