
Lộ trình
Kỹ sư dữ liệu chịu trách nhiệm tạo ra các pipeline dữ liệu có thể thu nhận, xử lý và phân phối dữ liệu đến nhiều điểm đích, như cơ sở dữ liệu, kho dữ liệu và nền tảng phân tích. Bằng cách xây dựng và duy trì các pipeline này, họ giúp nhà khoa học dữ liệu và nhà phân tích truy cập dữ liệu theo thời gian thực để phân tích và ra quyết định.
Kỹ sư dữ liệu hiện đại còn được kỳ vọng đảm nhiệm nhiều tác vụ hơn. Họ phải duy trì và triển khai các giải pháp dữ liệu, quản lý quy trình làm việc, giám sát kho dữ liệu, chuyển đổi và trực quan hóa dữ liệu, đồng thời sử dụng nhiều công cụ xử lý theo lô và streaming để tối ưu, thu nhận và xử lý các loại dữ liệu khác nhau.
Khám phá dữ liệu engineering là gì, khác gì với khoa học dữ liệu, phạm vi và cách học qua hướng dẫn What is Data Engineering?
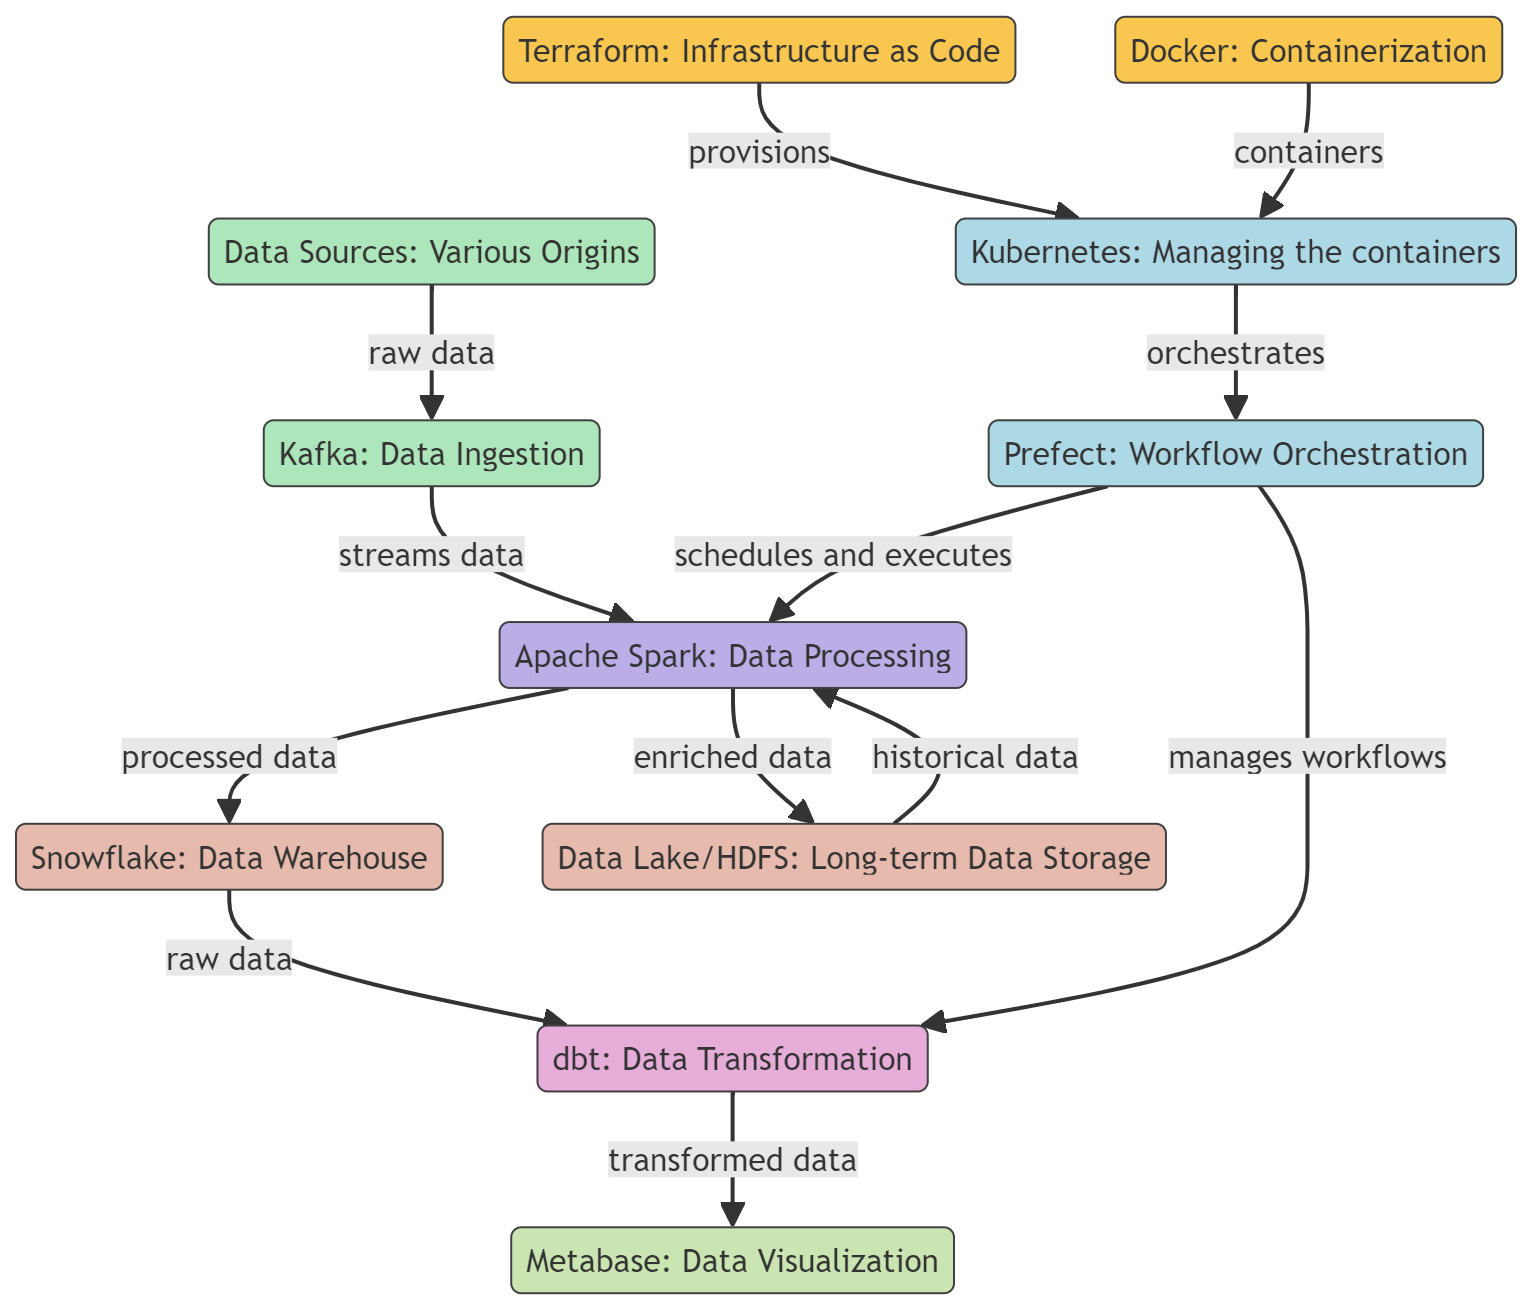
Trong bài viết này, chúng ta sẽ tìm hiểu các công cụ thiết yếu đang phổ biến và đôi khi là bắt buộc đối với kỹ sư dữ liệu. Những công cụ này dùng cho thu nhận, xử lý, lưu trữ, chuyển đổi và trực quan hóa dữ liệu. Ngoài ra, chúng ta cũng xem xét các công cụ cho container hóa và quản lý quy trình làm việc.
Học các kỹ năng cốt lõi về data engineering qua blog How to Become a Data Engineer.
Công cụ Container hóa
Công cụ container hóa cung cấp cách tiêu chuẩn để đóng gói, phân phối và quản lý ứng dụng trên nhiều môi trường khác nhau. Điều này đảm bảo tính nhất quán, khả năng mở rộng và hiệu quả cho quy trình làm việc của kỹ sư dữ liệu.
1. Docker
Docker là nền tảng container hóa phổ biến, thường được dùng trong data engineering để phát triển, phân phối và chạy các công cụ cùng ứng dụng dữ liệu. Nó mang lại cách đóng gói và triển khai nhẹ, di động và nhất quán, rất phù hợp cho kỹ sư dữ liệu.
Docker có thể dùng để tạo và quản lý container cho nhiều công cụ dữ liệu như cơ sở dữ liệu, kho dữ liệu, framework xử lý dữ liệu và công cụ trực quan hóa. Xem thêm hướng dẫn Docker for Data Science của chúng tôi.
2. Kubernetes
Kubernetes là nền tảng mã nguồn mở để tự động hóa việc triển khai, mở rộng và quản lý các ứng dụng dạng container, bao gồm những ứng dụng xây dựng bằng Docker.
Docker là công cụ để đóng gói ứng dụng xử lý dữ liệu, cơ sở dữ liệu và công cụ phân tích vào container, đảm bảo môi trường nhất quán và cô lập ứng dụng. Sau khi tạo container, Kubernetes sẽ quản lý chúng bằng cách xử lý triển khai, mở rộng theo khối lượng công việc và đảm bảo tính sẵn sàng cao.
Tìm hiểu thêm về Containerization using Docker and Kubernetes trong một bài viết khác.
Công cụ Hạ tầng như Mã
Infrastructure as Code (IaC) tinh giản việc triển khai và bảo trì hạ tầng đám mây bằng cách sử dụng ngôn ngữ lập trình đa dụng hoặc cấu hình YAML. Cách tiếp cận này thúc đẩy tạo ra các môi trường nhất quán, lặp lại được và tự động hóa, giúp quá trình chuyển đổi giữa phát triển, kiểm thử và sản xuất diễn ra trơn tru.
3. Terraform
Terraform là công cụ IaC mã nguồn mở do HashiCorp tạo ra. Nó cho phép kỹ sư dữ liệu định nghĩa và triển khai hạ tầng dữ liệu, như cơ sở dữ liệu và pipeline dữ liệu, theo cách nhất quán và đáng tin cậy bằng ngôn ngữ cấu hình khai báo, mô tả trạng thái cuối cùng mong muốn của hạ tầng thay vì các bước để đạt đến trạng thái đó.
Terraform hỗ trợ quản lý phiên bản, quản lý tài nguyên qua mã, cộng tác nhóm và tích hợp với nhiều công cụ, nền tảng.
4. Pulumi
Pulumi là công cụ hạ tầng như mã mã nguồn mở cho phép nhà phát triển tạo, triển khai và quản lý hạ tầng đám mây bằng các ngôn ngữ lập trình đa dụng như JavaScript, TypeScript, Java, Python, Go và C#. Nó hỗ trợ nhiều nhà cung cấp đám mây, bao gồm AWS, Azure, GCP và Kubernetes.
Khung Pulumi cung cấp giao diện dòng lệnh (CLI), bộ công cụ phát triển phần mềm (SDK) và động cơ triển khai có thể tải về để mang đến nền tảng vững chắc cho việc cấp phát, cập nhật và quản lý hạ tầng đám mây.
Công cụ Điều phối Quy trình
Công cụ điều phối quy trình tự động hóa và quản lý việc thực thi các quy trình xử lý dữ liệu phức tạp, đảm bảo tác vụ chạy theo đúng thứ tự đồng thời quản lý các phụ thuộc.
5. Prefect
Prefect là công cụ điều phối quy trình mã nguồn mở cho các quy trình dữ liệu hiện đại và quy trình ETL (trích xuất, biến đổi, nạp). Nó giúp kỹ sư và nhà khoa học dữ liệu tự động hóa, quản lý pipeline dữ liệu phức tạp, đảm bảo luồng dữ liệu từ nguồn đến đích diễn ra trơn tru, tin cậy và hiệu quả.
Prefect cung cấp mô hình thực thi lai, kết hợp ưu điểm của quản lý trên đám mây với tính bảo mật và kiểm soát của thực thi cục bộ. Giao diện thân thiện và API phong phú giúp việc giám sát và khắc phục sự cố quy trình dữ liệu trở nên dễ dàng.
6. Luigi
Luigi là gói Python mã nguồn mở giúp bạn xây dựng pipeline dữ liệu phức tạp gồm các tác vụ theo lô chạy lâu. Được Spotify phát triển để xử lý giải quyết phụ thuộc, quản lý quy trình, trực quan hóa, xử lý lỗi và tích hợp dòng lệnh.
Luigi được thiết kế để quản lý nhiều tác vụ như xử lý, kiểm định và tổng hợp dữ liệu, có thể dùng để xây dựng quy trình dữ liệu từ đơn giản đến tinh vi. Luigi tích hợp với nhiều công cụ và nền tảng như Apache Hadoop và Apache Spark, cho phép tạo pipeline để xử lý và phân tích khối lượng dữ liệu lớn.
Công cụ Kho Dữ liệu
Kho dữ liệu cung cấp các giải pháp đám mây có khả năng mở rộng cao để lưu trữ, truy vấn và quản lý tập dữ liệu lớn.
7. Snowflake
Snowflake là kho dữ liệu trên đám mây cho phép lưu trữ, xử lý và truy vấn phân tích trên khối lượng dữ liệu lớn. Nó dựa trên kiến trúc tách rời giữa lưu trữ và tính toán, cho phép mở rộng độc lập.
Snowflake có thể tự động điều chỉnh tài nguyên tính toán theo nhu cầu, đảm bảo truy vấn được xử lý kịp thời, hiệu quả và tiết kiệm chi phí. Nó tương thích với các nhà cung cấp đám mây lớn như AWS, GCP và Azure.
Khám phá chi tiết hơn trong khóa học Introduction to Snowflake của chúng tôi.
8. PostgreSQL
PostgreSQL là hệ quản trị cơ sở dữ liệu quan hệ (RDBMS) mã nguồn mở mạnh mẽ, cũng có thể dùng như một kho dữ liệu. Là kho dữ liệu, PostgreSQL cung cấp kho trung tâm để lưu trữ, quản lý và phân tích khối lượng lớn dữ liệu có cấu trúc từ nhiều nguồn.
PostgreSQL cung cấp các tính năng như phân vùng, lập chỉ mục và thực thi truy vấn song song, cho phép xử lý hiệu quả truy vấn phức tạp và bộ dữ liệu lớn.
Lưu ý, kho dữ liệu PostgreSQL là giải pháp nội bộ có thể không mở rộng tốt như một số giải pháp được quản lý hoàn toàn. Nó đòi hỏi nhiều công việc quản trị và bảo trì thủ công hơn.
Tìm hiểu thêm trong Hướng dẫn cho người mới bắt đầu về PostgreSQL.
Công cụ Kỹ thuật Phân tích
Công cụ kỹ thuật phân tích giúp tinh giản việc chuyển đổi, kiểm thử và lập tài liệu cho dữ liệu trong kho dữ liệu.
9. dbt
dbt (data build tool) là công cụ dòng lệnh và khung làm việc mã nguồn mở, được thiết kế để hỗ trợ quy trình chuyển đổi dữ liệu và mô hình hóa trong môi trường kho dữ liệu. Nó hỗ trợ tất cả các kho dữ liệu lớn, gồm Redshift, BigQuery, Snowflake và PostgreSQL.
dbt có thể truy cập qua dbt Core hoặc dbt Cloud. dbt Cloud cung cấp giao diện web, CLI chạy trên dbt Cloud, môi trường được lưu trữ, bộ lập lịch công việc trong ứng dụng và tích hợp với các công cụ khác.
Bạn có thể nắm vững những điều cơ bản của dbt với khóa học Introduction to dbt.
10. Metabase
Metabase là công cụ phân tích và thông minh kinh doanh (BI) mã nguồn mở cho phép người dùng tạo và chia sẻ dashboard tương tác và báo cáo phân tích. Nó được thiết kế thân thiện, cho phép người không chuyên kỹ thuật truy vấn dữ liệu, trực quan hóa kết quả và rút ra insight mà không cần biết SQL hay ngôn ngữ truy vấn khác.
Metabase mang đến thiết lập dễ dàng, hỗ trợ nhiều nguồn dữ liệu, giao diện đơn giản, tính năng cộng tác, thông báo tùy chỉnh và bảo mật mạnh mẽ cho việc khám phá, phân tích và chia sẻ dữ liệu.
Phân tích dữ liệu và xây dựng dashboard là một phần của khoa học dữ liệu. Tìm hiểu sự khác nhau giữa Nhà khoa học Dữ liệu và Kỹ sư Dữ liệu qua bài viết: Data Scientist vs Data Engineer.
Công cụ Xử lý Theo lô
Những công cụ dành cho kỹ sư dữ liệu này cho phép xử lý hiệu quả khối lượng dữ liệu lớn theo lô, chạy các tác vụ tính toán phức tạp, phân tích dữ liệu và ứng dụng học máy trên môi trường tính toán phân tán.
11. Apache Spark
Apache Spark là khung tính toán phân tán mã nguồn mở mạnh mẽ, được thiết kế cho xử lý và phân tích dữ liệu quy mô lớn. Dù nổi tiếng với khả năng xử lý dữ liệu streaming theo thời gian thực, Spark cũng rất mạnh về xử lý theo lô, trở thành công cụ giá trị trong quy trình data engineering.
Apache Spark có RDD (Resilient Distributed Datasets), API phong phú cho nhiều ngôn ngữ lập trình, xử lý dữ liệu trên nhiều nút trong cụm và tích hợp mượt với các công cụ khác. Nó có khả năng mở rộng cao và nhanh, lý tưởng cho xử lý theo lô trong các tác vụ data engineering.
12. Apache Hadoop
Apache Hadoop là framework mã nguồn mở phổ biến dành cho lưu trữ và xử lý phân tán các tập dữ liệu lớn. Cốt lõi của hệ sinh thái Hadoop gồm hai thành phần chính: Hệ thống tệp phân tán Hadoop (HDFS) để lưu trữ và mô hình lập trình MapReduce để xử lý.
Apache Hadoop là công cụ mạnh mẽ, có khả năng mở rộng cho kỹ sư dữ liệu, cung cấp lưu trữ tiết kiệm chi phí, chịu lỗi, năng lực xử lý phân tán và tích hợp mượt với các công cụ xử lý dữ liệu khác.
Công cụ Streaming
Công cụ streaming cung cấp cách mạnh mẽ để xây dựng pipeline dữ liệu thời gian thực, cho phép thu nhận, xử lý và phân tích dữ liệu streaming một cách liên tục.
13. Apache Kafka
Apache Kafka là nền tảng streaming sự kiện phân tán được thiết kế cho xử lý dữ liệu thời gian thực hiệu năng cao và tối ưu hóa các pipeline dữ liệu quy mô lớn. Nó được dùng để xây dựng pipeline thời gian thực, phân tích streaming, tích hợp dữ liệu và các ứng dụng nhiệm vụ trọng yếu.
Kafka có thể xử lý lượng dữ liệu lớn với độ trễ thấp. Nó lưu trữ dữ liệu theo cách phân tán và chịu lỗi, đảm bảo dữ liệu vẫn khả dụng ngay cả khi xảy ra lỗi phần cứng hoặc sự cố mạng.
Kafka có khả năng mở rộng cao và hỗ trợ nhiều subscriber. Nó cũng tích hợp tốt với các công cụ và framework xử lý dữ liệu khác như Apache Spark, Apache Flink và Apache Storm.
14. Apache Flink
Apache Flink là nền tảng mã nguồn mở cho xử lý stream và batch phân tán. Nó có thể xử lý dòng dữ liệu theo thời gian thực, trở thành lựa chọn phổ biến để xây dựng pipeline dữ liệu streaming và ứng dụng phân tích thời gian thực.
Flink là công cụ xử lý dữ liệu cung cấp khả năng xử lý thời gian thực và theo lô nhanh, hiệu quả. Nó hỗ trợ nhiều API (bao gồm Java, Scala và Python), cho phép tích hợp mượt với các công cụ xử lý dữ liệu khác và cung cấp quản lý trạng thái hiệu quả. Vì vậy, nó là lựa chọn phổ biến cho phân tích thời gian thực, phát hiện gian lận và ứng dụng IoT nhờ khả năng xử lý dữ liệu thông lượng cao với độ trễ thấp.
Kết luận
Danh sách của chúng tôi kết thúc tại đây, nhưng hành trình data engineering của bạn thì không. Hãy đăng ký lộ trình kỹ năng Data Engineer in Python để học về Python, SQL, thiết kế cơ sở dữ liệu, điện toán đám mây, làm sạch dữ liệu và trực quan hóa. Sau khi hoàn thành lộ trình, bạn có thể thi chứng chỉ nghề nghiệp Data Engineer và trở thành Kỹ sư Dữ liệu được chứng nhận.
Kỹ sư dữ liệu đóng vai trò then chốt trong việc xây dựng và duy trì các pipeline dữ liệu cung cấp cho phân tích và ra quyết định trên toàn tổ chức. Khi khối lượng và độ phức tạp dữ liệu tiếp tục tăng theo cấp số nhân, kỹ sư dữ liệu phải tận dụng đúng công cụ để thu nhận, xử lý, lưu trữ và phân phối dữ liệu chất lượng một cách hiệu quả.
Chúng tôi đã đề cập 14 công cụ data engineering hàng đầu cho container hóa, cấp phát hạ tầng, tự động hóa quy trình, kho dữ liệu, kỹ thuật phân tích, xử lý theo lô và streaming thời gian thực.
Nếu bạn mới bắt đầu với data engineering, hãy học Docker, Kubernetes, Terraform, Prefect, Snowflake, dbt, Apache Spark, Apache Kafka và nhiều công cụ khác.
Sau khi thành thạo các công cụ này, bạn nên xem Top 21 câu hỏi phỏng vấn Data Engineering, câu trả lời và ví dụ để chuẩn bị cho bước tiến sự nghiệp tiếp theo.
Là một nhà khoa học dữ liệu được chứng nhận, tôi đam mê tận dụng công nghệ tiên tiến để tạo ra các ứng dụng học máy đổi mới. Với nền tảng vững chắc về nhận dạng giọng nói, phân tích và báo cáo dữ liệu, MLOps, AI hội thoại và NLP, tôi đã rèn giũa kỹ năng phát triển các hệ thống thông minh có thể tạo ra tác động thực sự. Bên cạnh chuyên môn kỹ thuật, tôi cũng là một người truyền đạt tốt, có khả năng chắt lọc các khái niệm phức tạp thành ngôn ngữ rõ ràng, súc tích. Nhờ đó, tôi trở thành một blogger được nhiều người quan tâm trong lĩnh vực khoa học dữ liệu, chia sẻ góc nhìn và kinh nghiệm với cộng đồng các chuyên gia dữ liệu ngày càng lớn. Hiện tại, tôi tập trung vào sáng tạo và biên tập nội dung, làm việc với các mô hình ngôn ngữ lớn để phát triển nội dung mạnh mẽ và hấp dẫn, giúp doanh nghiệp và cá nhân tận dụng tối đa dữ liệu của mình.
