
Program
Veri mühendisleri; veriyi veritabanları, veri ambarları ve analitik platformları gibi çeşitli uç noktalara alıp işleyebilen ve ulaştırabilen veri boru hatlarını oluşturmaktan sorumludur. Bu boru hatlarını oluşturup sürdürerek, veri mühendisleri veri bilimcilerin ve analistlerin gerçek zamanlı veriye erişmesini sağlar, böylece analiz ve karar alma mümkündür.
Günümüz veri mühendislerinden daha da fazla görev beklenir. Veri çözümlerini devreye almak ve sürdürmek, iş akışlarını yönetmek, veri ambarlarını gözetmek, veriyi dönüştürmek ve görselleştirmek; farklı tür verileri iyileştirmek, almak ve işlemek için çeşitli toplu işleme ve akış araçlarını kullanmak zorundadırlar.
Rehberimizi okuyarak veri mühendisliğinin ne olduğunu, veri biliminden nasıl farklılaştığını, kapsamını ve nasıl öğrenileceğini keşfedin: What is Data Engineering?
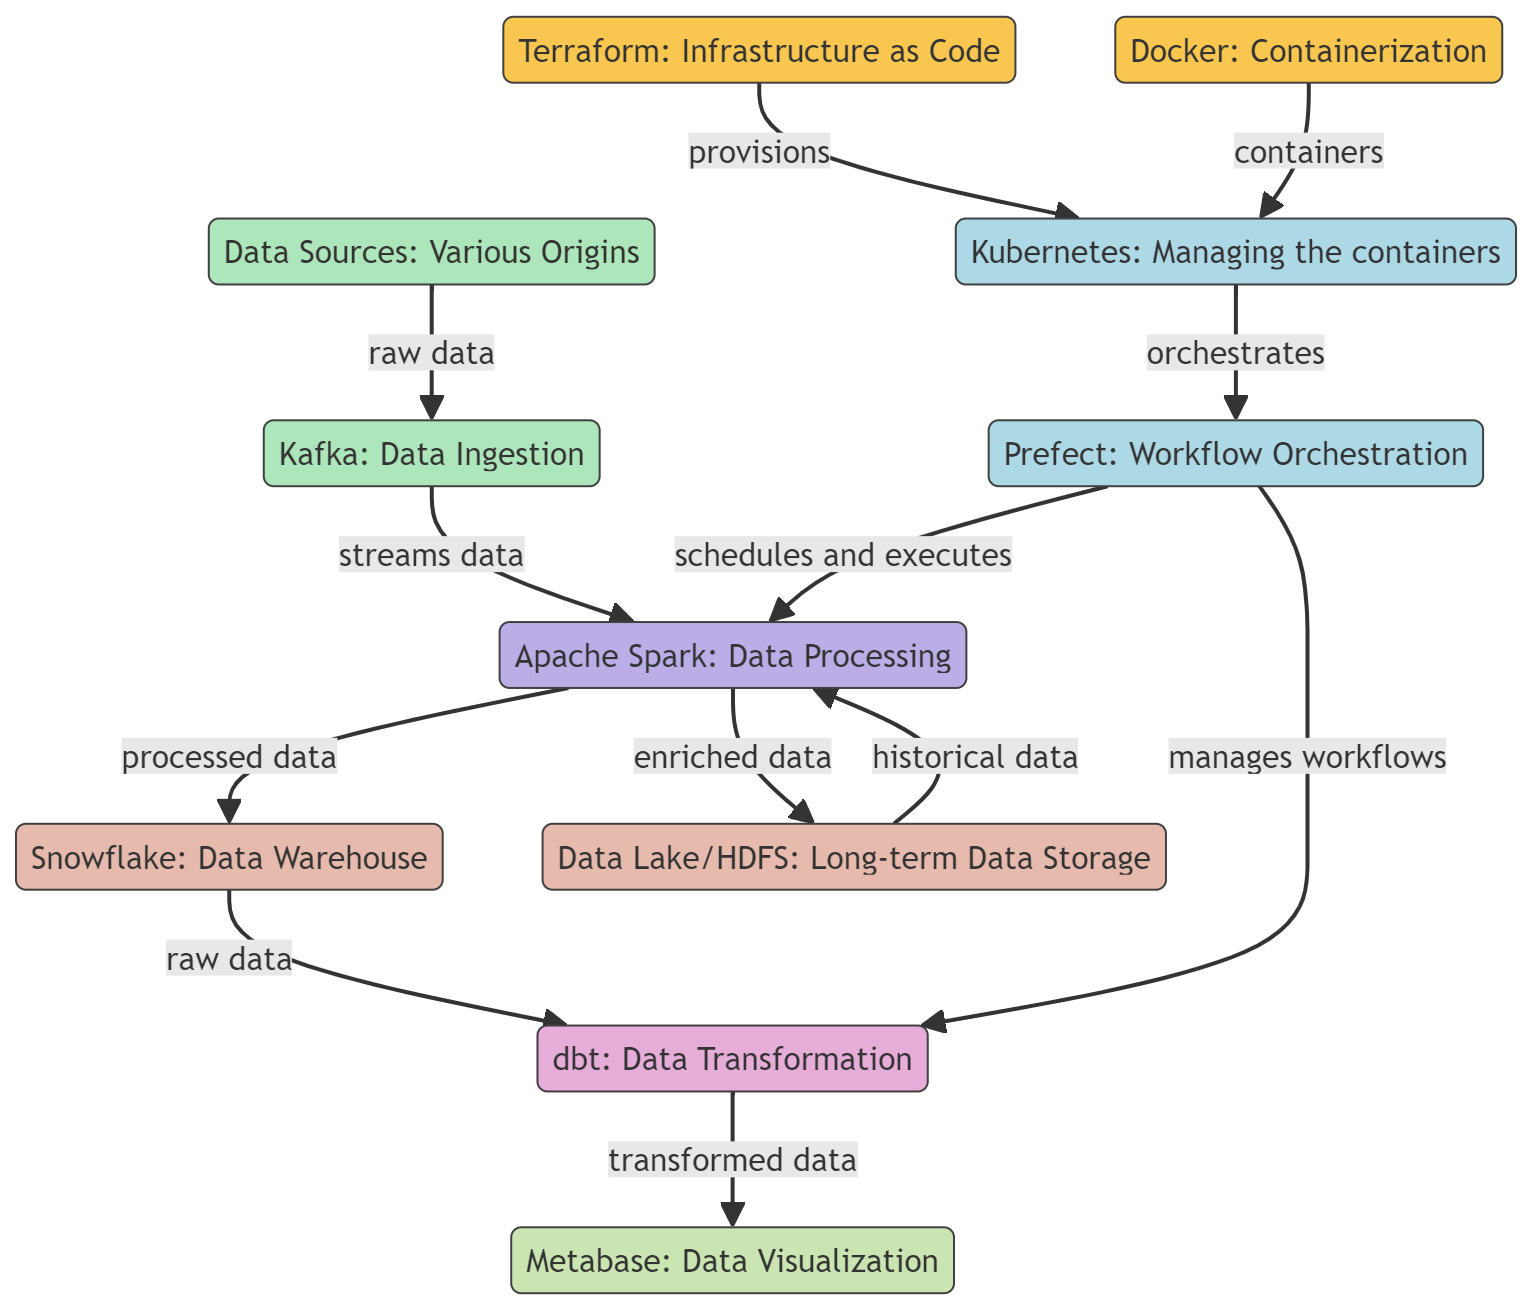
Bu yazıda, veri mühendisleri için popüler ve bazen de gerekli olan temel araçları inceleyeceğiz. Bu araçlar veri alımı, işlenmesi, depolanması, dönüşümü ve görselleştirilmesi için kullanılır. Ayrıca konteynerleştirme ve iş akışı yönetimi için araçlara da bakacağız.
Temel veri mühendisliği becerilerini, şu blog yazımızı okuyarak öğrenin: How to Become a Data Engineer.
Konteynerleştirme Araçları
Konteynerleştirme araçları, uygulamaları farklı ortamlarda paketlemek, dağıtmak ve yönetmek için standart bir yol sağlar. Bu da veri mühendisliği iş akışlarının tutarlılığını, ölçeklenebilirliğini ve verimliliğini garanti eder.
1. Docker
Docker, veri mühendisliğinde veri araçları ve uygulamalarını geliştirmek, dağıtmak ve çalıştırmak için sıklıkla kullanılan popüler bir konteynerleştirme platformudur. Veri araçlarını ve uygulamalarını paketlemek ve devreye almak için hafif, taşınabilir ve tutarlı bir yol sunar; bu nedenle veri mühendisleri için ideal bir seçenektir.
Docker; veritabanları, veri ambarları, veri işleme çatıları ve veri görselleştirme araçları gibi çeşitli veri araçları için konteynerler oluşturup yönetmekte kullanılabilir. Daha fazla bilgi için Docker for Data Science rehberimize göz atın.
2. Kubernetes
Kubernetes, Docker ile oluşturulanlar da dahil olmak üzere, konteynerleştirilmiş uygulamaların devreye alımını, ölçeklenmesini ve yönetimini otomatikleştiren açık kaynaklı bir platformdur.
Docker; veri işleme uygulamalarını, veritabanlarını ve analitik araçlarını konteynerlere paketlemek için kullanılabilen bir araçtır. Bu, ortam tutarlılığı sağlar ve uygulamaları yızalatır. Konteynerler oluşturulduktan sonra Kubernetes, bunların devreye alımını yöneterek, işyüküne göre ölçekler ve yüksek kullanılabilirliği sağlar.
Docker ve Kubernetes ile Konteynerleştirme hakkında ayrı bir yazıda daha fazla bilgi edinin.
Kod Olarak Altyapı Araçları
Kod Olarak Altyapı (IaC), genel amacı olan programlama dilleri veya YAML yapılandırmaları kullanarak bulut altyapısının devreye alımını ve bakımını sadeleştirir. Bu yaklaşım, tutarlı, tekrarlanabilir ve otomatik ortamlarda geliştirme, test ve üretim aşamaları arasındaki geçişleri kolaylaştırır.
3. Terraform
Terraform, HashiCorp tarafından oluşturulmuş açık kaynaklı bir kod olarak altyapı (IaC) aracıdır. Veri mühendislerinin; veritabanları ve veri boru hatları gibi veri altyapısını, gerekli duruma ulaşmak için izlenecek adımlar yerine altyapının istenen nihai durumunu tanımlayan bildirime dayalı bir yapılandırma diliyle tutarlı ve güvenilir bir şekilde tanımlayıp devreye almasını sağlar.
Terraform; sürüm kontrolü, kod aracılığıyla kaynak yönetimi, ekip işbirliği ve çeşitli araç ve platformlarla bütünleşmeyi destekler.
4. Pulumi
Pulumi, geliştiricilerin JavaScript, TypeScript, Java, Python, Go ve C# gibi genel amaçlı programlama dillerini kullanarak bulut altyapısı oluşturmasına, devreye almasına ve yönetmesine olanak tanıyan açık kaynaklı bir kod olarak altyapı aracıdır. AWS, Azure, GCP ve Kubernetes dahil geniş bir bulut sağlayıcı yelpazesini destekler.
Pulmi çerçevesi; bulut altyapısını sağlamak, güncellemek ve yönetmek için güçlü bir platform sunmak üzere indirilebilir bir Komut Satırı arabirimi (CLI), Yazılım geliştirme kiti (SDK) ve Dağıtım motoru sağlar.
İş Akışı Orkestrasyon Araçları
İş akışı orkestrasyon araçları, karmaşık veri işleme iş akışlarını otomatikleştirir ve yönetir; bağlılıkları yönetirken görevlerin doğru sırayla çalışmasını sağlar.
5. Prefect
Prefect, modern veri iş akışları ve ETL (extract, transform, load) süreçleri için açık kaynaklı bir iş akışı orkestrasyon aracıdır. Veri mühendisleri ve bilimcilerin karmaşık veri boru hatlarını otomatikleştirip yönetmesine yardımcı olur; verinin kaynaktan hedefe güvenilir ve verimli bir şekilde akmasını sağlar.
Prefect, bulut tabanlı yönetimin avantajlarını yerel çalıştırmanın güvenliği ve kontrolü ile birleştiren hibrit bir çalıştırma modeli sunar. Kullanıcı dostu arayüzü ve zengin API’si, veri iş akışlarını izlemeyi ve sorun gidermeyi kolaylaştırır.
6. Luigi
Luigi, uzun süre çalışan toplu görevlerden oluşan karmaşık veri boru hatları oluşturmanıza yardımcı olan açık kaynaklı bir Python paketidir. Spotify tarafından bağımlılık çözümleme, iş akışı yönetimi, görselleştirme, hata yönetimi ve komut satırı bütünleşmesi için geliştirilmiştir.
Luigi; veri işleme, veri doğrulama ve veri toplulaştırma dahil çeşitli görevleri yönetmek üzere tasarlanmıştır ve basit ya da gelişmiş veri iş akışları kurmak için kullanılabilir. Luigi; Apache Hadoop ve Apache Spark gibi çeşitli araç ve platformlarla bütünleştirilebilir; kullanıcıların büyük hacimli verileri işleyip analiz etmek için veri boru hatları oluşturmasına olanak tanır.
Veri Ambarı Araçları
Veri ambarları, büyük veri kümesini depolamak, sorgulamak ve yönetmek için yüksek ölçeklenebilir bulut tabanlı çözümler sunar.
7. Snowflake
Snowflake, büyük hacimli verilerin depolanmasını, işlenmesini ve analitik sorgulanmasını sağlayan bulut tabanlı bir veri ambarıdır. Depolama ve işlemeyi birbirinden ayıran benzersiz bir mimariye dayanır; böylece bunları bağımsız olarak ölçeklemek mümkündür.
Snowflake, talebe göre işlem kaynaklarını dinamik olarak ayarlayabilir. Bu sayede sorgular zamanında, verimli ve maliyet etkin bir şekilde işlenebilir. AWS, GCP ve Azure gibi başlıca bulut sağlayıcılarla uyumludur.
Bu aracı daha ayrıntılı incelemek için Introduction to Snowflake kursumuza göz atın.
8. PostgreSQL
PostgreSQL, veri ambarı olarak da kullanılabilecek güçlü, açık kaynaklı bir ilişkisel veritabanı yönetim sistemidir (RDBMS). Bir veri ambarı olarak PostgreSQL, çeşitli kaynaklardan gelen büyük hacimli yapılandırılmış verilerin depolanması, yönetilmesi ve analiz edilmesi için merkezi bir havuz sağlar.
PostgreSQL; bölümlendirme, indeksleme ve paralel sorgu çalıştırma gibi özelliklerle karmaşık sorguları ve büyük veri kümesini verimli şekilde işleyebilir.
Unutmayın, PostgreSQL tabanlı bir veri ambarı, bazı tam yönetilen çözümler kadar iyi ölçeklenmeyen yerel bir çözümdür. Bu çözümlere kıyasla daha fazla manuel yönetim ve bakım gerektirir.
Dahası için Beginner’s Guide to PostgreSQL içeriğimize göz atın.
Analitik Mühendislik Araçları
Analitik mühendislik araçları, veri ambarı içinde verinin dönüşümünü, test edilmesini ve belgelendirilmesini düzenler.
9. dbt
dbt (data build tool), veri ambarı ortamında veri dönüşüm iş akışını ve modellemeyi kolaylaştırmak için tasarlanmış açık kaynaklı bir komut satırı aracı ve çerçevedir. Redshift, BigQuery, Snowflakes ve PostgreSQL dahil tüm büyük veri ambarlarını destekler.
dbt’ye dbt Core veya dbt Cloud aracılığıyla erişilebilir. dbt Cloud; web tabanlı bir kullanıcı arayüzü, dbt Cloud destekli bir CLI, barındırılan bir ortam, uygulama içi iş zamanlayıcı ve diğer araçlarla bütünleşmeler sunar.
dbt’nin temellerini Introduction to dbt kursumuzla kavrayabilirsiniz.
10. Metabase
Metabase, kullanıcıların etkileşimli panolar ve analitik raporlar oluşturup paylaşmasını sağlayan açık kaynaklı bir iş zekâsı (BI) ve analitik aracıdır. Kullanıcı dostu olacak şekilde tasarlanmıştır; teknik olmayan kullanıcıların bile SQL veya diğer sorgulama dillerini bilmeden veri sorgulamasını, sonuçları görselleştirmesini ve içgörü elde etmesini mümkün kılar.
Kolay kurulum, çeşitli veri kaynakları için destek, basit bir kullanıcı arayüzü, işbirliği özellikleri, özelleştirilebilir bildirimler ve güçlü güvenlik sunar; böylece veri keşfi, analiz ve paylaşımını kolaylaştırır.
Veri analitiği ve panolaştırma, veri biliminin bir parçasıdır. Şu yazıyı okuyarak Veri Bilimci ile Veri Mühendisi arasındaki farkları öğrenin: Data Scientist vs Data Engineer.
Toplu İşleme Araçları
Bu veri mühendisliği araçları, dağıtık bilişim ortamlarında karmaşık hesaplama görevleri, veri analizi ve makine öğrenmesi uygulamalarını büyük verileri partiler halinde verimli şekilde işlemeyi sağlar.
11. Apache Spark
Apache Spark, büyük ölçekte veri işleme ve analiz için tasarlanmış, güçlü açık kaynaklı bir dağıtık işleme çatısıdır. Gerçek zamanlı akış verilerini yönetme yeteneğiyle bilinse de Spark, toplu işlemede de üstün performans gösterir ve veri mühendisliği iş akışlarında değerli bir araçtır.
Apache Spark; Dayanıklı Dağıtık Veri Kümesi (RDD) yapıları, çeşitli programlama dilleri için zengin API’ler, bir küme içindeki birden fazla düğümde veri işleme ve diğer araçlarla sorunsuz bütünleşme gibi özellikler sunar. Yüksek ölçeklenebilirlik ve hız sağlar; bu da onu veri mühendisliğinde toplu işleme için ideal kılar.
12. Apache Hadoop
Apache Hadoop, büyük veri kümesini dağıtık olarak depolamak ve işlemek için popüler bir açık kaynaklı çerçevedir. Hadoop ekosisteminin merkezinde, depolama için Hadoop Dağıtık Dosya Sistemi (HDFS) ve işleme için MapReduce programlama modeli olmak üzere iki temel bileşen bulunur.
Apache Hadoop; uygun maliyetli depolama, hata toleransı, dağıtık işleme yetenekleri ve diğer veri işleme araçlarıyla sorunsuz bütünleşme sunarak veri mühendisleri için güçlü ve ölçeklenebilir bir araçtır.
Akış Araçları
Akış araçları, gerçek zamanlı veri boru hatları oluşturmanın güçlü bir yolunu sunar; akış verisinin kesintisiz olarak alınmasını, işlenmesini ve analizini mümkün kılar.
13. Apache Kafka
Apache Kafka, yüksek performanslı, gerçek zamanlı veri işleme ve büyük ölçekli veri boru hatlarını düzenlemek için tasarlanmış dağıtık bir olay akışı platformudur. Gerçek zamanlı veri boru hatları kurmak, akış analitiği, veri entegrasyonu ve kritik uygulamalar için kullanılır.
Kafka, düşük gecikme ile büyük miktarda veriyi yönetebilen bir sistemdir. Veriyi dağıtık ve hata toleranslı biçimde depolar; donanım arızaları veya ağ sorunları olsa bile verinin erişilebilir kalmasını sağlar.
Kafka çok ölçeklenebilirdir ve birden çok aboneyi destekler. Ayrıca Apache Spark, Apache Flink ve Apache Storm gibi farklı veri işleme araçları ve çatılarıyla iyi bütünleşir.
14. Apache Flink
Apache Flink, dağıtık akış ve toplu işleme için açık kaynaklı bir platformdur. Veri akışlarını gerçek zamanlı olarak işleyebilir; bu da onu akış veri boru hatları ve gerçek zamanlı analitik uygulamaları için popüler bir seçenek haline getirir.
Flink; hızlı ve verimli gerçek zamanlı ve toplu veri işleme yetenekleri sağlayan bir veri işleme aracıdır. Birçok API’yi (Java, Scala ve Python dahil) destekler, diğer veri işleme araçlarıyla sorunsuz bütünleşme sağlar ve etkin durum yönetimi sunar. Bu nedenle, yüksek hacimli veriyi düşük gecikmeyle işleyebilme yeteneği sayesinde gerçek zamanlı analitik, dolandırıcılık tespiti ve IoT uygulamaları için popüler bir tercihtir.
Sonuç
Listemizin sonuna geldik; ancak veri mühendisliği yolculuğunuz burada bitmek zorunda değil. Python, SQL, veritabanı tasarımı, bulut bilişim, veri temizleme ve görselleştirme öğrenmek için Data Engineer in Python beceri programına kaydolun. Programı tamamladıktan sonra Data Engineer Career Certification sınavına girerek profesyonel Veri Mühendisi sertifikası alabilirsiniz.
Veri mühendisleri, kuruluşlar genelinde analitik ve karar alma süreçlerini besleyen veri boru hatlarını oluşturup sürdürmede kritik bir rol oynar. Veri hacmi ve karmaşıklığı üssel olarak artmaya devam ettikçe, veri mühendislerinin veriyi verimli şekilde almak, işlemek, depolamak ve kaliteli veriyi sunmak için doğru araçlardan yararlanmaları gerekir.
Konteynerleştirme, altyapı sağlama, iş akışı otomasyonu, veri ambarları, analitik mühendislik, toplu işleme ve gerçek zamanlı akış için en iyi 14 veri mühendisliği aracını ele aldık.
Veri mühendisliğine yeni başlıyorsanız Docker, Kubernetes, Terraform, Prefect, Snowflake, dbt, Apache Spark, Apache Kafka ve daha fazlasını öğrenerek başlayın.
Bu araçlarda yetkinlik kazandıktan sonra, bir sonraki kariyer adımınıza hazırlanmak için The Top 21 Data Engineering Interview Questions, Answers, and Examples içeriğini incelemelisiniz.
Sertifikalı bir veri bilimcisi olarak, yenilikçi makine öğrenimi uygulamaları oluşturmak için en son teknolojileri kullanmaya büyük ilgi duyuyorum. Konuşma tanıma, veri analizi ve raporlama, MLOps, konuşma yapay zekası ve NLP alanlarında güçlü bir geçmişe sahip olarak, gerçek bir etki yaratabilecek akıllı sistemler geliştirme becerilerimi geliştirdim. Teknik uzmanlığımın yanı sıra, karmaşık kavramları açık ve özlü bir dille ifade etme yeteneğine sahip, becerikli bir iletişimciyim. Sonuç olarak, veri bilimi konusunda aranan bir blog yazarı oldum ve giderek büyüyen veri profesyonelleri topluluğuyla görüşlerimi ve deneyimlerimi paylaşıyorum. Şu anda, içerik oluşturma ve düzenlemeye odaklanıyorum. Büyük dil modelleriyle çalışarak, hem işletmelerin hem de bireylerin verilerinden en iyi şekilde yararlanmalarına yardımcı olabilecek güçlü ve ilgi çekici içerikler geliştiriyorum.


