Last chance! 50% off DataCamp Premium
Sale ends in
डेटा इंजीनियर ऐसे डेटा पाइपलाइनों का निर्माण करने के लिए ज़िम्मेदार होते हैं जो डेटा को इन्गेस्ट, प्रोसेस और विभिन्न एंडपॉइंट्स—जैसे डेटाबेस, डेटा वेयरहाउस और एनालिटिक्स प्लेटफ़ॉर्म—तक पहुँचाते हैं। इन पाइपलाइनों का निर्माण और रखरखाव करके, डेटा इंजीनियर डेटा वैज्ञानिकों और विश्लेषकों को रीयल-टाइम डेटा तक पहुँचने में सक्षम बनाते हैं ताकि वे विश्लेषण और निर्णय-निर्धारण कर सकें।
आधुनिक डेटा इंजीनियरों से और भी अधिक कार्यों की अपेक्षा की जाती है। उन्हें डेटा समाधानों को मेंटेन और डिप्लॉय करना, वर्कफ़्लो प्रबंधित करना, डेटा वेयरहाउस की निगरानी करना, डेटा को ट्रांसफ़ॉर्म और विज़ुअलाइज़ करना, और विभिन्न बैच प्रोसेसिंग तथा स्ट्रीमिंग टूल्स का उपयोग करके अलग-अलग प्रकार के डेटा के इन्गेस्ट और प्रोसेस को अनुकूलित करना भी आना चाहिए।
हमारे गाइड What is Data Engineering? को पढ़कर जानें कि डेटा इंजीनियरिंग क्या है, यह डेटा साइंस से कैसे अलग है, इसका दायरा क्या है, और इसे सीखने के तरीके क्या हैं।
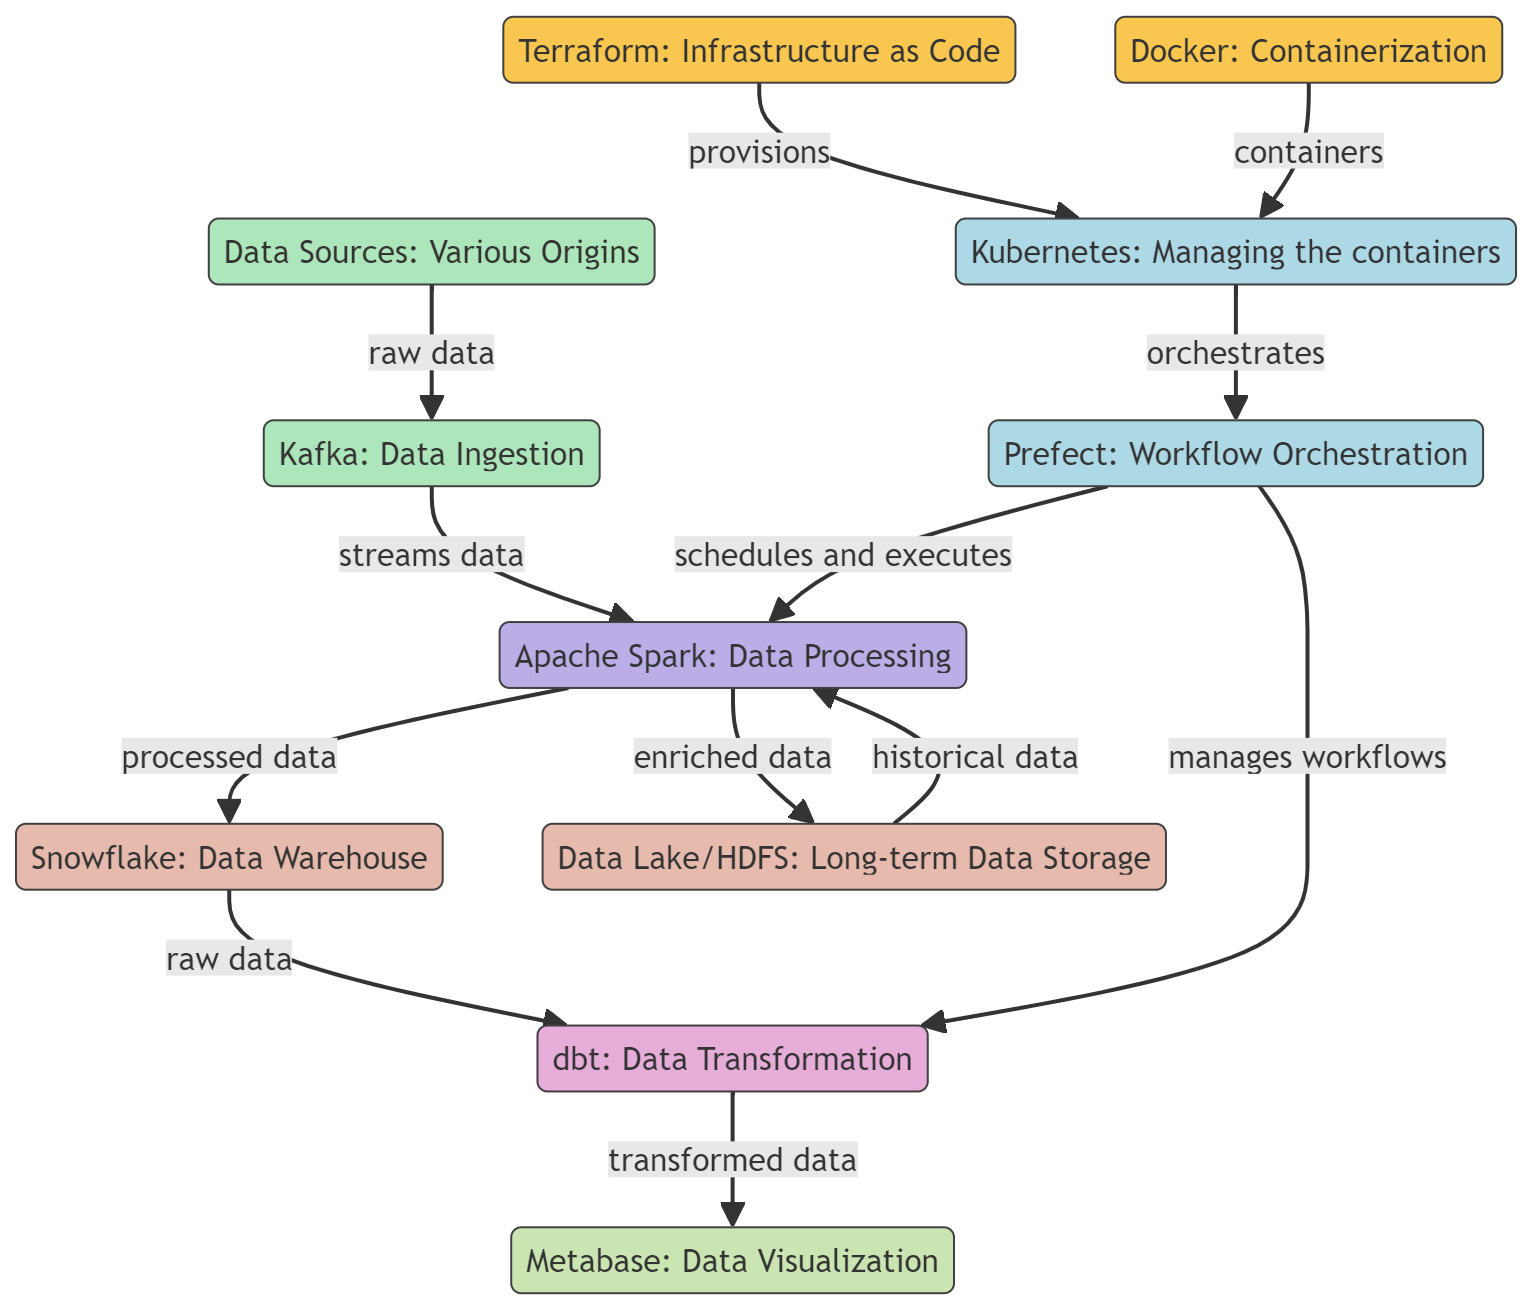
इस पोस्ट में, हम उन आवश्यक टूल्स के बारे में जानेंगे जो डेटा इंजीनियरों के बीच लोकप्रिय हैं और कई बार अनिवार्य भी। ये टूल्स डेटा के इन्गेस्ट, प्रोसेसिंग, स्टोरेज, ट्रांसफ़ॉर्मेशन और विज़ुअलाइज़ेशन के लिए उपयोग किए जाते हैं। इसके अलावा, हम कंटेनरीकरण और वर्कफ़्लो मैनेजमेंट के टूल्स पर भी नज़र डालेंगे।
हमारा ब्लॉग How to Become a Data Engineer पढ़कर आवश्यक डेटा इंजीनियरिंग कौशल सीखें।
कंटेनरीकरण टूल्स विभिन्न परिवेशों में अनुप्रयोगों को पैकेज, वितरित और प्रबंधित करने का मानकीकृत तरीका प्रदान करते हैं। यह डेटा इंजीनियरिंग वर्कफ़्लोज़ की स्थिरता, स्केलेबिलिटी और दक्षता सुनिश्चित करता है।
Docker एक लोकप्रिय कंटेनरीकरण प्लेटफ़ॉर्म है जिसका उपयोग अक्सर डेटा इंजीनियरिंग में डेटा टूल्स और अनुप्रयोगों को विकसित करने, शिप करने और चलाने के लिए किया जाता है। यह डेटा टूल्स और अनुप्रयोगों को पैकेज और डिप्लॉय करने का हल्का, पोर्टेबल और सुसंगत तरीका प्रदान करता है, जो डेटा इंजीनियरों के लिए इसे एक आदर्श विकल्प बनाता है।
Docker का उपयोग डेटाबेस, डेटा वेयरहाउस, डेटा प्रोसेसिंग फ्रेमवर्क और डेटा विज़ुअलाइज़ेशन टूल्स जैसे विभिन्न डेटा टूल्स के लिए कंटेनर बनाने और प्रबंधित करने में किया जा सकता है। और जानने के लिए हमारा Docker for Data Science ट्यूटोरियल देखें।
Kubernetes कंटेनराइज़्ड अनुप्रयोगों—जिनमें Docker का उपयोग करके बनाए गए ऐप्स भी शामिल हैं—की डिप्लॉयमेंट, स्केलिंग और प्रबंधन को स्वचालित करने के लिए एक ओपन-सोर्स प्लेटफ़ॉर्म है।
Docker एक ऐसा टूल है जिसका उपयोग डेटा प्रोसेसिंग अनुप्रयोगों, डेटाबेस और एनालिटिक्स टूल्स को कंटेनरों में पैकेज करने के लिए किया जा सकता है। यह वातावरणों में सुसंगति सुनिश्चित करता है और अनुप्रयोगों को आइसोलेट करता है। एक बार कंटेनर बन जाने के बाद, Kubernetes उनकी डिप्लॉयमेंट, वर्कलोड के आधार पर स्केलिंग और उच्च उपलब्धता सुनिश्चित करने को संभालते हुए उन्हें प्रबंधित करता है।
अलग लेख में Docker और Kubernetes का उपयोग करके कंटेनरीकरण के बारे में और जानें।
इंफ्रास्ट्रक्चर ऐज़ कोड (IaC) सामान्य-उद्देश्य प्रोग्रामिंग भाषाओं या YAML कॉन्फ़िगरेशन का उपयोग करके क्लाउड इंफ्रास्ट्रक्चर की डिप्लॉयमेंट और मेंटेनेंस को सरल बनाता है। यह दृष्टिकोण सुसंगत, दोहराने योग्य और स्वचालित परिवेश बनाने को बढ़ावा देता है, जिससे विकास, परीक्षण और प्रोडक्शन चरणों के बीच सुगम संक्रमण संभव होता है।
Terraform HashiCorp द्वारा बनाया गया एक ओपन-सोर्स इंफ्रास्ट्रक्चर ऐज़ कोड (IaC) टूल है। यह डेटा इंजीनियरों को घोषणात्मक कॉन्फ़िगरेशन भाषा का उपयोग करके डेटाबेस और डेटा पाइपलाइनों जैसी डेटा इंफ्रास्ट्रक्चर को सुसंगत और विश्वसनीय तरीके से परिभाषित और डिप्लॉय करने में सक्षम बनाता है, जो इंफ्रास्ट्रक्चर की वांछित अंतिम स्थिति का वर्णन करती है, न कि वहाँ तक पहुँचने के चरणों का।
Terraform वर्शन कंट्रोल, कोड के माध्यम से रिसोर्स प्रबंधन, टीम सहयोग और विभिन्न टूल्स व प्लेटफ़ॉर्म के साथ एकीकरण का समर्थन करता है।
Pulumi एक ओपन-सोर्स इंफ्रास्ट्रक्चर ऐज़ कोड टूल है जो डेवलपर्स को JavaScript, TypeScript, Java, Python, Go और C# जैसी सामान्य-उद्देश्य प्रोग्रामिंग भाषाओं का उपयोग करके क्लाउड इंफ्रास्ट्रक्चर बनाने, डिप्लॉय करने और प्रबंधित करने की अनुमति देता है। यह AWS, Azure, GCP और Kubernetes सहित व्यापक क्लाउड प्रदाताओं का समर्थन करता है।
Pulumi फ़्रेमवर्क एक डाउनलोड करने योग्य कमांड-लाइन इंटरफ़ेस (CLI), सॉफ़्टवेयर डेवलपमेंट किट (SDK) और डिप्लॉयमेंट इंजन प्रदान करता है, जो क्लाउड इंफ्रास्ट्रक्चर की प्रोविज़निंग, अपडेटिंग और मैनेजमेंट के लिए एक सुदृढ़ प्लेटफ़ॉर्म मुहैया कराता है।
वर्कफ़्लो ऑर्केस्ट्रेशन टूल्स जटिल डेटा प्रोसेसिंग वर्कफ़्लोज़ के निष्पादन को स्वचालित और प्रबंधित करते हैं, यह सुनिश्चित करते हुए कि निर्भरताओं को संभालते हुए कार्य सही क्रम में चलें।
Prefect आधुनिक डेटा वर्कफ़्लोज़ और ETL (extract, transform, load) प्रक्रियाओं के लिए एक ओपन-सोर्स वर्कफ़्लो ऑर्केस्ट्रेशन टूल है। यह डेटा इंजीनियरों और वैज्ञानिकों को जटिल डेटा पाइपलाइनों को स्वचालित और प्रबंधित करने में मदद करता है, यह सुनिश्चित करते हुए कि डेटा स्रोत से गंतव्य तक विश्वसनीयता और दक्षता के साथ सुचारू रूप से प्रवाहित हो।
Prefect एक हाइब्रिड निष्पादन मॉडल प्रदान करता है जो क्लाउड-आधारित मैनेजमेंट के फायदों को लोकल निष्पादन की सुरक्षा और नियंत्रण के साथ जोड़ता है। इसका उपयोगकर्ता-अनुकूल UI और समृद्ध API डेटा वर्कफ़्लोज़ की मॉनिटरिंग और ट्रबलशूटिंग को आसान बनाते हैं।
Luigi एक ओपन-सोर्स Python पैकेज है जो लंबे समय तक चलने वाले बैच जॉब्स की जटिल डेटा पाइपलाइनों के निर्माण में मदद करता है। इसे Spotify ने निर्भरता समाधान, वर्कफ़्लो मैनेजमेंट, विज़ुअलाइज़ेशन, विफलताओं को संभालने और कमांड लाइन इंटीग्रेशन के लिए विकसित किया।
Luigi विभिन्न कार्यों—जैसे डेटा प्रोसेसिंग, डेटा वैलिडेशन और डेटा एग्रीगेशन—को प्रबंधित करने के लिए डिज़ाइन किया गया है, और सरल से लेकर परिष्कृत डेटा वर्कफ़्लोज़ तक बनाने में उपयोग किया जा सकता है। Luigi को Apache Hadoop और Apache Spark जैसे विभिन्न टूल्स और प्लेटफ़ॉर्म्स के साथ एकीकृत किया जा सकता है, जिससे उपयोगकर्ता बड़े पैमाने पर डेटा को प्रोसेस और विश्लेषित करने के लिए डेटा पाइपलाइनों का निर्माण कर सकते हैं।
डेटा वेयरहाउस बड़े डेटासेट्स को स्टोर, क्वेरी और प्रबंधित करने के लिए उच्च स्केलेबल क्लाउड-आधारित समाधान प्रदान करते हैं।
Snowflake एक क्लाउड-आधारित डेटा वेयरहाउस है जो बड़े पैमाने पर डेटा के स्टोरेज, प्रोसेसिंग और विश्लेषणात्मक क्वेरीइंग को सक्षम बनाता है। यह एक अद्वितीय आर्किटेक्चर पर आधारित है जो स्टोरेज और कंप्यूट को अलग करता है, जिससे वे स्वतंत्र रूप से स्केल हो सकते हैं।
Snowflake माँग के आधार पर कंप्यूटिंग संसाधनों की मात्रा को डायनमिक रूप से समायोजित कर सकता है। यह सुनिश्चित करता है कि क्वेरी समय पर, कुशलता से और लागत-प्रभावी तरीके से प्रोसेस हों। यह प्रमुख क्लाउड प्रदाताओं—जैसे AWS, GCP और Azure—के साथ संगत है।
इस टूल का विस्तार से अन्वेषण करने के लिए हमारा Introduction to Snowflake course देखें।
PostgreSQL एक शक्तिशाली ओपन-सोर्स रिलेशनल डेटाबेस मैनेजमेंट सिस्टम (RDBMS) है जिसे डेटा वेयरहाउस के रूप में भी उपयोग किया जा सकता है। डेटा वेयरहाउस के रूप में, PostgreSQL विभिन्न स्रोतों से प्राप्त बड़े पैमाने पर संरचित डेटा को स्टोर, प्रबंधित और विश्लेषित करने के लिए एक केंद्रीकृत रिपॉज़िटरी प्रदान करता है।
PostgreSQL पार्टिशनिंग, इंडेक्सिंग और पैरेलल क्वेरी निष्पादन जैसी सुविधाएँ प्रदान करता है, जो इसे जटिल क्वेरीज और बड़े डेटा सेट्स को कुशलतापूर्वक संभालने में सक्षम बनाती हैं।
ध्यान दें, PostgreSQL डेटा वेयरहाउस एक लोकल समाधान है जो कुछ पूर्ण-प्रबंधित समाधानों जितना स्केल नहीं कर सकता। इन समाधानों की तुलना में इसमें अधिक मैनुअल प्रशासन और मेंटेनेंस की आवश्यकता होती है।
हमारे Beginner’s Guide to PostgreSQL में और जानें।
एनालिटिक्स इंजीनियरिंग टूल्स डेटा वेयरहाउस में डेटा के ट्रांसफ़ॉर्मेशन, टेस्टिंग और डॉक्यूमेंटेशन को सुव्यवस्थित करते हैं।
dbt (data build tool) एक ओपन-सोर्स कमांड-लाइन टूल और फ़्रेमवर्क है, जिसे डेटा वेयरहाउस वातावरण में डेटा ट्रांसफ़ॉर्मेशन वर्कफ़्लो और मॉडलिंग को सुगम बनाने के लिए डिज़ाइन किया गया है। यह Redshift, BigQuery, Snowflake और PostgreSQL सहित सभी प्रमुख डेटा वेयरहाउज़ का समर्थन करता है।
dbt तक पहुँच dbt Core या dbt Cloud के माध्यम से हो सकती है। dbt Cloud वेब-आधारित यूज़र इंटरफ़ेस, dbt Cloud-संचालित CLI, होस्टेड वातावरण, इन-ऐप जॉब शेड्यूलर और अन्य टूल्स के साथ इंटीग्रेशन प्रदान करता है।
हमारे Introduction to dbt course के साथ dbt की बुनियादी बातें समझें।
Metabase एक ओपन-सोर्स बिज़नेस इंटेलिजेंस (BI) और एनालिटिक्स टूल है जो उपयोगकर्ताओं को इंटरैक्टिव डैशबोर्ड और एनालिटिक्स रिपोर्ट बनाने और साझा करने में सक्षम बनाता है। इसे उपयोगकर्ता-अनुकूल बनाने के लिए डिज़ाइन किया गया है, जिससे गैर-तकनीकी उपयोगकर्ता भी बिना SQL या अन्य क्वेरी भाषाएँ जाने डेटा को क्वेरी कर सकें, परिणामों का विज़ुअलाइज़ेशन कर सकें और इनसाइट्स प्राप्त कर सकें।
यह आसान सेटअप, विभिन्न डेटा स्रोतों के लिए समर्थन, सरल यूज़र इंटरफ़ेस, सहयोग सुविधाएँ, अनुकूलन योग्य सूचनाएँ, और डेटा एक्सप्लोरेशन, विश्लेषण और साझा करने के लिए मज़बूत सुरक्षा प्रदान करता है।
डेटा एनालिटिक्स और डैशबोर्डिंग डेटा साइंस का हिस्सा हैं। इस लेख को पढ़कर Data Scientist और Data Engineer के बीच के अंतर के बारे में जानें: Data Scientist vs Data Engineer।
ये डेटा इंजीनियर टूल्स बड़े डेटा वॉल्यूम्स को बैचेज़ में कुशलतापूर्वक प्रोसेस करने, जटिल संगणनात्मक कार्यों, डेटा विश्लेषण और मशीन लर्निंग अनुप्रयोगों को वितरित कंप्यूटिंग वातावरणों में चलाने में सक्षम बनाते हैं।
Apache Spark बड़े पैमाने पर डेटा प्रोसेसिंग और विश्लेषण के लिए डिज़ाइन किया गया एक शक्तिशाली ओपन-सोर्स डिस्ट्रीब्यूटेड कंप्यूटिंग फ़्रेमवर्क है। जहाँ यह रीयल-टाइम स्ट्रीमिंग डेटा को संभालने की अपनी क्षमता के लिए जाना जाता है, वहीं Spark बैच प्रोसेसिंग में भी उत्कृष्ट है, जो इसे डेटा इंजीनियरिंग वर्कफ़्लोज़ में एक मूल्यवान टूल बनाता है।
Apache Spark में Resilient Distributed Datasets (RDDs), विभिन्न प्रोग्रामिंग भाषाओं के लिए समृद्ध APIs, क्लस्टर के कई नोड्स में डेटा प्रोसेसिंग, और अन्य टूल्स के साथ सहज एकीकरण जैसी विशेषताएँ हैं। यह अत्यधिक स्केलेबल और तेज़ है, जो इसे डेटा इंजीनियरिंग कार्यों में बैच प्रोसेसिंग के लिए आदर्श बनाता है।
Apache Hadoop बड़े डेटासेट्स के वितरित स्टोरेज और प्रोसेसिंग के लिए एक लोकप्रिय ओपन-सोर्स फ़्रेमवर्क है। Hadoop इकोसिस्टम के केंद्र में दो प्रमुख घटक हैं: स्टोरेज के लिए Hadoop Distributed File System (HDFS) और प्रोसेसिंग के लिए MapReduce प्रोग्रामिंग मॉडल।
Apache Hadoop डेटा इंजीनियरों के लिए एक शक्तिशाली और स्केलेबल टूल है, जो किफायती स्टोरेज, फ़ॉल्ट टॉलरेंस, वितरित प्रोसेसिंग क्षमताएँ, और अन्य डेटा प्रोसेसिंग टूल्स के साथ सहज एकीकरण प्रदान करता है।
स्ट्रीमिंग टूल्स रीयल-टाइम डेटा पाइपलाइनों के निर्माण का एक शक्तिशाली तरीका प्रदान करते हैं, जो स्ट्रीमिंग डेटा के सतत इन्गेस्ट, प्रोसेसिंग और विश्लेषण को सक्षम बनाते हैं।
Apache Kafka उच्च-प्रदर्शन, रीयल-टाइम डेटा प्रोसेसिंग और बड़े पैमाने पर डेटा पाइपलाइनों के सुव्यवस्थीकरण के लिए डिज़ाइन किया गया एक डिस्ट्रीब्यूटेड इवेंट स्ट्रीमिंग प्लेटफ़ॉर्म है। इसका उपयोग रीयल-टाइम डेटा पाइपलाइनों, स्ट्रीमिंग एनालिटिक्स, डेटा इंटीग्रेशन और मिशन-क्रिटिकल अनुप्रयोगों के निर्माण के लिए किया जाता है।
Kafka कम विलंबता के साथ बड़े पैमाने पर डेटा को संभालने वाला सिस्टम है। यह डेटा को वितरित और फ़ॉल्ट-टॉलरेंट तरीके से स्टोर करता है, यह सुनिश्चित करते हुए कि हार्डवेयर विफलता या नेटवर्क समस्याओं की स्थिति में भी डेटा उपलब्ध रहे।
Kafka अत्यधिक स्केलेबल है और कई सब्सक्राइबर्स का समर्थन करता है। यह Apache Spark, Apache Flink और Apache Storm जैसे विभिन्न डेटा प्रोसेसिंग टूल्स और फ़्रेमवर्क्स के साथ अच्छी तरह एकीकृत होता है।
Apache Flink डिस्ट्रीब्यूटेड स्ट्रीम और बैच प्रोसेसिंग के लिए एक ओपन-सोर्स प्लेटफ़ॉर्म है। यह रीयल-टाइम में डेटा स्ट्रीम्स को प्रोसेस कर सकता है, जिससे स्ट्रीमिंग डेटा पाइपलाइनों और रीयल-टाइम एनालिटिक्स अनुप्रयोगों के निर्माण के लिए यह एक लोकप्रिय विकल्प बनता है।
Flink एक डेटा प्रोसेसिंग टूल है जो रीयल-टाइम और बैच डेटा प्रोसेसिंग के लिए तेज़ और कुशल क्षमताएँ प्रदान करता है। यह कई APIs (जिनमें Java, Scala और Python शामिल हैं) का समर्थन करता है, अन्य डेटा प्रोसेसिंग टूल्स के साथ सहज एकीकरण सक्षम करता है, और कुशल स्टेट मैनेजमेंट प्रदान करता है। इसलिए, उच्च थ्रूपुट डेटा को कम विलंबता के साथ प्रोसेस करने की अपनी क्षमता के कारण, यह रीयल-टाइम एनालिटिक्स, धोखाधड़ी का पता लगाने और IoT अनुप्रयोगों के लिए लोकप्रिय विकल्प है।
हमारी सूची यहाँ पूरी होती है, लेकिन आपका डेटा इंजीनियरिंग सफ़र यहीं समाप्त नहीं होना चाहिए। Python, SQL, डेटाबेस डिज़ाइन, क्लाउड कंप्यूटिंग, डेटा क्लीनिंग और विज़ुअलाइज़ेशन सीखने के लिए Data Engineer in Python skill track में नामांकन करें। ट्रैक पूरा करने के बाद, आप Data Engineer Career Certification परीक्षा दे सकते हैं और एक प्रमाणित प्रोफ़ेशनल डेटा इंजीनियर बन सकते हैं।
डेटा इंजीनियर संगठन भर में एनालिटिक्स और निर्णय-निर्धारण को सक्षम करने वाली डेटा पाइपलाइनों के निर्माण और रखरखाव में महत्वपूर्ण भूमिका निभाते हैं। जैसे-जैसे डेटा की मात्रा और जटिलता तीव्र गति से बढ़ती जा रही है, डेटा इंजीनियरों को गुणवत्तापूर्ण डेटा को कुशलतापूर्वक इन्गेस्ट, प्रोसेस, स्टोर और डिलीवर करने के लिए सही टूल्स का लाभ उठाना चाहिए।
हमने कंटेनरीकरण, इंफ्रास्ट्रक्चर प्रोविज़निंग, वर्कफ़्लो ऑटोमेशन, डेटा वेयरहाउज़िंग, एनालिटिक्स इंजीनियरिंग, बैच प्रोसेसिंग और रीयल-टाइम स्ट्रीमिंग के लिए शीर्ष 14 डेटा इंजीनियरिंग टूल्स को कवर किया है।
यदि आप डेटा इंजीनियरिंग में नए हैं, तो Docker, Kubernetes, Terraform, Prefect, Snowflake, dbt, Apache Spark, Apache Kafka, और अन्य से शुरुआत करें।
इन टूल्स में दक्षता हासिल करने के बाद, अपने अगले करियर कदम के लिए तैयारी करने हेतु The Top 21 Data Engineering Interview Questions, Answers, and Examples की समीक्षा करें।
एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
आज ही अपना डेटा इंजीनियर सफ़र शुरू करें!
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
