
Last chance! 50% off DataCamp Premium
Sale ends in
Catatan: Tutorial ini terutama akan membahas implementasi praktis klasifikasi menggunakan convolutional neural network dan convolutional autoencoder. Jadi, jika Anda belum familiar dengan convolutional neural network (CNN) dan autoencoder, Anda mungkin ingin melihat tutorial CNN dan Autoencoder.
Secara lebih spesifik, Anda akan membahas topik-topik berikut dalam tutorial hari ini:
Sebelum mulai memuat dataset dan memprosesnya, ada baiknya memiliki gambaran singkat tentang seperti apa jenis datasetnya, bagaimana dimensinya, dan berapa banyak kelas berbeda yang ada dalam dataset.
Dataset Fashion-MNIST berisi gambar grayscale 28x28 dari 70.000 produk fesyen dari 10 kategori, dengan 7.000 gambar per kategori. Set pelatihan memiliki 60.000 gambar, dan set pengujian memiliki 10.000 gambar. Fashion-MNIST merupakan pengganti dataset MNIST asli untuk menghasilkan hasil yang lebih baik; dimensi gambar serta pembagian pelatihan dan uji serupa dengan dataset MNIST asli. Dataset ini tersedia gratis di URL ini dan dapat dimuat menggunakan tensorflow maupun keras sebagai kerangka kerja tanpa harus mengunduhnya ke komputer Anda.
Mirip dengan MNIST, Fashion-MNIST juga terdiri dari 10 kelas, tetapi alih-alih digit tulisan tangan, kita memiliki 10 kelas aksesori fesyen yang berbeda seperti sandal, kemeja, celana, dan sebagainya.
Tugas Anda adalah melatih convolutional autoencoder dan menggunakan bagian encoder dari autoencoder yang digabungkan dengan lapisan fully connected untuk mengenali sampel baru dari set uji secara benar.
Tip: jika Anda ingin belajar cara mengimplementasikan Multi-Layer Perceptron (MLP) untuk tugas klasifikasi dengan dataset MNIST, lihat tutorial ini.
Pada kode di bawah, Anda pada dasarnya menetapkan variabel lingkungan di notebook menggunakan os.environ. Sebaiknya lakukan hal berikut sebelum menginisialisasi Keras untuk membatasi backend TensorFlow Keras agar menggunakan GPU pertama. Jika mesin tempat Anda melatih memiliki GPU di 0, pastikan menggunakan 0 alih-alih 1. Anda bisa memeriksanya dengan menjalankan perintah sederhana di terminal: misalnya, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU 0
Selanjutnya, Anda mengimpor semua modul yang diperlukan seperti numpy, matplotlib, dan yang terpenting Keras, karena dalam tutorial hari ini Anda akan menggunakan keras sebagai kerangka kerja!
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
from keras.utils import to_categorical
Using TensorFlow backend.
/usr/local/lib/python2.7/dist-packages/h5py/__init__.py:34: FutureWarning: Conversion of the second argument of issubdtype from `float` to `np.floating` is deprecated. In future, it will be treated as `np.float64 == np.dtype(float).type`.
  from ._conv import register_converters as _register_converters
Di sini, Anda mendefinisikan fungsi yang membuka file gzip, membaca file menggunakan bytestream.read(). Anda meneruskan dimensi gambar dan jumlah total gambar ke fungsi ini. Lalu, menggunakan np.frombuffer(), Anda mengonversi string yang disimpan dalam variabel buf menjadi array NumPy bertipe float32.
Setelah dikonversi menjadi array NumPy, Anda membentuk ulang array menjadi array tiga dimensi atau tensor di mana dimensi pertama adalah jumlah gambar, dan dimensi kedua dan ketiga adalah dimensi gambar. Terakhir, Anda mengembalikan array NumPy data.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Sekarang Anda akan memanggil fungsi extract_data() dengan meneruskan file pelatihan dan pengujian beserta jumlah gambar masing-masing.
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
Demikian pula, Anda mendefinisikan fungsi ekstraksi label yang membuka file gzip, membaca file menggunakan bytestream.read(), yang Anda beri dimensi label (1) dan jumlah total gambar. Lalu, menggunakan np.frombuffer(), Anda mengonversi string yang disimpan dalam variabel buf menjadi array NumPy bertipe int64.
Kali ini, Anda tidak perlu membentuk ulang array karena variabel labels akan mengembalikan vektor kolom berdimensi 60.000 x 1. Terakhir, Anda mengembalikan array NumPy labels.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Sekarang Anda akan memanggil fungsi ekstrak label dengan meneruskan file label pelatihan dan pengujian beserta jumlah gambar masing-masing.
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Setelah Anda memuat data pelatihan dan pengujian, Anda siap untuk menganalisis data guna mendapatkan intuisi tentang dataset yang akan Anda gunakan dalam tutorial hari ini!
Sekarang mari kita analisis seperti apa tampilan gambar dalam dataset dan lihat juga dimensi gambarnya dengan bantuan atribut array NumPy .shape:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Dari output di atas, Anda dapat melihat bahwa data pelatihan memiliki bentuk 60000 x 28 x 28 karena ada 60.000 sampel pelatihan masing-masing berupa matriks berdimensi 28 x 28. Demikian pula, data uji memiliki bentuk 10000 x 28 x 28 karena ada 10.000 sampel uji.
Catatan bahwa dalam tugas rekonstruksi menggunakan convolutional autoencoder Anda tidak memerlukan label pelatihan dan pengujian. Gambar pelatihan Anda akan berperan sebagai masukan sekaligus ground truth mirip dengan label yang Anda miliki pada tugas klasifikasi.
Namun untuk tugas klasifikasi Anda juga akan membutuhkan label beserta gambar, yang akan Anda lakukan nanti dalam tutorial. Meskipun tugas saat ini hanya berurusan dengan gambar pelatihan dan pengujian, untuk tujuan eksplorasi yang mungkin memberi Anda intuisi lebih baik tentang data, Anda akan memanfaatkan label.
Mari buat kamus yang berisi nama kelas dengan label kelas kategorikal yang sesuai:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Sekarang, mari lihat beberapa gambar dalam dataset Anda:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[10], (28,28))
curr_lbl = train_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[10], (28,28))
curr_lbl = test_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
Text(0.5,1,'(Label: E)')
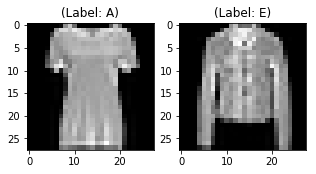
Keluaran dari dua plot di atas adalah salah satu gambar sampel dari data pelatihan dan pengujian, dan gambar-gambar ini diberi label kelas 0 atau A di satu sisi, dan 4 atau E di sisi lain. Demikian pula, alfabet lain akan memiliki label berbeda, tetapi alfabet yang sama akan memiliki label yang sama. Ini berarti semua 6.000 gambar kelas E akan memiliki label kelas 4.
Gambar dalam dataset memang merupakan gambar grayscale dengan nilai piksel antara 0 hingga 255 dengan dimensi 28 x 28, jadi sebelum kita memasukkan data ke dalam model, sangat penting untuk memprosesnya terlebih dahulu. Anda akan terlebih dahulu mengonversi setiap gambar 28 x 28 dari set train dan test menjadi matriks berukuran 28 x 28 x 1, yang dapat Anda masukkan ke dalam jaringan:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Selanjutnya, pastikan untuk memeriksa tipe data array NumPy pelatihan dan pengujian, seharusnya dalam format float32; jika tidak, Anda perlu mengonversinya ke format ini, tetapi karena Anda sudah mengonversinya saat membaca data, Anda tidak perlu melakukannya lagi. Anda juga harus melakukan penskalaan ulang nilai piksel ke rentang 0 - 1 inklusif. Mari kita lakukan!
Jangan lupa untuk memverifikasi tipe data pelatihan dan pengujian:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Selanjutnya, skala ulang data pelatihan dan pengujian dengan nilai piksel maksimum dari data pelatihan dan pengujian:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Mari verifikasi nilai maksimum data pelatihan dan pengujian yang seharusnya 1.0 setelah penskalaan ulang!
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Setelah semua ini, penting untuk melakukan partisi data. Agar model kita dapat melakukan generalisasi dengan baik, Anda membagi data pelatihan menjadi dua bagian: set pelatihan dan validasi. Anda akan melatih model pada 80% data dan memvalidasinya pada 20% sisa data pelatihan.
Ini juga akan membantu mengurangi kemungkinan overfitting, karena Anda akan memvalidasi model pada data yang tidak dilihat saat fase pelatihan.
Anda dapat menggunakan modul train_test_split dari scikit-learn untuk membagi data dengan benar:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Catatan: Anda akan menggunakan pembagian data di atas dua kali, sekali untuk tugas rekonstruksi menggunakan convolutional autoencoder yang tidak memerlukan label pelatihan dan pengujian. Itulah sebabnya Anda akan meneruskan gambar pelatihan dua kali. Gambar pelatihan Anda akan berperan sebagai masukan sekaligus ground truth mirip dengan label yang Anda miliki pada tugas klasifikasi.
Namun untuk tugas klasifikasi, Anda juga akan meneruskan label beserta gambar yang akan Anda lakukan nanti dalam tutorial.
Sekarang Anda siap untuk mendefinisikan jaringan dan memasukkan data ke dalam jaringan. Jadi tanpa berlama-lama, mari lanjut ke langkah berikutnya!
Gambar berukuran 28 x 28 x 1 atau vektor berdimensi 30976. Anda mengonversi matriks gambar menjadi array, melakukan penskalaan ulang antara 0 dan 1, membentuk ulang sehingga berukuran 28 x 28 x 1, dan memasukkan ini sebagai input ke jaringan.
Selain itu, Anda akan menggunakan ukuran batch 128; menggunakan ukuran batch yang lebih besar 256 atau 512 juga dapat dipertimbangkan—semuanya bergantung pada sistem tempat Anda melatih model. Ini sangat berkontribusi dalam menentukan parameter pembelajaran dan memengaruhi akurasi prediksi.
batch_size = 64
epochs = 200
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
num_classes = 10
Seperti yang mungkin sudah Anda ketahui, autoencoder terbagi menjadi dua bagian: encoder dan decoder.
Encoder: Memiliki 4 blok Konvolusi, tiap blok memiliki lapisan konvolusi diikuti lapisan normalisasi batch. Lapisan max-pooling digunakan setelah blok konvolusi pertama dan kedua.
Decoder: Memiliki 3 blok Konvolusi, tiap blok memiliki lapisan konvolusi diikuti lapisan normalisasi batch. Lapisan upsampling digunakan setelah blok konvolusi kedua dan ketiga.
Lapisan max-pooling akan melakukan downsampling input sebanyak dua kali setiap kali digunakan, sementara lapisan upsampling akan melakukan upsampling input sebanyak dua kali setiap kali digunakan.
Catatan: Jumlah filter, ukuran filter, jumlah lapisan, jumlah epoch pelatihan model, semuanya adalah hiperparameter dan harus diputuskan berdasarkan intuisi Anda sendiri; Anda bebas mencoba eksperimen baru dengan mengutak-atik hiperparameter ini dan mengukur performa model Anda. Dan dari situlah Anda perlahan belajar seni deep learning!
Mari buat fungsi encoder dan decoder terpisah karena Anda akan menggunakan bobot encoder nanti untuk tujuan klasifikasi!
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4

def decoder(conv4):
    #decoder
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv4) #7 x 7 x 128
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv5) #7 x 7 x 64
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up1 = UpSampling2D((2,2))(conv6) #14 x 14 x 64
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 32
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up2 = UpSampling2D((2,2))(conv7) # 28 x 28 x 32
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Setelah model dibuat, Anda harus mengompilasinya menggunakan optimizer RMSProp.
Perhatikan bahwa Anda juga harus menentukan jenis loss melalui argumen loss. Dalam kasus ini, yaitu mean squared error, karena loss setelah setiap batch akan dihitung antara batch keluaran yang diprediksi dan ground truth menggunakan mean squared error per piksel:
autoencoder = Model(input_img, decoder(encoder(input_img)))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Mari visualisasikan lapisan yang Anda buat pada langkah di atas menggunakan fungsi summary. Ini akan menampilkan jumlah parameter (bobot dan bias) di setiap lapisan dan juga total parameter dalam model Anda.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_16 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_15 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
...

batch_normalization_28 (Batc (None, 14, 14, 32)        128
_________________________________________________________________
up_sampling2d_4 (UpSampling2 (None, 28, 28, 32)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         289
=================================================================
Total params: 1,758,657
Trainable params: 1,755,841
Non-trainable params: 2,816
_________________________________________________________________
Akhirnya saatnya melatih model dengan fungsi fit() Keras! Model dilatih selama 200 epoch. Fungsi fit() akan mengembalikan objek history; Dengan menyimpan hasil fungsi ini pada autoencoder_train, Anda dapat menggunakannya nanti untuk memplot kurva loss antara pelatihan dan validasi yang akan membantu Anda menganalisis performa model secara visual.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/200
48000/48000 [==============================] - 19s - loss: 0.0202 - val_loss: 0.0114s: 0.020
Epoch 2/200
48000/48000 [==============================] - 17s - loss: 0.0087 - val_loss: 0.0071
...
Epoch 199/200
48000/48000 [==============================] - 18s - loss: 7.0886e-04 - val_loss: 8.9876e-04
Epoch 200/200
48000/48000 [==============================] - 18s - loss: 7.0929e-04 - val_loss: 0.0010
Akhirnya! Anda melatih model pada dataset fashion-mnist selama 100 epoch, Sekarang, mari plot kurva loss antara data pelatihan dan validasi untuk memvisualisasikan performa model.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
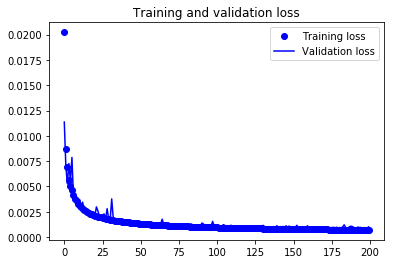
Akhirnya, Anda dapat melihat bahwa loss validasi dan loss pelatihan selaras. Ini menunjukkan bahwa model Anda tidak overfitting: loss validasi menurun dan tidak meningkat, dan jarang ada celah antara loss pelatihan dan validasi sepanjang fase pelatihan.
Karena itu, dapat dikatakan kemampuan generalisasi model Anda baik.
Tetapi ingat, tugas kita adalah menggunakan bagian encoder dari model yang telah dilatih di atas untuk mengklasifikasikan gambar fashion mnist. Jadi, mari lanjut ke bagian berikutnya sekarang!
Karena Anda akan memerlukan bobot encoder dalam tugas klasifikasi, pertama mari simpan bobot autoencoder lengkap. Anda akan mempelajari cara mengekstrak bobot encoder segera.
autoencoder.save_weights('autoencoder.h5')
Sekarang Anda akan menggunakan bagian kepala autoencoder terlatih, yaitu bagian encoder, dan akan memuat bobot autoencoder yang baru saja Anda latih hanya ke bagian encoder dari model.
Anda akan menambahkan beberapa lapisan dense atau fully connected pada encoder untuk mengklasifikasikan gambar fashion mnist.
Dalam one-hot encoding, Anda mengonversi data kategorikal menjadi vektor angka. Alasan mengapa Anda mengonversi data kategorikal ke one-hot encoding adalah karena algoritme pembelajaran mesin tidak dapat bekerja langsung dengan data kategorikal. Anda membuat satu kolom boolean untuk setiap kategori atau kelas. Hanya satu dari kolom ini yang dapat bernilai 1 untuk setiap sampel. Karena itulah disebut one-hot encoding.
Untuk pernyataan masalah Anda, one hot encoding akan berupa vektor baris, dan untuk setiap gambar, dimensinya 1 x 10. Hal penting yang perlu diperhatikan di sini adalah vektor terdiri dari semua nol kecuali untuk kelas yang diwakilinya, dan untuk kelas itu nilainya 1.
Jadi mari konversi label menjadi vektor one-hot encoding:
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_labels)
test_Y_one_hot = to_categorical(test_labels)

# Display the change for category label using one-hot encoding
print('Original label:', train_labels[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([0., 0., 0., 0., 0., 0., 0., 0., 0., 1.]))
Cukup jelas, bukan?
train_X,valid_X,train_label,valid_label = train_test_split(train_data,train_Y_one_hot,test_size=0.2,random_state=13)
Untuk terakhir kalinya mari periksa bentuk set pelatihan dan validasi.
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
Sekarang, mari definisikan model klasifikasi. Ingat bahwa Anda akan menggunakan bagian encoder yang persis sama seperti yang digunakan pada arsitektur autoencoder.
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4
Mari definisikan lapisan fully connected yang akan Anda tumpuk dengan fungsi encoder.
def fc(enco):
    flat = Flatten()(enco)
    den = Dense(128, activation='relu')(flat)
    out = Dense(num_classes, activation='softmax')(den)
    return out
encode = encoder(input_img)
full_model = Model(input_img,fc(encode))
for l1,l2 in zip(full_model.layers[:19],autoencoder.layers[0:19]):
    l1.set_weights(l2.get_weights())
Catatan: Langkah berikut cukup penting. Untuk memastikan apakah bobot pada bagian encoder autoencoder serupa dengan bobot yang Anda muat ke fungsi encoder model klasifikasi, Anda sebaiknya selalu mencetak bobot salah satu lapisan yang sama dari kedua model. Jika tidak serupa, maka tidak ada gunanya menggunakan strategi klasifikasi autoencoder.
Mari cetak bobot lapisan pertama dari kedua model.
autoencoder.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
full_model.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
Voila! Kedua array terlihat persis sama. Jadi, tanpa berlama-lama, mari kompilasi model dan mulai pelatihan.
Selanjutnya, Anda akan menjadikan bagian encoder yaitu sembilan belas lapisan pertama model tidak dapat dilatih. Karena bagian encoder sudah dilatih, Anda tidak perlu melatihnya. Anda hanya akan melatih bagian Fully Connected.
for layer in full_model.layers[0:19]:
    layer.trainable = False
Mari kompilasi model!
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Mari cetak ringkasan model juga. Seharusnya ada parameter yang tidak dapat dilatih karena Anda menjadikan lima belas lapisan pertama model tidak dapat dilatih.
full_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_53 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 28, 28, 32)        9248
_________________________________________________________________
batch_normalization_54 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
max_pooling2d_11 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_57 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
batch_normalization_55 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
conv2d_58 (Conv2D)           (None, 14, 14, 64)        36928
_________________________________________________________________
batch_normalization_56 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
max_pooling2d_12 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_59 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
batch_normalization_57 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_60 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
batch_normalization_58 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_61 (Conv2D)           (None, 7, 7, 256)         295168
_________________________________________________________________
batch_normalization_59 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
conv2d_62 (Conv2D)           (None, 7, 7, 256)         590080
_________________________________________________________________
batch_normalization_60 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
flatten_4 (Flatten)          (None, 12544)             0
_________________________________________________________________
dense_7 (Dense)              (None, 128)               1605760
_________________________________________________________________
dense_8 (Dense)              (None, 10)                1290
=================================================================
Total params: 2,782,570
Trainable params: 1,607,050
Non-trainable params: 1,175,520
_________________________________________________________________
Akhirnya saatnya melatih model dengan fungsi fit() Keras! Model dilatih selama 10 epoch. Fungsi fit() akan mengembalikan objek history; Dengan menyimpan hasil fungsi ini pada fashion_train, Anda dapat menggunakannya nanti untuk memplot akurasi dan loss antara pelatihan dan validasi yang akan membantu Anda menganalisis performa model secara visual.
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 6s - loss: 0.3747 - acc: 0.8732 - val_loss: 0.2888 - val_acc: 0.8935
Epoch 2/100
48000/48000 [==============================] - 6s - loss: 0.2216 - acc: 0.9178 - val_loss: 0.2942 - val_acc: 0.9010
Epoch 3/100
48000/48000 [==============================] - 5s - loss: 0.1762 - acc: 0.9340 - val_loss: 0.2868 - val_acc: 0.9078
...
Epoch 74/100
48000/48000 [==============================] - 6s - loss: 0.0182 - acc: 0.9953 - val_loss: 0.8069 - val_acc: 0.9109
Epoch 75/100
48000/48000 [==============================] - 6s - loss: 0.0102 - acc: 0.9971 - val_loss: 0.7872 - val_acc: 0.9125
Epoch 76/100
11776/48000 [======>.......................] - ETA: 3s - loss: 0.0084 - acc: 0.9977
Akhirnya! Anda melatih model pada fashion-MNIST hanya selama 10 epoch, dan dengan mengamati akurasi dan loss pelatihan, Anda dapat mengatakan bahwa model bekerja dengan sangat baik karena setelah 10 epoch akurasi pelatihan 99% dan loss validasi 98%.
Mari simpan model klasifikasi!
full_model.save_weights('autoencoder_classification.h5')
Selanjutnya, Anda akan melatih ulang model dengan menjadikan sembilan belas lapisan pertama dapat dilatih True alih-alih menjaganya False! Jadi, mari cepat lakukan itu.
for layer in full_model.layers[0:19]:
    layer.trainable = True
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Sekarang mari latih seluruh model untuk terakhir kalinya!
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 13s - loss: 0.1584 - acc: 0.9718 - val_loss: 0.7902 - val_acc: 0.8960
Epoch 2/100
48000/48000 [==============================] - 12s - loss: 0.1049 - acc: 0.9759 - val_loss: 0.8327 - val_acc: 0.8893
Epoch 3/100
48000/48000 [==============================] - 12s - loss: 0.0792 - acc: 0.9804 - val_loss: 0.6947 - val_acc: 0.9099
...
loss: 0.0123 - acc: 0.9971 - val_loss: 0.6827 - val_acc: 0.9217
Epoch 98/100
48000/48000 [==============================] - 13s - loss: 0.0097 - acc: 0.9975 - val_loss: 0.7074 - val_acc: 0.9211
Epoch 99/100
48000/48000 [==============================] - 13s - loss: 0.0081 - acc: 0.9984 - val_loss: 0.6846 - val_acc: 0.9205
Epoch 100/100
48000/48000 [==============================] - 13s - loss: 0.0090 - acc: 0.9977 - val_loss: 0.6739 - val_acc: 0.9226
Mari simpan model untuk terakhir kalinya.
full_model.save_weights('classification_complete.h5')
Mari letakkan evaluasi model Anda dalam perspektif dan plot kurva akurasi dan loss antara data pelatihan dan validasi:
accuracy = classify_train.history['acc']
val_accuracy = classify_train.history['val_acc']
loss = classify_train.history['loss']
val_loss = classify_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
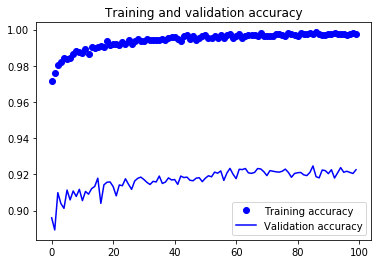
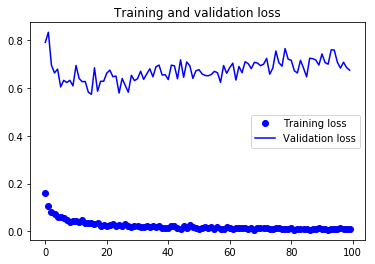
Dari dua plot di atas, Anda dapat melihat bahwa model mengalami overfitting karena ada celah besar antara loss pelatihan dan validasi. Untuk mengatasi overfitting, Anda mungkin harus menggunakan beberapa teknik regularisasi seperti Dropout. Anda dapat mengikuti tutorial ini tentang CNN di Python dengan keras.
Terakhir, mari evaluasi model Anda juga pada data uji dan lihat bagaimana performanya!
test_eval = full_model.evaluate(test_data, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.7068972043234281)
('Test accuracy:', 0.9205)
predicted_classes = full_model.predict(test_data)
Karena prediksi yang Anda dapatkan berupa nilai floating point, tidak akan mudah membandingkan label yang diprediksi dengan label uji yang benar. Jadi, Anda akan membulatkan keluaran yang akan mengonversi nilai float menjadi integer. Selanjutnya, Anda akan menggunakan np.argmax() untuk memilih nomor indeks yang memiliki nilai lebih tinggi dalam satu baris.
Misalnya, anggap satu prediksi untuk satu gambar uji adalah [0 1 0 0 0 0 0 0 0 0], keluaran untuk ini seharusnya label kelas 1.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_labels.shape
((10000,), (10000,))
correct = np.where(predicted_classes==test_labels)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_labels[correct]))
    plt.tight_layout()
Found 9204 correct labels
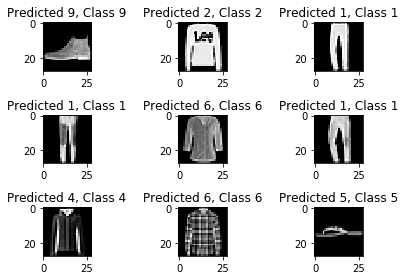
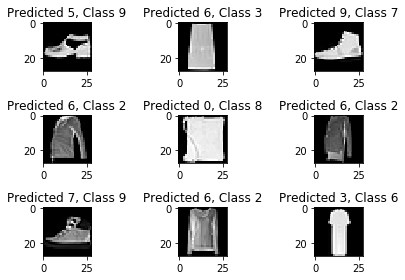
incorrect = np.where(predicted_classes!=test_labels)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_labels[incorrect]))
    plt.tight_layout()
Found 796 incorrect labels
Laporan klasifikasi akan membantu Anda mengidentifikasi kelas yang salah klasifikasi secara lebih rinci. Anda akan dapat mengamati untuk kelas mana model berkinerja buruk dari sepuluh kelas yang ada.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_labels, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.83      0.89      0.86      1000
    Class 1       0.99      0.99      0.99      1000
    Class 2       0.89      0.87      0.88      1000
    Class 3       0.92      0.93      0.92      1000
    Class 4       0.85      0.90      0.88      1000
    Class 5       0.99      0.99      0.99      1000
    Class 6       0.81      0.72      0.76      1000
    Class 7       0.96      0.98      0.97      1000
    Class 8       0.98      0.98      0.98      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Tutorial ini merupakan awal yang baik untuk menggunakan autoencoder dan convolutional neural network yang fully connected dengan Python dan Keras. Jika Anda dapat mengikutinya dengan mudah atau bahkan dengan sedikit usaha lebih, bagus! Cobalah melakukan beberapa eksperimen mungkin dengan arsitektur model yang sama tetapi menggunakan berbagai jenis dataset publik yang tersedia.
Masih banyak yang harus dipelajari, jadi mengapa tidak mengambil kursus Deep Learning in Python dari DataCamp? Sambil menunggu, pastikan juga untuk memeriksa dokumentasi Keras, jika Anda belum melakukannya. Anda akan menemukan lebih banyak contoh dan informasi tentang semua fungsi, argumen, lebih banyak lapisan, dan lain-lain. Ini pasti akan menjadi sumber yang tak tergantikan saat Anda belajar cara bekerja dengan neural network di Python!
Jika Anda lebih suka membaca buku yang menjelaskan dasar-dasar deep learning (dengan Keras) beserta penggunaannya dalam praktik, Anda harus membaca buku Deep Learning in Python karya François Chollet.
Kursus Python
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



