Khóa học
Nhập môn Deep Learning với Python
4 giờ
264.8K
Lưu ý: Hướng dẫn này chủ yếu tập trung vào triển khai thực tiễn việc phân loại bằng mạng nơ-ron tích chập và autoencoder tích chập. Vì vậy, nếu bạn chưa nắm rõ về mạng nơ-ron tích chập (CNN) và autoencoder, bạn có thể xem các hướng dẫn về CNN và Autoencoder.
Cụ thể hơn, hôm nay bạn sẽ tìm hiểu các chủ đề sau:
Trước khi bắt đầu tải và xử lý bộ dữ liệu, tốt hơn hết là có một trực giác ngắn gọn về loại dữ liệu, kích thước dữ liệu và có bao nhiêu lớp khác nhau trong bộ dữ liệu.
Bộ dữ liệu Fashion-MNIST gồm 70.000 ảnh thang xám kích thước 28x28 về các sản phẩm thời trang thuộc 10 danh mục, mỗi danh mục có 7.000 ảnh. Tập huấn luyện có 60.000 ảnh, và tập kiểm tra có 10.000 ảnh. Fashion-MNIST được dùng thay thế cho MNIST gốc nhằm cho kết quả tốt hơn; kích thước ảnh, cách chia tập huấn luyện và kiểm tra tương tự như MNIST gốc. Bộ dữ liệu được cung cấp miễn phí tại URL này và có thể tải trực tiếp bằng tensorflow và keras mà không cần tải về máy tính của bạn.
Tương tự MNIST, Fashion-MNIST cũng có 10 lớp, nhưng thay vì chữ số viết tay, ta có 10 lớp phụ kiện thời trang như dép quai hậu, áo sơ mi, quần, v.v.
Nhiệm vụ là huấn luyện một autoencoder tích chập và sử dụng phần encoder của autoencoder kết hợp với các lớp fully connected để nhận dạng chính xác một mẫu mới từ tập kiểm tra.
Mẹo: nếu bạn muốn học cách triển khai Mạng Perceptron Nhiều Lớp (MLP) cho bài toán phân loại với bộ dữ liệu MNIST, hãy xem hướng dẫn này.
Trong đoạn mã dưới đây, về cơ bản bạn đặt các biến môi trường trong notebook bằng os.environ. Nên làm điều sau trước khi khởi tạo Keras để giới hạn backend TensorFlow chỉ dùng GPU đầu tiên. Nếu máy bạn huấn luyện có GPU ở vị trí 0, hãy dùng 0 thay vì 1. Bạn có thể kiểm tra bằng một lệnh đơn giản trong terminal: ví dụ, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU 0
Tiếp theo, bạn nhập tất cả các mô-đun cần thiết như numpy, matplotlib và quan trọng nhất là Keras, vì trong hướng dẫn hôm nay bạn sẽ dùng keras làm framework!
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
from keras.utils import to_categorical
Using TensorFlow backend.
/usr/local/lib/python2.7/dist-packages/h5py/__init__.py:34: FutureWarning: Conversion of the second argument of issubdtype from `float` to `np.floating` is deprecated. In future, it will be treated as `np.float64 == np.dtype(float).type`.
  from ._conv import register_converters as _register_converters
Tại đây, bạn định nghĩa một hàm mở tệp gzip, đọc tệp bằng bytestream.read(). Bạn truyền vào hàm này kích thước ảnh và tổng số ảnh bạn có. Sau đó, dùng np.frombuffer(), bạn chuyển chuỗi được lưu trong biến buf thành mảng NumPy kiểu float32.
Sau khi chuyển sang mảng NumPy, bạn reshape mảng thành mảng ba chiều hoặc tensor, trong đó chiều thứ nhất là số lượng ảnh, chiều thứ hai và thứ ba là kích thước ảnh. Cuối cùng, bạn trả về mảng NumPy data.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Bây giờ bạn sẽ gọi hàm extract_data() bằng cách truyền vào các tệp huấn luyện và kiểm tra cùng số lượng ảnh tương ứng.
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
Tương tự, bạn định nghĩa một hàm trích xuất nhãn mở tệp gzip, đọc tệp bằng bytestream.read(), trong đó bạn truyền kích thước nhãn (1) và tổng số ảnh. Sau đó, dùng np.frombuffer(), bạn chuyển chuỗi trong biến buf thành mảng NumPy kiểu int64.
Lần này, bạn không cần reshape mảng vì biến labels sẽ trả về một vector cột kích thước 60.000 x 1. Cuối cùng, bạn trả về mảng NumPy labels.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Bây giờ bạn sẽ gọi hàm trích xuất nhãn bằng cách truyền vào các tệp nhãn huấn luyện và kiểm tra cùng số lượng ảnh tương ứng.
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Khi đã tải xong dữ liệu huấn luyện và kiểm tra, bạn sẵn sàng phân tích dữ liệu để có trực giác về bộ dữ liệu sẽ làm việc trong hướng dẫn hôm nay!
Giờ hãy phân tích xem ảnh trong bộ dữ liệu trông như thế nào và xem kích thước ảnh với thuộc tính .shape của mảng NumPy:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Từ kết quả trên, bạn thấy dữ liệu huấn luyện có dạng 60000 x 28 x 28 vì có 60.000 mẫu huấn luyện, mỗi mẫu là ma trận 28 x 28. Tương tự, dữ liệu kiểm tra có dạng 10000 x 28 x 28 vì có 10.000 mẫu kiểm tra.
Lưu ý rằng trong tác vụ tái dựng bằng autoencoder tích chập, bạn sẽ không cần nhãn huấn luyện và kiểm tra. Ảnh huấn luyện vừa là đầu vào vừa là ground truth tương tự như nhãn trong bài toán phân loại.
Nhưng với bài toán phân loại, bạn sẽ cần cả nhãn đi kèm ảnh, điều này bạn sẽ thực hiện ở phần sau của hướng dẫn. Mặc dù nhiệm vụ hiện tại chỉ xử lý ảnh huấn luyện và kiểm tra, nhưng vì mục đích khám phá để có trực giác tốt hơn về dữ liệu, bạn sẽ sử dụng nhãn.
Hãy tạo một từ điển ánh xạ tên lớp với nhãn phân loại tương ứng:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Bây giờ, hãy xem thử một vài ảnh trong bộ dữ liệu:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[10], (28,28))
curr_lbl = train_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[10], (28,28))
curr_lbl = test_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
Text(0.5,1,'(Label: E)')
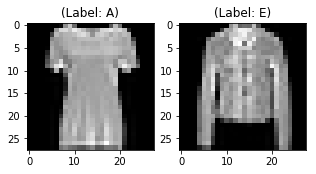
Kết quả của hai biểu đồ trên là một trong các ảnh mẫu từ cả dữ liệu huấn luyện và kiểm tra, và các ảnh này được gán nhãn lớp 0 hay A ở một bên, và 4 hay E ở bên kia. Tương tự, các chữ cái khác sẽ có nhãn khác nhau, còn các chữ cái giống nhau sẽ có cùng nhãn. Điều này có nghĩa là toàn bộ 6.000 ảnh lớp E sẽ có nhãn lớp là 4.
Các ảnh trong bộ dữ liệu là ảnh thang xám với giá trị pixel từ 0 đến 255 và kích thước 28 x 28, vì vậy trước khi đưa dữ liệu vào mô hình, việc tiền xử lý là rất quan trọng. Trước tiên, bạn sẽ chuyển mỗi ảnh 28 x 28 của tập train và test thành ma trận kích thước 28 x 28 x 1, có thể đưa vào mạng:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Tiếp theo, bạn cần kiểm tra kiểu dữ liệu của các mảng NumPy huấn luyện và kiểm tra; chúng phải ở định dạng float32, nếu không bạn sẽ cần chuyển đổi. Nhưng vì bạn đã chuyển đổi trong lúc đọc dữ liệu, bạn không cần làm lại bước này. Bạn cũng phải chuẩn hóa giá trị pixel về khoảng 0 - 1. Hãy thực hiện!
Đừng quên xác minh kiểu dữ liệu của tập huấn luyện và kiểm tra:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Tiếp theo, chuẩn hóa dữ liệu huấn luyện và kiểm tra theo giá trị pixel tối đa của chúng:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Hãy kiểm tra lại giá trị tối đa của tập huấn luyện và kiểm tra, sau khi chuẩn hóa phải là 1.0!
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Sau tất cả, việc chia dữ liệu là quan trọng. Để mô hình tổng quát hóa tốt, bạn chia dữ liệu huấn luyện thành hai phần: huấn luyện và xác thực. Bạn sẽ huấn luyện mô hình trên 80% dữ liệu và xác thực trên 20% còn lại.
Điều này cũng giúp giảm khả năng overfitting, vì bạn sẽ xác thực mô hình trên dữ liệu mà nó không thấy trong giai đoạn huấn luyện.
Bạn có thể dùng mô-đun train_test_split của scikit-learn để chia dữ liệu hợp lý:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Lưu ý: Bạn sẽ dùng cách chia dữ liệu trên hai lần, một lần cho tác vụ tái dựng bằng autoencoder tích chập, vốn không cần nhãn huấn luyện và kiểm tra. Đó là lý do bạn truyền ảnh huấn luyện hai lần. Ảnh huấn luyện vừa là đầu vào vừa là ground truth tương tự nhãn trong bài toán phân loại.
Còn với bài toán phân loại, bạn sẽ truyền cả nhãn đi kèm ảnh, điều này sẽ thực hiện ở phần sau của hướng dẫn.
Bây giờ bạn đã sẵn sàng định nghĩa mạng và đưa dữ liệu vào mạng. Không chần chờ nữa, sang bước tiếp theo!
Các ảnh có kích thước 28 x 28 x 1 hay vector 30976 chiều. Bạn chuyển ma trận ảnh thành mảng, chuẩn hóa về khoảng 0 đến 1, reshape về kích thước 28 x 28 x 1, và đưa làm đầu vào cho mạng.
Bạn sẽ dùng batch size 128; dùng batch lớn hơn như 256 hoặc 512 cũng tốt, tùy hệ thống bạn huấn luyện. Nó ảnh hưởng nhiều đến việc xác định tham số học và độ chính xác dự đoán.
batch_size = 64
epochs = 200
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
num_classes = 10
Như bạn đã biết, autoencoder chia làm hai phần: encoder và decoder.
Encoder: Gồm 4 khối Tích chập, mỗi khối có một lớp tích chập theo sau là lớp chuẩn hóa theo batch. Lớp gộp cực đại (max-pooling) được dùng sau khối tích chập thứ nhất và thứ hai.
Decoder: Gồm 3 khối Tích chập, mỗi khối có một lớp tích chập theo sau là lớp chuẩn hóa theo batch. Lớp tăng mẫu (upsampling) được dùng sau khối tích chập thứ hai và thứ ba.
Lớp max-pooling sẽ giảm kích thước đầu vào xuống hai lần mỗi khi dùng, trong khi lớp upsampling sẽ tăng kích thước đầu vào lên hai lần mỗi khi dùng.
Lưu ý: Số lượng bộ lọc, kích thước bộ lọc, số lớp, số epoch bạn huấn luyện... đều là siêu tham số và nên được quyết định dựa trên trực giác của bạn; bạn có thể thử nghiệm điều chỉnh các siêu tham số này và đo lường hiệu năng mô hình. Đó cũng là cách bạn dần học được “nghệ thuật” học sâu!
Hãy tạo riêng các hàm encoder và decoder vì sau này bạn sẽ dùng trọng số encoder cho mục đích phân loại!
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4

def decoder(conv4):
    #decoder
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv4) #7 x 7 x 128
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv5) #7 x 7 x 64
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up1 = UpSampling2D((2,2))(conv6) #14 x 14 x 64
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 32
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up2 = UpSampling2D((2,2))(conv7) # 28 x 28 x 32
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Sau khi tạo mô hình, bạn cần biên dịch với bộ tối ưu hóa RMSProp.
Lưu ý bạn cũng phải chỉ định loại loss qua tham số loss. Ở đây là mean squared error, vì loss sau mỗi batch sẽ được tính giữa đầu ra dự đoán và ground truth bằng sai số bình phương trung bình theo từng pixel:
autoencoder = Model(input_img, decoder(encoder(input_img)))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Hãy dùng hàm summary để trực quan hóa các lớp bạn đã tạo ở bước trên. Điều này sẽ hiển thị số lượng tham số (trọng số và bias) ở mỗi lớp và tổng tham số của mô hình.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_16 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_15 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
...

batch_normalization_28 (Batc (None, 14, 14, 32)        128
_________________________________________________________________
up_sampling2d_4 (UpSampling2 (None, 28, 28, 32)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         289
=================================================================
Total params: 1,758,657
Trainable params: 1,755,841
Non-trainable params: 2,816
_________________________________________________________________
Đến lúc huấn luyện mô hình với hàm fit() của Keras! Mô hình được huấn luyện trong 200 epoch. Hàm fit() sẽ trả về một đối tượng history; Bằng cách lưu kết quả vào autoencoder_train, bạn có thể dùng sau để vẽ biểu đồ loss giữa train và validation giúp bạn phân tích trực quan hiệu năng mô hình.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/200
48000/48000 [==============================] - 19s - loss: 0.0202 - val_loss: 0.0114s: 0.020
Epoch 2/200
48000/48000 [==============================] - 17s - loss: 0.0087 - val_loss: 0.0071
...
Epoch 199/200
48000/48000 [==============================] - 18s - loss: 7.0886e-04 - val_loss: 8.9876e-04
Epoch 200/200
48000/48000 [==============================] - 18s - loss: 7.0929e-04 - val_loss: 0.0010
Cuối cùng! Bạn đã huấn luyện mô hình trên bộ dữ liệu fashion-mnist trong 100 epoch, giờ hãy vẽ biểu đồ loss giữa train và validation để trực quan hóa hiệu năng mô hình.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
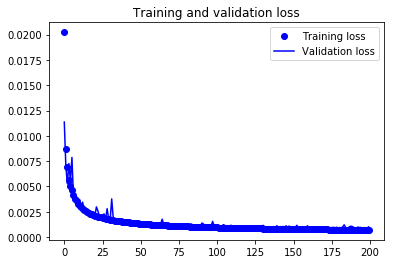
Bạn có thể thấy loss của validation và training đồng bộ với nhau. Điều này cho thấy mô hình không bị overfit: validation loss giảm và không tăng, và hầu như không có khoảng cách giữa training và validation loss trong suốt quá trình huấn luyện.
Vì vậy, có thể nói khả năng tổng quát hóa của mô hình là tốt.
Nhưng hãy nhớ nhiệm vụ là sử dụng phần encoder của mô hình trên để phân loại ảnh fashion mnist. Vậy hãy chuyển sang phần tiếp theo!
Vì bạn sẽ cần trọng số encoder cho bài toán phân loại, trước hết hãy lưu toàn bộ trọng số autoencoder. Bạn sẽ học cách trích xuất trọng số encoder ngay sau đây.
autoencoder.save_weights('autoencoder.h5')
Bây giờ bạn sẽ dùng phần đầu của autoencoder đã huấn luyện, tức phần encoder, và nạp trọng số của autoencoder vừa huấn luyện chỉ vào phần encoder của mô hình.
Bạn sẽ thêm một vài lớp dày (dense) hay fully connected vào encoder để phân loại ảnh fashion mnist.
Trong one-hot encoding, bạn chuyển dữ liệu phân loại thành vector số. Lý do phải chuyển dữ liệu phân loại sang one-hot là vì các thuật toán học máy không thể làm việc trực tiếp với dữ liệu phân loại. Bạn tạo một cột boolean cho mỗi danh mục hoặc lớp. Với mỗi mẫu, chỉ một trong các cột này mang giá trị 1. Do đó có tên gọi one-hot encoding.
Trong bài toán của bạn, one-hot encoding sẽ là vector hàng, và với mỗi ảnh sẽ có kích thước 1 x 10. Điều quan trọng cần lưu ý là vector gồm toàn số 0 ngoại trừ vị trí lớp mà nó đại diện, vị trí đó là 1.
Vậy hãy chuyển nhãn sang vector one-hot:
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_labels)
test_Y_one_hot = to_categorical(test_labels)

# Display the change for category label using one-hot encoding
print('Original label:', train_labels[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([0., 0., 0., 0., 0., 0., 0., 0., 0., 1.]))
Rất rõ ràng, đúng không?
train_X,valid_X,train_label,valid_label = train_test_split(train_data,train_Y_one_hot,test_size=0.2,random_state=13)
Thêm một lần nữa, hãy kiểm tra kích thước của tập huấn luyện và xác thực.
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
Bây giờ, hãy định nghĩa mô hình phân loại. Hãy nhớ bạn sẽ dùng đúng phần encoder như trong kiến trúc autoencoder.
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4
Hãy định nghĩa các lớp fully connected mà bạn sẽ ghép với hàm encoder.
def fc(enco):
    flat = Flatten()(enco)
    den = Dense(128, activation='relu')(flat)
    out = Dense(num_classes, activation='softmax')(den)
    return out
encode = encoder(input_img)
full_model = Model(input_img,fc(encode))
for l1,l2 in zip(full_model.layers[:19],autoencoder.layers[0:19]):
    l1.set_weights(l2.get_weights())
Lưu ý: Bước tiếp theo rất quan trọng. Để chắc chắn trọng số của phần encoder trong autoencoder giống với trọng số bạn đã nạp vào hàm encoder của mô hình phân loại, bạn nên in trọng số của một lớp trùng nhau ở cả hai mô hình. Nếu chúng không giống nhau, thì chiến lược phân loại bằng autoencoder là vô ích.
Hãy in trọng số lớp đầu tiên của cả hai mô hình.
autoencoder.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
full_model.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
Tuyệt vời! Cả hai mảng hoàn toàn giống nhau. Vậy không chần chờ nữa, hãy biên dịch mô hình và bắt đầu huấn luyện.
Tiếp theo, bạn sẽ đặt phần encoder, tức mười chín lớp đầu tiên của mô hình, thành không huấn luyện. Vì encoder đã được huấn luyện, bạn không cần huấn luyện lại. Bạn chỉ huấn luyện phần Fully Connected.
for layer in full_model.layers[0:19]:
    layer.trainable = False
Hãy biên dịch mô hình!
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Hãy in summary của mô hình. Sẽ có các tham số không thể huấn luyện vì bạn đã đặt mười lăm lớp đầu không huấn luyện.
full_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_53 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 28, 28, 32)        9248
_________________________________________________________________
batch_normalization_54 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
max_pooling2d_11 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_57 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
batch_normalization_55 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
conv2d_58 (Conv2D)           (None, 14, 14, 64)        36928
_________________________________________________________________
batch_normalization_56 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
max_pooling2d_12 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_59 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
batch_normalization_57 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_60 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
batch_normalization_58 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_61 (Conv2D)           (None, 7, 7, 256)         295168
_________________________________________________________________
batch_normalization_59 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
conv2d_62 (Conv2D)           (None, 7, 7, 256)         590080
_________________________________________________________________
batch_normalization_60 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
flatten_4 (Flatten)          (None, 12544)             0
_________________________________________________________________
dense_7 (Dense)              (None, 128)               1605760
_________________________________________________________________
dense_8 (Dense)              (None, 10)                1290
=================================================================
Total params: 2,782,570
Trainable params: 1,607,050
Non-trainable params: 1,175,520
_________________________________________________________________
Đến lúc huấn luyện mô hình với hàm fit() của Keras! Mô hình huấn luyện 10 epoch. Hàm fit() trả về một đối tượng history; Lưu kết quả vào fashion_train, bạn có thể dùng sau để vẽ biểu đồ độ chính xác và hàm mất mát giữa train và validation giúp bạn phân tích trực quan hiệu năng mô hình.
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 6s - loss: 0.3747 - acc: 0.8732 - val_loss: 0.2888 - val_acc: 0.8935
Epoch 2/100
48000/48000 [==============================] - 6s - loss: 0.2216 - acc: 0.9178 - val_loss: 0.2942 - val_acc: 0.9010
Epoch 3/100
48000/48000 [==============================] - 5s - loss: 0.1762 - acc: 0.9340 - val_loss: 0.2868 - val_acc: 0.9078
...
Epoch 74/100
48000/48000 [==============================] - 6s - loss: 0.0182 - acc: 0.9953 - val_loss: 0.8069 - val_acc: 0.9109
Epoch 75/100
48000/48000 [==============================] - 6s - loss: 0.0102 - acc: 0.9971 - val_loss: 0.7872 - val_acc: 0.9125
Epoch 76/100
11776/48000 [======>.......................] - ETA: 3s - loss: 0.0084 - acc: 0.9977
Cuối cùng! Bạn đã huấn luyện mô hình trên Fashion-MNIST chỉ 10 epoch, và quan sát độ chính xác và loss huấn luyện, có thể nói mô hình hoạt động rất tốt vì sau 10 epoch, độ chính xác huấn luyện là 99% và loss xác thực là 98%.
Hãy lưu mô hình phân loại!
full_model.save_weights('autoencoder_classification.h5')
Tiếp theo, bạn sẽ huấn luyện lại mô hình bằng cách đặt mười chín lớp đầu có thể huấn luyện (True) thay vì để False! Hãy thực hiện nhanh.
for layer in full_model.layers[0:19]:
    layer.trainable = True
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Bây giờ hãy huấn luyện toàn bộ mô hình lần cuối!
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 13s - loss: 0.1584 - acc: 0.9718 - val_loss: 0.7902 - val_acc: 0.8960
Epoch 2/100
48000/48000 [==============================] - 12s - loss: 0.1049 - acc: 0.9759 - val_loss: 0.8327 - val_acc: 0.8893
Epoch 3/100
48000/48000 [==============================] - 12s - loss: 0.0792 - acc: 0.9804 - val_loss: 0.6947 - val_acc: 0.9099
...
loss: 0.0123 - acc: 0.9971 - val_loss: 0.6827 - val_acc: 0.9217
Epoch 98/100
48000/48000 [==============================] - 13s - loss: 0.0097 - acc: 0.9975 - val_loss: 0.7074 - val_acc: 0.9211
Epoch 99/100
48000/48000 [==============================] - 13s - loss: 0.0081 - acc: 0.9984 - val_loss: 0.6846 - val_acc: 0.9205
Epoch 100/100
48000/48000 [==============================] - 13s - loss: 0.0090 - acc: 0.9977 - val_loss: 0.6739 - val_acc: 0.9226
Hãy lưu mô hình lần cuối.
full_model.save_weights('classification_complete.h5')
Hãy đặt việc đánh giá mô hình vào bối cảnh bằng cách vẽ các biểu đồ độ chính xác và mất mát giữa dữ liệu huấn luyện và xác thực:
accuracy = classify_train.history['acc']
val_accuracy = classify_train.history['val_acc']
loss = classify_train.history['loss']
val_loss = classify_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
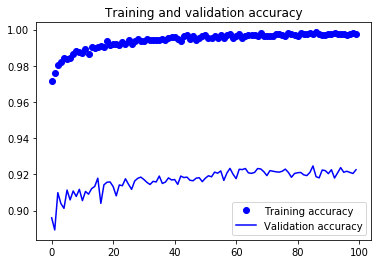
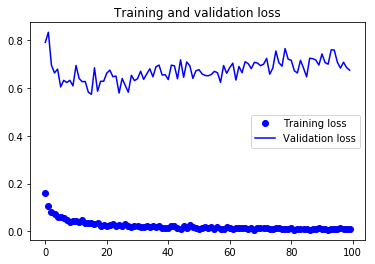
Từ hai biểu đồ trên, bạn có thể thấy mô hình bị overfit vì có khoảng cách lớn giữa training và validation loss. Để khắc phục overfitting, bạn có thể dùng các kỹ thuật regularization như Dropout. Bạn có thể xem hướng dẫn này về CNN trong python với keras.
Cuối cùng, hãy đánh giá mô hình trên dữ liệu kiểm tra và xem kết quả!
test_eval = full_model.evaluate(test_data, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.7068972043234281)
('Test accuracy:', 0.9205)
predicted_classes = full_model.predict(test_data)
Vì các dự đoán bạn nhận được là giá trị số thực, sẽ không tiện để so sánh nhãn dự đoán với nhãn kiểm tra thật. Do đó, bạn sẽ làm tròn đầu ra để chuyển giá trị thực thành số nguyên. Tiếp theo, bạn dùng np.argmax() để chọn chỉ số có giá trị cao nhất trên mỗi hàng.
Ví dụ, giả sử dự đoán cho một ảnh kiểm tra là [0 1 0 0 0 0 0 0 0 0], đầu ra nên là nhãn lớp 1.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_labels.shape
((10000,), (10000,))
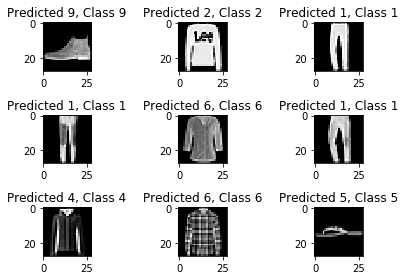
correct = np.where(predicted_classes==test_labels)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_labels[correct]))
    plt.tight_layout()
Found 9204 correct labels
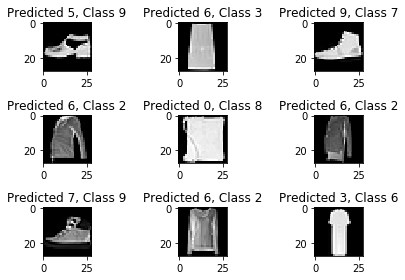
incorrect = np.where(predicted_classes!=test_labels)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_labels[incorrect]))
    plt.tight_layout()
Found 796 incorrect labels
Báo cáo phân loại sẽ giúp bạn xác định chi tiết hơn các lớp bị phân loại sai. Bạn sẽ quan sát được mô hình hoạt động kém ở lớp nào trong số mười lớp đã cho.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_labels, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.83      0.89      0.86      1000
    Class 1       0.99      0.99      0.99      1000
    Class 2       0.89      0.87      0.88      1000
    Class 3       0.92      0.93      0.92      1000
    Class 4       0.85      0.90      0.88      1000
    Class 5       0.99      0.99      0.99      1000
    Class 6       0.81      0.72      0.76      1000
    Class 7       0.96      0.98      0.97      1000
    Class 8       0.98      0.98      0.98      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Hướng dẫn này là một khởi đầu tốt để sử dụng cả autoencoder và mạng nơ-ron tích chập fully connected với Python và Keras. Nếu bạn theo kịp dễ dàng hoặc dù có đôi chút cố gắng, rất tốt! Hãy thử làm vài thí nghiệm, có thể với cùng kiến trúc mô hình nhưng dùng các bộ dữ liệu công khai khác nhau.
Vẫn còn rất nhiều điều để học, vậy tại sao không học khóa Deep Learning in Python của DataCamp? Trong lúc đó, cũng nhớ xem tài liệu Keras nếu bạn chưa xem. Bạn sẽ tìm thấy nhiều ví dụ và thông tin về mọi hàm, tham số, nhiều lớp, v.v. Đây chắc chắn là nguồn tài nguyên không thể thiếu khi bạn học cách làm việc với mạng nơ-ron trong Python!
Nếu bạn muốn đọc một cuốn sách giải thích các nền tảng của deep learning (với Keras) cùng cách áp dụng trong thực tế, bạn nhất định nên đọc cuốn Deep Learning in Python của François Chollet.
Khóa học Python
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
