Corso
Introduzione al Deep Learning in Python
4 ore
264.6K
Nota: questo tutorial si concentra soprattutto sull'implementazione pratica della classificazione usando la rete neurale convoluzionale e l’autoencoder convoluzionale. Quindi, se non conosci ancora le CNN e gli autoencoder, potresti voler dare un’occhiata ai tutorial su CNN e Autoencoder.
Più nello specifico, oggi affronterai i seguenti argomenti:
Prima di iniziare a caricare il dataset e a elaborarlo, è utile farsi un’idea del tipo di dataset, delle sue dimensioni e di quante classi diverse contiene.
Il dataset Fashion-MNIST è composto da immagini in scala di grigi 28x28 di 70.000 prodotti fashion suddivisi in 10 categorie, con 7.000 immagini per categoria. Il set di training ha 60.000 immagini e quello di test 10.000. Fashion-MNIST è un sostituto dell’MNIST originale per ottenere risultati migliori; le dimensioni delle immagini e le suddivisioni tra training e test sono simili a quelle del dataset MNIST originale. Il dataset è disponibile gratuitamente a questo URL e può essere caricato sia con tensorflow che con keras come framework senza doverlo scaricare sul computer.
Come MNIST, anche Fashion-MNIST ha 10 classi, ma invece di cifre scritte a mano ci sono 10 diverse classi di accessori/moda come sandali, camicie, pantaloni, ecc.
Il compito è addestrare un autoencoder convoluzionale e usare la parte di encoder dell’autoencoder combinata con livelli fully connected per riconoscere correttamente un nuovo campione del set di test.
Consiglio: se vuoi imparare a implementare un Multi-Layer Perceptron (MLP) per compiti di classificazione con il dataset MNIST, dai un’occhiata a questo tutorial.
Nel codice seguente imposti le variabili d’ambiente nel notebook usando os.environ. È utile farlo prima di inizializzare Keras per limitare TensorFlow (backend di Keras) a usare la prima GPU. Se la macchina su cui alleni ha una GPU su 0, assicurati di usare 0 invece di 1. Puoi verificarlo eseguendo un semplice comando nel terminale: ad esempio, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU 0
Ora importa tutti i moduli necessari come numpy, matplotlib e soprattutto Keras, dato che in questo tutorial userai keras come framework!
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
from keras.utils import to_categorical
Using TensorFlow backend.
/usr/local/lib/python2.7/dist-packages/h5py/__init__.py:34: FutureWarning: Conversion of the second argument of issubdtype from `float` to `np.floating` is deprecated. In future, it will be treated as `np.float64 == np.dtype(float).type`.
  from ._conv import register_converters as _register_converters
Qui definisci una funzione che apre il file gzip e lo legge con bytestream.read(). Passi a questa funzione la dimensione dell’immagine e il numero totale di immagini. Poi, usando np.frombuffer(), converti la stringa memorizzata nella variabile buf in un array NumPy di tipo float32.
Una volta convertito in array NumPy, rimodelli l’array in un array tridimensionale o tensore in cui la prima dimensione è il numero di immagini e la seconda e la terza sono la dimensione dell’immagine. Infine, restituisci l’array NumPy data.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Ora chiamerai la funzione extract_data() passando i file di training e test insieme al corrispondente numero di immagini.
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
Allo stesso modo, definisci una funzione di estrazione delle etichette che apre il file gzip e lo legge con bytestream.read(), alla quale passi la dimensione dell’etichetta (1) e il numero totale di immagini. Poi, usando np.frombuffer(), converti la stringa memorizzata nella variabile buf in un array NumPy di tipo int64.
Questa volta non devi rimodellare l’array poiché la variabile labels restituirà un vettore colonna di dimensione 60.000 x 1. Infine, restituisci l’array NumPy labels.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Ora chiamerai la funzione di estrazione etichette passando i file di etichette di training e test insieme al corrispondente numero di immagini.
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Una volta caricati i dati di training e test, sei pronto per analizzarli per capire meglio il dataset con cui lavorerai in questo tutorial!
Analizziamo ora come sono le immagini nel dataset e vediamo anche la dimensione delle immagini con l’attributo .shape degli array NumPy:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Dal risultato sopra puoi vedere che i dati di training hanno forma 60000 x 28 x 28 poiché ci sono 60.000 campioni di training, ognuno una matrice 28 x 28. Analogamente, i dati di test hanno forma 10000 x 28 x 28 poiché ci sono 10.000 campioni di test.
Nota che per il compito di ricostruzione con un autoencoder convoluzionale non ti serviranno le etichette di training e test. Le immagini di training fungeranno sia da input sia da ground truth, in modo analogo alle etichette nei compiti di classificazione.
Ma per il compito di classificazione ti serviranno anche le etichette insieme alle immagini, cosa che farai più avanti nel tutorial. Anche se qui ci occuperemo solo delle immagini di training e test, per scopi esplorativi, che possono darti un’intuizione migliore sui dati, userai le etichette.
Creiamo un dizionario che contenga i nomi delle classi con le relative etichette di classe categoriali:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Ora diamo un’occhiata ad alcune immagini del dataset:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[10], (28,28))
curr_lbl = train_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[10], (28,28))
curr_lbl = test_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
Text(0.5,1,'(Label: E)')
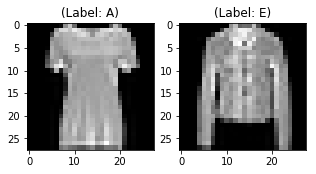
L’output dei due grafici sopra mostra una delle immagini di esempio sia dei dati di training che di test, e queste immagini hanno un’etichetta di classe 0 o A, da una parte, e 4 o E, dall’altra. Allo stesso modo, altre lettere avranno etichette diverse, ma le stesse lettere avranno la stessa etichetta. Ciò significa che tutte le 6.000 immagini di classe E avranno etichetta di classe 4.
Le immagini del dataset sono in scala di grigi con valori di pixel da 0 a 255 e dimensione 28 x 28; prima di dare i dati in pasto al modello, è molto importante pre-processarli. Per prima cosa convertirai ogni immagine 28 x 28 dei set di training e test in una matrice di dimensione 28 x 28 x 1, che puoi passare alla rete:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Poi, verifica il tipo di dato degli array NumPy di training e test: dovrebbe essere float32; in caso contrario, dovresti convertirlo, ma dato che lo hai già fatto durante la lettura dei dati, non serve ripeterlo. Devi anche riscalare i valori dei pixel nell’intervallo 0 - 1 inclusi. Facciamolo!
Non dimenticare di verificare i tipi di dato di training e test:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Quindi, riscala i dati di training e test con il valore massimo dei rispettivi set:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Verifichiamo che il valore massimo dei dati di training e test sia 1.0 dopo il riscalamento!
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Dopo tutto questo, è importante partizionare i dati. Per far generalizzare bene il modello, dividi i dati di training in due parti: un set di training e uno di validazione. Allenerai il modello sull’80% dei dati e lo validerai sul 20% rimanente dei dati di training.
Questo aiuterà anche a ridurre le probabilità di overfitting, dato che validerai il modello su dati che non vedrà nella fase di training.
Puoi usare il modulo train_test_split di scikit-learn per dividere correttamente i dati:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Nota: userai la suddivisione sopra due volte: una per il compito di ricostruzione con l’autoencoder convoluzionale, per il quale non ti servono le etichette di training e test. Ecco perché passerai le immagini di training due volte. Le immagini di training fungeranno sia da input che da ground truth, in modo analogo alle etichette nel compito di classificazione.
Ma per la classificazione passerai anche le etichette insieme alle immagini, cosa che farai più avanti nel tutorial.
Ora sei pronto per definire la rete e passare i dati alla rete. Quindi, senza ulteriori indugi, passiamo al prossimo step!
Le immagini hanno dimensione 28 x 28 x 1, ovvero un vettore di 30976 dimensioni. Converti la matrice dell’immagine in un array, la riscali tra 0 e 1, la rimodelli a 28 x 28 x 1 e la usi come input per la rete.
Inoltre userai una dimensione di batch pari a 128; anche batch size più grandi come 256 o 512 sono preferibili: dipende tutto dal sistema su cui alleni il modello. Questo influisce molto sui parametri di apprendimento e sull’accuratezza delle previsioni.
batch_size = 64
epochs = 200
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
num_classes = 10
Come già saprai, l’autoencoder è diviso in due parti: encoder e decoder.
Encoder: ha 4 blocchi convoluzionali, ciascuno con un livello di convoluzione seguito da un livello di batch normalization. Un livello di max-pooling è usato dopo il primo e il secondo blocco convoluzionale.
Decoder: ha 3 blocchi convoluzionali, ciascuno con un livello di convoluzione seguito da un livello di batch normalization. Un livello di upsampling è usato dopo il secondo e il terzo blocco convoluzionale.
Il livello di max-pooling riduce di due volte la dimensione dell’input ogni volta che lo usi, mentre il livello di upsampling la aumenta di due volte ogni volta che è usato.
Nota: il numero di filtri, la dimensione del filtro, il numero di livelli, il numero di epoche di training… sono tutti iperparametri e dovrebbero essere decisi in base alla tua intuizione; sei libero di provare nuovi esperimenti modificando questi iperparametri e misurando le prestazioni del modello. È così che imparerai gradualmente l’arte del deep learning!
Creiamo funzioni separate per encoder e decoder, dato che userai i pesi dell’encoder in seguito per la classificazione!
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4

def decoder(conv4):
    #decoder
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv4) #7 x 7 x 128
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv5) #7 x 7 x 64
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up1 = UpSampling2D((2,2))(conv6) #14 x 14 x 64
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 32
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up2 = UpSampling2D((2,2))(conv7) # 28 x 28 x 32
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Dopo aver creato il modello, devi compilarlo usando l’ottimizzatore RMSProp.
Nota che devi anche specificare il tipo di loss tramite l’argomento loss. In questo caso è l’errore quadratico medio, poiché la perdita dopo ogni batch sarà calcolata tra l’output previsto e il ground truth con MSE, pixel per pixel:
autoencoder = Model(input_img, decoder(encoder(input_img)))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualizziamo i livelli creati nello step sopra usando la funzione summary. Questo mostrerà il numero di parametri (pesi e bias) in ogni livello e anche il totale dei parametri nel modello.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_16 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_15 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
...

batch_normalization_28 (Batc (None, 14, 14, 32)        128
_________________________________________________________________
up_sampling2d_4 (UpSampling2 (None, 28, 28, 32)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         289
=================================================================
Total params: 1,758,657
Trainable params: 1,755,841
Non-trainable params: 2,816
_________________________________________________________________
È finalmente il momento di addestrare il modello con la funzione fit() di Keras! Il modello si allena per 200 epoche. La funzione fit() restituirà un oggetto history; salvando il risultato in autoencoder_train, potrai poi usarlo per tracciare il grafico della perdita tra training e validazione, utile per analizzare visivamente le prestazioni del modello.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/200
48000/48000 [==============================] - 19s - loss: 0.0202 - val_loss: 0.0114s: 0.020
Epoch 2/200
48000/48000 [==============================] - 17s - loss: 0.0087 - val_loss: 0.0071
...
Epoch 199/200
48000/48000 [==============================] - 18s - loss: 7.0886e-04 - val_loss: 8.9876e-04
Epoch 200/200
48000/48000 [==============================] - 18s - loss: 7.0929e-04 - val_loss: 0.0010
Finalmente! Hai addestrato il modello sul dataset fashion-mnist per 100 epoche. Ora tracciamo il grafico della perdita tra dati di training e di validazione per visualizzare le prestazioni del modello.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
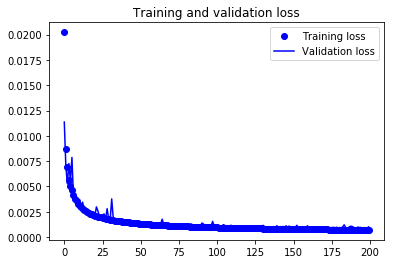
Infine, puoi vedere che la perdita di validazione e quella di training sono allineate. Questo mostra che il modello non sta overfittando: la perdita di validazione sta diminuendo e non aumentando, e c’è raramente un divario tra le due durante il training.
Puoi quindi dire che la capacità di generalizzazione del modello è buona.
Ma ricorda che il compito è usare la parte di encoder del modello addestrato per classificare le immagini di fashion mnist. Passiamo quindi alla parte successiva!
Poiché ti serviranno i pesi dell’encoder nel compito di classificazione, salviamo prima i pesi completi dell’autoencoder. Tra poco imparerai come estrarre i pesi dell’encoder.
autoencoder.save_weights('autoencoder.h5')
Ora userai la testa dell’autoencoder addestrato, cioè la parte di encoder, e caricherai i pesi dell’autoencoder appena addestrato ma solo nella parte di encoder del modello.
Aggiungerai alcuni livelli densi o fully connected all’encoder per classificare le immagini fashion mnist.
Nella one-hot encoding, converti i dati categoriali in un vettore di numeri. Il motivo è che gli algoritmi di machine learning non possono lavorare direttamente con dati categoriali. Generi una colonna booleana per ogni categoria o classe. Solo una di queste colonne può assumere il valore 1 per ciascun campione. Da qui il termine one-hot encoding.
Nel tuo problema, la one-hot encoding sarà un vettore riga e, per ogni immagine, avrà dimensione 1 x 10. La cosa importante da notare è che il vettore è composto da tutti zeri, tranne che per la classe che rappresenta, per la quale vale 1.
Quindi convertiamo le etichette in vettori one-hot:
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_labels)
test_Y_one_hot = to_categorical(test_labels)

# Display the change for category label using one-hot encoding
print('Original label:', train_labels[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([0., 0., 0., 0., 0., 0., 0., 0., 0., 1.]))
Chiaro, no?
train_X,valid_X,train_label,valid_label = train_test_split(train_data,train_Y_one_hot,test_size=0.2,random_state=13)
Per un’ultima volta, controlliamo la forma dei set di training e validazione.
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
Ora definiamo il modello di classificazione. Ricorda che userai esattamente la stessa parte di encoder usata nell’architettura dell’autoencoder.
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4
Definiamo i livelli fully connected che accoderai alla funzione di encoder.
def fc(enco):
    flat = Flatten()(enco)
    den = Dense(128, activation='relu')(flat)
    out = Dense(num_classes, activation='softmax')(den)
    return out
encode = encoder(input_img)
full_model = Model(input_img,fc(encode))
for l1,l2 in zip(full_model.layers[:19],autoencoder.layers[0:19]):
    l1.set_weights(l2.get_weights())
Nota: il prossimo passaggio è molto importante. Per essere sicuro che i pesi della parte di encoder dell’autoencoder siano uguali ai pesi che hai caricato nella funzione di encoder del modello di classificazione, dovresti sempre stampare i pesi di uno stesso livello di entrambi i modelli. Se non coincidono, non ha senso usare la strategia di classificazione con autoencoder.
Stampiamo i pesi del primo livello di entrambi i modelli.
autoencoder.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
full_model.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
Voilà! I due array sono identici. Quindi, senza ulteriori indugi, compiliamo il modello e avviamo il training.
Ora renderai la parte di encoder, cioè i primi diciannove livelli del modello, non addestrabile. Poiché l’encoder è già addestrato, non serve riaddestrarlo. Allenerai solo la parte Fully Connected.
for layer in full_model.layers[0:19]:
    layer.trainable = False
Compiliamo il modello!
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Stampiamo anche il summary del modello. Dovrebbero esserci anche parametri non addestrabili, dato che hai reso non addestrabili i primi quindici livelli del modello.
full_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_53 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 28, 28, 32)        9248
_________________________________________________________________
batch_normalization_54 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
max_pooling2d_11 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_57 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
batch_normalization_55 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
conv2d_58 (Conv2D)           (None, 14, 14, 64)        36928
_________________________________________________________________
batch_normalization_56 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
max_pooling2d_12 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_59 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
batch_normalization_57 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_60 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
batch_normalization_58 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_61 (Conv2D)           (None, 7, 7, 256)         295168
_________________________________________________________________
batch_normalization_59 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
conv2d_62 (Conv2D)           (None, 7, 7, 256)         590080
_________________________________________________________________
batch_normalization_60 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
flatten_4 (Flatten)          (None, 12544)             0
_________________________________________________________________
dense_7 (Dense)              (None, 128)               1605760
_________________________________________________________________
dense_8 (Dense)              (None, 10)                1290
=================================================================
Total params: 2,782,570
Trainable params: 1,607,050
Non-trainable params: 1,175,520
_________________________________________________________________
È finalmente il momento di addestrare il modello con la funzione fit() di Keras! Il modello si allena per 10 epoche. La funzione fit() restituirà un oggetto history; salvando il risultato in fashion_train, potrai poi usarlo per tracciare i grafici di accuratezza e perdita tra training e validazione, utili per analizzare visivamente le prestazioni del modello.
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 6s - loss: 0.3747 - acc: 0.8732 - val_loss: 0.2888 - val_acc: 0.8935
Epoch 2/100
48000/48000 [==============================] - 6s - loss: 0.2216 - acc: 0.9178 - val_loss: 0.2942 - val_acc: 0.9010
Epoch 3/100
48000/48000 [==============================] - 5s - loss: 0.1762 - acc: 0.9340 - val_loss: 0.2868 - val_acc: 0.9078
...
Epoch 74/100
48000/48000 [==============================] - 6s - loss: 0.0182 - acc: 0.9953 - val_loss: 0.8069 - val_acc: 0.9109
Epoch 75/100
48000/48000 [==============================] - 6s - loss: 0.0102 - acc: 0.9971 - val_loss: 0.7872 - val_acc: 0.9125
Epoch 76/100
11776/48000 [======>.......................] - ETA: 3s - loss: 0.0084 - acc: 0.9977
Finalmente! Hai addestrato il modello su fashion-MNIST per sole 10 epoche e, osservando accuratezza e perdita di training, puoi dire che il modello ha fatto un ottimo lavoro: dopo 10 epoche l’accuratezza di training è al 99% e la perdita di validazione è al 98%.
Salviamo il modello di classificazione!
full_model.save_weights('autoencoder_classification.h5')
Ora ri-addestrerai il modello rendendo i primi diciannove livelli trainable True invece di lasciarli False! Facciamolo rapidamente.
for layer in full_model.layers[0:19]:
    layer.trainable = True
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Adesso alleniamo l’intero modello un’ultima volta!
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 13s - loss: 0.1584 - acc: 0.9718 - val_loss: 0.7902 - val_acc: 0.8960
Epoch 2/100
48000/48000 [==============================] - 12s - loss: 0.1049 - acc: 0.9759 - val_loss: 0.8327 - val_acc: 0.8893
Epoch 3/100
48000/48000 [==============================] - 12s - loss: 0.0792 - acc: 0.9804 - val_loss: 0.6947 - val_acc: 0.9099
...
loss: 0.0123 - acc: 0.9971 - val_loss: 0.6827 - val_acc: 0.9217
Epoch 98/100
48000/48000 [==============================] - 13s - loss: 0.0097 - acc: 0.9975 - val_loss: 0.7074 - val_acc: 0.9211
Epoch 99/100
48000/48000 [==============================] - 13s - loss: 0.0081 - acc: 0.9984 - val_loss: 0.6846 - val_acc: 0.9205
Epoch 100/100
48000/48000 [==============================] - 13s - loss: 0.0090 - acc: 0.9977 - val_loss: 0.6739 - val_acc: 0.9226
Salviamo il modello per l’ultima volta.
full_model.save_weights('classification_complete.h5')
Mettiamo in prospettiva la valutazione del modello e tracciamo i grafici di accuratezza e perdita tra dati di training e validazione:
accuracy = classify_train.history['acc']
val_accuracy = classify_train.history['val_acc']
loss = classify_train.history['loss']
val_loss = classify_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
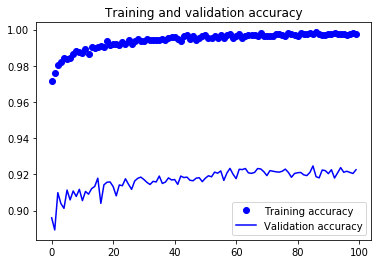
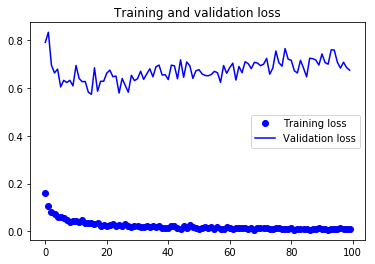
Dai due grafici sopra puoi vedere che il modello sta overfittando, dato il grande divario tra perdita di training e di validazione. Per affrontare l’overfitting, potresti usare tecniche di regolarizzazione come il Dropout. Puoi seguire questo tutorial sulle CNN in Python con Keras.
Infine, valutiamo anche il modello sui dati di test per vedere come si comporta!
test_eval = full_model.evaluate(test_data, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.7068972043234281)
('Test accuracy:', 0.9205)
predicted_classes = full_model.predict(test_data)
Poiché le predizioni che ottieni sono valori in virgola mobile, non è pratico confrontare direttamente le etichette previste con le vere etichette di test. Quindi, arrotonderai l’output per convertire i float in interi. Inoltre, userai np.argmax() per selezionare l’indice con il valore più alto in una riga.
Per esempio, se la predizione per un’immagine di test è [0 1 0 0 0 0 0 0 0 0], l’output dovrebbe essere l’etichetta di classe 1.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_labels.shape
((10000,), (10000,))
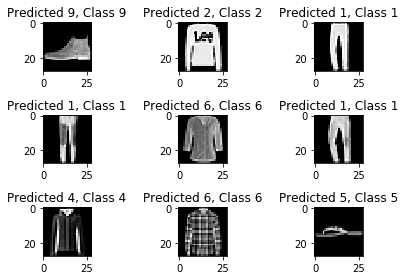
correct = np.where(predicted_classes==test_labels)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_labels[correct]))
    plt.tight_layout()
Found 9204 correct labels
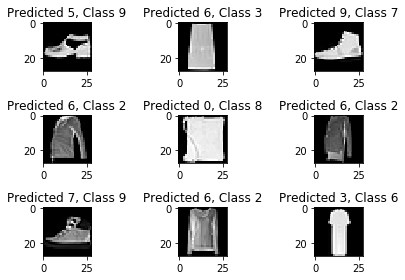
incorrect = np.where(predicted_classes!=test_labels)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_labels[incorrect]))
    plt.tight_layout()
Found 796 incorrect labels
Il report di classificazione ti aiuterà a identificare più in dettaglio le classi misclassificate. Potrai osservare per quali classi il modello ha avuto prestazioni peggiori tra le dieci disponibili.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_labels, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.83      0.89      0.86      1000
    Class 1       0.99      0.99      0.99      1000
    Class 2       0.89      0.87      0.88      1000
    Class 3       0.92      0.93      0.92      1000
    Class 4       0.85      0.90      0.88      1000
    Class 5       0.99      0.99      0.99      1000
    Class 6       0.81      0.72      0.76      1000
    Class 7       0.96      0.98      0.97      1000
    Class 8       0.98      0.98      0.98      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Questo tutorial è stato un buon inizio per usare sia un autoencoder che una rete neurale convoluzionale fully connected con Python e Keras. Se sei riuscito a seguirlo facilmente o anche con un po’ di impegno in più, ottimo lavoro! Prova a fare qualche esperimento magari con la stessa architettura di modello ma usando diversi dataset pubblici disponibili.
C’è ancora molto da coprire, quindi perché non seguire il corso di DataCamp Deep Learning in Python? Nel frattempo, assicurati anche di consultare la documentazione di Keras, se non l’hai già fatto. Troverai più esempi e informazioni su funzioni, argomenti, nuovi livelli, ecc. Sarà senza dubbio una risorsa indispensabile mentre impari a lavorare con le reti neurali in Python!
Se invece preferisci leggere un libro che spiega i fondamenti del deep learning (con Keras) insieme al suo uso pratico, dovresti assolutamente leggere il libro di François Chollet Deep Learning in Python.
Corsi Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



