कोर्स
Python में Deep Learning परिचय
4 घंटा
264.7K
नोट: यह ट्यूटोरियल मुख्य रूप से कॉन्वोल्यूशनल न्यूरल नेटवर्क और कॉन्वोल्यूशनल ऑटोएन्कोडर का उपयोग करके वर्गीकरण के व्यावहारिक इम्प्लीमेंटेशन को कवर करेगा। इसलिए, यदि आप अभी तक कॉन्वोल्यूशनल न्यूरल नेटवर्क (CNN) और ऑटोएन्कोडर से परिचित नहीं हैं, तो आप CNN और Autoencoder ट्यूटोरियल देखना चाहेंगे।
विशेष रूप से, आप आज के ट्यूटोरियल में निम्नलिखित विषयों को कवर करेंगे:
डेटासेट को लोड करने और प्रोसेस करना शुरू करने से पहले, यह समझ लेना बेहतर है कि यह किस प्रकार का डेटासेट है, डेटा के डाइमेंशन्स क्या हैं और डेटासेट में कितनी अलग-अलग क्लासेज़ हैं।
Fashion-MNIST डेटासेट 10 कैटेगरीज़ के 70,000 फ़ैशन प्रोडक्ट्स की 28x28 ग्रेस्केल इमेजेस से बना है, प्रति कैटेगरी 7,000 इमेज। ट्रेनिंग सेट में 60,000 इमेज हैं, और टेस्ट सेट में 10,000 इमेज। Fashion-MNIST को मूल MNIST डेटासेट का बेहतर विकल्प बनने के लिए डिज़ाइन किया गया है; इमेज डाइमेंशन्स, ट्रेनिंग और टेस्ट स्प्लिट्स मूल MNIST के समान हैं। यह डेटासेट इस URL पर मुफ़्त में उपलब्ध है और इसे tensorflow और keras—दोनों फ्रेमवर्क्स से बिना कंप्यूटर पर डाउनलोड किए लोड किया जा सकता है।
MNIST की तरह Fashion-MNIST में भी 10 क्लासेज़ हैं, लेकिन हाथ से लिखे अंकों के बजाय इसमें सैंडल, शर्ट, ट्राउज़र्स आदि जैसे फ़ैशन एक्सेसरीज़ की 10 अलग-अलग क्लासेज़ हैं।
उद्देश्य यह है कि एक कॉन्वोल्यूशनल ऑटोएन्कोडर को ट्रेन किया जाए और ऑटोएन्कोडर के एनकोडर हिस्से को फ़ुली कनेक्टेड लेयर्स के साथ जोड़कर टेस्ट सेट से किसी नए सैंपल की सही पहचान की जाए।
टिप: यदि आप सीखना चाहते हैं कि MNIST डेटासेट के साथ क्लासिफ़िकेशन कार्यों के लिए Multi-Layer Perceptron (MLP) कैसे इम्प्लीमेंट करें, तो यह ट्यूटोरियल देखें।
नीचे दिए गए कोड में, आप मूल रूप से os.environ का उपयोग करते हुए नोटबुक में वातावरण वेरिएबल सेट करते हैं। Keras इनिशियलाइज़ करने से पहले यह करना अच्छा है ताकि Keras बैकएंड TensorFlow को पहले GPU तक सीमित किया जा सके। यदि जिस मशीन पर आप ट्रेनिंग कर रहे हैं उसके 0 पर GPU है, तो 1 के बजाय 0 का उपयोग करना सुनिश्चित करें। आप टर्मिनल पर एक साधारण कमांड चलाकर यह जाँच सकते हैं: उदाहरण के लिए, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU 0
अब, आप numpy, matplotlib और सबसे महत्वपूर्ण Keras जैसे सभी आवश्यक मॉड्यूल इम्पोर्ट करेंगे, क्योंकि आज के ट्यूटोरियल में आप फ्रेमवर्क के रूप में keras का उपयोग करेंगे!
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
from keras.utils import to_categorical
Using TensorFlow backend.
/usr/local/lib/python2.7/dist-packages/h5py/__init__.py:34: FutureWarning: Conversion of the second argument of issubdtype from `float` to `np.floating` is deprecated. In future, it will be treated as `np.float64 == np.dtype(float).type`.
  from ._conv import register_converters as _register_converters
यहाँ, आप एक फ़ंक्शन परिभाषित करते हैं जो gzip फ़ाइल खोलता है, bytestream.read() का उपयोग करके फ़ाइल पढ़ता है। आप इस फ़ंक्शन को इमेज का डाइमेंशन और कुल इमेज की संख्या पास करते हैं। फिर, np.frombuffer() का उपयोग करके, आप वेरिएबल buf में संग्रहीत स्ट्रिंग को float32 प्रकार के NumPy array में बदलते हैं।
NumPy array में बदलने के बाद, आप उसे त्रिविमीय array या टेENSOR में रीशेप करते हैं जहाँ पहली डाइमेंशन इमेज की संख्या है, और दूसरी व तीसरी डाइमेंशन इमेज का डाइमेंशन। अंत में, आप NumPy array data को रिटर्न करते हैं।
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
अब आप extract_data() फ़ंक्शन को ट्रेनिंग और टेस्टिंग फ़ाइलों के साथ उनकी संबंधित इमेज की संख्या पास करके कॉल करेंगे।
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
इसी तरह, आप एक लेबल्स निकालने वाला फ़ंक्शन परिभाषित करते हैं जो gzip फ़ाइल खोलता है, bytestream.read() का उपयोग करके फ़ाइल पढ़ता है, जिसमें आप लेबल का डाइमेंशन (1) और कुल इमेज की संख्या पास करते हैं। फिर, np.frombuffer() का उपयोग करके, आप वेरिएबल buf में संग्रहीत स्ट्रिंग को int64 प्रकार के NumPy array में बदलते हैं।
इस बार, आपको array को रीशेप करने की आवश्यकता नहीं है क्योंकि वेरिएबल labels 60,000 x 1 डाइमेंशन का कॉलम वेक्टर रिटर्न करेगा। अंत में, आप NumPy array labels को रिटर्न करते हैं।
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
अब आप ट्रेनिंग और टेस्टिंग लेबल फ़ाइलों के साथ उनकी संबंधित इमेज की संख्या पास करके extract label फ़ंक्शन को कॉल करेंगे।
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
जब आपके पास ट्रेनिंग और टेस्टिंग डेटा लोड हो जाए, तो आप उस डेटासेट के बारे में कुछ समझ हासिल करने के लिए डेटा का विश्लेषण करने के लिए तैयार हैं जिसके साथ आप आज के ट्यूटोरियल में काम करेंगे!
अब देखते हैं कि डेटासेट में इमेज कैसी दिखती हैं और NumPy array के एट्रिब्यूट .shape की मदद से उनकी डाइमेंशन क्या है:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
ऊपर के आउटपुट से, आप देख सकते हैं कि ट्रेनिंग डेटा का आकार 60000 x 28 x 28 है क्योंकि 60,000 ट्रेनिंग सैंपल हैं, प्रत्येक 28 x 28 डाइमेंशन के मैट्रिक्स के साथ। इसी प्रकार, टेस्ट डेटा का आकार 10000 x 28 x 28 है क्योंकि 10,000 टेस्टिंग सैंपल हैं।
नोट कि कॉन्वोल्यूशनल ऑटोएन्कोडर का उपयोग करके रिकंस्ट्रक्शन के कार्य में आपको ट्रेनिंग और टेस्टिंग लेबल्स की आवश्यकता नहीं होगी। आपकी ट्रेनिंग इमेजेस इनपुट के साथ-साथ ग्राउंड ट्रुथ के रूप में भी काम करेंगी, ठीक वैसे ही जैसे क्लासिफ़िकेशन टास्क में लेबल्स होते हैं।
लेकिन क्लासिफ़िकेशन टास्क के लिए आपको इमेजेस के साथ अपने लेबल्स की भी आवश्यकता होगी, जिसे आप ट्यूटोरियल में आगे करेंगे। भले ही वर्तमान कार्य में आप केवल ट्रेनिंग और टेस्टिंग इमेजेस से ही डील करेंगे, फिर भी एक्सप्लोरेशन उद्देश्य के लिए, जो आपको डेटा के बारे में बेहतर समझ दे सकता है, आप लेबल्स का उपयोग करेंगे।
आइए एक डिक्शनरी बनाते हैं जिसमें क्लास के नाम उनके संबंधित कैटेगरिकल क्लास लेबल्स के साथ हों:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
अब, अपने डेटासेट की कुछ इमेजेस पर नज़र डालते हैं:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[10], (28,28))
curr_lbl = train_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[10], (28,28))
curr_lbl = test_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
Text(0.5,1,'(Label: E)')
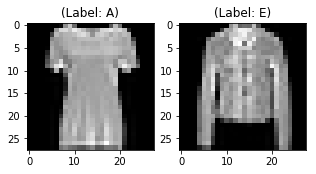
ऊपर दिए गए दोनों प्लॉट्स का आउटपुट ट्रेनिंग और टेस्टिंग डेटा में से एक-एक सैंपल इमेज है, और इन इमेजेस को एक तरफ 0 या A और दूसरी तरफ 4 या E का क्लास लेबल असाइन किया गया है। इसी तरह अन्य अक्षरों के अलग-अलग लेबल होंगे, लेकिन समान अक्षरों के एक जैसे लेबल होंगे। इसका मतलब है कि सभी 6,000 E क्लास की इमेजेस का क्लास लेबल 4 होगा।
डेटासेट की इमेजेस वाकई ग्रेस्केल हैं जिनके पिक्सेल वैल्यू 0 से 255 के बीच हैं और डाइमेंशन 28 x 28 है, इसलिए मॉडल में डेटा फ़ीड करने से पहले उसे प्रीप्रोसेस करना बहुत ज़रूरी है। आप सबसे पहले ट्रेन और टेस्ट सेट की प्रत्येक 28 x 28 इमेज को 28 x 28 x 1 आकार के मैट्रिक्स में बदलेंगे, जिसे आप नेटवर्क में फ़ीड कर सकते हैं:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
अगला कदम ट्रेनिंग और टेस्टिंग NumPy arrays के डेटा टाइप को जाँचना है—यह float32 फ़ॉर्मेट में होना चाहिए; यदि नहीं है, तो आपको इसे इस फ़ॉर्मेट में कन्वर्ट करना होगा, लेकिन चूँकि आपने पढ़ते समय पहले ही इसे कन्वर्ट कर लिया है, इसलिए अब इसे फिर से करने की आवश्यकता नहीं है। आपको पिक्सेल वैल्यूज़ को 0 - 1 की रेंज में रिस्केल भी करना होगा। तो चलिए यह करते हैं!
ट्रेनिंग और टेस्टिंग डेटा टाइप्स को वेरिफ़ाई करना न भूलें:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
अब, ट्रेनिंग और टेस्टिंग डेटा को उनके अधिकतम पिक्सेल वैल्यू के आधार पर रिस्केल करें:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
आइए ट्रेनिंग और टेस्टिंग डेटा के अधिकतम मान को वेरिफ़ाई करें जो रिस्केल करने के बाद 1.0 होना चाहिए!
np.max(train_data), np.max(test_data)
(1.0, 1.0)
यह सब करने के बाद, डेटा को विभाजित करना महत्वपूर्ण है। ताकि हमारा मॉडल अच्छी तरह जनरलाइज़ कर सके, आप ट्रेनिंग डेटा को दो भागों में बाँटेंगे: ट्रेनिंग और वैलिडेशन सेट। आप अपने मॉडल को 80% डेटा पर ट्रेन करेंगे और शेष 20% ट्रेनिंग डेटा पर उसे वैलिडेट करेंगे।
यह ओवरफ़िटिंग की संभावनाओं को कम करने में भी मदद करेगा, क्योंकि आप अपने मॉडल को उस डेटा पर वैलिडेट करेंगे जिसे उसने ट्रेनिंग फेज़ में नहीं देखा होगा।
आप scikit-learn के train_test_split मॉड्यूल का उपयोग करके डेटा को सही तरीके से बाँट सकते हैं:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
नोट: आप ऊपर दिए गए डेटा स्प्लिटिंग का उपयोग दो बार करेंगे, एक बार कॉन्वोल्यूशनल ऑटोएन्कोडर के साथ रिकंस्ट्रक्शन के कार्य के लिए, जिसके लिए आपको ट्रेनिंग और टेस्टिंग लेबल्स की आवश्यकता नहीं है। इसलिए आप ट्रेनिंग इमेजेस को दो बार पास करेंगे। आपकी ट्रेनिंग इमेजेस इनपुट के साथ-साथ ग्राउंड ट्रुथ के रूप में भी कार्य करेंगी, ठीक वैसे ही जैसे क्लासिफ़िकेशन टास्क में लेबल्स होते हैं।
लेकिन क्लासिफ़िकेशन टास्क के लिए, आप अपने लेबल्स को भी इमेजेस के साथ पास करेंगे, जिसे आप ट्यूटोरियल में आगे करेंगे।
अब आप नेटवर्क परिभाषित करने और डेटा को नेटवर्क में फ़ीड करने के लिए पूरी तरह तैयार हैं। तो बिना देर किए, अगले चरण पर चलते हैं!
इमेजेस का आकार 28 x 28 x 1 या 30976-डाइमेंशनल वेक्टर है। आप इमेज मैट्रिक्स को array में कन्वर्ट करते हैं, उसे 0 और 1 के बीच रिस्केल करते हैं, 28 x 28 x 1 के आकार में रीशेप करते हैं, और इसे नेटवर्क में इनपुट के रूप में फ़ीड करते हैं।
साथ ही, आप 128 के बैच साइज़ का उपयोग करेंगे—256 या 512 जैसे बड़े बैच साइज़ भी ठीक हैं; यह इस पर निर्भर करता है कि आप किस सिस्टम पर अपना मॉडल ट्रेन कर रहे हैं। यह लर्निंग पैरामीटर्स को निर्धारित करने में काफी योगदान देता है और प्रेडिक्शन एक्युरेसी को प्रभावित करता है।
batch_size = 64
epochs = 200
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
num_classes = 10
जैसा कि आप पहले से जानते होंगे, ऑटोएन्कोडर दो भागों में बँटा होता है: एक एनकोडर और एक डिकोडर।
एनकोडर: इसमें 4 कॉन्वोल्यूशनल ब्लॉक्स हैं, प्रत्येक ब्लॉक में एक कॉन्वोल्यूशनल लेयर के बाद एक बैच नॉर्मलाइज़ेशन लेयर होती है। पहले और दूसरे कॉन्वोल्यूशनल ब्लॉक्स के बाद मैक्स-पूलिंग लेयर का उपयोग किया जाता है।
डिकोडर: इसमें 3 कॉन्वोल्यूशनल ब्लॉक्स हैं, प्रत्येक ब्लॉक में एक कॉन्वोल्यूशनल लेयर के बाद एक बैच नॉर्मलाइज़ेशन लेयर होती है। दूसरे और तीसरे कॉन्वोल्यूशनल ब्लॉक्स के बाद अपसैंपलिंग लेयर का उपयोग किया जाता है।
मैक्स-पूलिंग लेयर हर बार इनपुट को दो गुना डाउनसैंपल करेगी, जबकि अपसैंपलिंग लेयर हर बार इनपुट को दो गुना अपसैंपल करेगी।
नोट: फ़िल्टर्स की संख्या, फ़िल्टर का आकार, लेयर्स की संख्या, अपने मॉडल को ट्रेन करने के लिए epochs की संख्या—ये सभी हाइपरपैरामीटर्स हैं और आपकी अपनी समझ पर आधारित होने चाहिए। आप इन हाइपरपैरामीटर्स के साथ बदलाव करके नए प्रयोग करने और अपने मॉडल के प्रदर्शन को मापने के लिए स्वतंत्र हैं। और इसी तरह आप धीरे-धीरे डीप लर्निंग की कला सीखेंगे!
आइए अलग-अलग एनकोडर और डिकोडर फ़ंक्शन्स बनाते हैं क्योंकि आप बाद में क्लासिफ़िकेशन उद्देश्य के लिए एनकोडर वेट्स का उपयोग करेंगे!
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4

def decoder(conv4):
    #decoder
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv4) #7 x 7 x 128
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv5) #7 x 7 x 64
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up1 = UpSampling2D((2,2))(conv6) #14 x 14 x 64
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 32
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up2 = UpSampling2D((2,2))(conv7) # 28 x 28 x 32
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
मॉडल बनने के बाद, आपको इसे RMSProp ऑप्टिमाइज़र के साथ कंपाइल करना होगा।
ध्यान दें कि आपको लॉस का प्रकार भी loss आर्ग्युमेंट के ज़रिए निर्दिष्ट करना होगा। इस मामले में, यह mean squared error है, क्योंकि हर बैच के बाद लॉस को प्रेडिक्टेड आउटपुट और ग्राउंड ट्रुथ के बीच पिक्सेल-टू-पिक्सेल mean squared error के जरिए कम्प्यूट किया जाएगा:
autoencoder = Model(input_img, decoder(encoder(input_img)))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
आइए summary फ़ंक्शन का उपयोग करके आपने ऊपर जो लेयर्स बनाई हैं उन्हें विज़ुअलाइज़ करें। यह प्रत्येक लेयर में पैरामीटर्स (वेट्स और बायसेज़) की संख्या और आपके मॉडल में कुल पैरामीटर्स को दिखाएगा।
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_16 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_15 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
...

batch_normalization_28 (Batc (None, 14, 14, 32)        128
_________________________________________________________________
up_sampling2d_4 (UpSampling2 (None, 28, 28, 32)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         289
=================================================================
Total params: 1,758,657
Trainable params: 1,755,841
Non-trainable params: 2,816
_________________________________________________________________
आख़िरकार Keras की fit() फ़ंक्शन के साथ मॉडल को ट्रेन करने का समय आ गया है! मॉडल 200 epochs तक ट्रेन होता है। fit() फ़ंक्शन एक history ऑब्जेक्ट रिटर्न करेगा; इसे autoencoder_train में स्टोर करके, आप बाद में ट्रेनिंग और वैलिडेशन के बीच लॉस प्लॉट बनाने के लिए इसका उपयोग कर सकते हैं, जो आपके मॉडल के प्रदर्शन का दृश्य विश्लेषण करने में सहायता करेगा।
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/200
48000/48000 [==============================] - 19s - loss: 0.0202 - val_loss: 0.0114s: 0.020
Epoch 2/200
48000/48000 [==============================] - 17s - loss: 0.0087 - val_loss: 0.0071
...
Epoch 199/200
48000/48000 [==============================] - 18s - loss: 7.0886e-04 - val_loss: 8.9876e-04
Epoch 200/200
48000/48000 [==============================] - 18s - loss: 7.0929e-04 - val_loss: 0.0010
आखिरकार! आपने fashion-mnist डेटासेट पर 100 epochs तक मॉडल को ट्रेन किया, अब चलिए मॉडल के प्रदर्शन को विज़ुअलाइज़ करने के लिए ट्रेनिंग और वैलिडेशन डेटा के बीच लॉस प्लॉट को प्लॉट करते हैं।
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
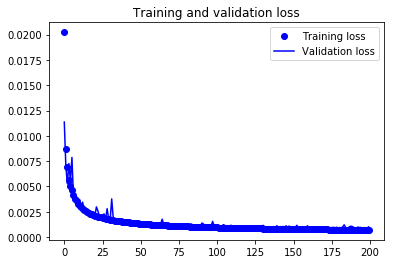
अंत में, आप देख सकते हैं कि वैलिडेशन लॉस और ट्रेनिंग लॉस दोनों सिंक में हैं। यह दिखाता है कि आपका मॉडल ओवरफ़िट नहीं हो रहा है: वैलिडेशन लॉस घट रही है और बढ़ नहीं रही, और पूरे ट्रेनिंग फेज़ के दौरान ट्रेनिंग और वैलिडेशन लॉस के बीच कोई बड़ा अंतर नहीं है।
अतः, आप कह सकते हैं कि आपके मॉडल की जनरलाइज़ेशन क्षमता अच्छी है।
लेकिन ध्यान रखें, मौजूदा कार्य यह है कि ऊपर प्रशिक्षित मॉडल के एनकोडर हिस्से का उपयोग करके fashion mnist इमेजेस को क्लासिफ़ाई किया जाए। तो, अब अगले भाग पर चलते हैं!
क्योंकि आपको क्लासिफ़िकेशन टास्क में एनकोडर वेट्स की आवश्यकता होगी, पहले पूरे ऑटोएन्कोडर वेट्स को सेव करते हैं। आप जल्द ही सीखेंगे कि एनकोडर वेट्स कैसे निकाले जाएँ।
autoencoder.save_weights('autoencoder.h5')
अब आप प्रशिक्षित ऑटोएन्कोडर के हेड, यानी एनकोडर हिस्से का उपयोग करेंगे और अभी-अभी ट्रेन किए गए ऑटोएन्कोडर के वेट्स को केवल मॉडल के एनकोडर हिस्से में लोड करेंगे।
आप fashion mnist इमेजेस को क्लासिफ़ाई करने के लिए एनकोडर में कुछ dense या फ़ुली कनेक्टेड लेयर्स जोड़ेंगे।
वन-हॉट एनकोडिंग में, आप कैटेगरिकल डेटा को संख्याओं के वेक्टर में बदलते हैं। कैटेगरिकल डेटा को वन-हॉट एनकोडिंग में बदलने का कारण यह है कि मशीन लर्निंग एल्गोरिदम सीधे कैटेगरिकल डेटा पर काम नहीं कर सकते। आप प्रत्येक कैटेगरी या क्लास के लिए एक बूलियन कॉलम जनरेट करते हैं। प्रत्येक सैंपल के लिए केवल इन कॉलम्स में से एक का मान 1 हो सकता है। इसलिए, इसे वन-हॉट एनकोडिंग कहा जाता है।
आपकी समस्या के लिए, वन-हॉट एनकोडिंग एक रो वेक्टर होगा, और हर इमेज के लिए इसका डाइमेंशन 1 x 10 होगा। यहाँ ध्यान देने वाली बात यह है कि वेक्टर में सभी जीरो होंगे सिवाय उस क्लास के जिसे वह दर्शाता है; उसके लिए मान 1 होगा।
तो चलिए लेबल्स को वन-हॉट एनकोडिंग वेक्टर्स में बदलते हैं:
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_labels)
test_Y_one_hot = to_categorical(test_labels)

# Display the change for category label using one-hot encoding
print('Original label:', train_labels[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([0., 0., 0., 0., 0., 0., 0., 0., 0., 1.]))
काफ़ी स्पष्ट है, है ना?
train_X,valid_X,train_label,valid_label = train_test_split(train_data,train_Y_one_hot,test_size=0.2,random_state=13)
आखिरी बार ट्रेनिंग और वैलिडेशन सेट के आकार को जाँच लेते हैं।
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
अब, क्लासिफ़िकेशन मॉडल परिभाषित करते हैं। याद रखें कि आप वही एनकोडर हिस्सा उपयोग करेंगे जो आपने ऑटोएन्कोडर आर्किटेक्चर में इस्तेमाल किया था।
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4
आइए फ़ुली कनेक्टेड लेयर्स परिभाषित करें जिन्हें आप एनकोडर फ़ंक्शन के साथ स्टैक करेंगे।
def fc(enco):
    flat = Flatten()(enco)
    den = Dense(128, activation='relu')(flat)
    out = Dense(num_classes, activation='softmax')(den)
    return out
encode = encoder(input_img)
full_model = Model(input_img,fc(encode))
for l1,l2 in zip(full_model.layers[:19],autoencoder.layers[0:19]):
    l1.set_weights(l2.get_weights())
नोट: अगला चरण काफ़ी महत्वपूर्ण है। यह सुनिश्चित करने के लिए कि ऑटोएन्कोडर के एनकोडर हिस्से के वेट्स वही हैं जो आपने क्लासिफ़िकेशन मॉडल के एनकोडर फ़ंक्शन में लोड किए हैं, आपको हमेशा दोनों मॉडलों की किसी एक समान लेयर के वेट्स प्रिंट करने चाहिए। यदि वे समान नहीं हैं, तो ऑटोएन्कोडर क्लासिफ़िकेशन रणनीति का उपयोग करने का कोई अर्थ नहीं है।
आइए दोनों मॉडलों की पहली लेयर के वेट्स प्रिंट करते हैं।
autoencoder.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
full_model.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
वाह! दोनों arrays बिल्कुल समान दिख रही हैं। तो, बिना देर किए, मॉडल को कंपाइल करते हैं और ट्रेनिंग शुरू करते हैं।
अगले चरण में आप एनकोडर हिस्से यानी मॉडल की पहली उन्नीस लेयर्स को ट्रेनएबल फॉल्स करेंगे। चूँकि एनकोडर हिस्सा पहले से प्रशिक्षित है, आपको इसे ट्रेन करने की ज़रूरत नहीं है। आप केवल फ़ुली कनेक्टेड हिस्से को ट्रेन करेंगे।
for layer in full_model.layers[0:19]:
    layer.trainable = False
मॉडल को कंपाइल करते हैं!
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
मॉडल का summary भी प्रिंट करते हैं। नॉन-ट्रेनेबल पैरामीटर्स भी होने चाहिए क्योंकि आपने मॉडल की पहली पंद्रह लेयर्स को नॉन-ट्रेनेबल बनाया है।
full_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_53 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 28, 28, 32)        9248
_________________________________________________________________
batch_normalization_54 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
max_pooling2d_11 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_57 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
batch_normalization_55 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
conv2d_58 (Conv2D)           (None, 14, 14, 64)        36928
_________________________________________________________________
batch_normalization_56 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
max_pooling2d_12 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_59 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
batch_normalization_57 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_60 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
batch_normalization_58 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_61 (Conv2D)           (None, 7, 7, 256)         295168
_________________________________________________________________
batch_normalization_59 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
conv2d_62 (Conv2D)           (None, 7, 7, 256)         590080
_________________________________________________________________
batch_normalization_60 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
flatten_4 (Flatten)          (None, 12544)             0
_________________________________________________________________
dense_7 (Dense)              (None, 128)               1605760
_________________________________________________________________
dense_8 (Dense)              (None, 10)                1290
=================================================================
Total params: 2,782,570
Trainable params: 1,607,050
Non-trainable params: 1,175,520
_________________________________________________________________
अब Keras की fit() फ़ंक्शन के साथ मॉडल को ट्रेन करने का समय है! मॉडल 10 epochs तक ट्रेन होता है। fit() फ़ंक्शन एक history ऑब्जेक्ट रिटर्न करेगा; इसे fashion_train में स्टोर करके, आप बाद में ट्रेनिंग और वैलिडेशन के बीच एक्युरेसी और लॉस के प्लॉट बनाने के लिए इसका उपयोग कर सकते हैं, जो आपके मॉडल के प्रदर्शन का दृश्य विश्लेषण करने में मदद करेगा।
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 6s - loss: 0.3747 - acc: 0.8732 - val_loss: 0.2888 - val_acc: 0.8935
Epoch 2/100
48000/48000 [==============================] - 6s - loss: 0.2216 - acc: 0.9178 - val_loss: 0.2942 - val_acc: 0.9010
Epoch 3/100
48000/48000 [==============================] - 5s - loss: 0.1762 - acc: 0.9340 - val_loss: 0.2868 - val_acc: 0.9078
...
Epoch 74/100
48000/48000 [==============================] - 6s - loss: 0.0182 - acc: 0.9953 - val_loss: 0.8069 - val_acc: 0.9109
Epoch 75/100
48000/48000 [==============================] - 6s - loss: 0.0102 - acc: 0.9971 - val_loss: 0.7872 - val_acc: 0.9125
Epoch 76/100
11776/48000 [======>.......................] - ETA: 3s - loss: 0.0084 - acc: 0.9977
आखिरकार! आपने fashion-MNIST पर केवल 10 epochs में मॉडल को ट्रेन किया, और ट्रेनिंग एक्युरेसी और लॉस को देखकर आप कह सकते हैं कि मॉडल ने शानदार काम किया क्योंकि 10 epochs के बाद ट्रेनिंग एक्युरेसी 99% और वैलिडेशन लॉस 98% है।
क्लासिफ़िकेशन मॉडल को सेव करते हैं!
full_model.save_weights('autoencoder_classification.h5')
अगला चरण, आप मॉडल को दोबारा ट्रेन करेंगे और पहली उन्नीस लेयर्स को False रखने के बजाय True यानी ट्रेनएबल बनाएंगे! तो, यह जल्दी से करते हैं।
for layer in full_model.layers[0:19]:
    layer.trainable = True
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
अब पूरे मॉडल को आखिरी बार ट्रेन करते हैं!
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 13s - loss: 0.1584 - acc: 0.9718 - val_loss: 0.7902 - val_acc: 0.8960
Epoch 2/100
48000/48000 [==============================] - 12s - loss: 0.1049 - acc: 0.9759 - val_loss: 0.8327 - val_acc: 0.8893
Epoch 3/100
48000/48000 [==============================] - 12s - loss: 0.0792 - acc: 0.9804 - val_loss: 0.6947 - val_acc: 0.9099
...
loss: 0.0123 - acc: 0.9971 - val_loss: 0.6827 - val_acc: 0.9217
Epoch 98/100
48000/48000 [==============================] - 13s - loss: 0.0097 - acc: 0.9975 - val_loss: 0.7074 - val_acc: 0.9211
Epoch 99/100
48000/48000 [==============================] - 13s - loss: 0.0081 - acc: 0.9984 - val_loss: 0.6846 - val_acc: 0.9205
Epoch 100/100
48000/48000 [==============================] - 13s - loss: 0.0090 - acc: 0.9977 - val_loss: 0.6739 - val_acc: 0.9226
आखिरी बार मॉडल को सेव करते हैं।
full_model.save_weights('classification_complete.h5')
आइए आपके मॉडल के मूल्यांकन को परिप्रेक्ष्य में रखते हुए ट्रेनिंग और वैलिडेशन डेटा के बीच एक्युरेसी और लॉस के प्लॉट बनाते हैं:
accuracy = classify_train.history['acc']
val_accuracy = classify_train.history['val_acc']
loss = classify_train.history['loss']
val_loss = classify_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
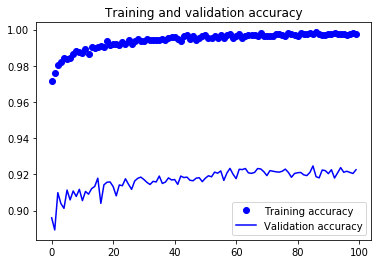
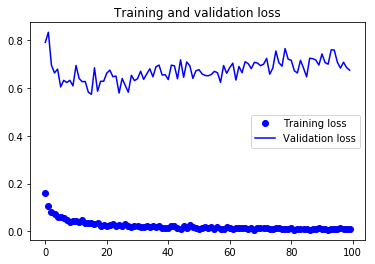
ऊपर दिए गए दोनों प्लॉट्स से आप देख सकते हैं कि मॉडल ओवरफ़िटिंग कर रहा है क्योंकि ट्रेनिंग और वैलिडेशन लॉस के बीच बड़ा गैप है। ओवरफ़िटिंग से निपटने के लिए, आपको संभवतः Dropout जैसी कुछ रेग्युलराइज़ेशन तकनीकों का उपयोग करना होगा। आप Python में keras के साथ इस CNN ट्यूटोरियल का अनुसरण कर सकते हैं।
अंत में, चलिए अपने मॉडल का टेस्ट डेटा पर भी मूल्यांकन करते हैं और देखते हैं कि यह कैसा प्रदर्शन करता है!
test_eval = full_model.evaluate(test_data, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.7068972043234281)
('Test accuracy:', 0.9205)
predicted_classes = full_model.predict(test_data)
क्योंकि आपको जो प्रेडिक्शंस मिलती हैं वे फ़्लोटिंग पॉइंट वैल्यूज़ होती हैं, इसलिए प्रेडिक्टेड लेबल्स की तुलना सही टेस्ट लेबल्स से करना व्यावहारिक नहीं होगा। इसलिए, आप आउटपुट को राउंड ऑफ़ करेंगे जिससे फ़्लोट वैल्यूज़ इंटीजर में कन्वर्ट हो जाएँगी। आगे, आप np.argmax() का उपयोग करेंगे ताकि उस इंडेक्स नंबर का चयन किया जा सके जिसकी किसी रो में वैल्यू अधिक है।
उदाहरण के लिए, मान लें कि एक टेस्ट इमेज के लिए प्रेडिक्शन [0 1 0 0 0 0 0 0 0 0] है, तो इसका आउटपुट क्लास लेबल 1 होना चाहिए।
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_labels.shape
((10000,), (10000,))
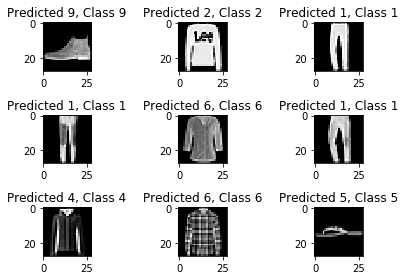
correct = np.where(predicted_classes==test_labels)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_labels[correct]))
    plt.tight_layout()
Found 9204 correct labels
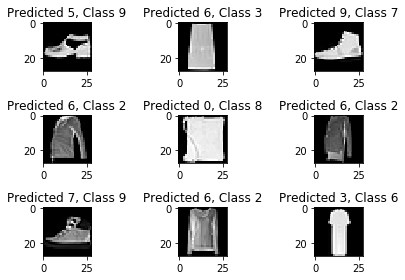
incorrect = np.where(predicted_classes!=test_labels)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_labels[incorrect]))
    plt.tight_layout()
Found 796 incorrect labels
क्लासिफ़िकेशन रिपोर्ट आपको अधिक विस्तार से मिसक्लासिफ़ाइड क्लासेज़ की पहचान करने में मदद करेगी। आप देख पाएँगे कि दी गई दस क्लासेज़ में से किन क्लासेज़ पर मॉडल ने कमज़ोर प्रदर्शन किया।
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_labels, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.83      0.89      0.86      1000
    Class 1       0.99      0.99      0.99      1000
    Class 2       0.89      0.87      0.88      1000
    Class 3       0.92      0.93      0.92      1000
    Class 4       0.85      0.90      0.88      1000
    Class 5       0.99      0.99      0.99      1000
    Class 6       0.81      0.72      0.76      1000
    Class 7       0.96      0.98      0.97      1000
    Class 8       0.98      0.98      0.98      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
यह ट्यूटोरियल Python और Keras के साथ ऑटोएन्कोडर और फ़ुली कनेक्टेड कॉन्वोल्यूशनल न्यूरल नेटवर्क दोनों का उपयोग करने की एक अच्छी शुरुआत था। यदि आप आसानी से या थोड़ी मेहनत के साथ भी साथ चल पाए हैं, तो बहुत बढ़िया! कुछ प्रयोग करने की कोशिश करें—शायद वही मॉडल आर्किटेक्चर रखते हुए अलग-अलग प्रकार के पब्लिक डेटासेट्स का उपयोग करें।
अब भी सीखने के लिए बहुत कुछ है, तो क्यों न DataCamp का Deep Learning in Python कोर्स कर लिया जाए? इस बीच, यदि आपने अभी तक नहीं किया है, तो Keras डाक्यूमेंटेशन भी ज़रूर देखें। वहाँ आपको और उदाहरण, सभी फ़ंक्शन्स, आर्ग्युमेंट्स, नई लेयर्स आदि पर जानकारी मिलेगी। Python में न्यूरल नेटवर्क्स के साथ काम करना सीखते समय यह निस्संदेह एक अनिवार्य संसाधन होगा!
यदि आप ऐसा पुस्तक पढ़ना पसंद करेंगे जो डीप लर्निंग (Keras के साथ) की बुनियादों को समझाती है और यह भी बताती है कि व्यवहार में इसका उपयोग कैसे होता है, तो आपको François Chollet की Deep Learning in Python पुस्तक अवश्य पढ़नी चाहिए।
Python कोर्स
कोर्स
कोर्स
कोर्स