Cursus
Introductie tot Deep Learning in Python
4 uur
264.8K
Opmerking: Deze tutorial draait vooral om de praktische implementatie van classificatie met een convolutioneel neuraal netwerk en een convolutionele autoencoder. Als je nog niet bekend bent met het convolutionele neuraal netwerk (CNN) en de autoencoder, bekijk dan zeker de tutorials over CNN en Autoencoder.
Meer specifiek behandel je in deze tutorial de volgende onderwerpen:
Voordat we de dataset gaan laden en verwerken, is het handig om kort te begrijpen wat voor dataset dit is, wat de afmetingen zijn en hoeveel verschillende klassen er in de dataset zitten.
De Fashion-MNIST-dataset bestaat uit 28x28-grijswaardebeelden van 70.000 modeproducten uit 10 categorieën, met 7.000 afbeeldingen per categorie. De trainingsset bevat 60.000 afbeeldingen en de testset 10.000 afbeeldingen. Fashion-MNIST is een vervanging voor de oorspronkelijke MNIST-dataset om betere resultaten te behalen; de afbeeldingsafmetingen en de splitsing in train/test zijn vergelijkbaar met de originele MNIST-dataset. De dataset is gratis beschikbaar op deze URL en kan worden geladen met zowel tensorflow als keras zonder dat je hem op je computer hoeft te downloaden.
Net als bij MNIST bestaat Fashion-MNIST ook uit 10 klassen, maar in plaats van handgeschreven cijfers hebben we 10 verschillende klassen van modeartikelen zoals sandalen, shirts, broeken, enzovoort.
De opdracht is om een convolutionele autoencoder te trainen en het encoder-gedeelte, gecombineerd met fully connected-lagen, te gebruiken om een nieuw voorbeeld uit de testset correct te herkennen.
Tip: wil je leren hoe je een Multi-Layer Perceptron (MLP) implementeert voor classificatietaken met de MNIST-dataset, bekijk dan deze tutorial.
In de onderstaande code stel je omgevingsvariabelen in de notebook in met os.environ. Het is handig om dit te doen vóór je Keras initialiseert, om de Keras-backend TensorFlow te beperken tot het gebruik van de eerste GPU. Als de machine waarop je traint een GPU op 0 heeft, zorg dan dat je 0 gebruikt in plaats van 1. Je kunt dit controleren met een eenvoudige opdracht in je terminal, bijvoorbeeld nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="0" #model will be trained on GPU 0
Vervolgens importeer je alle vereiste modules zoals numpy, matplotlib en vooral Keras, want in deze tutorial gebruik je keras als framework!
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
from keras.utils import to_categorical
Using TensorFlow backend.
/usr/local/lib/python2.7/dist-packages/h5py/__init__.py:34: FutureWarning: Conversion of the second argument of issubdtype from `float` to `np.floating` is deprecated. In future, it will be treated as `np.float64 == np.dtype(float).type`.
  from ._conv import register_converters as _register_converters
Hier definieer je een functie die het gzip-bestand opent en het bestand leest met bytestream.read(). Je geeft de afbeeldingsafmeting en het totale aantal afbeeldingen door aan deze functie. Vervolgens zet je met np.frombuffer() de string die is opgeslagen in de variabele buf om in een NumPy-array van het type float32.
Zodra dit een NumPy-array is, reshape je de array naar een driedimensionale array of tensor, waarbij de eerste dimensie het aantal afbeeldingen is en de tweede en derde dimensie de afbeeldingsafmetingen zijn. Tot slot retourneer je de NumPy-array data.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Nu roep je de functie extract_data() aan en geef je de train- en testbestanden met hun respectieve aantallen afbeeldingen door.
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
Op dezelfde manier definieer je een extract labels-functie die het gzip-bestand opent en leest met bytestream.read(), waaraan je de labeldimensie (1) en het totale aantal afbeeldingen doorgeeft. Daarna zet je met np.frombuffer() de string in de variabele buf om in een NumPy-array van het type int64.
Dit keer hoef je de array niet te reshapen, omdat de variabele labels een kolomvector van 60.000 x 1 oplevert. Tot slot retourneer je de NumPy-array labels.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Nu roep je de functie voor het extraheren van labels aan en geef je de train- en test-labelfiles met hun respectieve aantallen door.
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Als je de train- en testdata eenmaal geladen hebt, kun je de data analyseren om gevoel te krijgen bij de dataset waarmee je in deze tutorial gaat werken!
Laten we bekijken hoe de afbeeldingen in de dataset eruitzien en ook de afmetingen van de afbeeldingen bekijken met behulp van het NumPy-arrayattribuut .shape:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Uit bovenstaande output zie je dat de trainingsdata de vorm 60000 x 28 x 28 heeft, omdat er 60.000 trainingsvoorbeelden zijn, elk een 28 x 28-matrix. Op vergelijkbare wijze heeft de testdata de vorm 10000 x 28 x 28, omdat er 10.000 testvoorbeelden zijn.
Opmerking: bij de reconstructietaak met een convolutionele autoencoder heb je geen train- en testlabels nodig. Je trainingsafbeeldingen fungeren zowel als invoer als als ground truth, vergelijkbaar met labels bij een classificatietaak.
Maar voor de classificatietaak heb je ook je labels naast de afbeeldingen nodig; dat ga je later in de tutorial doen. Hoewel de taak hier alleen met de train- en testafbeeldingen werkt, gebruik je voor verkenningsdoeleinden — wat je beter inzicht in de data kan geven — wel de labels.
Laten we een dictionary maken met klassenamen en hun bijbehorende categorische klasselabels:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Bekijk nu een paar afbeeldingen uit je dataset:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[10], (28,28))
curr_lbl = train_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[10], (28,28))
curr_lbl = test_labels[10]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
Text(0.5,1,'(Label: E)')
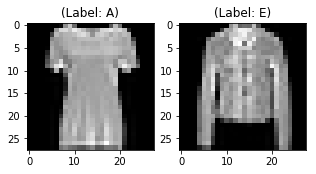
De output van de bovenstaande twee plots is een voorbeeldafbeelding uit zowel de train- als de testdata, en deze afbeeldingen hebben respectievelijk klasselabel 0 of A en 4 of E. Op dezelfde manier hebben andere letters verschillende labels, maar dezelfde letters hebben hetzelfde label. Dit betekent dat alle 6.000 afbeeldingen van klasse E het klasselabel 4 hebben.
De afbeeldingen in de dataset zijn grijswaardebeelden met pixelwaarden van 0 tot 255 en afmetingen van 28 x 28, dus voordat we de data aan het model voeren, is het belangrijk om te preprocessen. Je zet eerst elke 28 x 28-afbeelding van de train- en testset om naar een matrix van 28 x 28 x 1, die je aan het netwerk kunt voeren:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Controleer vervolgens het datatype van de train- en test-NumPy-arrays; dit moet float32 zijn. Zo niet, converteer je het naar dit formaat, maar omdat je dit al deed bij het inlezen van de data, hoeft dat nu niet meer. Je moet ook de pixelwaarden rescalen naar het bereik 0–1. Laten we dat doen!
Vergeet niet de datatypes van train en test te verifiëren:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Rescale daarna de train- en testdata met de maximale pixelwaarde van de train- en testdata:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Laten we verifiëren dat de maximale waarde van train- en testdata na rescaling 1.0 is!
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Daarna is het belangrijk om de data te verdelen. Om ons model goed te laten generaliseren, splits je de trainingsdata in tweeën: een train- en een validatieset. Je traint je model op 80% van de data en valideert op 20% van de overgebleven trainingsdata.
Dit helpt ook om overfitting te verminderen, omdat je het model valideert op data die het tijdens de training niet heeft gezien.
Je kunt de module train_test_split van scikit-learn gebruiken om de data goed te verdelen:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Opmerking: Bovenstaande datasplitsing gebruik je twee keer: één keer voor de reconstructietaak met een convolutionele autoencoder, waarvoor je geen train- en testlabels nodig hebt. Daarom geef je de trainingsafbeeldingen twee keer door. Je trainingsafbeeldingen fungeren zowel als input als ground truth, vergelijkbaar met labels in een classificatietaak.
Maar voor de classificatietaak geef je ook je labels mee, wat je later in de tutorial gaat doen.
Nu kun je het netwerk definiëren en de data erin voeren. Dus zonder verder oponthoud, door naar de volgende stap!
De afbeeldingen hebben een grootte van 28 x 28 x 1 of een vector van 30976 dimensies. Je zet de afbeelding om naar een array, rescalet tussen 0 en 1, reshaped naar 28 x 28 x 1 en voert dit als input aan het netwerk.
Ook gebruik je een batchgrootte van 128; een hogere batchgrootte van 256 of 512 is ook prima — het hangt af van het systeem waarop je traint. Dit draagt sterk bij aan het bepalen van de leerparameters en beïnvloedt de predictienauwkeurigheid.
batch_size = 64
epochs = 200
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
num_classes = 10
Zoals je waarschijnlijk al weet, bestaat de autoencoder uit twee delen: een encoder en een decoder.
Encoder: heeft 4 convolutionele blokken, elk met een convolutionele laag gevolgd door een batch-normalisatielaag. Na het eerste en tweede convolutionele blok wordt een max-poolinglaag gebruikt.
Decoder: heeft 3 convolutionele blokken, elk met een convolutionele laag gevolgd door een batch-normalisatielaag. Na het tweede en derde convolutionele blok wordt een upsamplinglaag gebruikt.
De max-poolinglaag downsamplet de input telkens met een factor twee, terwijl de upsamplinglaag de input telkens met een factor twee upsamplet.
Opmerking: het aantal filters, de filtergrootte, het aantal lagen en het aantal epochs waarin je je model traint, zijn allemaal hyperparameters en moeten worden bepaald op basis van je eigen intuïtie. Voel je vrij om te experimenteren met deze hyperparameters en de prestaties van je model te meten. Zo leer je stap voor stap de kunst van deep learning!
Laten we aparte encoder- en decoderfuncties maken, omdat je de encodergewichten later voor classificatie gaat gebruiken!
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4

def decoder(conv4):
    #decoder
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv4) #7 x 7 x 128
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv5) #7 x 7 x 64
    conv6 = BatchNormalization()(conv6)
    conv6 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv6)
    conv6 = BatchNormalization()(conv6)
    up1 = UpSampling2D((2,2))(conv6) #14 x 14 x 64
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 32
    conv7 = BatchNormalization()(conv7)
    conv7 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv7)
    conv7 = BatchNormalization()(conv7)
    up2 = UpSampling2D((2,2))(conv7) # 28 x 28 x 32
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Nadat het model is gemaakt, moet je het compileren met de optimizer RMSProp.
Merk op dat je ook het verlies (loss) moet specificeren via het argument loss. In dit geval is dat de mean squared error, omdat het verlies na elke batch wordt berekend tussen de batch met voorspelde output en de ground truth met de gemiddelde kwadratische fout, pixel voor pixel:
autoencoder = Model(input_img, decoder(encoder(input_img)))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Laten we de lagen die je hierboven hebt gemaakt visualiseren met de summary-functie. Dit toont het aantal parameters (gewichten en biases) per laag en het totale aantal parameters in je model.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_16 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_15 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
...

batch_normalization_28 (Batc (None, 14, 14, 32)        128
_________________________________________________________________
up_sampling2d_4 (UpSampling2 (None, 28, 28, 32)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         289
=================================================================
Total params: 1,758,657
Trainable params: 1,755,841
Non-trainable params: 2,816
_________________________________________________________________
Het is eindelijk tijd om het model te trainen met Keras’ fit()-functie! Het model traint 200 epochs. De fit()-functie retourneert een history-object; door het resultaat in autoencoder_train op te slaan, kun je later de verliescurves tussen training en validatie plotten, wat helpt om de prestaties van je model visueel te analyseren.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/200
48000/48000 [==============================] - 19s - loss: 0.0202 - val_loss: 0.0114s: 0.020
Epoch 2/200
48000/48000 [==============================] - 17s - loss: 0.0087 - val_loss: 0.0071
...
Epoch 199/200
48000/48000 [==============================] - 18s - loss: 7.0886e-04 - val_loss: 8.9876e-04
Epoch 200/200
48000/48000 [==============================] - 18s - loss: 7.0929e-04 - val_loss: 0.0010
Mooi! Je trainde het model op de fashion-mnist-dataset voor 100 epochs. Laten we nu de verliescurves tussen training en validatie plotten om de modelprestaties te visualiseren.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
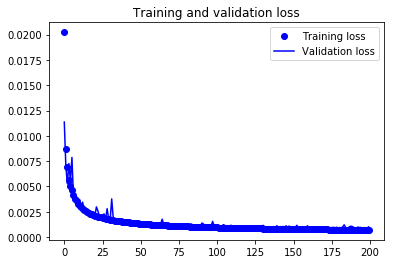
Je ziet dat de validatieloss en de trainingloss in de pas lopen. Dit toont aan dat je model niet overfit: de validatieloss daalt en stijgt niet, en er is tijdens de training nauwelijks een kloof tussen training- en validatieloss.
Daarom kun je zeggen dat de generalisatiecapaciteit van je model goed is.
Maar onthoud: de opdracht is om het hierboven getrainde encoderdeel te gebruiken om de fashion mnist-afbeeldingen te classificeren. Door naar het volgende deel!
Aangezien je de encodergewichten nodig hebt voor je classificatietaak, slaan we eerst de complete autoencodergewichten op. Je leert zo hoe je de encodergewichten kunt extraheren.
autoencoder.save_weights('autoencoder.h5')
Nu ga je de kop van de getrainde autoencoder gebruiken, oftewel het encoderdeel, en de gewichten laden van de zojuist getrainde autoencoder, maar dan alleen in het encodergedeelte van het model.
Je voegt enkele dichte of fully connected-lagen toe aan de encoder om fashion mnist-afbeeldingen te classificeren.
Bij one-hot-encoding zet je categorische data om naar een vector met getallen. De reden hiervoor is dat machine learning-algoritmen niet direct met categorische data kunnen werken. Je genereert voor elke categorie of klasse één booleaanse kolom. Voor elk sample kan slechts één van deze kolommen de waarde 1 hebben. Vandaar de term one-hot-encoding.
Voor jouw probleemstelling is de one-hot-encoding een rijvector, en voor elke afbeelding heeft die de dimensie 1 x 10. Belangrijk is dat de vector uit allemaal nullen bestaat, behalve voor de klasse die hij representeert; die is 1.
Converteer de labels nu naar one-hot-encoding vectors:
# Change the labels from categorical to one-hot encoding
train_Y_one_hot = to_categorical(train_labels)
test_Y_one_hot = to_categorical(test_labels)

# Display the change for category label using one-hot encoding
print('Original label:', train_labels[0])
print('After conversion to one-hot:', train_Y_one_hot[0])
('Original label:', 9)
('After conversion to one-hot:', array([0., 0., 0., 0., 0., 0., 0., 0., 0., 1.]))
Duidelijk, toch?
train_X,valid_X,train_label,valid_label = train_test_split(train_data,train_Y_one_hot,test_size=0.2,random_state=13)
Laten we voor de zekerheid nog één keer de vorm van de train- en validatieset controleren.
train_X.shape,valid_X.shape,train_label.shape,valid_label.shape
((48000, 28, 28, 1), (12000, 28, 28, 1), (48000, 10), (12000, 10))
Definieer nu het classificatiemodel. Onthoud dat je exact hetzelfde encodergedeelte gebruikt als in de autoencoder-architectuur.
def encoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 256 (small and thick)
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(256, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    return conv4
Definieer de fully connected-lagen die je bovenop de encoderfunctie stapelt.
def fc(enco):
    flat = Flatten()(enco)
    den = Dense(128, activation='relu')(flat)
    out = Dense(num_classes, activation='softmax')(den)
    return out
encode = encoder(input_img)
full_model = Model(input_img,fc(encode))
for l1,l2 in zip(full_model.layers[:19],autoencoder.layers[0:19]):
    l1.set_weights(l2.get_weights())
Opmerking: de volgende stap is belangrijk. Om zeker te zijn dat de gewichten van het encodergedeelte van de autoencoder gelijk zijn aan de gewichten die je hebt geladen in de encoderfunctie van het classificatiemodel, moet je altijd de gewichten van dezelfde laag van beide modellen printen. Als ze niet overeenkomen, heeft de autoencoder-classificatiestrategie geen zin.
Laten we de gewichten van de eerste laag van beide modellen printen.
autoencoder.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
full_model.get_weights()[0][1]
array([[[ 0.22935028, -0.800786  ,  0.42421195, -0.6509941 ,
         -0.82958347, -0.44448015,  0.04182598, -0.05483926,
          0.44611776,  0.7123421 , -0.4499234 ,  0.16125064,
          0.1174996 ,  0.12156075,  0.8391102 , -0.44067   ,
          0.02915774, -0.7223025 ,  0.33398604, -0.69252896,
          0.04369332, -0.3793029 ,  0.37535954,  0.34269437,
          0.8863593 , -0.2114254 ,  0.21323568, -0.4076597 ,
          0.2965019 ,  0.11617199, -0.22282824, -0.9501956 ]],

       [[ 0.23096658,  0.3701021 ,  0.78717273, -0.5014979 ,
         -1.3326751 , -0.73818666,  2.6434395 , -0.7560537 ,
         -0.52561104, -0.67917436,  2.0205429 ,  0.14013338,
         -0.9140436 ,  0.169709  ,  0.09063474, -0.20975377,
         -0.11247484, -0.09702996,  0.17846109,  0.40699893,
         -0.5722246 , -1.0119121 ,  0.30877167,  0.6645408 ,
         -0.68007207, -0.57144946, -0.68339616,  0.45407826,
          1.0148963 ,  0.88867754, -0.57179326,  0.01268557]],

       [[ 0.23020297,  0.14018346, -0.37600747, -0.6213855 ,
         -0.4104492 , -0.2036299 ,  0.12469969,  0.08351921,
          0.20644444, -0.01170571, -0.07618313,  0.23164392,
         -0.38417578,  0.3481844 , -0.8055927 ,  0.76824665,
          0.06819476,  0.93830526,  0.31898668,  0.51119566,
          0.4445658 , -0.4568496 ,  0.1269397 , -0.34482956,
         -1.3285302 , -0.20479   , -0.17618039, -0.22546193,
         -0.35588196,  0.9971566 , -0.03546353, -0.7294457 ]]],
      dtype=float32)
Voilà! Beide arrays zijn exact gelijk. Dus laten we zonder verder oponthoud het model compileren en het trainen starten.
Vervolgens zet je het encodergedeelte — de eerste negentien lagen van het model — op niet-trainbaar. Omdat de encoder al getraind is, hoef je die niet opnieuw te trainen. Je traint alleen het fully connected-gedeelte.
for layer in full_model.layers[0:19]:
    layer.trainable = False
Compileer het model!
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Print ook de samenvatting van het model. Er zouden ook niet-trainbare parameters moeten zijn, omdat je de eerste vijftien lagen van het model niet-trainbaar hebt gemaakt.
full_model.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_55 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
batch_normalization_53 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
conv2d_56 (Conv2D)           (None, 28, 28, 32)        9248
_________________________________________________________________
batch_normalization_54 (Batc (None, 28, 28, 32)        128
_________________________________________________________________
max_pooling2d_11 (MaxPooling (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_57 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
batch_normalization_55 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
conv2d_58 (Conv2D)           (None, 14, 14, 64)        36928
_________________________________________________________________
batch_normalization_56 (Batc (None, 14, 14, 64)        256
_________________________________________________________________
max_pooling2d_12 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_59 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
batch_normalization_57 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_60 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
batch_normalization_58 (Batc (None, 7, 7, 128)         512
_________________________________________________________________
conv2d_61 (Conv2D)           (None, 7, 7, 256)         295168
_________________________________________________________________
batch_normalization_59 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
conv2d_62 (Conv2D)           (None, 7, 7, 256)         590080
_________________________________________________________________
batch_normalization_60 (Batc (None, 7, 7, 256)         1024
_________________________________________________________________
flatten_4 (Flatten)          (None, 12544)             0
_________________________________________________________________
dense_7 (Dense)              (None, 128)               1605760
_________________________________________________________________
dense_8 (Dense)              (None, 10)                1290
=================================================================
Total params: 2,782,570
Trainable params: 1,607,050
Non-trainable params: 1,175,520
_________________________________________________________________
Het is tijd om het model te trainen met Keras’ fit()-functie! Het model traint 10 epochs. De fit()-functie retourneert een history-object; door het resultaat in fashion_train op te slaan, kun je later de accuracy- en loss-curves tussen training en validatie plotten en zo de prestaties van je model visueel analyseren.
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 6s - loss: 0.3747 - acc: 0.8732 - val_loss: 0.2888 - val_acc: 0.8935
Epoch 2/100
48000/48000 [==============================] - 6s - loss: 0.2216 - acc: 0.9178 - val_loss: 0.2942 - val_acc: 0.9010
Epoch 3/100
48000/48000 [==============================] - 5s - loss: 0.1762 - acc: 0.9340 - val_loss: 0.2868 - val_acc: 0.9078
...
Epoch 74/100
48000/48000 [==============================] - 6s - loss: 0.0182 - acc: 0.9953 - val_loss: 0.8069 - val_acc: 0.9109
Epoch 75/100
48000/48000 [==============================] - 6s - loss: 0.0102 - acc: 0.9971 - val_loss: 0.7872 - val_acc: 0.9125
Epoch 76/100
11776/48000 [======>.......................] - ETA: 3s - loss: 0.0084 - acc: 0.9977
Mooi! Je trainde het model op fashion-MNIST in slechts 10 epochs, en afgaand op de trainingsaccuracy en -loss kun je zeggen dat het model het uitstekend deed: na 10 epochs is de trainingsaccuracy 99% en de validatieloss 98%.
Laten we het classificatiemodel opslaan!
full_model.save_weights('autoencoder_classification.h5')
Vervolgens ga je het model opnieuw trainen waarbij je de eerste negentien lagen trainable op True zet in plaats van False! Laten we dat snel doen.
for layer in full_model.layers[0:19]:
    layer.trainable = True
full_model.compile(loss=keras.losses.categorical_crossentropy, optimizer=keras.optimizers.Adam(),metrics=['accuracy'])
Nu trainen we het volledige model nog één keer!
classify_train = full_model.fit(train_X, train_label, batch_size=64,epochs=100,verbose=1,validation_data=(valid_X, valid_label))
Train on 48000 samples, validate on 12000 samples
Epoch 1/100
48000/48000 [==============================] - 13s - loss: 0.1584 - acc: 0.9718 - val_loss: 0.7902 - val_acc: 0.8960
Epoch 2/100
48000/48000 [==============================] - 12s - loss: 0.1049 - acc: 0.9759 - val_loss: 0.8327 - val_acc: 0.8893
Epoch 3/100
48000/48000 [==============================] - 12s - loss: 0.0792 - acc: 0.9804 - val_loss: 0.6947 - val_acc: 0.9099
...
loss: 0.0123 - acc: 0.9971 - val_loss: 0.6827 - val_acc: 0.9217
Epoch 98/100
48000/48000 [==============================] - 13s - loss: 0.0097 - acc: 0.9975 - val_loss: 0.7074 - val_acc: 0.9211
Epoch 99/100
48000/48000 [==============================] - 13s - loss: 0.0081 - acc: 0.9984 - val_loss: 0.6846 - val_acc: 0.9205
Epoch 100/100
48000/48000 [==============================] - 13s - loss: 0.0090 - acc: 0.9977 - val_loss: 0.6739 - val_acc: 0.9226
Laten we het model voor de laatste keer opslaan.
full_model.save_weights('classification_complete.h5')
Zet je modelevaluatie in perspectief en plot de accuracy- en loss-curves voor train- en validatiedata:
accuracy = classify_train.history['acc']
val_accuracy = classify_train.history['val_acc']
loss = classify_train.history['loss']
val_loss = classify_train.history['val_loss']
epochs = range(len(accuracy))
plt.plot(epochs, accuracy, 'bo', label='Training accuracy')
plt.plot(epochs, val_accuracy, 'b', label='Validation accuracy')
plt.title('Training and validation accuracy')
plt.legend()
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
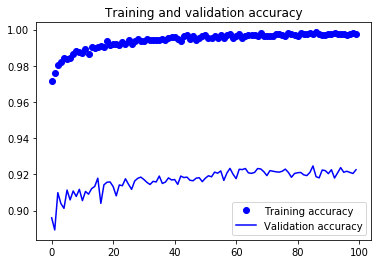
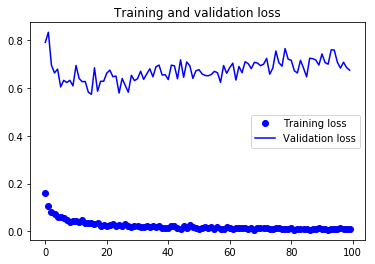
Uit de twee bovenstaande plots zie je dat het model overfit, omdat er een grote kloof is tussen de training- en validatieloss. Om overfitting aan te pakken, kun je regularisatietechnieken zoals Dropout gebruiken. Volg deze tutorial over CNN in Python met Keras.
Laten we je model ook evalueren op de testdata en zien hoe het presteert!
test_eval = full_model.evaluate(test_data, test_Y_one_hot, verbose=0)
print('Test loss:', test_eval[0])
print('Test accuracy:', test_eval[1])
('Test loss:', 0.7068972043234281)
('Test accuracy:', 0.9205)
predicted_classes = full_model.predict(test_data)
Omdat de voorspellingen zwevende-kommagetallen zijn, is het niet handig om de voorspelde labels te vergelijken met de echte testlabels. Daarom rond je de output af, zodat de floats naar gehele getallen worden omgezet. Vervolgens gebruik je np.argmax() om de index te kiezen met de hoogste waarde in een rij.
Stel bijvoorbeeld dat een voorspelling voor één testafbeelding [0 1 0 0 0 0 0 0 0 0] is; de output hiervan moet het klasselabel 1 zijn.
predicted_classes = np.argmax(np.round(predicted_classes),axis=1)
predicted_classes.shape, test_labels.shape
((10000,), (10000,))
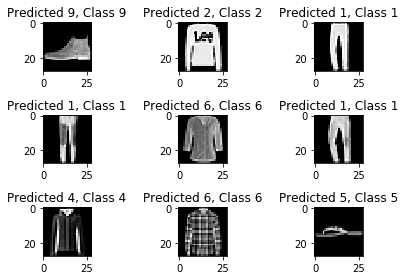
correct = np.where(predicted_classes==test_labels)[0]
print "Found %d correct labels" % len(correct)
for i, correct in enumerate(correct[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[correct].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[correct], test_labels[correct]))
    plt.tight_layout()
Found 9204 correct labels
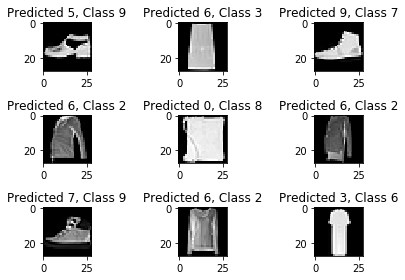
incorrect = np.where(predicted_classes!=test_labels)[0]
print "Found %d incorrect labels" % len(incorrect)
for i, incorrect in enumerate(incorrect[:9]):
    plt.subplot(3,3,i+1)
    plt.imshow(test_data[incorrect].reshape(28,28), cmap='gray', interpolation='none')
    plt.title("Predicted {}, Class {}".format(predicted_classes[incorrect], test_labels[incorrect]))
    plt.tight_layout()
Found 796 incorrect labels
Het classificatierapport helpt je de verkeerd geclassificeerde klassen in meer detail te identificeren. Je kunt zien voor welke klasse het model slecht presteerde van de tien gegeven klassen.
from sklearn.metrics import classification_report
target_names = ["Class {}".format(i) for i in range(num_classes)]
print(classification_report(test_labels, predicted_classes, target_names=target_names))
             precision    recall  f1-score   support

    Class 0       0.83      0.89      0.86      1000
    Class 1       0.99      0.99      0.99      1000
    Class 2       0.89      0.87      0.88      1000
    Class 3       0.92      0.93      0.92      1000
    Class 4       0.85      0.90      0.88      1000
    Class 5       0.99      0.99      0.99      1000
    Class 6       0.81      0.72      0.76      1000
    Class 7       0.96      0.98      0.97      1000
    Class 8       0.98      0.98      0.98      1000
    Class 9       0.98      0.96      0.97      1000

avg / total       0.92      0.92      0.92     10000
Deze tutorial is een goede start om zowel een autoencoder als een volledig connected convolutioneel neuraal netwerk te gebruiken met Python en Keras. Als je makkelijk kon volgen, of zelfs met wat extra moeite: goed gedaan! Probeer wat experimenten, bijvoorbeeld met dezelfde modelarchitectuur maar met andere publieke datasets.
Er is nog veel meer te leren, dus waarom zou je niet DataCamps cursus Deep Learning in Python volgen? Bekijk intussen ook zeker de Keras-documentatie, als je dat nog niet gedaan hebt. Je vindt er meer voorbeelden en informatie over alle functies, argumenten, extra lagen, enzovoort. Het zal ongetwijfeld een onmisbare bron zijn wanneer je leert werken met neurale netwerken in Python!
Lees je liever een boek dat de fundamenten van deep learning (met Keras) uitlegt en ook de praktijk behandelt, lees dan zeker François Chollets boek Deep Learning in Python.
Python-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

