Kursus
Pengantar Deep Learning dengan Python
4 jam
264.6K
Secara umum, Anda dapat menganggap autoencoder sebagai teknik pembelajaran tanpa supervisi, karena Anda tidak memerlukan label eksplisit untuk melatih model. Yang Anda butuhkan hanyalah data masukan mentah.
Dalam tutorial ini, Anda akan mempelajari autoencoder dalam deep learning dan akan mengimplementasikan convolutional dan denoising autoencoder di Python dengan Keras. Anda akan bekerja dengan dataset alfabet NotMNIST sebagai contoh.
Singkatnya, Anda akan membahas topik-topik berikut pada tutorial hari ini:
Seperti yang Anda baca di pendahuluan, autoencoder adalah algoritma machine learning tanpa supervisi yang mengambil gambar sebagai masukan dan mencoba merekonstruksinya menggunakan jumlah bit yang lebih sedikit dari bottleneck yang juga dikenal sebagai latent space. Gambar dikompresi secara signifikan di bottleneck. Kompresi pada autoencoder dicapai dengan melatih jaringan selama periode waktu tertentu dan seiring belajar, jaringan berusaha merepresentasikan gambar masukan sebaik mungkin pada bottleneck. Algoritma kompresi gambar umum seperti JPEG dan teknik kompresi lossless JPEG mengompresi gambar tanpa perlu pelatihan apa pun dan cukup baik dalam mengompresi gambar.
Autoencoder mirip dengan teknik reduksi dimensi seperti Principal Component Analysis (PCA). Mereka memproyeksikan data dari dimensi yang lebih tinggi ke dimensi yang lebih rendah menggunakan transformasi linear dan berusaha mempertahankan fitur penting dari data sambil menghapus bagian yang tidak esensial.
Namun, perbedaan utama antara autoencoder dan PCA terletak pada bagian transformasinya: seperti yang sudah Anda baca, PCA menggunakan transformasi linear sedangkan autoencoder menggunakan transformasi non-linear.
Sekarang setelah Anda memiliki sedikit pemahaman tentang autoencoder, mari kita uraikan istilah ini dan mencoba mendapatkan intuisi tentangnya!
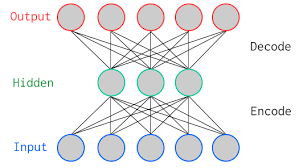
Gambar di atas adalah autoencoder vanilla dua lapis dengan satu hidden layer. Dalam terminologi deep learning, Anda sering melihat bahwa input layer tidak diperhitungkan saat menghitung total jumlah lapisan dalam sebuah arsitektur. Total lapisan dalam arsitektur hanya terdiri dari jumlah hidden layer dan output layer.
Seperti terlihat pada gambar di atas, lapisan masukan dan keluaran memiliki jumlah neuron yang sama.
Mari ambil contoh. Anda memasukkan gambar dengan hanya lima nilai piksel ke autoencoder yang dikompresi oleh encoder menjadi tiga nilai piksel pada bottleneck (lapisan tengah) atau latent space. Menggunakan tiga nilai ini, decoder mencoba merekonstruksi lima nilai piksel atau gambar masukan yang Anda berikan ke jaringan.
Pada kenyataannya, ada lebih banyak hidden layer di antara input dan output.
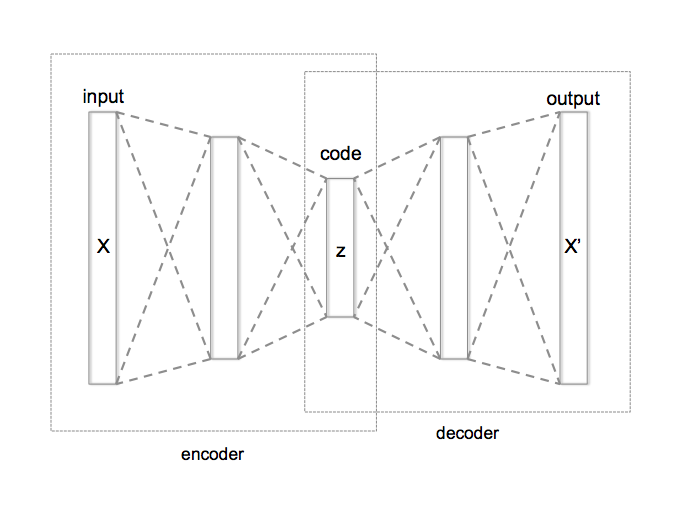
Autoencoder dapat dipecah menjadi tiga bagian
Ada beragam autoencoder, seperti convolutional autoencoder, denoising autoencoder, variational autoencoder, dan sparse autoencoder. Namun, seperti yang Anda baca di pendahuluan, Anda hanya akan fokus pada convolutional dan denoising dalam tutorial ini.Convolutional Autoencoders di Python dengan Keras
Karena data masukan Anda berupa gambar, ada baiknya menggunakan convolutional autoencoder. Ini bukan varian autoencoder, melainkan autoencoder tradisional yang ditumpuk dengan convolution layer: Anda pada dasarnya mengganti fully connected layer dengan convolutional layer. Convolution layer bersama dengan max-pooling layer, mengubah masukan dari lebar (gambar 28 x 28) dan tipis (satu kanal atau skala abu-abu) menjadi kecil (gambar 7 x 7 pada latent space) dan tebal (128 kanal).
Jangan khawatir jika Anda belum memahami gagasan di atas dengan baik! Bagian kedua dari tutorial ini, di mana Anda akan fokus pada implementasinya, semoga akan menjernihkan semua keraguan Anda (jika ada!).
Tip: jika Anda ingin tahu lebih banyak tentang convolutional neural network, lihat tutorial ini.
Ini membantu jaringan mengekstrak fitur visual dari gambar dan karena itu memperoleh representasi latent space yang lebih akurat. Proses rekonstruksi menggunakan upsampling dan convolutions yang dikenal sebagai decoder. Downsampling adalah proses di mana gambar dikompresi ke dimensi rendah yang juga dikenal sebagai encoder.
Penting untuk dicatat bahwa encoder terutama mengompresi gambar masukan, misalnya: jika gambar masukan Anda berdimensi 176 x 176 x 1 (~30976), maka titik kompresi maksimum dapat berdimensi 22 x 22 x 512 (~247808). Jadi, dalam kasus ini, Anda memulai dengan gambar skala abu-abu berukuran 176 x 176 dan dengan melewatinya melalui beberapa convolutional layer dan tepat tiga max-pooling layer, gambar Anda akhirnya di-downsample menjadi dimensi 22 x 22 tetapi jumlah kanalnya meningkat dari 1 menjadi 512. Seperti disebutkan di atas, masukan Anda dari lebar (176 x 176) dan tipis (1) menjadi kecil (22x22) dan tebal (512).
Dataset notMNIST adalah dataset pengenalan gambar dari glif font untuk huruf A hingga J. Ini cukup mirip dengan dataset klasik MNIST, yang berisi gambar angka tulisan tangan 0 hingga 9: dalam kasus ini, Anda akan menemukan bahwa dataset NotMNIST terdiri dari gambar skala abu-abu 28x28 dari 70.000 huruf A - J dalam total 10 kategori, dan 6.000 gambar per kategori.
Tip: jika Anda ingin mempelajari cara mengimplementasikan Multi-Layer Perceptron (MLP) untuk tugas klasifikasi dengan dataset MNIST, lihat tutorial ini.
Dataset NotMNIST tidak terdefinisi sebelumnya di kerangka kerja Keras atau TensorFlow, jadi Anda harus mengunduh data dari sumber ini. Data akan diunduh dalam format ubyte.gzip, tetapi jangan khawatir tentang itu dulu! Anda segera akan belajar cara membaca format bytestream dan mengonversinya menjadi array NumPy. Jadi, mari mulai!
Jaringan akan dilatih pada Nvidia Tesla K40, jadi jika Anda melatih di GPU dan menggunakan Jupyter Notebook, Anda perlu menambahkan tiga baris kode lagi untuk menentukan urutan perangkat CUDA dan perangkat CUDA yang terlihat menggunakan modul bernama os.
Pada kode di bawah, Anda pada dasarnya menyetel variabel lingkungan di notebook menggunakan os.environ. Sebaiknya lakukan hal berikut sebelum menginisialisasi Keras untuk membatasi backend Keras TensorFlow menggunakan GPU pertama. Jika mesin tempat Anda melatih memiliki GPU pada 0, pastikan menggunakan 0 alih-alih 1. Anda dapat memeriksanya dengan menjalankan perintah sederhana di terminal: misalnya, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Selanjutnya, Anda mengimpor semua modul yang diperlukan seperti numpy, matplotlib dan yang terpenting keras, karena Anda akan menggunakan kerangka kerja tersebut pada tutorial hari ini!
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
Using TensorFlow backend.
Di sini, Anda mendefinisikan fungsi yang membuka file gzip, membaca file menggunakan bytestream.read(). Anda meneruskan dimensi gambar dan total jumlah gambar ke fungsi ini. Lalu, menggunakan np.frombuffer(), Anda mengonversi string yang disimpan dalam variabel buf menjadi array NumPy bertipe float32.
Selanjutnya, Anda mengubah bentuk array menjadi array tiga dimensi atau tensor di mana dimensi pertama adalah jumlah gambar, dan dimensi kedua dan ketiga adalah dimensi gambar. Terakhir, Anda mengembalikan array NumPy data.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Sekarang Anda akan memanggil fungsi extract_data() dengan meneruskan file pelatihan dan pengujian beserta jumlah gambar masing-masing:
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
Demikian pula, Anda mendefinisikan fungsi ekstrak label yang membuka file gzip, membaca file menggunakan bytestream.read(), yang Anda beri dimensi label (1) dan total jumlah gambar. Lalu, menggunakan np.frombuffer(), Anda mengonversi string yang disimpan dalam variabel buf menjadi array NumPy bertipe int64.
Kali ini, Anda tidak perlu mengubah bentuk array karena variabel labels akan mengembalikan vektor kolom berdimensi 60.000 x 1. Terakhir, Anda mengembalikan array NumPy labels.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Sekarang Anda akan memanggil fungsi ekstrak label dengan meneruskan file label pelatihan dan pengujian beserta jumlah gambar masing-masing:
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Setelah Anda memuat data pelatihan dan pengujian, Anda siap untuk menganalisis data guna mendapatkan intuisi tentang dataset yang akan Anda gunakan pada tutorial hari ini!
Sekarang mari kita analisis bagaimana tampilan gambar dalam dataset dan juga melihat dimensi gambar dengan bantuan atribut array NumPy .shape:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Dari keluaran di atas, Anda dapat melihat bahwa data pelatihan memiliki bentuk 60000 x 28 x 28 karena ada 60.000 sampel pelatihan masing-masing berupa matriks berdimensi 28 x 28. Demikian pula, data uji memiliki bentuk 10000 x 28 x 28 karena ada 10.000 sampel pengujian.
Catatan bahwa dalam tugas ini, Anda tidak akan menggunakan label pelatihan dan pengujian. Tugas ini hanya akan menangani gambar pelatihan dan pengujian. Namun, untuk tujuan eksplorasi, yang mungkin memberi Anda intuisi lebih baik tentang data, Anda akan memanfaatkan label.
Mari buat kamus yang akan memiliki nama kelas dengan label kelas kategorikalnya masing-masing:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Sekarang, mari lihat beberapa gambar dalam dataset Anda:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[0], (28,28))
curr_lbl = train_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[0], (28,28))
curr_lbl = test_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
<matplotlib.text.Text at 0x7f3ec73db240>
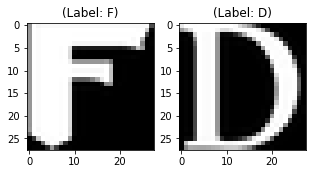
Keluaran dari dua plot di atas adalah salah satu gambar contoh dari data pelatihan dan pengujian, dan gambar-gambar ini diberi label kelas 5 atau F, di satu sisi, dan 3 atau D, di sisi lain. Demikian pula, alfabet lain akan memiliki label berbeda, tetapi alfabet yang serupa akan memiliki label yang sama. Ini berarti bahwa semua 6.000 gambar kelas F akan memiliki label kelas 5.
Gambar pada dataset memang merupakan gambar skala abu-abu dengan nilai piksel berkisar dari 0 hingga 255 dengan dimensi 28 x 28, jadi sebelum Anda memasukkan data ke model sangat penting untuk melakukan prapemrosesan. Anda akan terlebih dahulu mengonversi setiap gambar 28 x 28 dari train dan test set menjadi matriks berukuran 28 x 28 x 1, yang dapat Anda masukkan ke jaringan:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Selanjutnya, Anda ingin memastikan untuk memeriksa tipe data array NumPy pelatihan dan pengujian, seharusnya dalam format float32; jika tidak, Anda perlu mengonversinya ke format ini, tetapi karena Anda telah mengonversinya saat membaca data, Anda tidak perlu melakukannya lagi. Anda juga harus melakukan penskalaan ulang nilai piksel dalam rentang 0 - 1 inklusif. Jadi mari lakukan itu!
Jangan lupa untuk memverifikasi tipe data pelatihan dan pengujian:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Berikutnya, lakukan penskalaan ulang data pelatihan dan pengujian dengan nilai piksel maksimum dari data pelatihan dan pengujian:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Mari verifikasi nilai maksimum data pelatihan dan pengujian yang seharusnya 1.0 setelah penskalaan ulang!
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Setelah semua ini, penting untuk melakukan pemartisian data. Agar model Anda melakukan generalisasi dengan baik, Anda membagi data pelatihan menjadi dua bagian: set pelatihan dan validasi. Anda akan melatih model pada 80% data dan memvalidasinya pada 20% sisa data pelatihan.
Ini juga akan membantu Anda mengurangi kemungkinan overfitting, karena Anda akan memvalidasi model pada data yang tidak dilihatnya pada fase pelatihan.
Anda dapat menggunakan modul train_test_split dari scikit-learn untuk membagi data dengan benar:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Catatan bahwa untuk tugas ini, Anda tidak memerlukan label pelatihan dan pengujian. Itu sebabnya Anda akan meneruskan gambar pelatihan dua kali. Gambar pelatihan Anda akan bertindak sebagai masukan sekaligus ground truth mirip dengan label yang Anda miliki pada tugas klasifikasi.
Sekarang Anda siap untuk mendefinisikan jaringan dan memasukkan data ke dalam jaringan. Jadi tanpa basa-basi lagi, mari lanjut ke langkah berikutnya!
Gambar berukuran 28 x 28 x 1 atau vektor berdimensi 784. Anda mengonversi matriks gambar menjadi array, melakukan penskalaan ulang antara 0 dan 1, mengubah bentuknya sehingga berukuran 28 x 28 x 1, dan memasukkannya sebagai masukan ke jaringan.
Selain itu, Anda akan menggunakan ukuran batch 128; menggunakan ukuran batch yang lebih besar 256 atau 512 juga dapat dipertimbangkan, semua tergantung pada sistem tempat Anda melatih model. Ini sangat berkontribusi dalam menentukan parameter pembelajaran dan memengaruhi akurasi prediksi. Anda akan melatih jaringan selama 50 epoch.
batch_size = 128
epochs = 50
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
Seperti yang dibahas sebelumnya, autoencoder dibagi menjadi dua bagian: ada encoder dan decoder.
Encoder
Decoder
Lapisan max-pooling akan melakukan downsampling pada masukan dua kali setiap kali Anda menggunakannya, sedangkan lapisan upsampling akan melakukan upsampling pada masukan dua kali setiap kali digunakan.
Catatan: Jumlah filter, ukuran filter, jumlah lapisan, jumlah epoch pelatihan model, semuanya adalah hiperparameter dan sebaiknya diputuskan berdasarkan intuisi Anda sendiri; Anda bebas mencoba eksperimen baru dengan mengutak-atik hiperparameter ini dan mengukur kinerja model Anda. Dan begitulah cara Anda perlahan mempelajari seni deep learning!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Setelah model dibuat, Anda harus mengompilasinya menggunakan optimizer RMSProp.
Tip: tonton tutorial ini oleh Andrew Ng tentang RMSProp jika Anda ingin mengetahui lebih lanjut tentang RMSProp.
Perhatikan bahwa Anda juga harus menentukan jenis loss melalui argumen loss. Dalam kasus ini, yaitu mean squared error, karena loss setelah setiap batch akan dihitung antara batch keluaran yang diprediksi dan ground truth menggunakan mean squared error piksel demi piksel:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Mari visualisasikan lapisan yang Anda buat pada langkah di atas dengan menggunakan fungsi ringkasan; ini akan menampilkan jumlah parameter (bobot dan bias) di setiap lapisan dan juga total parameter dalam model Anda.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_6 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
max_pooling2d_9 (MaxPooling2 (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
max_pooling2d_10 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
up_sampling2d_9 (UpSampling2 (None, 14, 14, 128)       0
_________________________________________________________________
conv2d_29 (Conv2D)           (None, 14, 14, 64)        73792
_________________________________________________________________
up_sampling2d_10 (UpSampling (None, 28, 28, 64)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
Akhirnya saatnya melatih model dengan fungsi fit() milik Keras! Model dilatih selama 50 epoch. Fungsi fit() akan mengembalikan objek history; Dengan menyimpan hasil fungsi ini di fashion_train, Anda dapat menggunakannya nanti untuk memplot grafik loss antara pelatihan dan validasi yang akan membantu Anda menganalisis kinerja model secara visual.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/50
48000/48000 [==============================] - 16s - loss: 0.0368 - val_loss: 0.0132
Epoch 2/50
48000/48000 [==============================] - 15s - loss: 0.0101 - val_loss: 0.0085
Epoch 3/50
48000/48000 [==============================] - 15s - loss: 0.0071 - val_loss: 0.0081
Epoch 4/50
48000/48000 [==============================] - 15s - loss: 0.0057 - val_loss: 0.0056
Epoch 5/50
48000/48000 [==============================] - 15s - loss: 0.0048 - val_loss: 0.0051
Epoch 6/50
48000/48000 [==============================] - 15s - loss: 0.0043 - val_loss: 0.0039
Epoch 7/50
48000/48000 [==============================] - 15s - loss: 0.0038 - val_loss: 0.0039
Epoch 8/50
48000/48000 [==============================] - 15s - loss: 0.0035 - val_loss: 0.0039
Epoch 9/50
48000/48000 [==============================] - 15s - loss: 0.0032 - val_loss: 0.0030
Epoch 10/50
48000/48000 [==============================] - 15s - loss: 0.0030 - val_loss: 0.0029
Epoch 11/50
48000/48000 [==============================] - 15s - loss: 0.0029 - val_loss: 0.0026
Epoch 12/50
48000/48000 [==============================] - 15s - loss: 0.0027 - val_loss: 0.0025
Epoch 13/50
48000/48000 [==============================] - 15s - loss: 0.0026 - val_loss: 0.0028
Epoch 14/50
48000/48000 [==============================] - 15s - loss: 0.0025 - val_loss: 0.0022
Epoch 15/50
48000/48000 [==============================] - 15s - loss: 0.0024 - val_loss: 0.0024
Epoch 16/50
48000/48000 [==============================] - 16s - loss: 0.0023 - val_loss: 0.0027
Epoch 17/50
48000/48000 [==============================] - 15s - loss: 0.0023 - val_loss: 0.0022
Epoch 18/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0025
Epoch 19/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0022
Epoch 20/50
48000/48000 [==============================] - 15s - loss: 0.0021 - val_loss: 0.0022
Epoch 21/50
48000/48000 [==============================] - 16s - loss: 0.0021 - val_loss: 0.0020
Epoch 22/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0019
Epoch 23/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0021
Epoch 24/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0018
Epoch 25/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 26/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 27/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0017
Epoch 28/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0018
Epoch 29/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 30/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0017
Epoch 31/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 32/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0018
Epoch 33/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0017
Epoch 34/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0018
Epoch 35/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0019
Epoch 36/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0016
Epoch 37/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0017
Epoch 38/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0019
Epoch 39/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 40/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 41/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 42/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 43/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0018
Epoch 44/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 45/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 46/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 47/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0017
Epoch 48/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0015
Epoch 49/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 50/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0020
Akhirnya! Anda telah melatih model pada Not-MNIST selama 50 epoch. Sekarang, mari plot grafik loss antara data pelatihan dan validasi untuk memvisualisasikan kinerja model.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
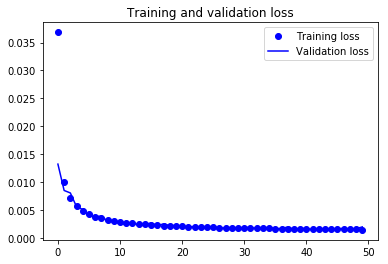
Akhirnya, Anda dapat melihat bahwa validation loss dan training loss selaras. Ini menunjukkan bahwa model Anda tidak overfitting: validation loss menurun dan tidak meningkat, dan jarang ada celah antara training dan validation loss.
Oleh karena itu, Anda dapat mengatakan bahwa kemampuan generalisasi model Anda baik.
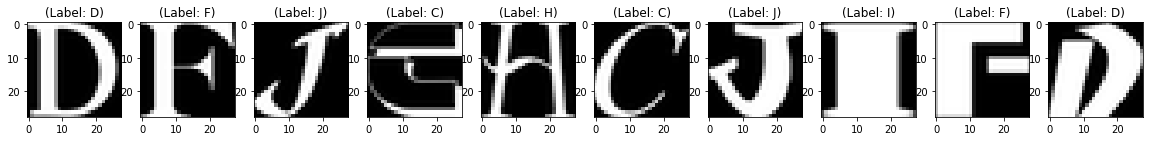
Terakhir, saatnya untuk merekonstruksi gambar uji menggunakan fungsi predict() dari Keras dan melihat seberapa baik model Anda dapat merekonstruksi pada data uji.
Anda akan menjalankan prediksi model terlatih pada seluruh 10.000 gambar uji dan memplot beberapa gambar yang direkonstruksi untuk memvisualisasikan seberapa baik model Anda merekonstruksi gambar uji.
pred = autoencoder.predict(test_data)
pred.shape
(10000, 28, 28, 1)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
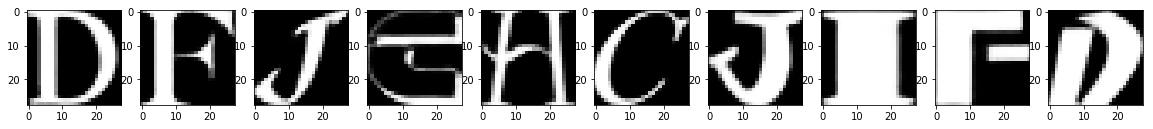
Dari gambar di atas, Anda dapat mengamati bahwa model Anda melakukan pekerjaan yang sangat baik dalam merekonstruksi gambar uji yang Anda prediksi menggunakan model. Setidaknya secara visual, gambar uji dan gambar yang direkonstruksi terlihat hampir sama persis.
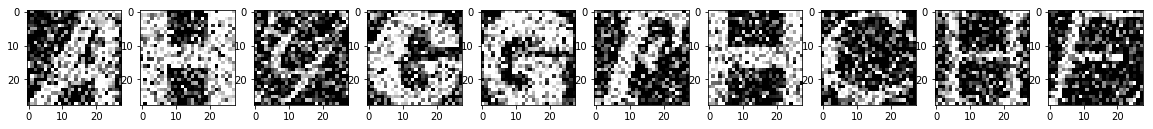
Denoising autoencoder berusaha mempelajari representasi (latent space atau bottleneck) yang tangguh terhadap noise. Anda menambahkan noise ke gambar dan kemudian memasukkan gambar berisik tersebut sebagai masukan ke bagian enooder dari jaringan Anda. Bagian encoder dari autoencoder mentransformasikan gambar ke ruang berbeda yang berusaha mempertahankan alfabet tetapi menghapus noise.
Tapi bagaimana tepatnya ia menghapus noise?
Selama pelatihan, Anda mendefinisikan fungsi loss, mirip dengan root mean squared error yang Anda definisikan sebelumnya pada convolutional autoencoder. Pada setiap iterasi pelatihan, jaringan akan menghitung loss antara gambar berisik yang dikeluarkan oleh decoder dan ground truth (gambar tanpa noise) dan juga akan mencoba meminimalkan loss atau perbedaan antara gambar yang direkonstruksi dan gambar asli tanpa noise. Dengan kata lain, jaringan akan mempelajari ruang 7 x 7 x 128 yang akan berupa encoding bebas noise dari data yang Anda latih pada jaringan Anda!
Sekarang, untuk melihat bagaimana ini bekerja di Python, Anda akan menggunakan dataset NotMNIST yang sama seperti pada bagian pertama tutorial ini. Itu berarti Anda tidak perlu melakukan prapemrosesan data apa pun karena sudah dilakukan sebelumnya! Namun, satu langkah prapemrosesan penting pada bagian tutorial ini adalah menambahkan noise ke gambar pelatihan, validasi, dan pengujian. Jadi, mari cepat lakukan itu terlebih dahulu!
Pertama-tama mari mendefinisikan noise factor yang merupakan hiperparameter. Noise factor dikalikan dengan matriks acak yang memiliki mean 0,0 dan standar deviasi 1,0. Matriks ini akan mengambil sampel dari distribusi normal (Gaussian). Bentuk array normal acak akan serupa dengan bentuk data yang akan Anda tambahkan noise.
Untuk kesederhanaan, mari pahami dengan contoh: Variabel train_X memiliki bentuk 48000 x 28 x 28 x 1. Maka, array normal acak juga akan memiliki bentuk yang serupa dengan train_X, hanya dengan begitu Anda dapat menambahkan dua array karena dimensinya sama.
noise_factor = 0.5
x_train_noisy = train_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=train_X.shape)
x_valid_noisy = valid_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=valid_X.shape)
x_test_noisy = test_data + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=test_data.shape)
x_train_noisy = np.clip(x_train_noisy, 0., 1.)
x_valid_noisy = np.clip(x_valid_noisy, 0., 1.)
x_test_noisy = np.clip(x_test_noisy, 0., 1.)
np.clip() akan membatasi semua nilai negatif menjadi nol dan semua nilai yang lebih besar dari satu menjadi satu. Karena, Anda menginginkan nilai piksel antara nol dan satu. Dan ada kemungkinan setelah memasukkan noise ke data rentang nilai piksel dapat sedikit berubah, jadi demi keamanan praktik yang baik adalah melakukan clip pada nilai piksel.
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(x_train_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(x_test_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7f3ec6b20e48>
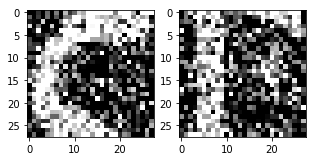
Sekarang setelah Anda memiliki data berisik, Anda dapat memasukkannya ke jaringan dan melihat bagaimana noise tersebut "secara ajaib" dihapus dari gambar!
Seperti yang dibahas sebelumnya autoencoder dibagi menjadi dua bagian: encoder dan decoder. Arsitektur yang akan Anda susun akan tampak sebagai berikut:
Encoder
Decoder
batch_size = 128
epochs = 20
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
def autoencoder(input_img):
    #encoder
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    up1 = UpSampling2D((2,2))(conv4)
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1)
    up2 = UpSampling2D((2,2))(conv5)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2)
    return decoded
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Jika Anda ingat saat melatih convolutional autoencoder, Anda memasukkan gambar pelatihan dua kali karena masukan dan ground truth sama. Namun, pada denoising autoencoder, Anda memasukkan gambar berisik sebagai masukan sementara ground truth tetap gambar tanpa noise yang sebelumnya Anda tambahkan noise. Hanya dengan begitu jaringan dapat menghitung loss antara gambar berisik dan gambar tanpa noise yang benar.
autoencoder_train = autoencoder.fit(x_train_noisy, train_X, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(x_valid_noisy, valid_X))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 15s - loss: 0.0531 - val_loss: 0.0268
Epoch 2/20
48000/48000 [==============================] - 14s - loss: 0.0243 - val_loss: 0.0217
Epoch 3/20
48000/48000 [==============================] - 14s - loss: 0.0207 - val_loss: 0.0200
Epoch 4/20
48000/48000 [==============================] - 14s - loss: 0.0190 - val_loss: 0.0184
Epoch 5/20
48000/48000 [==============================] - 14s - loss: 0.0179 - val_loss: 0.0183
Epoch 6/20
48000/48000 [==============================] - 14s - loss: 0.0171 - val_loss: 0.0178
Epoch 7/20
48000/48000 [==============================] - 14s - loss: 0.0165 - val_loss: 0.0161
Epoch 8/20
48000/48000 [==============================] - 14s - loss: 0.0160 - val_loss: 0.0166
Epoch 9/20
48000/48000 [==============================] - 14s - loss: 0.0157 - val_loss: 0.0157
Epoch 10/20
48000/48000 [==============================] - 14s - loss: 0.0153 - val_loss: 0.0159
Epoch 11/20
48000/48000 [==============================] - 14s - loss: 0.0151 - val_loss: 0.0153
Epoch 12/20
48000/48000 [==============================] - 14s - loss: 0.0148 - val_loss: 0.0154
Epoch 13/20
48000/48000 [==============================] - 14s - loss: 0.0146 - val_loss: 0.0151
Epoch 14/20
48000/48000 [==============================] - 14s - loss: 0.0145 - val_loss: 0.0152
Epoch 15/20
48000/48000 [==============================] - 14s - loss: 0.0143 - val_loss: 0.0163
Epoch 16/20
48000/48000 [==============================] - 14s - loss: 0.0141 - val_loss: 0.0152
Epoch 17/20
48000/48000 [==============================] - 14s - loss: 0.0140 - val_loss: 0.0149
Epoch 18/20
48000/48000 [==============================] - 14s - loss: 0.0139 - val_loss: 0.0153
Epoch 19/20
48000/48000 [==============================] - 14s - loss: 0.0138 - val_loss: 0.0152
Epoch 20/20
48000/48000 [==============================] - 14s - loss: 0.0137 - val_loss: 0.0150
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
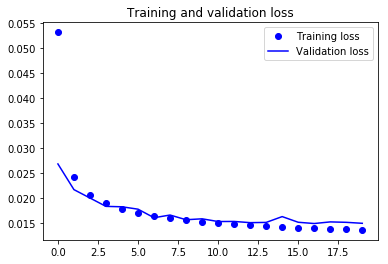
Dari plot di atas, Anda dapat menarik intuisi bahwa model overfitting pada beberapa epoch sementara selaras pada sebagian besar waktu. Anda tentu dapat mencoba meningkatkan kinerja model dengan menambahkan kompleksitas agar loss dapat berkurang lebih jauh, coba latih lebih banyak epoch lalu tentukan.
pred = autoencoder.predict(x_test_noisy)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Test Images with Noise")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(x_test_noisy[i, ..., 0], cmap='gray')
plt.show()

plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
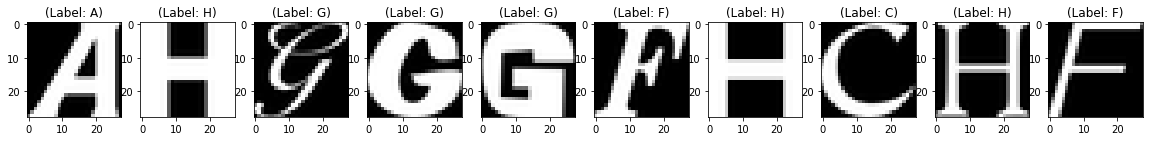
Test Images with Noise
Reconstruction of Noisy Test Images
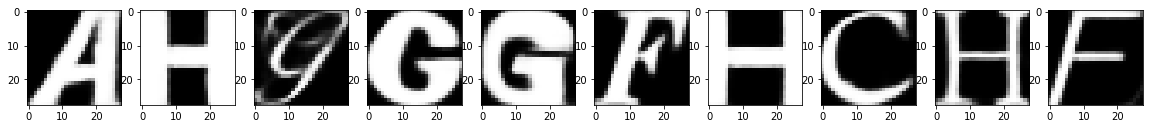
Tampaknya, hanya dalam 20 epoch, arsitektur jaringan yang cukup sederhana berhasil melakukan pekerjaan yang cukup baik dalam menghapus noise dari gambar uji, bukan?
Tutorial ini merupakan awal yang baik untuk memahami autoencoder baik secara teoretis maupun praktis. Jika Anda dapat mengikutinya dengan mudah atau dengan sedikit usaha lebih, bagus! Lihat Keras Tutorial: Deep Learning in Python dari DataCamp dan kursus Introduction to Deep Learning in Python.
Pada tutorial berikutnya, Anda akan mempelajari cara membaca gambar dari awal, menganalisis, melakukan prapemrosesan, dan memasukkannya ke dalam model menggunakan dataset sidik jari. Anda juga akan belajar cara membaca gambar medis modalitas T-1 dan merekonstruksinya menggunakan autoencoder!
Masih banyak yang harus dibahas, jadi mengapa tidak mengikuti kursus Deep Learning in Python dari DataCamp? Jika Anda belum melakukannya. Anda akan belajar dari dasar dan perlahan bergerak menuju penguasaan bidang deep learning, ini pasti akan menjadi sumber yang sangat berharga saat Anda belajar bekerja dengan convolutional neural networks di Python, cara mendeteksi wajah, objek, dan lain-lain.
Pelajari lebih lanjut tentang Python dan Keras
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt




