
Last chance! 50% off DataCamp Premium
Sale ends in
Genel olarak, otokodlayıcıları denetimsiz bir öğrenme tekniği olarak düşünebilirsiniz; çünkü modeli eğitmek için açık etiketlere ihtiyacınız yoktur. Bir otokodlayıcıyı eğitmek için gereken tek şey ham girdi verileridir.
Bu eğitimde, derin öğrenmede otokodlayıcıları öğrenecek ve Python ile Keras kullanarak bir evrişimli ve bir gürültü giderici otokodlayıcı uygulayacaksınız. Örnek olarak NotMNIST alfabe veri kümesiyle çalışacaksınız.
Özetle, bugünkü eğitimde şu konuları ele alacaksınız:
Girişte okuduğunuz gibi, bir otokodlayıcı, bir görüntüyü girdi olarak alan ve bunu, dar boğaz olarak da bilinen gizli uzaydan daha az bit kullanarak yeniden oluşturmaya çalışan denetimsiz bir makine öğrenmesi algoritmasıdır. Görüntü, dar boğazda büyük ölçüde sıkıştırılır. Otokodlayıcılarda sıkıştırma, ağ bir süre eğitilerek ve öğrendikçe girdi görüntüsünü dar boğazda en iyi şekilde temsil etmeye çalışarak elde edilir. JPEG ve JPEG kayıpsız sıkıştırma gibi genel görüntü sıkıştırma algoritmaları, herhangi bir eğitim gerektirmeden görüntüleri sıkıştırır ve bu işte oldukça başarılıdır.
Otokodlayıcılar, Temel Bileşen Analizi (PCA) gibi boyut indirgeme tekniklerine benzer. Verileri daha yüksek boyuttan daha düşük boyuta doğrusal dönüşümle yansıtır ve önemsiz kısımları çıkarırken önemli özellikleri korumaya çalışırlar.
Ancak, otokodlayıcılar ile PCA arasındaki temel fark dönüşüm kısmında yatar: zaten okuduğunuz gibi, PCA doğrusal dönüşüm kullanırken otokodlayıcılar doğrusal olmayan dönüşümler kullanır.
Artık otokodlayıcılar hakkında biraz fikir sahibi olduğunuza göre, gelin şimdi bu terimi parçalara ayıralım ve biraz sezgi kazanmaya çalışalım!
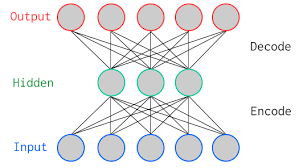
Yukarıdaki şekil, tek gizli katmanlı iki katmanlı basit bir otokodlayıcıyı göstermektedir. Derin öğrenme terminolojisinde, bir mimarideki toplam katman sayısı sayılırken girdi katmanının genellikle hesaba katılmadığını sık sık görürsünüz. Bir mimarideki toplam katman sayısı yalnızca gizli katmanların sayısı ve çıktı katmanından oluşur.
Yukarıdaki görselde gösterildiği gibi, girdi ve çıktı katmanları aynı sayıda nörona sahiptir.
Bir örnek verelim. Otokodlayıcıya yalnızca beş piksellik bir görüntü veriyorsunuz; kodlayıcı bunu dar boğazda (orta katman) ya da gizli uzayda üç piksellik değerlere sıkıştırıyor. Kod çözücü (decoder) bu üç değeri kullanarak, ağa girdi olarak verdiğiniz beş piksellik değerleri ya da girdi görüntüsünü yeniden oluşturmaya çalışır.
Gerçekte, girdi ile çıktı arasında daha fazla sayıda gizli katman vardır.
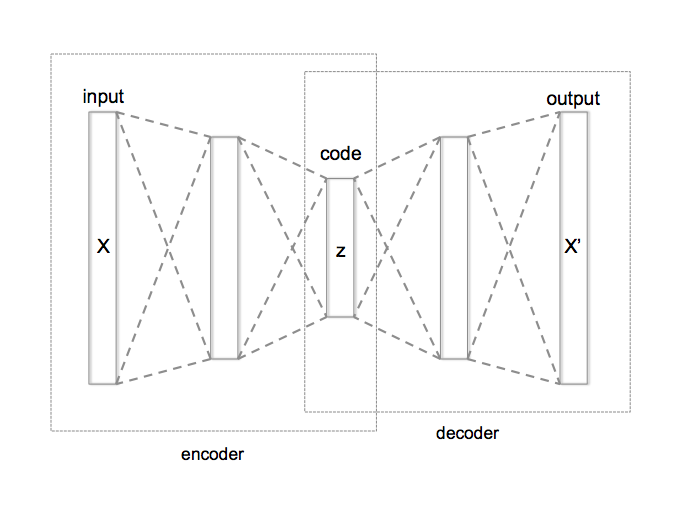
Otokodlayıcı üç parçaya ayrılabilir
Evrişimli otokodlayıcı, gürültü giderici otokodlayıcı, varyasyonel otokodlayıcı ve seyrek otokodlayıcı gibi çeşitli otokodlayıcı türleri vardır. Ancak girişte okuduğunuz gibi, bu eğitimde yalnızca evrişimli ve gürültü giderici olanlara odaklanacaksınız.Python ve Keras ile Evrişimli Otokodlayıcılar
Girdi verileriniz görüntülerden oluştuğu için, evrişimli bir otokodlayıcı kullanmak iyi bir fikir olacaktır. Bu bir otokodlayıcı varyantı değil, daha çok evrişim katmanlarıyla yığılmış geleneksel bir otokodlayıcıdır: esasen tam bağlantılı katmanları evrişim katmanlarıyla değiştirirsiniz. Maksimum havuzlama (max-pooling) katmanlarıyla birlikte evrişim katmanları, girdiyi geniş (28 x 28 görüntü) ve ince (tek kanal ya da gri ton) bir biçimden küçük (gizli uzayda 7 x 7 görüntü) ve kalın (128 kanal) bir biçime dönüştürür.
Yukarıdaki fikri tam olarak anlamadıysanız endişelenmeyin! Bu eğitimin ikinci kısmında, yukarıdakilerin uygulanmasına odaklanacağınız için varsa tüm soru işaretlerinizin giderilmesi umulur.
İpucu: Evrişimli sinir ağları hakkında daha fazla bilgi almak istiyorsanız, bu eğitime göz atın.
Bu, ağın görüntülerden görsel özellikler çıkarmasına ve dolayısıyla daha doğru bir gizli uzay temsili elde etmesine yardımcı olur. Yeniden oluşturma süreci, kod çözücü olarak bilinen yukarı örnekleme ve evrişimleri kullanır. Aşağı örnekleme ise görüntünün düşük boyuta sıkıştırıldığı ve kodlayıcı olarak da bilinen süreçtir.
Şunu not etmek önemlidir: Kodlayıcı esas olarak girdi görüntüsünü sıkıştırır; örneğin, girdi görüntünüzün boyutu 176 x 176 x 1 (~30976) ise, maksimum sıkıştırma noktası 22 x 22 x 512 (~247808) boyutunda olabilir. Yani bu durumda, 176 x 176 boyutunda gri tonlu bir görüntüyle başladınız ve bunu birkaç evrişim katmanından ve tam olarak üç maksimum havuzlama katmanından geçirerek görüntünüzü nihayetinde 22 x 22 boyutuna aşağı örneklediniz; ancak kanal sayısı 1’den 512’ye yükseldi. Yukarıda belirtildiği gibi, geniş (176 x 176) ve ince (1) olan girdiniz küçük (22x22) ve kalın (512) hale geldi.
notMNIST veri kümesi, A’dan J’ye harfler için yazı tipi gliflerinden oluşan bir görüntü tanıma veri kümesidir. Klasik MNIST veri kümesine oldukça benzer; MNIST, 0’dan 9’a el yazısı rakamların görüntülerini içerir: bu durumda, NotMNIST veri kümesinin A - J harflerinden toplam 10 kategoride 70.000 adet 28x28 gri tonlu görüntü ve kategori başına 6.000 görüntü içerdiğini göreceksiniz.
İpucu: MNIST veri kümesiyle sınıflandırma görevleri için Çok Katmanlı Algılayıcı (MLP) uygulamayı öğrenmek istiyorsanız, bu eğitime göz atın.
NotMNIST veri kümesi Keras ya da TensorFlow çerçevesinde ön tanımlı değildir; bu yüzden verileri bu kaynaktan indirmeniz gerekir. Veriler ubyte.gzip formatında indirilecektir, fakat bunun hakkında şimdilik endişelenmeyin! Az sonra bayt akışı formatlarını nasıl okuyacağınızı ve bunları bir NumPy dizisine nasıl dönüştüreceğinizi öğreneceksiniz. Haydi başlayalım!
Ağ Nvidia Tesla K40 üzerinde eğitilecektir; dolayısıyla bir GPU üzerinde eğitim yapıyor ve Jupyter Notebook kullanıyorsanız, CUDA aygıt sırası ve CUDA görünür aygıtları os adlı modülü kullanarak belirttiğiniz üç satır daha eklemeniz gerekecek.
Aşağıdaki kodda, os.environ kullanarak not defterinde ortam değişkenleri ayarlıyorsunuz. Keras başlatılmadan önce bunu yapmak, Keras arka ucu TensorFlow’un ilk GPU’yu kullanmasını kısıtlamak için iyidir. Eğitimi yaptığınız makinede GPU 0 üzerinde ise, 1 yerine 0 kullandığınızdan emin olun. Bunu terminalinizde basit bir komut çalıştırarak kontrol edebilirsiniz: örneğin, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Sonra, numpy, matplotlib ve en önemlisi keras gibi gerekli tüm modülleri içe aktarırsınız; çünkü bugünkü eğitimde bu çerçeveyi kullanacaksınız!
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
Using TensorFlow backend.
Burada, gzip dosyasını açan, bytestream.read() kullanarak dosyayı okuyan bir işlev tanımlarsınız. Bu işlev, görüntü boyutunu ve toplam görüntü sayısını parametre olarak alır. Ardından np.frombuffer() kullanarak, buf değişkeninde saklanan dizeyi float32 türünde bir NumPy dizisine dönüştürürsünüz.
Sonrasında diziyi, birinci boyutu görüntü sayısı, ikinci ve üçüncü boyutları görüntünün boyutları olacak şekilde üç boyutlu bir diziye ya da tensöre yeniden şekillendirirsiniz. Son olarak data adlı NumPy dizisini döndürürsünüz.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Şimdi, extract_data() işlevini, eğitim ve test dosyalarını ve bunlara karşılık gelen görüntü sayısını geçirerek çağıracaksınız:
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
Benzer şekilde, bir etiket çıkarma işlevi tanımlarsınız; bu işlev gzip dosyasını açar, bytestream.read() kullanarak dosyayı okur; bu işlevde etiket boyutunu (1) ve toplam görüntü sayısını geçirirsiniz. Ardından np.frombuffer() kullanarak, buf değişkeninde saklanan dizeyi int64 türünde bir NumPy dizisine dönüştürürsünüz.
Bu kez, labels değişkeni 60.000 x 1 boyutunda bir sütun vektörü döndüreceği için diziyi yeniden şekillendirmenize gerek yoktur. Son olarak labels adlı NumPy dizisini döndürürsünüz.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Şimdi, eğitim ve test etiket dosyalarını ve bunlara karşılık gelen görüntü sayılarını geçirerek etiket çıkarma işlevini çağıracaksınız:
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Eğitim ve test verilerini yükledikten sonra, bugün birlikte çalışacağınız veri kümesi hakkında biraz sezgi edinmek için verileri analiz etmeye hazırsınız!
Şimdi, veri kümesindeki görüntülerin nasıl göründüğünü inceleyelim ve ayrıca NumPy dizi özniteliği .shape yardımıyla görüntülerin boyutuna bakalım:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Yukarıdaki çıktıya göre, eğitim verilerinin şekli 60000 x 28 x 28’dir; çünkü 28 x 28 boyutlu matrislerden oluşan 60.000 eğitim örneği vardır. Benzer şekilde, test verilerinin şekli 10000 x 28 x 28’dir; çünkü 10.000 test örneği vardır.
Not: Bu görevde, eğitim ve test etiketlerini kullanmayacaksınız. Ele alınan görev yalnızca eğitim ve test görüntüleriyle ilgilidir. Ancak veriye dair daha iyi bir sezgi edinebileceğiniz keşif amaçları için etiketleri kullanacaksınız.
Karşılık gelen kategorik sınıf etiketleriyle sınıf adlarını içeren bir sözlük oluşturalım:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Şimdi, veri kümenizdeki birkaç görüntüye göz atalım:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[0], (28,28))
curr_lbl = train_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[0], (28,28))
curr_lbl = test_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
<matplotlib.text.Text at 0x7f3ec73db240>
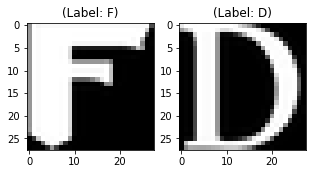
Yukarıdaki iki grafiğin çıktısı, hem eğitim hem de test verilerinden birer örnek görüntüdür ve bu görüntülere 5 ya da F ile, diğer yandan 3 ya da D sınıf etiketi atanmıştır. Benzer şekilde, diğer harflerin farklı etiketleri olur, fakat aynı harfler aynı etiketlere sahip olur. Bu, tüm 6.000 F sınıfı görüntüsünün 5 etiketine sahip olacağı anlamına gelir.
Veri kümesindeki görüntüler gerçekten de 28 x 28 boyutunda ve piksel değerleri 0 ile 255 arasında değişen gri tonlu görüntülerdir; bu yüzden verileri modele beslemeden önce ön işleme çok önemlidir. Önce, eğitim ve test kümesindeki her 28 x 28 görüntüyü, ağa besleyebileceğiniz 28 x 28 x 1 boyutunda bir matrise dönüştüreceksiniz:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Sonra, eğitim ve test NumPy dizilerinin veri türünü kontrol ettiğinizden emin olmak istersiniz; float32 formatında olmalıdır, değilse bu formata dönüştürmeniz gerekir; ancak verileri okurken zaten dönüştürdüğünüz için bunu tekrar yapmanıza gerek yok. Ayrıca piksel değerlerini 0 - 1 aralığına yeniden ölçeklemeniz gerekir. Haydi bunu yapalım!
Eğitim ve test veri türlerini doğrulamayı unutmayın:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Sonra, eğitim ve test verilerini, eğitim ve test verilerinin maksimum piksel değeriyle yeniden ölçekleyin:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Yeniden ölçeklemeden sonra eğitim ve test verilerinin maksimum değerini doğrulayalım; 1.0 olmalıdır!
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Tüm bunlardan sonra, verileri bölmek önemlidir. Modelinizin iyi genelleme yapabilmesi için eğitim verilerini ikiye ayırırsınız: bir eğitim ve bir doğrulama kümesi. Modelinizi verilerin %80’i üzerinde eğitecek ve kalan eğitim verilerinin %20’si üzerinde doğrulayacaksınız.
Bu aynı zamanda aşırı uyum (overfitting) olasılığını azaltmanıza da yardımcı olur; çünkü modeli, eğitim aşamasında görmediği veriler üzerinde doğrulayacaksınız.
Verileri düzgün bir şekilde bölmek için scikit-learn’ün train_test_split modülünü kullanabilirsiniz:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Not: Bu görev için, eğitim ve test etiketlerine ihtiyacınız yoktur. Bu nedenle eğitim görüntülerini iki kez geçireceksiniz. Eğitim görüntüleriniz hem girdi hem de sınıflandırma görevindeki etiketlere benzer şekilde yer gerçekliği (ground truth) olarak davranacaktır.
Artık ağı tanımlamaya ve verileri ağa beslemeye hazırsınız. O halde daha fazla vakit kaybetmeden bir sonraki adıma geçelim!
Görüntüler 28 x 28 x 1 boyutunda ya da 784 boyutlu bir vektördür. Görüntü matrisini bir diziye dönüştürür, 0 ile 1 arasına yeniden ölçekler, 28 x 28 x 1 boyutuna getirir ve bunu ağa girdi olarak verirsiniz.
Ayrıca, 128’lik bir yığın boyutu (batch size) kullanacaksınız; 256 ya da 512 gibi daha yüksek bir yığın boyutu kullanmak da tercih edilebilir; tamamen modeli eğittiğiniz sisteme bağlıdır. Bu, öğrenme parametrelerinin belirlenmesinde önemli rol oynar ve tahmin doğruluğunu etkiler. Ağı 50 dönem (epoch) boyunca eğiteceksiniz.
batch_size = 128
epochs = 50
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
Daha önce tartışıldığı gibi, otokodlayıcı iki parçaya ayrılır: bir kodlayıcı ve bir kod çözücü vardır.
Kodlayıcı
Kod çözücü
Maksimum havuzlama katmanı her kullanımınızda girdiyi iki kat aşağı örneklerken, yukarı örnekleme katmanı da her kullanımda girdiyi iki kat yukarı örnekler.
Not: Filtre sayısı, filtre boyutu, katman sayısı, modeli eğittiğiniz dönem sayısı gibi tümü hiperparametrelerdir ve kendi sezginize göre belirlenmelidir; bu hiperparametrelerle oynayıp yeni deneyler yapmaya ve modelinizin performansını ölçmeye açıksınız. Derin öğrenme sanatını yavaş yavaş böyle öğreneceksiniz!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Model oluşturulduktan sonra, RMSProp eniyileyicisini (optimizer) kullanarak derlemeniz gerekir.
İpucu: RMSProp hakkında daha fazla bilgi almak isterseniz Andrew Ng’nin bu eğitimini izleyin.
Ayrıca loss bağımsız değişkeniyle kayıp türünü de belirtmeniz gerektiğini unutmayın. Bu durumda, ortalama kare hata (MSE) kullanılacaktır; çünkü her yığın sonrasında kayıp, tahmin edilen çıktı yığını ile yer gerçekliği (ground truth) arasındaki piksel bazlı ortalama kare hata ile hesaplanacaktır:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Yukarıdaki adımda oluşturduğunuz katmanları özet işlevini kullanarak görselleştirelim; bu, her katmandaki parametre (ağırlık ve önyargılar) sayısını ve ayrıca modelinizdeki toplam parametre sayısını gösterecektir.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_6 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
max_pooling2d_9 (MaxPooling2 (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
max_pooling2d_10 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
up_sampling2d_9 (UpSampling2 (None, 14, 14, 128)       0
_________________________________________________________________
conv2d_29 (Conv2D)           (None, 14, 14, 64)        73792
_________________________________________________________________
up_sampling2d_10 (UpSampling (None, 28, 28, 64)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
Artık Keras’ın fit() işleviyle modeli eğitme zamanı! Model 50 dönem boyunca eğitilir. fit() işlevi bir geçmiş (history) nesnesi döndürür; Bu işlevin sonucunu fashion_train’e kaydederek, daha sonra eğitim ve doğrulama arasındaki kayıp fonksiyonu grafiğini çizmek ve modelinizin performansını görsel olarak analiz etmek için kullanabilirsiniz.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/50
48000/48000 [==============================] - 16s - loss: 0.0368 - val_loss: 0.0132
Epoch 2/50
48000/48000 [==============================] - 15s - loss: 0.0101 - val_loss: 0.0085
Epoch 3/50
48000/48000 [==============================] - 15s - loss: 0.0071 - val_loss: 0.0081
Epoch 4/50
48000/48000 [==============================] - 15s - loss: 0.0057 - val_loss: 0.0056
Epoch 5/50
48000/48000 [==============================] - 15s - loss: 0.0048 - val_loss: 0.0051
Epoch 6/50
48000/48000 [==============================] - 15s - loss: 0.0043 - val_loss: 0.0039
Epoch 7/50
48000/48000 [==============================] - 15s - loss: 0.0038 - val_loss: 0.0039
Epoch 8/50
48000/48000 [==============================] - 15s - loss: 0.0035 - val_loss: 0.0039
Epoch 9/50
48000/48000 [==============================] - 15s - loss: 0.0032 - val_loss: 0.0030
Epoch 10/50
48000/48000 [==============================] - 15s - loss: 0.0030 - val_loss: 0.0029
Epoch 11/50
48000/48000 [==============================] - 15s - loss: 0.0029 - val_loss: 0.0026
Epoch 12/50
48000/48000 [==============================] - 15s - loss: 0.0027 - val_loss: 0.0025
Epoch 13/50
48000/48000 [==============================] - 15s - loss: 0.0026 - val_loss: 0.0028
Epoch 14/50
48000/48000 [==============================] - 15s - loss: 0.0025 - val_loss: 0.0022
Epoch 15/50
48000/48000 [==============================] - 15s - loss: 0.0024 - val_loss: 0.0024
Epoch 16/50
48000/48000 [==============================] - 16s - loss: 0.0023 - val_loss: 0.0027
Epoch 17/50
48000/48000 [==============================] - 15s - loss: 0.0023 - val_loss: 0.0022
Epoch 18/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0025
Epoch 19/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0022
Epoch 20/50
48000/48000 [==============================] - 15s - loss: 0.0021 - val_loss: 0.0022
Epoch 21/50
48000/48000 [==============================] - 16s - loss: 0.0021 - val_loss: 0.0020
Epoch 22/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0019
Epoch 23/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0021
Epoch 24/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0018
Epoch 25/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 26/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 27/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0017
Epoch 28/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0018
Epoch 29/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 30/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0017
Epoch 31/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 32/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0018
Epoch 33/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0017
Epoch 34/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0018
Epoch 35/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0019
Epoch 36/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0016
Epoch 37/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0017
Epoch 38/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0019
Epoch 39/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 40/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 41/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 42/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 43/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0018
Epoch 44/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 45/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 46/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 47/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0017
Epoch 48/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0015
Epoch 49/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 50/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0020
Nihayet! Not-MNIST üzerinde modeli 50 dönem eğittiniz. Şimdi, model performansını görselleştirmek için eğitim ve doğrulama verileri arasındaki kayıp grafiğini çizelim.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
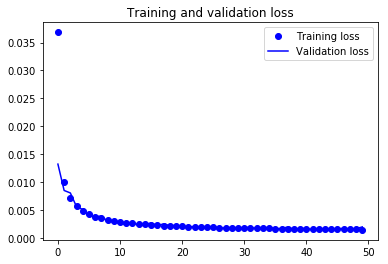
Son olarak, doğrulama kaybı ile eğitim kaybının birbiriyle uyumlu olduğunu görebilirsiniz. Bu, modelinizin aşırı uyum göstermediğini belirtir: doğrulama kaybı azalıyor ve artmıyor, ayrıca eğitim ve doğrulama kayıpları arasında nadiren bir boşluk var.
Dolayısıyla, modelinizin genelleme yeteneğinin iyi olduğunu söyleyebilirsiniz.
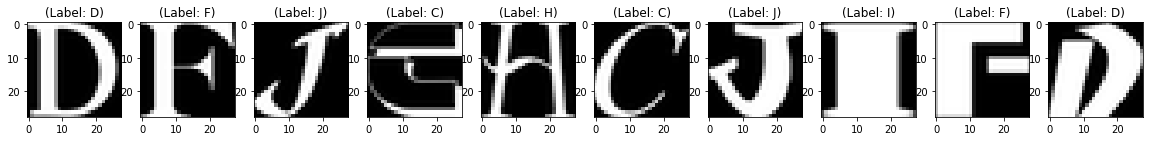
Sonunda, Keras’ın predict() işlevini kullanarak test görüntülerini yeniden oluşturma zamanı ve modelinizin test verilerinde ne kadar iyi yeniden oluşturma yapabildiğini görme vakti.
Eğitilmiş modeli 10.000 test görüntüsünün tamamı üzerinde tahmin için kullanacak ve modelinizin test görüntülerini ne kadar iyi yeniden oluşturabildiğini görselleştirmek için birkaç yeniden oluşturulmuş görüntüyü çizeceksiniz.
pred = autoencoder.predict(test_data)
pred.shape
(10000, 28, 28, 1)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
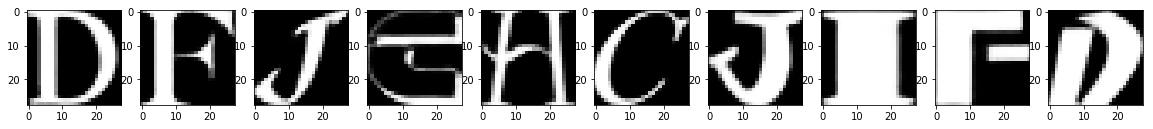
Yukarıdaki şekillerden, modelinizin test görüntülerini yeniden oluşturmada harika bir iş çıkardığını gözlemleyebilirsiniz. En azından görsel olarak, test ve yeniden oluşturulmuş görüntüler neredeyse tamamen benzer görünmektedir.
Gürültü giderici bir otokodlayıcı, gürültüye dayanıklı bir temsili (gizli uzay ya da dar boğaz) öğrenmeye çalışır. Bir görüntüye gürültü eklersiniz ve ardından gürültülü görüntüyü ağınızın kodlayıcı kısmına girdi olarak verirsiniz. Otokodlayıcının kodlayıcı kısmı, görüntüyü harfleri korumaya çalışırken gürültüyü gideren farklı bir uzaya dönüştürür.
Peki, gürültüyü tam olarak nasıl giderir?
Eğitim sırasında, evrişimli otokodlayıcıda daha önce tanımladığınıza benzer şekilde, kök ortalama kare hatası türünde bir kayıp fonksiyonu belirlersiniz. Eğitimin her yinelemesinde, ağ, kod çözücünün ürettiği gürültülü görüntü ile yer gerçekliği (gürültüsüz görüntü) arasında bir kayıp hesaplayacak ve ayrıca yeniden oluşturulan görüntü ile orijinal gürültüsüz görüntü arasındaki bu kaybı ya da farkı en aza indirmeye çalışacaktır. Başka bir deyişle, ağ, ağınızı eğiteceğiniz verilerin gürültüsüz kodlamaları olacak 7 x 7 x 128 boyutunda bir uzayı öğrenecektir!
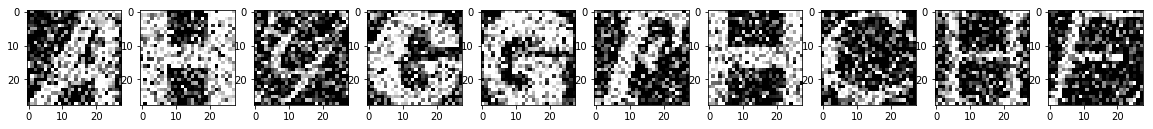
Şimdi, bunun Python’da nasıl çalıştığını görmek için, bu eğitimin ilk kısmında olduğu gibi yine NotMNIST veri kümesini kullanacaksınız. Bu, herhangi bir veri ön işlemeye gerek olmadığı anlamına gelir; çünkü daha önce yapılmıştı! Ancak bu kısmın önemli bir ön işleme adımı, eğitim, doğrulama ve test görüntülerine gürültü eklemek olacaktır. O halde bunu hızlıca yapalım!
Önce bir gürültü katsayısı tanımlayalım; bu bir hiperparametredir. Gürültü katsayısı, ortalaması 0,0 ve standart sapması 1,0 olan rastgele bir matrisle çarpılır. Bu matris, normal (Gauss) dağılımdan örnekler çekecektir. Rastgele normal dizinin şekli, gürültü ekleyeceğiniz verilerin şekline benzer olacaktır.
Basitlik açısından bir örnekle anlayalım: train_X değişkeni 48000 x 28 x 28 x 1 şekline sahiptir. Dolayısıyla, rastgele normal dizi de train_X’e benzer bir şekle sahip olacaktır; ancak o zaman iki diziyi toplayabilirsiniz; çünkü boyutları aynı olacaktır.
noise_factor = 0.5
x_train_noisy = train_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=train_X.shape)
x_valid_noisy = valid_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=valid_X.shape)
x_test_noisy = test_data + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=test_data.shape)
x_train_noisy = np.clip(x_train_noisy, 0., 1.)
x_valid_noisy = np.clip(x_valid_noisy, 0., 1.)
x_test_noisy = np.clip(x_test_noisy, 0., 1.)
np.clip(), tüm negatif değerleri sıfıra ve birden büyük tüm değerleri bire eşiklerecektir. Çünkü piksel değerlerinizin sıfır ile bir arasında olmasını istersiniz. Verilere gürültü ekledikten sonra piksel değer aralığının biraz değişme ihtimali olduğundan, güvenli tarafta kalmak için piksel değerlerini kırpmak iyi bir uygulamadır.
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(x_train_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(x_test_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7f3ec6b20e48>
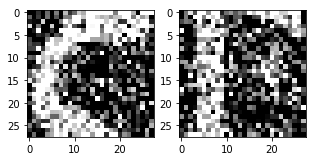
Artık gürültülü veriler elinizde olduğuna göre, bunları ağa besleyebilir ve gürültünün görüntülerden “sihirli” bir şekilde nasıl giderildiğini görebilirsiniz!
Daha önce tartışıldığı gibi otokodlayıcı iki parçaya ayrılır: kodlayıcı ve kod çözücü. Kuracağınız mimari aşağıdaki gibi görünecektir:
Kodlayıcı
Kod çözücü
batch_size = 128
epochs = 20
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
def autoencoder(input_img):
    #encoder
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    up1 = UpSampling2D((2,2))(conv4)
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1)
    up2 = UpSampling2D((2,2))(conv5)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2)
    return decoded
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Evrişimli otokodlayıcıyı eğitirken, girdileri iki kez beslediğinizi hatırlayın; çünkü girdi ve yer gerçekliği aynıydı. Ancak gürültü giderici otokodlayıcıda, girdi olarak gürültülü görüntüleri verirsiniz; yer gerçekliği ise gürültü uyguladığınız gürültüsüz görüntüler olarak kalır. Ancak bu şekilde ağ, gürültülü ve gerçek gürültüsüz görüntüler arasındaki kaybı hesaplayabilir.
autoencoder_train = autoencoder.fit(x_train_noisy, train_X, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(x_valid_noisy, valid_X))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 15s - loss: 0.0531 - val_loss: 0.0268
Epoch 2/20
48000/48000 [==============================] - 14s - loss: 0.0243 - val_loss: 0.0217
Epoch 3/20
48000/48000 [==============================] - 14s - loss: 0.0207 - val_loss: 0.0200
Epoch 4/20
48000/48000 [==============================] - 14s - loss: 0.0190 - val_loss: 0.0184
Epoch 5/20
48000/48000 [==============================] - 14s - loss: 0.0179 - val_loss: 0.0183
Epoch 6/20
48000/48000 [==============================] - 14s - loss: 0.0171 - val_loss: 0.0178
Epoch 7/20
48000/48000 [==============================] - 14s - loss: 0.0165 - val_loss: 0.0161
Epoch 8/20
48000/48000 [==============================] - 14s - loss: 0.0160 - val_loss: 0.0166
Epoch 9/20
48000/48000 [==============================] - 14s - loss: 0.0157 - val_loss: 0.0157
Epoch 10/20
48000/48000 [==============================] - 14s - loss: 0.0153 - val_loss: 0.0159
Epoch 11/20
48000/48000 [==============================] - 14s - loss: 0.0151 - val_loss: 0.0153
Epoch 12/20
48000/48000 [==============================] - 14s - loss: 0.0148 - val_loss: 0.0154
Epoch 13/20
48000/48000 [==============================] - 14s - loss: 0.0146 - val_loss: 0.0151
Epoch 14/20
48000/48000 [==============================] - 14s - loss: 0.0145 - val_loss: 0.0152
Epoch 15/20
48000/48000 [==============================] - 14s - loss: 0.0143 - val_loss: 0.0163
Epoch 16/20
48000/48000 [==============================] - 14s - loss: 0.0141 - val_loss: 0.0152
Epoch 17/20
48000/48000 [==============================] - 14s - loss: 0.0140 - val_loss: 0.0149
Epoch 18/20
48000/48000 [==============================] - 14s - loss: 0.0139 - val_loss: 0.0153
Epoch 19/20
48000/48000 [==============================] - 14s - loss: 0.0138 - val_loss: 0.0152
Epoch 20/20
48000/48000 [==============================] - 14s - loss: 0.0137 - val_loss: 0.0150
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
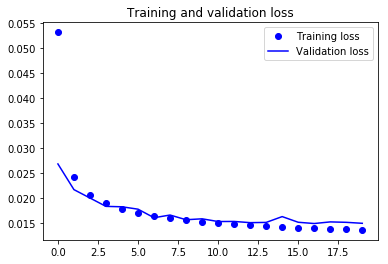
Yukarıdaki grafikten, modelin bazı dönemlerde aşırı uyum gösterirken çoğu zaman uyumlu kaldığına dair bir sezgi edinebilirsiniz. Kayıpların daha fazla azalabilmesi için modele biraz karmaşıklık katarak performansı iyileştirmeyi deneyebilir, daha fazla dönem eğitip sonra karar verebilirsiniz.
pred = autoencoder.predict(x_test_noisy)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Test Images with Noise")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(x_test_noisy[i, ..., 0], cmap='gray')
plt.show()

plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
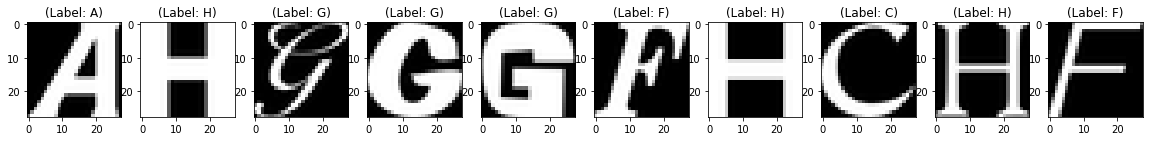
Test Images with Noise
Reconstruction of Noisy Test Images
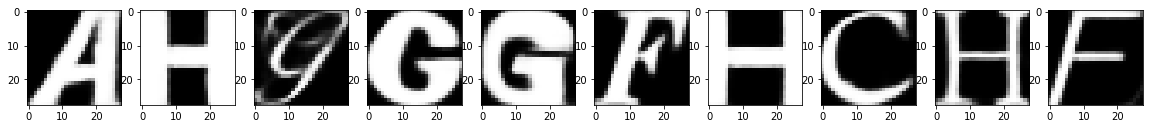
Görünüşe göre, yalnızca 20 dönem içinde, oldukça basit bir ağ mimarisi test görüntülerinden gürültüyü gidermede oldukça iyi bir iş çıkardı, öyle değil mi?
Bu eğitim, otokodlayıcıları hem kuramsal hem de pratik olarak anlamak için iyi bir başlangıçtı. Kolayca ya da biraz daha fazla çabayla takip edebildiyseniz, tebrikler! DataCamp’in Keras Eğitimi: Python’da Derin Öğrenme eğitimine ve Python ile Derin Öğrenmeye Giriş kursuna göz atın.
Bir sonraki eğitimde, görüntüleri sıfırdan nasıl okuyacağınızı, analiz edeceğinizi, ön işleyeceğinizi ve bir parmak izi veri kümesi kullanarak modele nasıl besleyeceğinizi öğreneceksiniz. Ayrıca T-1 modalitesindeki tıbbi görüntüleri nasıl okuyacağınızı ve bunları bir otokodlayıcı kullanarak nasıl yeniden oluşturacağınızı da öğreneceksiniz!
Hâlâ ele alınacak çok şey var; o halde neden DataCamp’in Python ile Derin Öğrenmeye Giriş kursunu almıyorsunuz? Henüz almadıysanız, temellerden başlayacak ve yavaş yavaş derin öğrenme alanında uzmanlaşmaya ilerleyeceksiniz; Python’da evrişimli sinir ağlarıyla çalışma, yüz, nesne vb. tespiti öğrenirken şüphesiz vazgeçilmez bir kaynak olacaktır.
Python ve Keras hakkında daha fazla bilgi edinin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




