कोर्स
Python में Deep Learning परिचय
4 घंटा
264.7K
आम तौर पर, आप ऑटोएन्कोडर्स को अनसुपरवाइज़्ड लर्निंग तकनीक मान सकते हैं, क्योंकि मॉडल को प्रशिक्षित करने के लिए आपको स्पष्ट लेबल्स की ज़रूरत नहीं होती। एक ऑटोएन्कोडर को ट्रेन करने के लिए केवल कच्चा इनपुट डेटा चाहिए।
इस ट्यूटोरियल में, आप डीप लर्निंग में ऑटोएन्कोडर्स के बारे में सीखेंगे और Python में Keras के साथ एक कॉन्वोल्यूशनल और एक डिनॉइज़िंग ऑटोएन्कोडर इम्प्लीमेंट करेंगे। उदाहरण के लिए आप NotMNIST अल्फ़ाबेट डेटासेट के साथ काम करेंगे।
संक्षेप में, आज के ट्यूटोरियल में आप निम्नलिखित विषयों पर काम करेंगे:
जैसा कि आपने परिचय में पढ़ा, ऑटोएन्कोडर एक अनसुपरवाइज़्ड मशीन लर्निंग एल्गोरिद्म है जो एक इमेज को इनपुट के रूप में लेता है और बॉटलनेक, जिसे लैटेंट स्पेस भी कहते हैं, से कम बिट्स का उपयोग कर उसे रिकंस्ट्रक्ट करने की कोशिश करता है। इमेज का बड़ा भाग बॉटलनेक पर कंप्रेस होता है। ऑटोएन्कोडर्स में कंप्रेशन नेटवर्क को कुछ समय तक ट्रेन करने से हासिल होता है और जैसे-जैसे यह सीखता है, यह बॉटलनेक पर इनपुट इमेज का सर्वश्रेष्ठ प्रतिनिधित्व खोजने की कोशिश करता है। सामान्य इमेज कंप्रेशन एल्गोरिद्म जैसे JPEG और JPEG lossless कंप्रेशन तकनीकें बिना किसी ट्रेनिंग के भी इमेज को काफ़ी अच्छी तरह कंप्रेस कर देती हैं।
ऑटोएन्कोडर्स, डायमेंशनलिटी रिडक्शन तकनीकों जैसे प्रिंसिपल कंपोनेंट एनालिसिस (PCA) से मिलते-जुलते हैं। वे डेटा को उच्च आयाम से कम आयाम में रैखिक रूपांतरण का उपयोग करते हुए प्रोजेक्ट करते हैं और गैर-जरूरी भागों को हटाते हुए डेटा की महत्वपूर्ण विशेषताओं को संरक्षित रखने की कोशिश करते हैं।
हालांकि, ऑटोएन्कोडर्स और PCA के बीच मुख्य अंतर रूपांतरण में है: जैसा कि आपने पढ़ा, PCA रैखिक रूपांतरण का उपयोग करता है, जबकि ऑटोएन्कोडर्स गैर-रैखिक रूपांतरणों का।
अब जब आपको ऑटोएन्कोडर्स के बारे में कुछ समझ हो गई है, तो आइए इस शब्द को तोड़कर इसके प्रति और सहजता से समझ विकसित करें!
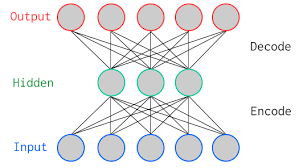
ऊपर दी गई आकृति एक टू-लेयर वनीला ऑटोएन्कोडर है जिसमें एक हिडन लेयर है। डीप लर्निंग में अक्सर आप देखेंगे कि आर्किटेक्चर में कुल लेयर्स गिनते समय इनपुट लेयर को शामिल नहीं किया जाता। किसी आर्किटेक्चर की कुल लेयर्स में केवल हिडन लेयर्स और आउटपुट लेयर शामिल होते हैं।
जैसा कि ऊपर की इमेज में दिखाया गया है, इनपुट और आउटपुट लेयर्स में न्यूरॉन्स की संख्या समान होती है।
एक उदाहरण लेते हैं। आप पाँच पिक्सेल वैल्यू वाली इमेज को ऑटोएन्कोडर में फीड करते हैं जिसे एन्कोडर बॉटलनेक (मिडल लेयर) या लैटेंट स्पेस पर तीन पिक्सेल वैल्यू में कंप्रेस करता है। इन तीन वैल्यू का उपयोग करते हुए, डिकोडर पाँच पिक्सेल वैल्यू या वह इनपुट इमेज जिसे आपने नेटवर्क में फीड किया था, को रिकंस्ट्रक्ट करने की कोशिश करता है।
वास्तविकता में, इनपुट और आउटपुट के बीच अधिक हिडन लेयर्स होते हैं।
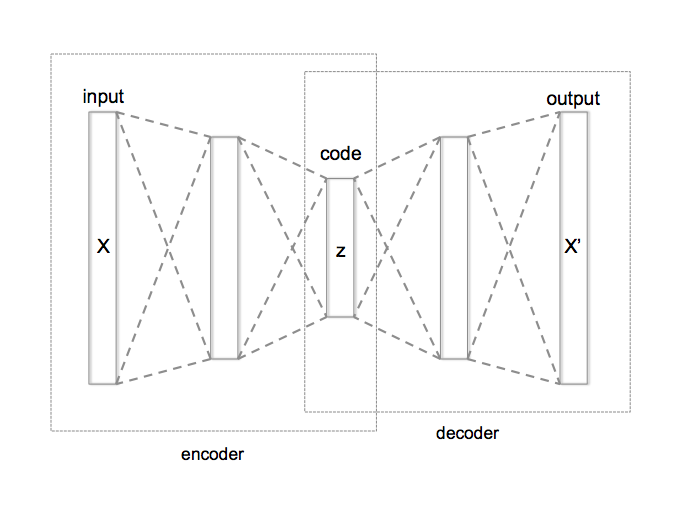
ऑटोएन्कोडर को तीन भागों में तोड़ा जा सकता है
ऑटोएन्कोडर्स की कई वैरायटीज़ होती हैं, जैसे कॉन्वोल्यूशनल ऑटोएन्कोडर, डिनॉइज़िंग ऑटोएन्कोडर, वेरिएशनल ऑटोएन्कोडर और स्पार्स ऑटोएन्कोडर। हालांकि, जैसा कि आपने परिचय में पढ़ा, इस ट्यूटोरियल में आप केवल कॉन्वोल्यूशनल और डिनॉइज़िंग पर फोकस करेंगे।Python में Keras के साथ कॉन्वोल्यूशनल ऑटोएन्कोडर्स
चूंकि आपका इनपुट डेटा इमेज का है, इसलिए कॉन्वोल्यूशनल ऑटोएन्कोडर का उपयोग करना एक अच््छा विचार है। यह कोई अलग ऑटोएन्कोडर वैरिएंट नहीं है, बल्कि कॉन्वोल्यूशनल लेयर्स के साथ स्टैक किया गया पारंपरिक ऑटोएन्कोडर है: आप मूल रूप से फुली-कनेक्टेड लेयर्स को कॉन्वोल्यूशनल लेयर्स से बदलते हैं। कॉन्वोल्यूशनल लेयर्स के साथ मैक्स-पूलिंग लेयर्स इनपुट को चौड़ा (28 x 28 इमेज) और पतला (एकल चैनल या ग्रेस्केल) से छोटा (लैटेंट स्पेस पर 7 x 7 इमेज) और मोटा (128 चैनल) बना देती हैं।
यदि ऊपर का विचार आपको पूरी तरह समझ न आया हो तो चिंता न करें! इस ट्यूटोरियल के दूसरे हिस्से में, जिसमें आप इसकी इम्प्लीमेंटेशन पर फोकस करेंगे, आपकी सारी शंकाएँ (यदि कोई हैं) स्पष्ट हो जाएंगी।
टिप: यदि आप कॉन्वोल्यूशनल न्यूरल नेटवर्क्स के बारे में और जानना चाहते हैं, तो यह ट्यूटोरियल देखें।
यह नेटवर्क को इमेज से विज़ुअल फीचर्स निकालने में मदद करता है और इस प्रकार अधिक सटीक लैटेंट स्पेस प्रतिनिधित्व प्राप्त होता है। रिकंस्ट्रक्शन प्रक्रिया में अपसैंपलिंग और कॉन्वोल्यूशंस का उपयोग होता है जिसे डिकोडर कहा जाता है। डाउनसैंपलिंग वह प्रक्रिया है जिसमें इमेज कम आयाम में कंप्रेस होती है जिसे एन्कोडर भी कहते हैं।
यह नोट करना महत्वपूर्ण है कि एन्कोडर मुख्य रूप से इनपुट इमेज को कंप्रेस करता है, उदाहरण के लिए: यदि आपकी इनपुट इमेज का आयाम 176 x 176 x 1 (~30976) है, तो अधिकतम कंप्रेशन बिंदु का आयाम 22 x 22 x 512 (~247808) हो सकता है। तो, इस केस में, आपने 176 x 176 आयाम की ग्रेस्केल इमेज से शुरुआत की और कुछ कॉन्वोल्यूशनल लेयर्स और ठीक तीन मैक्स-पूलिंग लेयर्स से गुजारकर आपकी इमेज अंततः 22 x 22 के आयाम तक डाउनसैंपल हो गई, लेकिन चैनल्स की संख्या 1 से बढ़कर 512 हो गई। जैसा कि ऊपर बताया गया, आपका इनपुट चौड़ा (176 x 176) और पतला (1) से छोटा (22x22) और मोटा (512) हो गया।
notMNIST डेटासेट अक्षरों A से J तक के फ़ॉन्ट ग्लिफ़्स का एक इमेज रिकग्निशन डेटासेट है। यह क्लासिक MNIST डेटासेट के काफ़ी समान है, जिसमें 0 से 9 तक के हस्तलिखित अंकों की इमेज होती हैं: इस केस में, आप पाएंगे कि NotMNIST डेटासेट में कुल 10 श्रेणियों में A - J तक के 70,000 अक्षरों की 28x28 ग्रेस्केल इमेज हैं, और प्रति श्रेणी 6,000 इमेज हैं।
टिप: यदि आप MNIST डेटासेट के साथ क्लासिफिकेशन कार्यों के लिए मल्टी-लेयर परसेप्ट्रॉन (MLP) इम्प्लीमेंट करना सीखना चाहते हैं, तो यह ट्यूटोरियल देखें।
NotMNIST डेटासेट Keras या TensorFlow फ्रेमवर्क में प्रीडिफ़ाइंड नहीं है, इसलिए आपको डेटा इस स्रोत से डाउनलोड करना होगा। डेटा ubyte.gzip फ़ॉर्मेट में डाउनलोड होगा, लेकिन अभी इसकी चिंता न करें! आप जल्दी ही सीखेंगे कि बाइटस्ट्रीम फ़ॉर्मेट कैसे पढ़ें और उन्हें NumPy array में कैसे बदलें। तो चलिए शुरू करते हैं!
नेटवर्क को Nvidia Tesla K40 पर ट्रेन किया जाएगा, इसलिए यदि आप GPU पर ट्रेन करते हैं और Jupyter Notebook का उपयोग करते हैं, तो आपको तीन और कोड की पंक्तियाँ जोड़नी होंगी जहाँ आप os मॉड्यूल का उपयोग करके CUDA डिवाइस ऑर्डर और CUDA विज़िबल डिवाइसेज़ निर्दिष्ट करेंगे।
नीचे दिए गए कोड में, आप मूल रूप से os.environ का उपयोग करके नोटबुक में एनवायरनमेंट वेरिएबल्स सेट करते हैं। Keras को इनिशियलाइज़ करने से पहले यह करना अच्छा रहता है ताकि Keras बैकएंड TensorFlow पहले GPU का उपयोग करे। यदि जिस मशीन पर आप ट्रेन कर रहे हैं, उस पर GPU 0 पर है, तो सुनिश्चित करें कि आप 1 की जगह 0 का उपयोग करें। आप अपने टर्मिनल पर एक साधारण कमांड चलाकर यह देख सकते हैं: उदाहरण के लिए, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
इसके बाद, आप सभी आवश्यक मॉड्यूल जैसे numpy, matplotlib और सबसे महत्वपूर्ण keras इम्पोर्ट करेंगे, क्योंकि आज के ट्यूटोरियल में आप इसी फ्रेमवर्क का उपयोग करेंगे!
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
Using TensorFlow backend.
यहाँ, आप एक फ़ंक्शन परिभाषित करते हैं जो gzip फ़ाइल खोलता है, और bytestream.read() का उपयोग करके फ़ाइल को पढ़ता है। आप इस फ़ंक्शन को इमेज के आयाम और कुल इमेजों की संख्या पास करते हैं। फिर, np.frombuffer() का उपयोग करके, आप buf वेरिएबल में स्टोर की गई स्ट्रिंग को float32 प्रकार के NumPy array में बदलते हैं।
अगले चरण में, आप array को तीन-आयामी array या टेन्सर में रीशेप करते हैं जहाँ पहला आयाम इमेजों की संख्या है, और दूसरा तथा तीसरा आयाम इमेज का आयाम। अंत में, आप NumPy array data रिटर्न करते हैं।
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
अब आप फ़ंक्शन extract_data() को ट्रेनिंग और टेस्टिंग फ़ाइलें और उनकी संबंधित इमेजों की संख्या पास करके कॉल करेंगे:
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
इसी तरह, आप एक extract labels फ़ंक्शन परिभाषित करते हैं जो gzip फ़ाइल खोलता है, bytestream.read() का उपयोग करके फ़ाइल पढ़ता है, जिसमें आप लेबल का आयाम (1) और कुल इमेजों की संख्या पास करते हैं। फिर, np.frombuffer() का उपयोग करके, आप buf वेरिएबल में स्टोर स्ट्रिंग को int64 प्रकार के NumPy array में बदलते हैं।
इस बार, आपको array को रीशेप करने की ज़रूरत नहीं है क्योंकि वेरिएबल labels 60,000 x 1 आयाम का कॉलम वेक्टर रिटर्न करेगा। अंत में, आप NumPy array labels रिटर्न करते हैं।
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
अब आप ट्रेनिंग और टेस्टिंग लेबल फ़ाइलें और उनकी संबंधित इमेजों की संख्या पास करके extract label फ़ंक्शन को कॉल करेंगे:
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
जब आपके पास ट्रेनिंग और टेस्टिंग डेटा लोड हो जाए, तो आप आज के ट्यूटोरियल में जिन डेटा के साथ काम करने जा रहे हैं, उनके बारे में कुछ समझ हासिल करने के लिए डेटा का विश्लेषण करने के लिए पूरी तरह तैयार हैं!
आइए अब देखें कि डेटासेट में इमेज कैसी दिखती हैं और NumPy array के .shape एट्रिब्यूट की मदद से इमेज के आयाम क्या हैं:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
ऊपर के आउटपुट से, आप देख सकते हैं कि ट्रेनिंग डेटा का आकार 60000 x 28 x 28 है क्योंकि 60,000 ट्रेनिंग सैंपल हैं, प्रत्येक 28 x 28 आयाम की मैट्रिक्स। इसी प्रकार, टेस्ट डेटा का आकार 10000 x 28 x 28 है क्योंकि 10,000 टेस्टिंग सैंपल हैं।
नोट करें कि इस टास्क में आप ट्रेनिंग और टेस्टिंग लेबल्स का उपयोग नहीं करेंगे। मौजूदा कार्य केवल ट्रेनिंग और टेस्टिंग इमेज से संबंधित है। हालांकि, बेहतर समझ के लिए, जो आपको डेटा के बारे में बेहतर अंतर्ज्ञान दे सकती है, आप लेबल्स का उपयोग करेंगे।
आइए एक डिक्शनरी बनाते हैं जिसमें क्लास नाम और उनके संबंधित केटेगोरिकल क्लास लेबल्स होंगे:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
अब, आइए आपके डेटासेट की कुछ इमेज पर नज़र डालते हैं:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[0], (28,28))
curr_lbl = train_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[0], (28,28))
curr_lbl = test_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
<matplotlib.text.Text at 0x7f3ec73db240>
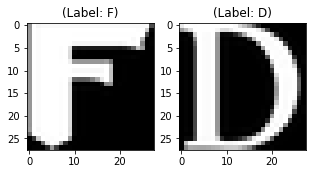
ऊपर दिए गए दो प्लॉट्स का आउटपुट ट्रेनिंग और टेस्टिंग डेटा से एक-एक सैंपल इमेज है, और इन इमेजों को क्रमशः 5 या F और 3 या D का क्लास लेबल दिया गया है। इसी तरह, अन्य अक्षरों के अलग-अलग लेबल होंगे, लेकिन समान अक्षरों के समान लेबल होंगे। इसका मतलब है कि सभी 6,000 F क्लास इमेज का क्लास लेबल 5 होगा।
डेटासेट की इमेज वास्तव में 28 x 28 आयाम की ग्रेस्केल इमेज हैं जिनके पिक्सेल वैल्यू 0 से 255 के बीच होते हैं, इसलिए मॉडल में डेटा फीड करने से पहले इसका प्रीप्रोसेस करना बहुत महत्वपूर्ण है। आप पहले ट्रेन और टेस्ट सेट की प्रत्येक 28 x 28 इमेज को 28 x 28 x 1 साइज की मैट्रिक्स में बदलेंगे, जिसे आप नेटवर्क में फीड कर सकते हैं:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
अब, आप ट्रेनिंग और टेस्टिंग NumPy arrays के डेटा टाइप को चेक करना चाहेंगे, यह float32 फॉर्मेट में होना चाहिए, यदि नहीं है तो आपको इसे इस फॉर्मेट में बदलना होगा, लेकिन चूंकि आप डेटा पढ़ते समय पहले ही इसे कन्वर्ट कर चुके हैं, इसलिए अब इसे दोबारा करने की ज़रूरत नहीं। आपको पिक्सेल वैल्यू को 0 - 1 की रेंज में रीसकेल भी करना होगा। तो चलिए यह करते हैं!
ट्रेनिंग और टेस्टिंग डेटा टाइप्स को वेरिफाई करना न भूलें:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
अगला कदम, ट्रेनिंग और टेस्टिंग डेटा को उनके अधिकतम पिक्सेल वैल्यू से रीसकेल करना है:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
आइए ट्रेनिंग और टेस्टिंग डेटा का अधिकतम मान वेरिफाई करें जो रीसकेलिंग के बाद 1.0 होना चाहिए!
np.max(train_data), np.max(test_data)
(1.0, 1.0)
यह सब करने के बाद, डेटा को पार्टिशन करना महत्वपूर्ण है। ताकि आपका मॉडल अच्छी तरह जनरलाइज़ कर सके, आप ट्रेनिंग डेटा को दो भागों में बाँटेंगे: ट्रेनिंग और वेलिडेशन सेट। आप अपने मॉडल को 80% डेटा पर ट्रेन करेंगे और बचे हुए ट्रेनिंग डेटा के 20% पर वेलिडेट करेंगे।
यह ओवरफिटिंग की संभावनाएँ कम करने में भी मदद करेगा, क्योंकि आप अपने मॉडल को ऐसे डेटा पर वेलिडेट करेंगे जिसे उसने ट्रेनिंग फेज़ में नहीं देखा होगा।
आप scikit-learn के train_test_split मॉड्यूल का उपयोग करके डेटा को ठीक से विभाजित कर सकते हैं:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
नोट करें कि इस टास्क के लिए आपको ट्रेनिंग और टेस्टिंग लेबल्स की ज़रूरत नहीं है। इसलिए आप ट्रेनिंग इमेज को दो बार पास करेंगे। आपकी ट्रेनिंग इमेज इनपुट के साथ-साथ ग्राउंड ट्रुथ के रूप में भी काम करेंगी, ठीक वैसे ही जैसे क्लासिफिकेशन टास्क में लेबल्स करते हैं।
अब आप नेटवर्क को परिभाषित करने और डेटा को नेटवर्क में फीड करने के लिए तैयार हैं। तो बिना देर किए, अगले चरण पर चलते हैं!
इमेज का साइज 28 x 28 x 1 या 784-आयामी वेक्टर है। आप इमेज मैट्रिक्स को array में बदलते हैं, उसे 0 और 1 के बीच रीसकेल करते हैं, 28 x 28 x 1 के साइज में रीशेप करते हैं और इसे नेटवर्क में इनपुट के रूप में फीड करते हैं।
आप 128 का बैच साइज उपयोग करेंगे; 256 या 512 जैसे बड़े बैच साइज का उपयोग भी किया जा सकता है—यह इस पर निर्भर करता है कि आप किस सिस्टम पर मॉडल को ट्रेन कर रहे हैं। यह लर्निंग पैरामीटर्स तय करने में काफ़ी योगदान देता है और प्रिडिक्शन एक्यूरेसी को प्रभावित करता है। आप अपने नेटवर्क को 50 epochs तक ट्रेन करेंगे।
batch_size = 128
epochs = 50
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
जैसा कि पहले चर्चा हुई, ऑटोएन्कोडर दो भागों में बँटा होता है: एन्कोडर और डिकोडर।
एन्कोडर
डिकोडर
मैक्स-पूलिंग लेयर हर बार इनपुट को दो गुना डाउनसैंपल करेगी, जबकि अपसैंपलिंग लेयर हर बार इनपुट को दो गुना अपसैंपल करेगी।
नोट: फ़िल्टर्स की संख्या, फ़िल्टर साइज, लेयर्स की संख्या, आप अपने मॉडल को कितने epochs तक ट्रेन करते हैं—ये सभी हाइपरपैरामीटर्स हैं और इन्हें आपकी अपनी समझ पर तय किया जाना चाहिए। आप इन हाइपरपैरामीटर्स में बदलाव कर नए प्रयोग करने और अपने मॉडल का प्रदर्शन मापने के लिए स्वतंत्र हैं। और इसी तरह आप धीरे-धीरे डीप लर्निंग की कला सीखेंगे!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
मॉडल बनने के बाद, आपको इसे RMSProp ऑप्टिमाइज़र के साथ कम्पाइल करना होगा।
टिप: यदि आप RMSProp के बारे में और जानना चाहते हैं तो Andrew Ng का यह ट्यूटोरियल देखें।
ध्यान दें कि आपको loss आर्गुमेंट के माध्यम से लॉस टाइप भी निर्दिष्ट करना होगा। इस केस में, यह मीन स्क्वेयर्ड एरर है, क्योंकि हर बैच के बाद लॉस का हिसाब प्रिडिक्टेड आउटपुट के बैच और ग्राउंड ट्रुथ के बीच पिक्सेल-दर-पिक्सेल मीन स्क्वेयर्ड एरर से किया जाएगा:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
आइए summary फ़ंक्शन का उपयोग करके आपने ऊपर जो लेयर्स बनाई हैं उन्हें विज़ुअलाइज़ करें, इससे प्रत्येक लेयर में पैरामीटर्स (वेट्स और बायसेज़) की संख्या और आपके मॉडल में कुल पैरामीटर्स दिखेंगे।
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_6 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
max_pooling2d_9 (MaxPooling2 (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
max_pooling2d_10 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
up_sampling2d_9 (UpSampling2 (None, 14, 14, 128)       0
_________________________________________________________________
conv2d_29 (Conv2D)           (None, 14, 14, 64)        73792
_________________________________________________________________
up_sampling2d_10 (UpSampling (None, 28, 28, 64)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
आखिरकार, Keras के fit() फ़ंक्शन से मॉडल को ट्रेन करने का समय आ गया है! मॉडल 50 epochs तक ट्रेन करता है। fit() फ़ंक्शन एक हिस्ट्री ऑब्जेक्ट रिटर्न करेगा; इस फ़ंक्शन के परिणाम को fashion_train में स्टोर करके, आप बाद में ट्रेनिंग और वेलिडेशन के बीच लॉस फ़ंक्शन प्लॉट कर सकते हैं, जो आपको अपने मॉडल के प्रदर्शन का दृश्य विश्लेषण करने में मदद करेगा।
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/50
48000/48000 [==============================] - 16s - loss: 0.0368 - val_loss: 0.0132
Epoch 2/50
48000/48000 [==============================] - 15s - loss: 0.0101 - val_loss: 0.0085
Epoch 3/50
48000/48000 [==============================] - 15s - loss: 0.0071 - val_loss: 0.0081
Epoch 4/50
48000/48000 [==============================] - 15s - loss: 0.0057 - val_loss: 0.0056
Epoch 5/50
48000/48000 [==============================] - 15s - loss: 0.0048 - val_loss: 0.0051
Epoch 6/50
48000/48000 [==============================] - 15s - loss: 0.0043 - val_loss: 0.0039
Epoch 7/50
48000/48000 [==============================] - 15s - loss: 0.0038 - val_loss: 0.0039
Epoch 8/50
48000/48000 [==============================] - 15s - loss: 0.0035 - val_loss: 0.0039
Epoch 9/50
48000/48000 [==============================] - 15s - loss: 0.0032 - val_loss: 0.0030
Epoch 10/50
48000/48000 [==============================] - 15s - loss: 0.0030 - val_loss: 0.0029
Epoch 11/50
48000/48000 [==============================] - 15s - loss: 0.0029 - val_loss: 0.0026
Epoch 12/50
48000/48000 [==============================] - 15s - loss: 0.0027 - val_loss: 0.0025
Epoch 13/50
48000/48000 [==============================] - 15s - loss: 0.0026 - val_loss: 0.0028
Epoch 14/50
48000/48000 [==============================] - 15s - loss: 0.0025 - val_loss: 0.0022
Epoch 15/50
48000/48000 [==============================] - 15s - loss: 0.0024 - val_loss: 0.0024
Epoch 16/50
48000/48000 [==============================] - 16s - loss: 0.0023 - val_loss: 0.0027
Epoch 17/50
48000/48000 [==============================] - 15s - loss: 0.0023 - val_loss: 0.0022
Epoch 18/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0025
Epoch 19/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0022
Epoch 20/50
48000/48000 [==============================] - 15s - loss: 0.0021 - val_loss: 0.0022
Epoch 21/50
48000/48000 [==============================] - 16s - loss: 0.0021 - val_loss: 0.0020
Epoch 22/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0019
Epoch 23/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0021
Epoch 24/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0018
Epoch 25/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 26/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 27/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0017
Epoch 28/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0018
Epoch 29/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 30/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0017
Epoch 31/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 32/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0018
Epoch 33/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0017
Epoch 34/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0018
Epoch 35/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0019
Epoch 36/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0016
Epoch 37/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0017
Epoch 38/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0019
Epoch 39/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 40/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 41/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 42/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 43/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0018
Epoch 44/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 45/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 46/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 47/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0017
Epoch 48/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0015
Epoch 49/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 50/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0020
शानदार! आपने Not-MNIST पर मॉडल को 50 epochs तक ट्रेन किया। अब, मॉडल के प्रदर्शन को विज़ुअलाइज़ करने के लिए ट्रेनिंग और वेलिडेशन डेटा के बीच का लॉस प्लॉट बनाते हैं।
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
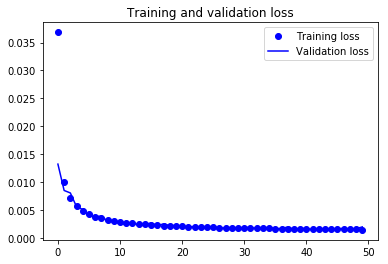
अंततः, आप देख सकते हैं कि वेलिडेशन लॉस और ट्रेनिंग लॉस दोनों सिंक में हैं। यह दर्शाता है कि आपका मॉडल ओवरफिटिंग नहीं कर रहा: वेलिडेशन लॉस घट रहा है, बढ़ नहीं रहा, और ट्रेनिंग व वेलिडेशन लॉस के बीच शायद ही कोई गैप है।
अतः, आप कह सकते हैं कि आपके मॉडल की जनरलाइज़ेशन क्षमता अच्छी है।
आखिरकार, अब समय है Keras के predict() फ़ंक्शन का उपयोग करके टेस्ट इमेज को रिकंस्ट्रक्ट करने का और देखना कि आपका मॉडल टेस्ट डेटा पर कितनी अच्छी तरह रिकंस्ट्रक्ट कर पाता है।
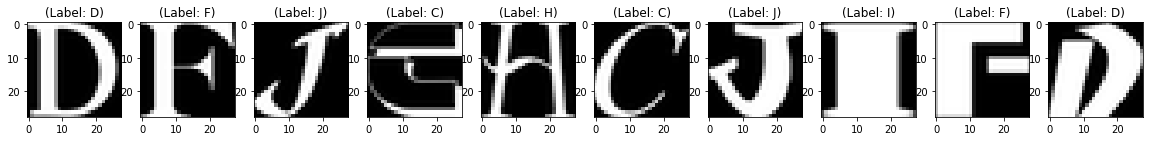
आप प्रशिक्षित मॉडल से सभी 10,000 टेस्ट इमेज पर प्रिडिक्ट करेंगे और कुछ रिकंस्ट्रक्टेड इमेज प्लॉट करेंगे ताकि आप विज़ुअल रूप से देख सकें कि आपका मॉडल टेस्ट इमेज को कितना अच्छी तरह रिकंस्ट्रक्ट कर रहा है।
pred = autoencoder.predict(test_data)
pred.shape
(10000, 28, 28, 1)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
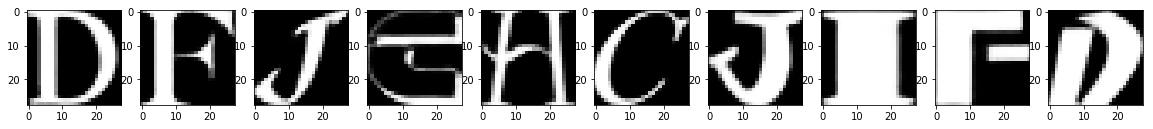
ऊपर दी गई आकृतियों से, आप देख सकते हैं कि आपके मॉडल ने उन टेस्ट इमेज के रिकंस्ट्रक्शन में बेहतरीन काम किया है जिन पर आपने प्रिडिक्शन किया। कम से कम विज़ुअल रूप से देखें तो टेस्ट और रिकंस्ट्रक्टेड इमेज लगभग एक जैसी दिखती हैं।
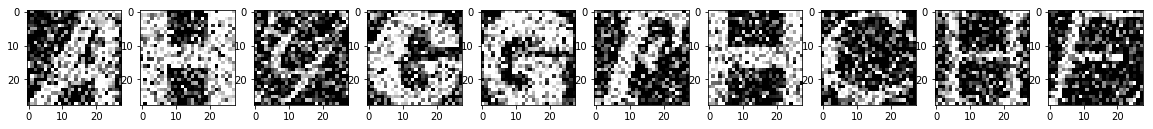
डिनॉइज़िंग ऑटोएन्कोडर ऐसा प्रतिनिधित्व (लैटेंट-स्पेस या बॉटलनेक) सीखने की कोशिश करता है जो नॉइज़ के प्रति मज़बूत हो। आप एक इमेज में नॉइज़ जोड़ते हैं और फिर नॉइज़ी इमेज को नेटवर्क के एन्कोडर भाग के इनपुट के रूप में फीड करते हैं। ऑटोएन्कोडर का एन्कोडर भाग इमेज को एक अलग स्पेस में ट्रांसफ़ॉर्म करता है जो अक्षरों को संरक्षित रखने की कोशिश करता है लेकिन नॉइज़ को हटा देता है।
लेकिन यह नॉइज़ को वास्तव में कैसे हटाता है?
ट्रेनिंग के दौरान, आप एक लॉस फ़ंक्शन निर्धारित करते हैं, ठीक वैसे ही जैसे आपने पहले कॉन्वोल्यूशनल ऑटोएन्कोडर में रूट मीन स्क्वेयर्ड एरर निर्धारित किया था। ट्रेनिंग की हर इटरेशन पर, नेटवर्क डिकोडर द्वारा आउटपुट की गई नॉइज़ी इमेज और ग्राउंड ट्रुथ (डेनॉइज़्ड इमेज) के बीच लॉस की गणना करेगा और रिकंस्ट्रक्टेड इमेज और मूल नॉइज़-फ्री इमेज के बीच उस लॉस या अंतर को कम करने की कोशिश करेगा। दूसरे शब्दों में, नेटवर्क 7 x 7 x 128 का ऐसा स्पेस सीखेगा जो उस डेटा के नॉइज़-फ्री एन्कोडिंग्स होगा जिस पर आप अपना नेटवर्क ट्रेन करेंगे!
अब, Python में यह कैसे काम करता है, यह देखने के लिए, आप उसी NotMNIST डेटासेट का उपयोग करेंगे जिसका उपयोग आपने इस ट्यूटोरियल के पहले हिस्से में किया था। यानी अब आपको कोई डेटा प्रीप्रोसेसिंग नहीं करनी है क्योंकि वह पहले ही हो चुकी है! हालांकि, इस हिस्से में एक महत्वपूर्ण प्रीप्रोसेसिंग स्टेप ट्रेनिंग, वेलिडेशन और टेस्टिंग इमेज में नॉइज़ जोड़ना होगा। तो, पहले इसे जल्दी से कर लेते हैं!
सबसे पहले, एक नॉइज़ फ़ैक्टर परिभाषित करते हैं जो एक हाइपरपैरामीटर है। नॉइज़ फ़ैक्टर को एक रैंडम मैट्रिक्स के साथ गुणा किया जाता है जिसका माध्य 0.0 और मानक विचलन 1.0 है। यह मैट्रिक्स नॉर्मल (गौसियन) डिस्ट्रीब्यूशन से सैंपल्स लेगा। जिस डेटा में आप नॉइज़ जोड़ेंगे, उसके आकार के समान ही रैंडम नॉर्मल array का आकार होगा।
सरलता के लिए, एक उदाहरण से समझते हैं: वेरिएबल train_X का आकार 48000 x 28 x 28 x 1 है। अतः, रैंडम नॉर्मल array का आकार भी train_X के समान होगा, तभी आप दो arrays को जोड़ पाएँगे क्योंकि तब उनके आयाम समान होंगे।
noise_factor = 0.5
x_train_noisy = train_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=train_X.shape)
x_valid_noisy = valid_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=valid_X.shape)
x_test_noisy = test_data + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=test_data.shape)
x_train_noisy = np.clip(x_train_noisy, 0., 1.)
x_valid_noisy = np.clip(x_valid_noisy, 0., 1.)
x_test_noisy = np.clip(x_test_noisy, 0., 1.)
np.clip() सभी नकारात्मक मानों को शून्य तक और एक से बड़े सभी मानों को एक तक सीमित कर देगा। क्योंकि आप अपने पिक्सेल वैल्यू को शून्य और एक के बीच रखना चाहते हैं। और डेटा में नॉइज़ जोड़ने के बाद पिक्सेल वैल्यू की रेंज में थोड़ा बदलाव आने की संभावना रहती है, इसलिए सुरक्षित रहने के लिए पिक्सेल वैल्यू को क्लिप करना अच्छा अभ्यास है।
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(x_train_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(x_test_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7f3ec6b20e48>
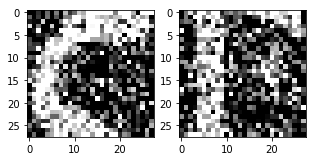
अब जब आपके पास नॉइज़ी डेटा है, तो आप इसे नेटवर्क में फीड कर सकते हैं और देख सकते हैं कि इमेज से नॉइज़ किस तरह "जादुई" तरीके से हट जाता है!
जैसा कि पहले चर्चा हुई, ऑटोएन्कोडर दो भागों में बँटा होता है: एन्कोडर और डिकोडर। आप जो आर्किटेक्चर बनाएँगे, वह निम्नलिखित जैसा दिखेगा:
एन्कोडर
डिकोडर
batch_size = 128
epochs = 20
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
def autoencoder(input_img):
    #encoder
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    up1 = UpSampling2D((2,2))(conv4)
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1)
    up2 = UpSampling2D((2,2))(conv5)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2)
    return decoded
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
यदि आपको याद हो, कॉन्वोल्यूशनल ऑटोएन्कोडर को ट्रेन करते समय आपने ट्रेनिंग इमेज दो बार फीड की थीं क्योंकि इनपुट और ग्राउंड ट्रुथ दोनों एक जैसे थे। हालांकि, डिनॉइज़िंग ऑटोएन्कोडर में, आप नॉइज़ी इमेज को इनपुट के रूप में फीड करते हैं जबकि आपका ग्राउंड ट्रुथ वही डेनॉइज़्ड इमेज रहती हैं जिन पर आपने नॉइज़ लगाया था। तभी नेटवर्क नॉइज़ी और असली डेनॉइज़्ड इमेज के बीच लॉस की गणना कर पाएगा।
autoencoder_train = autoencoder.fit(x_train_noisy, train_X, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(x_valid_noisy, valid_X))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 15s - loss: 0.0531 - val_loss: 0.0268
Epoch 2/20
48000/48000 [==============================] - 14s - loss: 0.0243 - val_loss: 0.0217
Epoch 3/20
48000/48000 [==============================] - 14s - loss: 0.0207 - val_loss: 0.0200
Epoch 4/20
48000/48000 [==============================] - 14s - loss: 0.0190 - val_loss: 0.0184
Epoch 5/20
48000/48000 [==============================] - 14s - loss: 0.0179 - val_loss: 0.0183
Epoch 6/20
48000/48000 [==============================] - 14s - loss: 0.0171 - val_loss: 0.0178
Epoch 7/20
48000/48000 [==============================] - 14s - loss: 0.0165 - val_loss: 0.0161
Epoch 8/20
48000/48000 [==============================] - 14s - loss: 0.0160 - val_loss: 0.0166
Epoch 9/20
48000/48000 [==============================] - 14s - loss: 0.0157 - val_loss: 0.0157
Epoch 10/20
48000/48000 [==============================] - 14s - loss: 0.0153 - val_loss: 0.0159
Epoch 11/20
48000/48000 [==============================] - 14s - loss: 0.0151 - val_loss: 0.0153
Epoch 12/20
48000/48000 [==============================] - 14s - loss: 0.0148 - val_loss: 0.0154
Epoch 13/20
48000/48000 [==============================] - 14s - loss: 0.0146 - val_loss: 0.0151
Epoch 14/20
48000/48000 [==============================] - 14s - loss: 0.0145 - val_loss: 0.0152
Epoch 15/20
48000/48000 [==============================] - 14s - loss: 0.0143 - val_loss: 0.0163
Epoch 16/20
48000/48000 [==============================] - 14s - loss: 0.0141 - val_loss: 0.0152
Epoch 17/20
48000/48000 [==============================] - 14s - loss: 0.0140 - val_loss: 0.0149
Epoch 18/20
48000/48000 [==============================] - 14s - loss: 0.0139 - val_loss: 0.0153
Epoch 19/20
48000/48000 [==============================] - 14s - loss: 0.0138 - val_loss: 0.0152
Epoch 20/20
48000/48000 [==============================] - 14s - loss: 0.0137 - val_loss: 0.0150
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
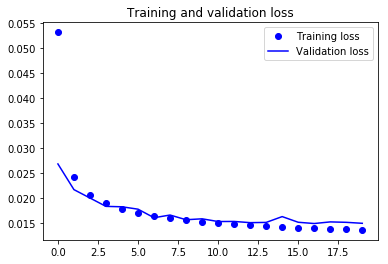
ऊपर के प्लॉट से, आप यह अंतर्ज्ञान प्राप्त कर सकते हैं कि मॉडल कुछ epochs पर ओवरफिटिंग कर रहा है जबकि ज़्यादातर समय सिंक में है। आप मॉडल के प्रदर्शन को बेहतर बनाने के लिए इसमें कुछ जटिलता जोड़कर निश्चित रूप से कोशिश कर सकते हैं ताकि लॉस और घटे, इसे और epochs तक ट्रेन करें और फिर निर्णय लें।
pred = autoencoder.predict(x_test_noisy)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Test Images with Noise")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(x_test_noisy[i, ..., 0], cmap='gray')
plt.show()

plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
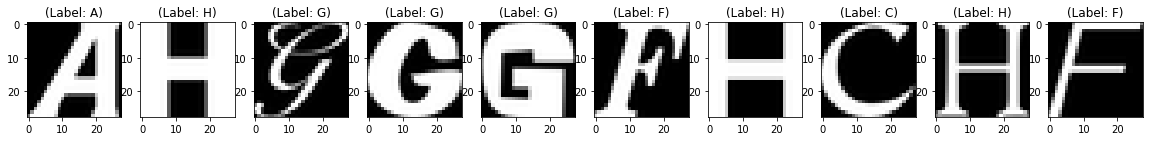
Test Images with Noise
Reconstruction of Noisy Test Images
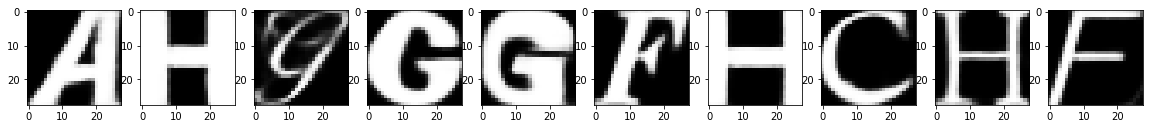
ऐसा लगता है कि, केवल 20 epochs में, काफ़ी सरल नेटवर्क आर्किटेक्चर ने टेस्ट इमेज से नॉइज़ हटाने में काफ़ी अच्छा काम किया है, है न?
यह ट्यूटोरियल ऑटोएन्कोडर्स को सैद्धांतिक और व्यावहारिक रूप से समझने की अच्छी शुरुआत था। यदि आप आसानी से या थोड़े अतिरिक्त प्रयास के साथ साथ चल पाए हैं, तो शाबाश! DataCamp का Keras Tutorial: Deep Learning in Python ट्यूटोरियल और Introduction to Deep Learning in Python कोर्स देखें।
अगले ट्यूटोरियल में, आप स्क्रैच से इमेज पढ़ना, उनका विश्लेषण, प्रीप्रोसेस और उन्हें फिंगरप्रिंट डेटासेट का उपयोग करके मॉडल में फीड करना सीखेंगे। आप T-1 मोडेलिटी की मेडिकल इमेज पढ़ना और उन्हें ऑटोएन्कोडर का उपयोग करके रिकंस्ट्रक्ट करना भी सीखेंगे!
अभी भी बहुत कुछ कवर करना बाकी है, तो क्यों न DataCamp का Deep Learning in Python कोर्स कर लिया जाए? यदि आपने अभी तक नहीं किया है। आप बुनियाद से सीखेंगे और धीरे-धीरे डीप लर्निंग डोमेन में महारत हासिल करेंगे, यह निस्संदेह एक अमूल्य संसाधन होगा जब आप Python में कॉन्वोल्यूशनल न्यूरल नेटवर्क्स के साथ काम करना, चेहरों, वस्तुओं आदि का पता लगाना सीख रहे होंगे।
Python और Keras के बारे में और जानें
कोर्स
कोर्स
कोर्स