Corso
Introduzione al Deep Learning in Python
4 ore
264.7K
In generale, puoi considerare gli autoencoder come una tecnica di apprendimento non supervisionato, dato che non servono etichette esplicite per addestrare il modello. Tutto ciò di cui hai bisogno per addestrare un autoencoder sono i dati grezzi in input.
In questo tutorial imparerai cosa sono gli autoencoder nel deep learning e implementerai un autoencoder convoluzionale e uno denoising in Python con Keras. Lavorerai con il dataset alfabetico NotMNIST come esempio.
In sintesi, in questo tutorial affronterai i seguenti argomenti:
Come hai letto nell’introduzione, un autoencoder è un algoritmo di machine learning non supervisionato che prende un’immagine come input e prova a ricostruirla usando un numero inferiore di bit nel collo di bottiglia, noto anche come spazio latente. L’immagine viene in gran parte compressa nel collo di bottiglia. La compressione negli autoencoder si ottiene addestrando la rete per un certo periodo e, man mano che apprende, cerca di rappresentare al meglio l’immagine in input nel collo di bottiglia. Gli algoritmi generali di compressione delle immagini come JPEG e le tecniche lossless JPEG comprimono le immagini senza bisogno di alcun addestramento e fanno un buon lavoro nel comprimerle.
Gli autoencoder sono simili alle tecniche di riduzione della dimensionalità come l’Analisi delle Componenti Principali (PCA). Proiettano i dati da una dimensione superiore a una inferiore usando trasformazioni lineari e cercano di preservare le caratteristiche importanti dei dati rimuovendo le parti non essenziali.
Tuttavia, la principale differenza tra autoencoder e PCA risiede nella trasformazione: come hai già letto, la PCA utilizza trasformazioni lineari, mentre gli autoencoder usano trasformazioni non lineari.
Ora che hai un’idea di base degli autoencoder, scomponiamo il termine e cerchiamo di farci un po’ di intuizione!
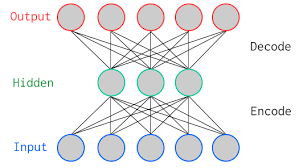
La figura sopra mostra un autoencoder vanilla a due strati con un solo livello nascosto. Nella terminologia del deep learning, noterai spesso che lo strato di input non viene conteggiato nel totale degli strati di un’architettura. Il totale degli strati in un’architettura comprende solo il numero di livelli nascosti e lo strato di output.
Come mostrato nell’immagine, gli strati di input e di output hanno lo stesso numero di neuroni.
Facciamo un esempio. Fornisci un’immagine con solo cinque valori di pixel all’autoencoder, che viene compressa dall’encoder in tre valori di pixel nel collo di bottiglia (lo strato centrale) o spazio latente. Usando questi tre valori, il decoder prova a ricostruire i cinque valori di pixel o, meglio, l’immagine di input che hai fornito alla rete.
Nella realtà, ci sono più livelli nascosti tra l’input e l’output.
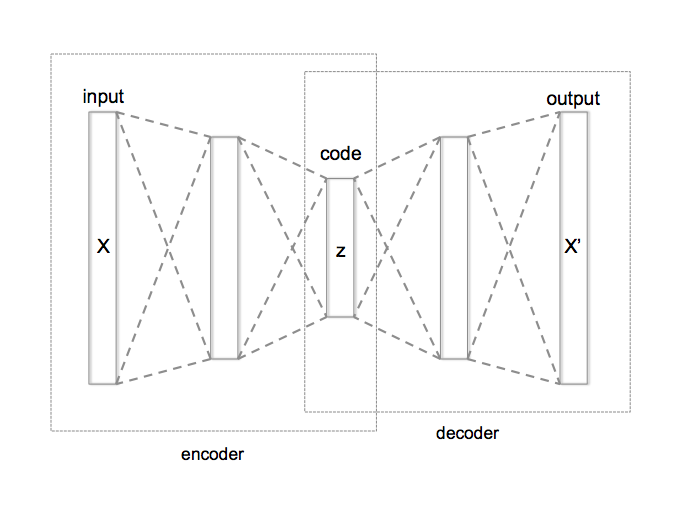
L’autoencoder può essere scomposto in tre parti
Esistono vari tipi di autoencoder, come l’autoencoder convoluzionale, il denoising autoencoder, il variational autoencoder e lo sparse autoencoder. Tuttavia, come hai letto nell’introduzione, in questo tutorial ti concentrerai solo su quelli convoluzionali e denoising.Autoencoder convoluzionali in Python con Keras
Dal momento che i tuoi dati in input sono immagini, è una buona idea usare un autoencoder convoluzionale. Non è una variante dell’autoencoder, ma piuttosto un autoencoder tradizionale impilato con layer convoluzionali: in pratica sostituisci i fully connected layer con layer convoluzionali. I layer convoluzionali, insieme ai layer di max-pooling, convertono l’input da largo (un’immagine 28 x 28) e sottile (un singolo canale o in scala di grigi) a piccolo (immagine 7 x 7 nello spazio latente) e spesso (128 canali).
Non preoccuparti se l’idea sopra non ti è chiara! La seconda parte di questo tutorial, in cui ti concentrerai sull’implementazione di quanto sopra, chiarirà tutti i tuoi dubbi (se ne hai!).
Consiglio: se vuoi saperne di più sulle reti neurali convoluzionali, dai un’occhiata a questo tutorial.
Questo aiuta la rete a estrarre caratteristiche visive dalle immagini e quindi a ottenere una rappresentazione dello spazio latente più accurata. Il processo di ricostruzione usa upsampling e convoluzioni, che costituiscono il decoder. Il downsampling è il processo in cui l’immagine viene compressa in una bassa dimensione, noto anche come encoder.
È importante notare che l’encoder comprime principalmente l’immagine in input, per esempio: se l’immagine in input ha dimensioni 176 x 176 x 1 (~30976), allora il punto di massima compressione può avere dimensioni 22 x 22 x 512 (~247808). Quindi, in questo caso, sei partito da un’immagine in scala di grigi di dimensione 176 x 176 e, passando attraverso un paio di layer convoluzionali e precisamente tre layer di max-pooling, l’immagine è stata infine ridotta a una dimensione di 22 x 22 ma il numero di canali è aumentato da 1 a 512. Come detto sopra, il tuo input da largo (176 x 176) e sottile (1) è diventato piccolo (22x22) e spesso (512).
Il dataset notMNIST è un dataset di riconoscimento di immagini di glifi di font per le lettere dalla A alla J. È piuttosto simile al classico MNIST, che contiene immagini di cifre scritte a mano da 0 a 9: in questo caso, troverai che il dataset NotMNIST comprende immagini in scala di grigi 28x28 di 70.000 lettere dalla A alla J in totale 10 categorie, e 6.000 immagini per categoria.
Consiglio: se vuoi imparare a implementare un Multi-Layer Perceptron (MLP) per compiti di classificazione con il dataset MNIST, dai un’occhiata a questo tutorial.
Il dataset NotMNIST non è predefinito nei framework Keras o TensorFlow, quindi dovrai scaricare i dati da questa fonte. I dati verranno scaricati in formato ubyte.gzip, ma niente panico! Tra poco imparerai a leggere formati bytestream e convertirli in un array NumPy. Quindi, iniziamo!
La rete verrà addestrata su una Nvidia Tesla K40, quindi se ti alleni su una GPU e usi Jupyter Notebook, dovrai aggiungere tre righe di codice in cui specifichi l’ordine dei dispositivi CUDA e i dispositivi CUDA visibili utilizzando un modulo chiamato os.
Nel codice seguente, imposti sostanzialmente variabili d’ambiente nel notebook usando os.environ. È buona norma fare quanto segue prima di inizializzare Keras per limitare il backend TensorFlow di Keras a usare la prima GPU. Se la macchina su cui ti alleni ha una GPU su 0, assicurati di usare 0 invece di 1. Puoi verificarlo eseguendo un semplice comando nel tuo terminale: ad esempio, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Successivamente, importi tutti i moduli necessari come numpy, matplotlib e soprattutto keras, dato che userai quel framework nel tutorial di oggi!
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
Using TensorFlow backend.
Qui definisci una funzione che apre il file gzip, legge il file usando bytestream.read(). Passi a questa funzione la dimensione dell’immagine e il numero totale di immagini. Poi, usando np.frombuffer(), converti la stringa memorizzata nella variabile buf in un array NumPy di tipo float32.
Quindi, rimodelli l’array in un array tridimensionale o tensore in cui la prima dimensione è il numero di immagini e la seconda e la terza sono le dimensioni dell’immagine. Infine, ritorni l’array NumPy data.
def extract_data(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(16)
        buf = bytestream.read(28 * 28 * num_images)
        data = np.frombuffer(buf, dtype=np.uint8).astype(np.float32)
        data = data.reshape(num_images, 28,28)
        return data
Ora chiamerai la funzione extract_data() passando i file di training e test insieme al rispettivo numero di immagini:
train_data = extract_data('train-images-idx3-ubyte.gz', 60000)
test_data = extract_data('t10k-images-idx3-ubyte.gz', 10000)
Allo stesso modo, definisci una funzione per estrarre le etichette che apre il file gzip, legge il file usando bytestream.read(), a cui passi la dimensione dell’etichetta (1) e il numero totale di immagini. Poi, usando np.frombuffer(), converti la stringa memorizzata nella variabile buf in un array NumPy di tipo int64.
Questa volta non hai bisogno di rimodellare l’array poiché la variabile labels restituirà un vettore colonna di dimensione 60.000 x 1. Infine, ritorni l’array NumPy labels.
def extract_labels(filename, num_images):
    with gzip.open(filename) as bytestream:
        bytestream.read(8)
        buf = bytestream.read(1 * num_images)
        labels = np.frombuffer(buf, dtype=np.uint8).astype(np.int64)
        return labels
Ora chiamerai la funzione di estrazione delle etichette passando i file delle etichette di training e test insieme al rispettivo numero di immagini:
train_labels = extract_labels('train-labels-idx1-ubyte.gz',60000)
test_labels = extract_labels('t10k-labels-idx1-ubyte.gz',10000)
Una volta caricati i dati di training e test, sei pronto per analizzare i dati in modo da farti un’idea del dataset con cui lavorerai nel tutorial di oggi!
Analizziamo ora come sono fatte le immagini nel dataset e vediamo anche le dimensioni delle immagini con l’aiuto dell’attributo dell’array NumPy .shape:
# Shapes of training set
print("Training set (images) shape: {shape}".format(shape=train_data.shape))

# Shapes of test set
print("Test set (images) shape: {shape}".format(shape=test_data.shape))
Training set (images) shape: (60000, 28, 28)
Test set (images) shape: (10000, 28, 28)
Dall’output sopra, puoi vedere che i dati di training hanno forma 60000 x 28 x 28 poiché ci sono 60.000 campioni di training, ognuno rappresentato da una matrice 28 x 28. Allo stesso modo, i dati di test hanno forma 10000 x 28 x 28 poiché ci sono 10.000 campioni di test.
Nota che in questo task non userai le etichette di training e test. Il compito qui tratterà solo le immagini di training e test. Tuttavia, per scopi esplorativi, che potrebbero darti una migliore intuizione sui dati, userai le etichette.
Creiamo un dizionario che contenga i nomi delle classi con le corrispondenti etichette categoriche:
# Create dictionary of target classes
label_dict = {
 0: 'A',
 1: 'B',
 2: 'C',
 3: 'D',
 4: 'E',
 5: 'F',
 6: 'G',
 7: 'H',
 8: 'I',
 9: 'J',
}
Ora, diamo un’occhiata a un paio di immagini del tuo dataset:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_data[0], (28,28))
curr_lbl = train_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(test_data[0], (28,28))
curr_lbl = test_labels[0]
plt.imshow(curr_img, cmap='gray')
plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
<matplotlib.text.Text at 0x7f3ec73db240>
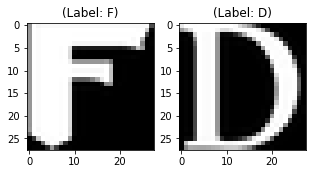
L’output dei due grafici sopra mostra una delle immagini di esempio sia dei dati di training che di test, e queste immagini hanno un’etichetta di classe 5 ovvero F, da un lato, e 3 ovvero D, dall’altro. Allo stesso modo, altre lettere avranno etichette diverse, ma lettere uguali avranno la stessa etichetta. Ciò significa che tutte le 6.000 immagini della classe F avranno un’etichetta di classe 5.
Le immagini del dataset sono effettivamente in scala di grigi con valori di pixel che vanno da 0 a 255 e dimensione 28 x 28, quindi prima di alimentare i dati nel modello è molto importante preprocessorli. Per prima cosa convertirai ogni immagine 28 x 28 dei set di train e test in una matrice di dimensione 28 x 28 x 1, che puoi fornire alla rete:
train_data = train_data.reshape(-1, 28,28, 1)
test_data = test_data.reshape(-1, 28,28, 1)
train_data.shape, test_data.shape
((60000, 28, 28, 1), (10000, 28, 28, 1))
Successivamente, assicurati di controllare il tipo di dato degli array NumPy di training e test: dovrebbe essere in formato float32; se non lo è, dovrai convertirlo, ma poiché lo hai già convertito durante la lettura dei dati, non devi rifarlo. Devi anche riscalare i valori dei pixel nell’intervallo 0 - 1 inclusi. Facciamolo!
Non dimenticare di verificare i tipi di dato di training e test:
train_data.dtype, test_data.dtype
(dtype('float32'), dtype('float32'))
Ora riscaliamo i dati di training e test con il valore massimo dei pixel dei rispettivi dataset:
np.max(train_data), np.max(test_data)
(255.0, 255.0)
train_data = train_data / np.max(train_data)
test_data = test_data / np.max(test_data)
Verifichiamo il valore massimo dei dati di training e test, che dopo il riscalamento dovrebbe essere 1.0!
np.max(train_data), np.max(test_data)
(1.0, 1.0)
Dopo tutto questo, è importante partizionare i dati. Affinché il tuo modello generalizzi bene, dividi i dati di training in due parti: un set di training e uno di validazione. Allenerai il modello sull’80% dei dati e lo validerai sul 20% rimanente dei dati di training.
Questo ti aiuterà anche a ridurre le possibilità di overfitting, perché validerai il modello su dati che non ha visto in fase di training.
Puoi usare il modulo train_test_split di scikit-learn per dividere correttamente i dati:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(train_data,
                                                             train_data,
                                                             test_size=0.2,
                                                             random_state=13)
Nota che per questo compito non ti servono le etichette di training e test. Ecco perché passerai le immagini di training due volte. Le tue immagini di training fungeranno sia da input sia da ground truth, proprio come le etichette in un compito di classificazione.
Ora sei pronto per definire la rete e alimentare i dati. Quindi, senza ulteriori indugi, passiamo al prossimo passo!
Le immagini hanno dimensione 28 x 28 x 1 ovvero un vettore a 784 dimensioni. Converti la matrice dell’immagine in un array, la riscalai tra 0 e 1, la rimodelli a dimensione 28 x 28 x 1 e la fornisci come input alla rete.
Inoltre, userai una dimensione di batch di 128; anche una dimensione di 256 o 512 è preferibile: dipende tutto dal sistema su cui alleni il modello. Questo influisce molto nel determinare i parametri di apprendimento e incide sulla precisione delle previsioni. Allenerai la rete per 50 epoche.
batch_size = 128
epochs = 50
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
Come discusso, l’autoencoder è diviso in due parti: un encoder e un decoder.
Encoder
Decoder
Il layer di max-pooling eseguirà il downsampling dell’input di due volte ogni volta che lo usi, mentre il layer di upsampling effettuerà l’upsampling dell’input di due volte ogni volta che viene utilizzato.
Nota: Il numero di filtri, la dimensione dei filtri, il numero di layer, il numero di epoche con cui addestri il modello sono tutti iperparametri e dovrebbero essere decisi in base alla tua intuizione. Sei libero di provare nuovi esperimenti modificando questi iperparametri e misurare le prestazioni del modello. Ed è così che imparerai lentamente l’arte del deep learning!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Dopo aver creato il modello, devi compilarlo usando come ottimizzatore RMSProp.
Consiglio: guarda questo tutorial di Andrew Ng su RMSProp se vuoi saperne di più.
Nota che devi anche specificare il tipo di loss tramite l’argomento loss. In questo caso, è l’errore quadratico medio, dato che la loss dopo ogni batch verrà calcolata tra il batch di output predetto e la ground truth usando l’errore quadratico medio, pixel per pixel:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualizziamo i layer che hai creato nello step precedente usando la funzione summary: mostrerà il numero di parametri (pesi e bias) in ciascun layer e anche il totale dei parametri del modello.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_6 (InputLayer)         (None, 28, 28, 1)         0
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 28, 28, 32)        320
_________________________________________________________________
max_pooling2d_9 (MaxPooling2 (None, 14, 14, 32)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 14, 14, 64)        18496
_________________________________________________________________
max_pooling2d_10 (MaxPooling (None, 7, 7, 64)          0
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 7, 7, 128)         73856
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 7, 7, 128)         147584
_________________________________________________________________
up_sampling2d_9 (UpSampling2 (None, 14, 14, 128)       0
_________________________________________________________________
conv2d_29 (Conv2D)           (None, 14, 14, 64)        73792
_________________________________________________________________
up_sampling2d_10 (UpSampling (None, 28, 28, 64)        0
_________________________________________________________________
conv2d_30 (Conv2D)           (None, 28, 28, 1)         577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
È finalmente il momento di addestrare il modello con la funzione fit() di Keras! Il modello si allena per 50 epoche. La funzione fit() restituirà un oggetto history; Memorizzando il risultato di questa funzione in fashion_train, potrai poi utilizzarlo per tracciare il grafico della loss tra training e validazione, che ti aiuterà ad analizzare visivamente le prestazioni del modello.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 48000 samples, validate on 12000 samples
Epoch 1/50
48000/48000 [==============================] - 16s - loss: 0.0368 - val_loss: 0.0132
Epoch 2/50
48000/48000 [==============================] - 15s - loss: 0.0101 - val_loss: 0.0085
Epoch 3/50
48000/48000 [==============================] - 15s - loss: 0.0071 - val_loss: 0.0081
Epoch 4/50
48000/48000 [==============================] - 15s - loss: 0.0057 - val_loss: 0.0056
Epoch 5/50
48000/48000 [==============================] - 15s - loss: 0.0048 - val_loss: 0.0051
Epoch 6/50
48000/48000 [==============================] - 15s - loss: 0.0043 - val_loss: 0.0039
Epoch 7/50
48000/48000 [==============================] - 15s - loss: 0.0038 - val_loss: 0.0039
Epoch 8/50
48000/48000 [==============================] - 15s - loss: 0.0035 - val_loss: 0.0039
Epoch 9/50
48000/48000 [==============================] - 15s - loss: 0.0032 - val_loss: 0.0030
Epoch 10/50
48000/48000 [==============================] - 15s - loss: 0.0030 - val_loss: 0.0029
Epoch 11/50
48000/48000 [==============================] - 15s - loss: 0.0029 - val_loss: 0.0026
Epoch 12/50
48000/48000 [==============================] - 15s - loss: 0.0027 - val_loss: 0.0025
Epoch 13/50
48000/48000 [==============================] - 15s - loss: 0.0026 - val_loss: 0.0028
Epoch 14/50
48000/48000 [==============================] - 15s - loss: 0.0025 - val_loss: 0.0022
Epoch 15/50
48000/48000 [==============================] - 15s - loss: 0.0024 - val_loss: 0.0024
Epoch 16/50
48000/48000 [==============================] - 16s - loss: 0.0023 - val_loss: 0.0027
Epoch 17/50
48000/48000 [==============================] - 15s - loss: 0.0023 - val_loss: 0.0022
Epoch 18/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0025
Epoch 19/50
48000/48000 [==============================] - 16s - loss: 0.0022 - val_loss: 0.0022
Epoch 20/50
48000/48000 [==============================] - 15s - loss: 0.0021 - val_loss: 0.0022
Epoch 21/50
48000/48000 [==============================] - 16s - loss: 0.0021 - val_loss: 0.0020
Epoch 22/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0019
Epoch 23/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0021
Epoch 24/50
48000/48000 [==============================] - 16s - loss: 0.0020 - val_loss: 0.0018
Epoch 25/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 26/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0020
Epoch 27/50
48000/48000 [==============================] - 16s - loss: 0.0019 - val_loss: 0.0017
Epoch 28/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0018
Epoch 29/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 30/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0017
Epoch 31/50
48000/48000 [==============================] - 16s - loss: 0.0018 - val_loss: 0.0019
Epoch 32/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0018
Epoch 33/50
48000/48000 [==============================] - 16s - loss: 0.0017 - val_loss: 0.0017
Epoch 34/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0018
Epoch 35/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0019
Epoch 36/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0016
Epoch 37/50
48000/48000 [==============================] - 15s - loss: 0.0017 - val_loss: 0.0017
Epoch 38/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0019
Epoch 39/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 40/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 41/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0017
Epoch 42/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 43/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0018
Epoch 44/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0015
Epoch 45/50
48000/48000 [==============================] - 15s - loss: 0.0016 - val_loss: 0.0014
Epoch 46/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 47/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0017
Epoch 48/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0015
Epoch 49/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0016
Epoch 50/50
48000/48000 [==============================] - 16s - loss: 0.0015 - val_loss: 0.0020
Finalmente! Hai addestrato il modello su Not-MNIST per 50 epoche. Ora tracciamo il grafico della loss tra dati di training e validazione per visualizzare le prestazioni del modello.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
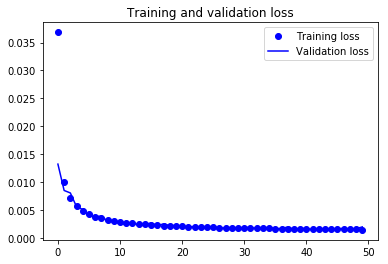
Infine, puoi vedere che la validation loss e la training loss sono entrambe in sincronia. Mostra che il tuo modello non sta facendo overfitting: la validation loss sta diminuendo e non aumentando, e c’è raramente un gap tra training e validation loss.
Pertanto, puoi dire che la capacità di generalizzazione del tuo modello è buona.
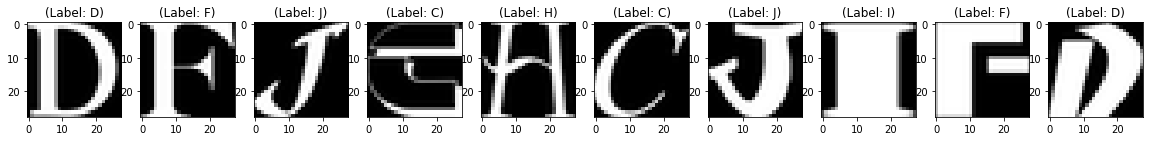
Finalmente è il momento di ricostruire le immagini di test usando la funzione predict() di Keras e vedere quanto bene il tuo modello riesce a ricostruire sui dati di test.
Prevederai con il modello addestrato su tutte le 10.000 immagini di test e traccerai alcune delle immagini ricostruite per visualizzare quanto bene il tuo modello è in grado di ricostruire le immagini di test.
pred = autoencoder.predict(test_data)
pred.shape
(10000, 28, 28, 1)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(10):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
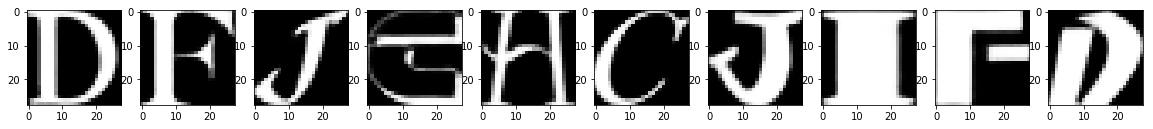
Dalle figure sopra, puoi osservare che il tuo modello ha fatto un lavoro eccellente nel ricostruire le immagini di test che hai previsto usando il modello. Almeno visivamente, le immagini di test e quelle ricostruite sembrano quasi identiche.
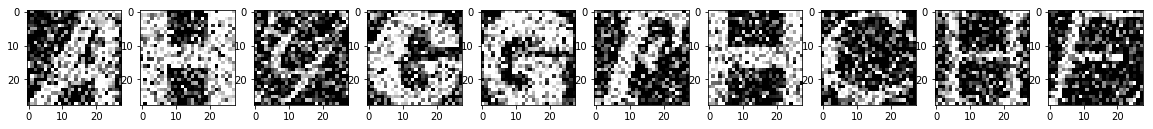
Un denoising autoencoder cerca di apprendere una rappresentazione (spazio latente o collo di bottiglia) robusta al rumore. Aggiungi rumore a un’immagine e poi fornisci l’immagine rumorosa come input alla parte di encooder della tua rete. La parte di encoder dell’autoencoder trasforma l’immagine in uno spazio diverso che cerca di preservare le lettere ma rimuovere il rumore.
Ma come rimuove esattamente il rumore?
Durante l’addestramento, definisci una funzione di loss, simile alla radice dell’errore quadratico medio che avevi definito prima nell’autoencoder convoluzionale. A ogni iterazione dell’addestramento, la rete calcolerà una loss tra l’immagine rumorosa prodotta dal decoder e la ground truth (immagine denoisy) e cercherà anche di minimizzare quella loss o differenza tra l’immagine ricostruita e l’immagine originale priva di rumore. In altre parole, la rete apprenderà uno spazio 7 x 7 x 128 che sarà una codifica priva di rumore dei dati su cui allenerai la rete!
Ora, per vedere come funziona in Python, userai lo stesso dataset NotMNIST che hai usato nella prima parte di questo tutorial. Ciò significa che non è necessario alcun preprocessing dei dati, dato che è già stato fatto prima! Tuttavia, un importante step di preprocessing in questa parte del tutorial sarà aggiungere rumore alle immagini di training, validazione e test. Quindi, facciamolo subito!
Definiamo prima un fattore di rumore che è un iperparametro. Il fattore di rumore viene moltiplicato per una matrice casuale con media 0.0 e deviazione standard 1.0. Questa matrice estrarrà campioni da una distribuzione normale (gaussiana). La forma dell’array normale casuale sarà simile alla forma dei dati a cui aggiungerai il rumore.
Per semplicità, capiamolo con un esempio: la variabile train_X ha forma 48000 x 28 x 28 x 1. Di conseguenza, l’array normale casuale avrà anch’esso una forma simile a train_X; solo così potrai sommare due array, avendo stesse dimensioni.
noise_factor = 0.5
x_train_noisy = train_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=train_X.shape)
x_valid_noisy = valid_X + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=valid_X.shape)
x_test_noisy = test_data + noise_factor * np.random.normal(loc=0.0, scale=1.0, size=test_data.shape)
x_train_noisy = np.clip(x_train_noisy, 0., 1.)
x_valid_noisy = np.clip(x_valid_noisy, 0., 1.)
x_test_noisy = np.clip(x_test_noisy, 0., 1.)
np.clip() metterà a soglia tutti i valori negativi a zero e tutti i valori maggiori di uno a uno. Poiché vuoi che i valori dei pixel siano tra zero e uno. E c’è la possibilità che dopo aver introdotto rumore nei dati l’intervallo dei valori dei pixel cambi un po’, quindi per sicurezza è una buona pratica tagliarli (clip) ai limiti.
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(x_train_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(x_test_noisy[1], (28,28))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7f3ec6b20e48>
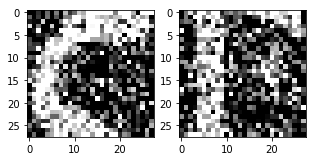
Ora che hai i dati rumorosi, puoi alimentarli nella rete e vedere come il rumore viene "magicamente" rimosso dalle immagini!
Come discusso, l’autoencoder è diviso in due parti: encoder e decoder. L’architettura che costruirai sarà la seguente:
Encoder
Decoder
batch_size = 128
epochs = 20
inChannel = 1
x, y = 28, 28
input_img = Input(shape = (x, y, inChannel))
def autoencoder(input_img):
    #encoder
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    up1 = UpSampling2D((2,2))(conv4)
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1)
    up2 = UpSampling2D((2,2))(conv5)
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2)
    return decoded
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Se ricordi, durante l’addestramento dell’autoencoder convoluzionale avevi fornito le immagini di training due volte poiché input e ground truth erano gli stessi. Tuttavia, nel denoising autoencoder fornisci le immagini rumorose come input mentre la ground truth rimane le immagini denoisy su cui avevi applicato il rumore. Solo così la rete sarà in grado di calcolare una loss tra le immagini rumorose e le vere immagini denoisy.
autoencoder_train = autoencoder.fit(x_train_noisy, train_X, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(x_valid_noisy, valid_X))
Train on 48000 samples, validate on 12000 samples
Epoch 1/20
48000/48000 [==============================] - 15s - loss: 0.0531 - val_loss: 0.0268
Epoch 2/20
48000/48000 [==============================] - 14s - loss: 0.0243 - val_loss: 0.0217
Epoch 3/20
48000/48000 [==============================] - 14s - loss: 0.0207 - val_loss: 0.0200
Epoch 4/20
48000/48000 [==============================] - 14s - loss: 0.0190 - val_loss: 0.0184
Epoch 5/20
48000/48000 [==============================] - 14s - loss: 0.0179 - val_loss: 0.0183
Epoch 6/20
48000/48000 [==============================] - 14s - loss: 0.0171 - val_loss: 0.0178
Epoch 7/20
48000/48000 [==============================] - 14s - loss: 0.0165 - val_loss: 0.0161
Epoch 8/20
48000/48000 [==============================] - 14s - loss: 0.0160 - val_loss: 0.0166
Epoch 9/20
48000/48000 [==============================] - 14s - loss: 0.0157 - val_loss: 0.0157
Epoch 10/20
48000/48000 [==============================] - 14s - loss: 0.0153 - val_loss: 0.0159
Epoch 11/20
48000/48000 [==============================] - 14s - loss: 0.0151 - val_loss: 0.0153
Epoch 12/20
48000/48000 [==============================] - 14s - loss: 0.0148 - val_loss: 0.0154
Epoch 13/20
48000/48000 [==============================] - 14s - loss: 0.0146 - val_loss: 0.0151
Epoch 14/20
48000/48000 [==============================] - 14s - loss: 0.0145 - val_loss: 0.0152
Epoch 15/20
48000/48000 [==============================] - 14s - loss: 0.0143 - val_loss: 0.0163
Epoch 16/20
48000/48000 [==============================] - 14s - loss: 0.0141 - val_loss: 0.0152
Epoch 17/20
48000/48000 [==============================] - 14s - loss: 0.0140 - val_loss: 0.0149
Epoch 18/20
48000/48000 [==============================] - 14s - loss: 0.0139 - val_loss: 0.0153
Epoch 19/20
48000/48000 [==============================] - 14s - loss: 0.0138 - val_loss: 0.0152
Epoch 20/20
48000/48000 [==============================] - 14s - loss: 0.0137 - val_loss: 0.0150
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(epochs)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
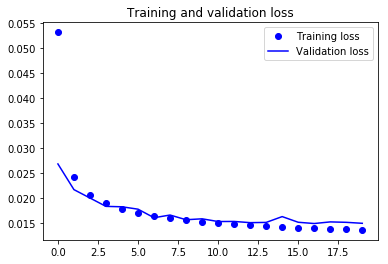
Dal grafico sopra, puoi intuire che il modello va in overfitting in alcune epoche pur restando in sincronia per la maggior parte del tempo. Puoi sicuramente provare a migliorare le prestazioni del modello introducendo un po’ di complessità così che la loss possa ridursi ulteriormente; prova ad addestrarlo per più epoche e poi decidi.
pred = autoencoder.predict(x_test_noisy)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(test_data[i, ..., 0], cmap='gray')
    curr_lbl = test_labels[i]
    plt.title("(Label: " + str(label_dict[curr_lbl]) + ")")
plt.show()
plt.figure(figsize=(20, 4))
print("Test Images with Noise")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(x_test_noisy[i, ..., 0], cmap='gray')
plt.show()

plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(10,20,1):
    plt.subplot(2, 10, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
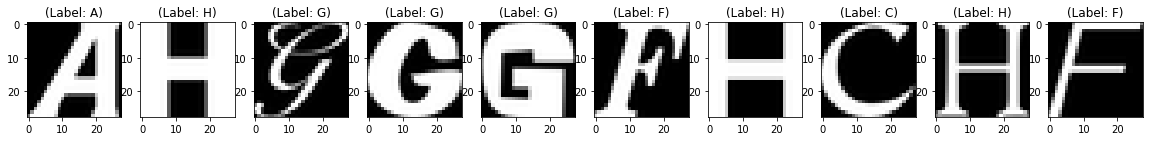
Test Images with Noise
Reconstruction of Noisy Test Images
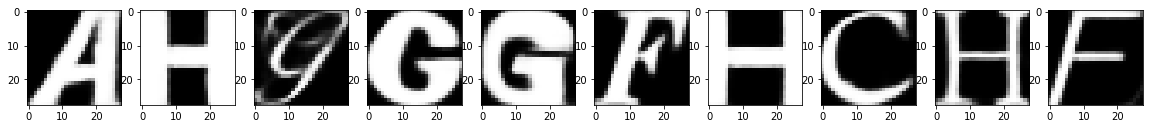
Sembra che, in sole 20 epoche, un’architettura di rete piuttosto semplice abbia fatto un ottimo lavoro nel rimuovere il rumore dalle immagini di test, non ti pare?
Questo tutorial è stato un buon punto di partenza per capire gli autoencoder sia teoricamente che praticamente. Se sei riuscito a seguirlo facilmente o anche con un po’ di impegno, ben fatto! Dai un’occhiata al tutorial di DataCamp Keras Tutorial: Deep Learning in Python e Introduction to Deep Learning in Python.
Nel prossimo tutorial, imparerai a leggere immagini da zero, analizzarle, preprocessarle e fornirle al modello usando un dataset di impronte digitali. Imparerai anche a leggere immagini mediche di modalità T-1 e a ricostruirle con un autoencoder!
C’è ancora molto da coprire, quindi perché non seguire il corso di DataCamp Deep Learning in Python? Se non l’hai già fatto. Partirai dalle basi e passerai gradualmente a padroneggiare il deep learning: sarà senza dubbio una risorsa indispensabile quando imparerai a lavorare con le reti neurali convoluzionali in Python, a rilevare volti, oggetti, ecc.
Scopri di più su Python e Keras
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



