Pendahuluan
Pandas adalah alat yang sangat kuat dalam ekosistem sains data Python, menawarkan berbagai kemampuan manipulasi dan pembersihan data. Namun, meskipun sangat baik untuk dataset berukuran menengah, pandas dapat menghadapi masalah performa ketika berurusan dengan dataset besar, sehingga memunculkan kebutuhan akan alternatif berkinerja tinggi.
Artikel komprehensif ini memperkenalkan beberapa alternatif tersebut dan membandingkannya melalui benchmarking dalam hal waktu pemuatan data, waktu eksekusi, penggunaan memori, skalabilitas, dan kemudahan penggunaan.
Catatan: Hasil benchmarking sangat bervariasi tergantung pada konfigurasi perangkat keras Anda.
Memahami Benchmark
Benchmark adalah titik acuan yang digunakan untuk membandingkan perangkat lunak atau perangkat keras dalam evaluasi performa. Acuan ini relevan dalam optimasi performa perangkat lunak karena memungkinkan kita mengukur efisiensi berbagai metode, algoritme, atau alat. Dalam konteks ini, metrik kunci untuk benchmarking pustaka manipulasi data mencakup waktu eksekusi, penggunaan memori, skalabilitas, dan kemudahan penggunaan.
Pengenalan Alternatif Berkinerja Tinggi
Alat alternatif utama di Python adalah Polars, Vaex, dan Datatable. Sebelum masuk ke analisis perbandingan, mari kita lihat sekilas apa masing-masing alat ini.
Polars
Polars dapat dijelaskan melalui tiga fitur kunci. Pertama, Polars menawarkan API Python yang komprehensif dengan banyak fungsi untuk menangani DataFrame. Kedua, Polars dapat berfungsi ganda — dapat digunakan sebagai pustaka untuk DataFrame atau sebagai mesin kueri dasar untuk model data. Terakhir, dengan menggabungkan implementasi Arrow2 yang aman dari spesifikasi Apache Arrow, Polars menjadi alat yang sangat efisien untuk memproses data dalam jumlah besar.
Anda dapat melihat tutorial pengantar Polars kami, serta perbandingan antara pandas 2.0 dan Polars.
Vaex
Vaex ditujukan untuk DataFrame lazy dan out-of-core (mirip dengan Pandas) guna memvisualisasikan dan mengeksplorasi dataset tabular besar. Vaex bisa sangat efisien karena menunda operasi hingga diperlukan (lazy evaluation), sehingga mengurangi penggunaan memori dan waktu.
Datatable
Datatable dapat digunakan untuk pemrosesan data besar (hingga 100GB) pada mesin satu node dengan kecepatan maksimum. Salah satu fitur penting Datatable adalah interoperabilitasnya dengan Pandas/NumPy/Python murni, yang memungkinkan pengguna dengan mudah beralih ke kerangka kerja pemrosesan data lainnya.
Untuk mempelajari lebih lanjut tentang pandas, Tutorial pandas DataFrame di Python kami merupakan titik awal yang baik.
Selain itu, Pandas Cheat Sheet untuk Data Science di Python memberikan panduan cepat mengenai dasar-dasar pustaka analisis data Python, lengkap dengan contoh kode.
Menyiapkan Lingkungan Benchmarking
Bagian ini membahas pembuatan data benchmarking dan pemasangan semua pustaka yang terlibat dalam analisis benchmarking.
Data benchmarking
Set benchmarking berukuran 5,7 GB, yang cukup besar untuk melakukan perbandingan yang layak. Setiap baris diduplikasi sebanyak 100000 kali, menghasilkan 76.800.000 baris. Data diabetes adalah data asli yang digunakan dan tersedia gratis di Kaggle.
Notebook benchmarking final tersedia di GitHub.
import pandas as pd

data_URL = "https://raw.githubusercontent.com/keitazoumana/Experimentation-Data/main/diabetes.csv"

original_data = pd.read_csv(data_URL)

# Duplicate each row 100000 times
benchmarking_df = original_data.loc[original_data.index.repeat(100000)]

# Save the result as a CSV file for future use.
file_name = "benchmarking_data.csv"

benchmarking_df.to_csv(file_name, index=False)
Instalasi pustaka
Sekarang, kita dapat melanjutkan dengan pemasangan semua pustaka yang terlibat dalam analisis benchmarking.
Dari lingkungan Jupyter notebook, semua pemasangan dilakukan menggunakan perintah pip install sebagai berikut:
%%bash
pip3 -q install -U polars
pip3 -q install vaex
pip -q install datatable
Setelah berhasil menjalankan blok kode di atas, kita dapat mengimpornya dengan pernyataan import:
import pandas as pd
from time import time
import polars as pl
import vaex as vx
import datatable as dt
Selain itu, kami menggunakan pustaka plotly untuk keperluan visualisasi.
import plotly.express as pxSekarang semuanya siap untuk melanjutkan analisis benchmarking.
Benchmarking Waktu Eksekusi
Waktu eksekusi akan dievaluasi untuk operasi berikut: pemuatan data, offloading data, agregasi data, dan penyaringan data. Sebuah fungsi pembantu diterapkan untuk setiap tugas dan akan mengembalikan kamus dengan dua kunci utama: nama pustaka dan waktu eksekusi.
Fungsi plot metrics kemudian digunakan untuk menampilkan hasil secara grafis menggunakan pustaka Plotly Express. Fungsi ini memiliki dua parameter: daftar semua kamus dari fungsi pembantu sebelumnya dan judul grafik yang dihasilkan.
def plot_metrics(list_exec_time, graph_title):

	df = pd.DataFrame(list_exec_time)

	fig = px.bar(df, x='library', y= 'execution_time', title=graph_title)

	fig.show()
Pemuatan data
Fungsi pembantu read_csv_with_time memiliki dua parameter utama: nama file yang akan dibaca dan nama pustaka.
def read_csv_with_time(library_name, file_name):

	final_time = 0

	start_time = time.time()

	if library_name.lower() == 'polars':
    	df = pl.read_csv(file_name)

	elif library_name.lower() == 'pandas':
    	df = pd.read_csv(file_name)

	elif library_name.lower() == 'vaex':
    	df = vx.read_csv(file_name)

	elif library_name.lower() == 'datatable':
    	df = dt.fread(file_name)

	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'pandas', 'vaex', or 'datatable'")

	end_time = time.time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
Fungsi tersebut dapat diterapkan menggunakan masing-masing pustaka, dimulai dengan pandas.
pandas_time, pandas_df = read_csv_with_time('pandas', file_name)
polars_time, polars_df = read_csv_with_time('polars', file_name)
vaex_time, vaex_df = read_csv_with_time('vaex', file_name)
datatable_time, dt_df = read_csv_with_time('datatable', file_name)
Hasil kamus dapat digabungkan sebagai sebuah daftar dan diplot menggunakan ekspresi berikut.
exec_times = [pandas_time, polars_time,
           vaex_time, datatable_time]

def plot_metrics(list_exec_time, graph_title):

 [print(exec_time) for exec_time in list_exec_time]
 df = pd.DataFrame(exec_times)

 # Plot bar plot using Plotly Express
 fig = px.bar(df, x='library', y='execution_time', title=graph_title)
 fig.show()

plot_metrics(exec_times, "Read Execution Time Comparison")
{'library': 'pandas', 'execution_time': 35.07908916473389}
{'library': 'polars', 'execution_time': 6.041005373001099}
{'library': 'vaex', 'execution_time': 36.431522607803345}
{'library': 'datatable', 'execution_time': 4.4584901332855225}Format kamus untuk waktu eksekusi saat pemuatan data
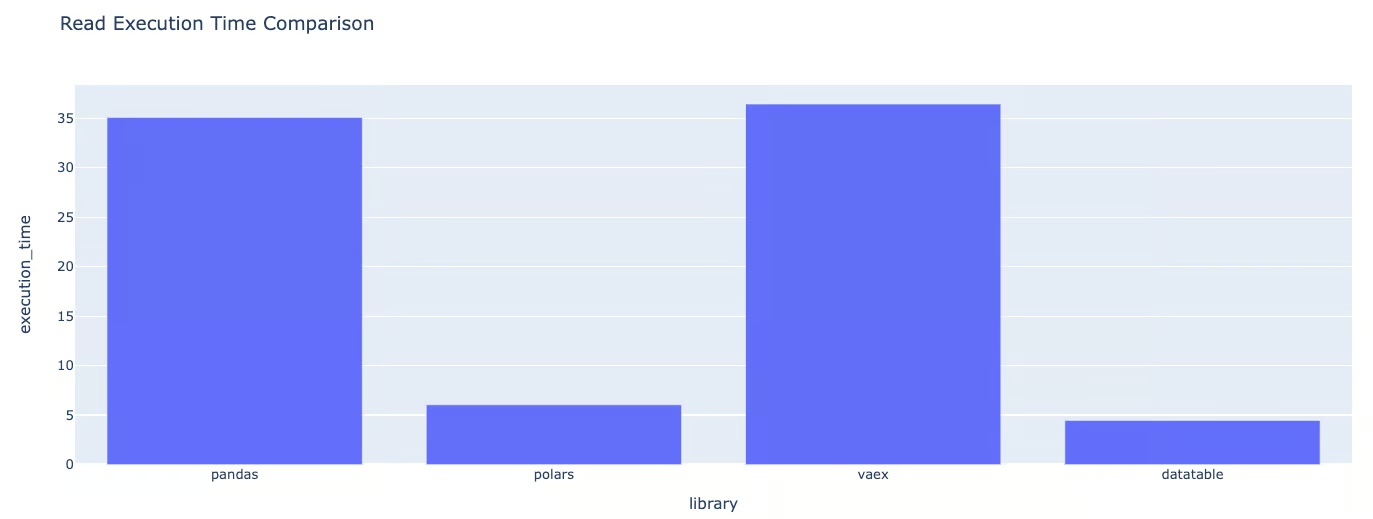
Format grafik untuk waktu eksekusi saat pemuatan data
Berdasarkan grafik, kita dapat menyimpulkan bahwa Polars:
- Polars 1,35 kali lebih lambat daripada Datatable
- Pandas 7,87 kali lebih lambat daripada DataTable.
- Vaex kira-kira 8,17 kali lebih lambat daripada DataTable.
Pengelompokan data
Serupa, group_data_with_time bertugas melacak waktu eksekusi untuk mengelompokkan kolom yang diberikan sebagai parameter. Dalam kasus ini, kita menggunakan kolom Pregnancies.
from time import time

def group_data_with_time(library_name, df, column_name='Pregnancies'):

 start_time = time()

 if library_name.lower() == 'polars':
     df_grouped = df.group_by(column_name).first()

 elif library_name.lower() == 'vaex':
     df_grouped = df.groupby(column_name, agg='first')

 elif library_name.lower() == 'pandas':
     df_grouped = df.groupby(column_name).first()

 elif library_name.lower() == 'datatable':
     df_grouped = df[:, dt.first(dt.f[:]), dt.by(column_name)]

 else:
     raise ValueError("Invalid library name. Must be 'polars', 'vaex', or 'datatable'")

 end_time = time()

 final_time = end_time - start_time

 return {"library": library_name, "execution_time": final_time}
pandas_time = group_data_with_time('pandas', pandas_df)
polars_time = group_data_with_time('polars', polars_df)
vaex_time = group_data_with_time('vaex', vaex_df)
datatable_time = group_data_with_time('datatable', dt_df)exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Grouping Execution Time Comparison"){'library': 'pandas', 'execution_time': 2.382519245147705}
{'library': 'pandas', 'execution_time'': 1.0898876190185547}
{'library': 'pandas', 'execution_time': 0.8506548404693604}
{'library': 'pandas', 'execution_time': 0.34698963165283203}
Format grafik untuk waktu eksekusi saat pengelompokan data
Untuk tugas pengelompokan data yang diperbarui, dengan membandingkan pustaka tercepat DataTable dengan yang lain:
Kita dapat melihat bahwa DataTable adalah yang tercepat di antara pustaka yang dievaluasi.
- Vaex 2,45 kali lebih lambat daripada DataTable.
- Polars 3,14 kali lebih lambat daripada DataTable.
- Pandas 6,87 kali lebih lambat daripada DataTable.
Analisis ini menunjukkan efisiensi superior DataTable untuk tugas pengelompokan data, dengan Vaex relatif mendekati dari sisi performa. Polars dan Pandas menunjukkan waktu eksekusi yang serupa, keduanya jauh lebih lambat daripada DataTable.
Pengurutan Kolom
Dengan pendekatan yang sama, fungsi pengurutan kolom mengurutkan kolom yang diberikan menggunakan masing-masing pustaka.
def sort_data_with_time(library_name, df, column_name='Pregnancies'):

	start_time = time()

	if library_name.lower() == 'polars':
    	df_sorted = df.sort(column_name)
	elif library_name.lower() == 'vaex':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'datatable':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'pandas':
    	df_sorted = pd.DataFrame(df).sort_values(column_name)
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
pandas_time = sort_data_with_time('pandas', pandas_df)
polars_time = sort_data_with_time('polars', polars_df)
vaex_time = sort_data_with_time('vaex', vaex_df)
datatable_time = sort_data_with_time('datatable', dt_df){'library': 'pandas', 'execution_time': 6.735127687454224}
{'library': 'polars', 'execution_time': 4.119458436965942}
{'library': 'vaex', 'execution_time': 1.0371737480163574}
{'library': 'datatable', 'execution_time': 0.3971593379974365}Format kamus untuk waktu eksekusi saat pengurutan data
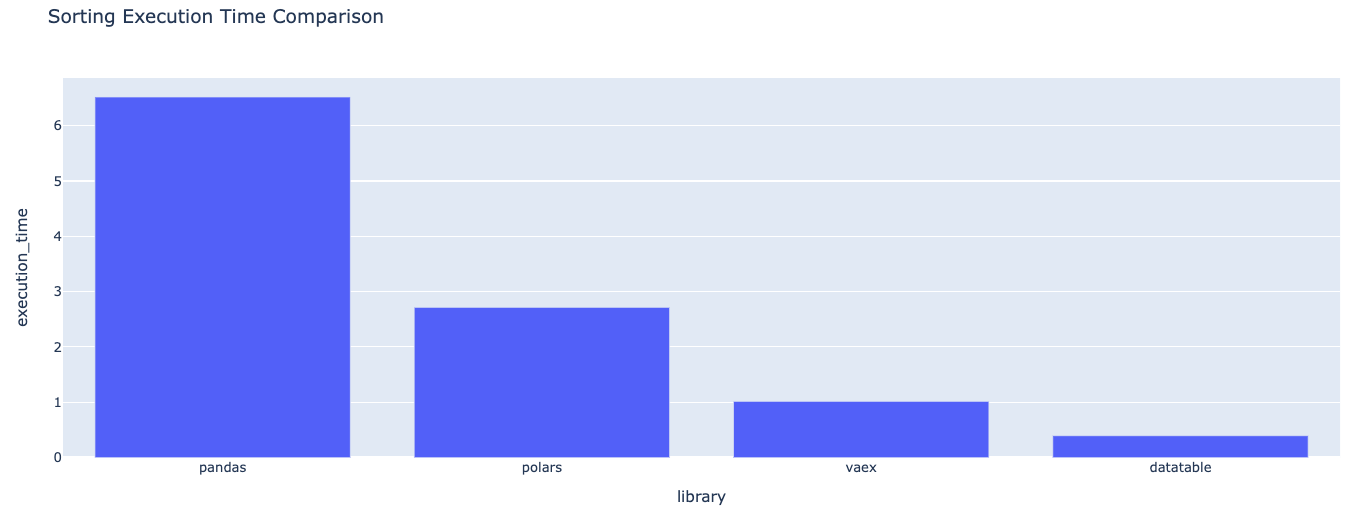
Format grafik untuk waktu eksekusi saat pengurutan data
Untuk tugas pengurutan data, DataTable adalah yang tercepat di antara pustaka yang dievaluasi.
- Vaex 2,61 kali lebih lambat daripada DataTable.
- Polars 10,37 kali lebih lambat daripada DataTable.
- Pandas 16,96 kali lebih lambat daripada DataTable.
Analisis ini menunjukkan performa superior DataTable dalam menangani tugas pengurutan data, secara signifikan melampaui Vaex, Polars, dan Pandas, dengan Vaex menjadi yang paling dekat dari sisi performa namun tetap lebih dari dua kali lebih lambat.
Offloading Data
Dengan offloading data, idenya adalah mengonversi data asli ke format lain, yang dalam skenario khusus ini adalah array numpy.
def offload_data_with_time(library_name, df):

	start_time = time()

	if library_name.lower() == 'polars':
    	array = df.to_numpy()

	elif library_name.lower() == 'vaex':
    	array = df.to_pandas_df().values

	elif library_name.lower() == 'datatable':
    	array = df.to_numpy()

	elif library_name.lower() == 'pandas':
    	array = pd.DataFrame(df).values
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Data offloading Execution Time Comparison"){'library': 'pandas', 'execution_time': 1.8406445980072021}
{'library': 'polars', 'execution_time': 3.238591432571411}
{'library': 'vaex', 'execution_time': 6.945307970046997}
{'library': 'datatable', 'execution_time': 2.634136438369751}Format kamus untuk waktu eksekusi saat offloading data
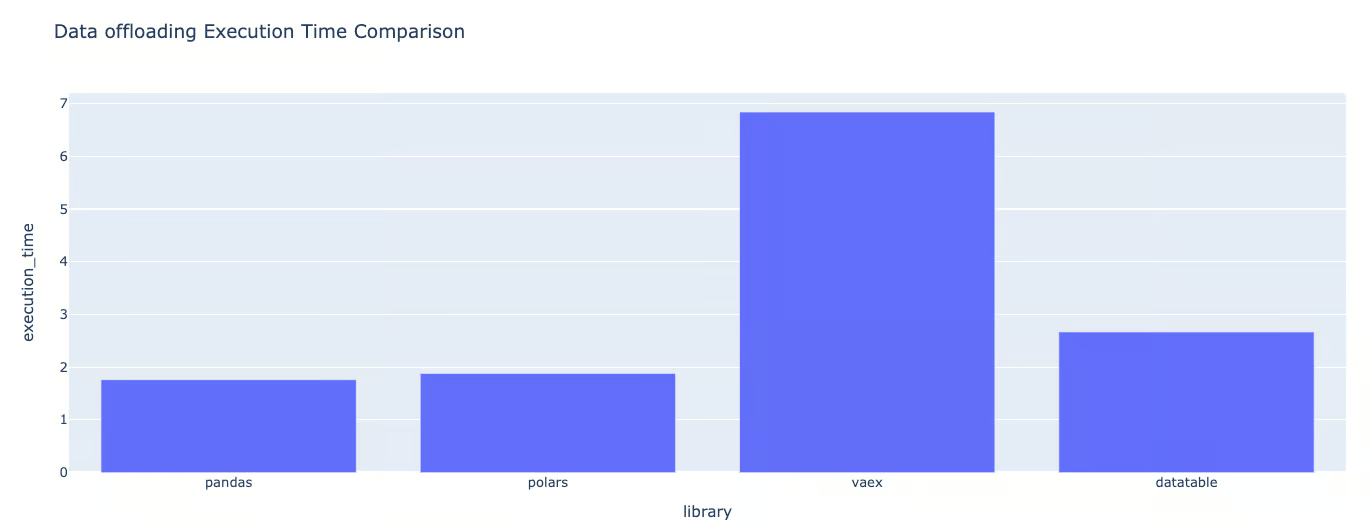
Format grafik untuk waktu eksekusi saat offloading data
Offloading data adalah putaran terakhir dari benchmarking untuk waktu eksekusi.
Kali ini, Vaex memiliki waktu eksekusi tertinggi. Dibandingkan dengan pustaka ini, kita dapat melihat bahwa waktu eksekusi pandas kira-kira:
- DataTable 1,43 kali lebih lambat daripada Pandas.
- Polars 1,76 kali lebih lambat daripada Pandas.
- Vaex 3,77 kali lebih lambat daripada Pandas.
Benchmarking Penggunaan Memori
Waktu eksekusi bukan satu-satunya kriteria saat membandingkan berbagai pustaka. Mengetahui seberapa efisien pustaka tersebut mengelola memori juga penting untuk dipertimbangkan. Bagian ini menampilkan dua jenis penggunaan memori menggunakan pustaka tracemalloc:
- Penggunaan memori saat ini. Total memori yang digunakan selama eksekusi menggunakan pustaka tertentu. Ini sesuai dengan ruang RAM yang ditempati saat itu.
- Puncak penggunaan memori. Merupakan jumlah maksimum memori yang digunakan oleh program. Penting untuk diketahui bahwa puncak memori selalu lebih tinggi daripada memori saat ini.
Memiliki visualisasi ini membantu memahami program mana yang menggunakan begitu banyak memori hingga menyebabkan kesalahan kehabisan memori, terutama saat bekerja dengan dataset besar.
Selain tracemalloc, pustaka os juga diperlukan.
import tracemalloc as tm
import os
Sebelum memulai, kita membuat daftar kosong yang akan menampung hasil setiap nilai penggunaan memori.
list_memory_usage = []Untuk setiap pustaka, estimasi penggunaan memori dilakukan dengan sintaks umum di bawah ini yang sesuai dengan eksekusi menggunakan pustaka Vaex. Selain itu, fokusnya hanya pada penggunaan memori untuk tugas offloading data.
tm.start()
vaex_time = offload_data_with_time('vaex', vaex_df)
memory_usage = tm.get_traced_memory()
tm.stop()

list_memory_usage.append({
	'library': 'vaex',
	'memory_usage': memory_usage
})
Sintaksnya sama untuk pustaka lainnya, dan kita mendapatkan instruksi berikut, masing-masing untuk Polars, pandas, dan Datatable:
tm.start()
polars_time = offload_data_with_time('polars', polars_df)
memory_usage = tm.get_traced_memory()

tm.stop()

list_memory_usage.append({
	'library': 'polars',
	'memory_usage': memory_usage
})
tm.start()
offload_data_with_time('pandas', pandas_df)
# Get the memory usage
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'pandas',
'memory_usage': memory_usage
})tm.start()
datatable_time = offload_data_with_time('datatable', datatable_df)
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'datatable',
'memory_usage': memory_usage
})Setelah menjalankan semua kode sebelumnya, kita dapat memplot grafik menggunakan fungsi pembantu di bawah ini:
def plot_memory_usage(list_memory_usage, graph_title='Memory Usage by Library'):

	df = pd.DataFrame(list_memory_usage)

	# separate the memory usage tuple into two columns: current_memory and peak_memory
	df[['current_memory', 'peak_memory']] = pd.DataFrame(df['memory_usage'].tolist(), index=df.index)

	# now we no longer need the memory_usage column
	df = df.drop(columns='memory_usage')

	# melt the DataFrame to make it suitable for grouped bar chart
	df_melted = df.melt(id_vars='library', var_name='memory_type', value_name='memory')

	# create the grouped bar chart
	fig = px.bar(df_melted, x='library', y='memory', color='memory_type', barmode='group',
             	labels={'memory':'Memory Usage (bytes)', 'library':'Library', 'memory_type':'Memory Type'},
             	title=graph_title)

	fig.update_layout(yaxis_type="log")
	fig.show()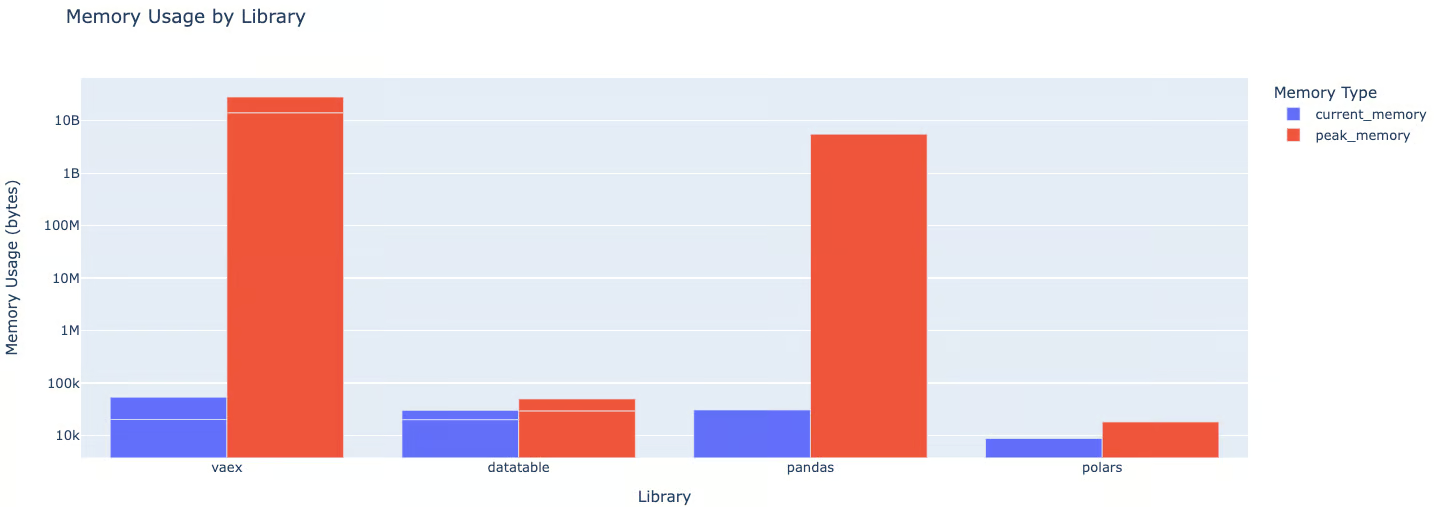
Kita dapat mencatat bahwa:
- Pandas menggunakan sekitar 1100 kali lebih banyak memori saat ini daripada Polars, 7,4 kali lebih banyak daripada Vaex, dan 29,4 kali lebih banyak daripada Datatable.
- Untuk puncak penggunaan memori, baik pandas maupun Vaex menggunakan sekitar 963K kali lebih banyak memori daripada Polars dan 131K kali lebih banyak daripada Datatable.
Analisis lebih lanjut, seperti perbandingan kecepatan Dask vs pandas, dapat memberikan gambaran yang lebih luas.
Tabel Perbandingan Alternatif Pandas
Di bawah ini, kami merangkum temuan kami ke dalam tabel perbandingan, yang menunjukkan perbedaan antara Polars, Vaex, dan Datatables:
|
Kriteria Benchmark |
Polars |
Vaex |
Datatable |
|
Waktu Pemuatan Data |
Lebih cepat dari Vaex, lebih lambat dari Datatable |
Lebih lambat dari Polars dan Datatable |
Paling cepat di antara ketiganya |
|
Waktu Pengelompokan Data |
Paling lambat di antara ketiganya |
Lebih cepat dari Polars, lebih lambat dari Datatable |
Paling cepat di antara ketiganya |
|
Waktu Pengurutan Data |
Lebih cepat dari Vaex, lebih lambat dari Datatable |
Lebih lambat dari Polars dan Datatable |
Paling cepat di antara ketiganya |
|
Waktu Offloading Data |
Lebih cepat dari Vaex, lebih lambat dari Datatable |
Paling lambat di antara ketiganya |
Lebih cepat dari Polars, lebih lambat dari Vaex |
|
Penggunaan Memori Saat Ini |
Paling sedikit menggunakan memori |
Menggunakan lebih banyak memori daripada Polars namun lebih sedikit dari Datatable |
Paling banyak menggunakan memori di antara ketiganya |
|
Puncak Penggunaan Memori |
Paling sedikit menggunakan memori |
Menggunakan lebih banyak memori daripada Polars namun lebih sedikit dari Datatable |
Paling banyak menggunakan memori di antara ketiganya |
|
Skalabilitas |
Skalabel terhadap ukuran data |
Skalabel terhadap ukuran data, tetapi dapat menggunakan lebih banyak memori seiring pertambahan ukuran data |
Sangat skalabel terhadap ukuran data |
|
Kemudahan penggunaan |
Memiliki API Python lengkap dan kompatibel dengan Apache Arrow |
Menggunakan lazy evaluation dan kompatibel dengan Pandas |
Menawarkan interoperabilitas dengan Pandas/NumPy/Python murni |
Kesimpulan
Berbagai faktor harus dipertimbangkan saat melakukan analisis skalabilitas dan kemudahan integrasi. Benchmarking kami menyoroti bahwa meskipun pandas sudah matang dan mudah digunakan serta memiliki kurva pembelajaran yang lebih curam, pandas tidak efisien menangani dataset besar.
Namun, ada berbagai cara yang dapat diterapkan untuk mempercepat pandas, dan High-Performance Data Manipulation in Python: Pandas 2.0 vs Polars kami dapat membantu.
Performa Vaex bervariasi tergantung pada tugas. Jadi, memilih alternatif untuk Pandas bergantung pada kebutuhan spesifik pengguna, ukuran dataset, serta kemampuan mereka dalam menghadapi kurva pembelajaran dan integrasi.





