Introduction
Pandas est un outil extrêmement puissant dans l’écosystème data science de Python, offrant de vastes capacités de manipulation et de nettoyage de données. Toutefois, s’il excelle sur des jeux de données de taille moyenne, il peut rencontrer des limites de performance à grande échelle, d’où l’intérêt d’alternatives plus performantes.
Cet article passe en revue plusieurs de ces alternatives et les compare via un benchmark selon le temps de chargement des données, le temps d’exécution, l’usage mémoire, l’évolutivité et la facilité d’utilisation.
Remarque : les résultats de benchmark varient fortement selon votre configuration matérielle.
Comprendre les benchmarks
Un benchmark sert de point de référence pour comparer des logiciels ou du matériel en termes de performance. En optimisation logicielle, il permet de mesurer l’efficience de différentes méthodes, algorithmes ou outils. Dans ce contexte, les indicateurs clés pour évaluer des bibliothèques de manipulation de données incluent le temps d’exécution, l’usage mémoire, l’évolutivité et la facilité d’utilisation.
Tour d’horizon des alternatives hautes performances
Les principales alternatives en Python sont Polars, Vaex et Datatable. Avant d’entrer dans la comparaison, voici un aperçu rapide de chacune.
Polars
Trois caractéristiques définissent Polars. D’abord, une API Python complète, riche en fonctions pour manipuler des DataFrames. Ensuite, une double vocation : agir comme bibliothèque de DataFrames ou moteur de requêtes sous-jacent à des modèles de données. Enfin, grâce à l’implémentation sécurisée Arrow2 de la spécification Apache Arrow, Polars traite de grands volumes de données avec une efficacité remarquable.
Consultez notre tutoriel introduction à Polars, ainsi qu’une comparaison entre pandas 2.0 et Polars.
Vaex
Vaex propose des DataFrames paresseux, « out-of-core » (proches de pandas) pour visualiser et explorer de grands tableaux de données. Son évaluation paresseuse diffère l’exécution au dernier moment, ce qui réduit l’usage mémoire et le temps.
Datatable
Datatable permet de traiter de très grands volumes (jusqu’à 100 Go) sur une machine mono-nœud à la vitesse maximale possible. Un atout majeur : son interopérabilité avec Pandas/NumPy/Python pur, qui facilite la conversion vers d’autres cadres de traitement.
Pour approfondir pandas, notre tutoriel pandas : DataFrames en Python est un excellent point de départ.
La pandas Cheat Sheet for Data Science in Python fournit également un mémo des bases avec des exemples de code.
Mise en place de l’environnement de benchmark
Cette section couvre la création des données de benchmark et l’installation des bibliothèques utilisées dans l’analyse.
Données de benchmark
L’ensemble de données de benchmark pèse 5,7 Go, suffisant pour une comparaison pertinente. Chaque ligne a été dupliquée 100000 fois, pour un total de 76 800 000 lignes. Les données Diabetes d’origine, utilisées ici, sont librement disponibles sur Kaggle.
Le notebook final de benchmark est disponible sur GitHub.
import pandas as pd

data_URL = "https://raw.githubusercontent.com/keitazoumana/Experimentation-Data/main/diabetes.csv"

original_data = pd.read_csv(data_URL)

# Duplicate each row 100000 times
benchmarking_df = original_data.loc[original_data.index.repeat(100000)]

# Save the result as a CSV file for future use.
file_name = "benchmarking_data.csv"

benchmarking_df.to_csv(file_name, index=False)
Installation des bibliothèques
Nous pouvons maintenant installer toutes les bibliothèques impliquées dans le benchmark.
Depuis un environnement Jupyter Notebook, l’installation se fait via pip install comme suit :
%%bash
pip3 -q install -U polars
pip3 -q install vaex
pip -q install datatable
Après exécution réussie du bloc ci-dessus, importez-les ainsi :
import pandas as pd
from time import time
import polars as pl
import vaex as vx
import datatable as dt
Nous utiliserons également la bibliothèque plotly pour la visualisation.
import plotly.express as pxTout est prêt pour lancer le benchmark.
Benchmark du temps d’exécution
Le temps d’exécution sera évalué pour : le chargement, l’export (« offloading »), l’agrégation et le filtrage des données. Une fonction utilitaire est définie pour chaque tâche et renvoie un dictionnaire avec deux clés principales : le nom de la bibliothèque et le temps d’exécution.
La fonction de tracé des métriques est ensuite utilisée pour représenter les résultats graphiquement via Plotly Express. Elle prend en paramètres la liste des dictionnaires renvoyés et le titre du graphique.
def plot_metrics(list_exec_time, graph_title):

	df = pd.DataFrame(list_exec_time)

	fig = px.bar(df, x='library', y= 'execution_time', title=graph_title)

	fig.show()
Chargement des données
La fonction utilitaire read_csv_with_time prend deux paramètres : le nom du fichier à lire et le nom de la bibliothèque.
def read_csv_with_time(library_name, file_name):

	final_time = 0

	start_time = time.time()

	if library_name.lower() == 'polars':
    	df = pl.read_csv(file_name)

	elif library_name.lower() == 'pandas':
    	df = pd.read_csv(file_name)

	elif library_name.lower() == 'vaex':
    	df = vx.read_csv(file_name)

	elif library_name.lower() == 'datatable':
    	df = dt.fread(file_name)

	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'pandas', 'vaex', or 'datatable'")

	end_time = time.time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
On applique ensuite la fonction à chaque bibliothèque, en commençant par pandas.
pandas_time, pandas_df = read_csv_with_time('pandas', file_name)
polars_time, polars_df = read_csv_with_time('polars', file_name)
vaex_time, vaex_df = read_csv_with_time('vaex', file_name)
datatable_time, dt_df = read_csv_with_time('datatable', file_name)
Les dictionnaires obtenus sont combinés en liste puis tracés comme suit.
exec_times = [pandas_time, polars_time,
           vaex_time, datatable_time]

def plot_metrics(list_exec_time, graph_title):

 [print(exec_time) for exec_time in list_exec_time]
 df = pd.DataFrame(exec_times)

 # Plot bar plot using Plotly Express
 fig = px.bar(df, x='library', y='execution_time', title=graph_title)
 fig.show()

plot_metrics(exec_times, "Read Execution Time Comparison")
{'library': 'pandas', 'execution_time': 35.07908916473389}
{'library': 'polars', 'execution_time': 6.041005373001099}
{'library': 'vaex', 'execution_time': 36.431522607803345}
{'library': 'datatable', 'execution_time': 4.4584901332855225}Format dictionnaire des temps d’exécution pour le chargement
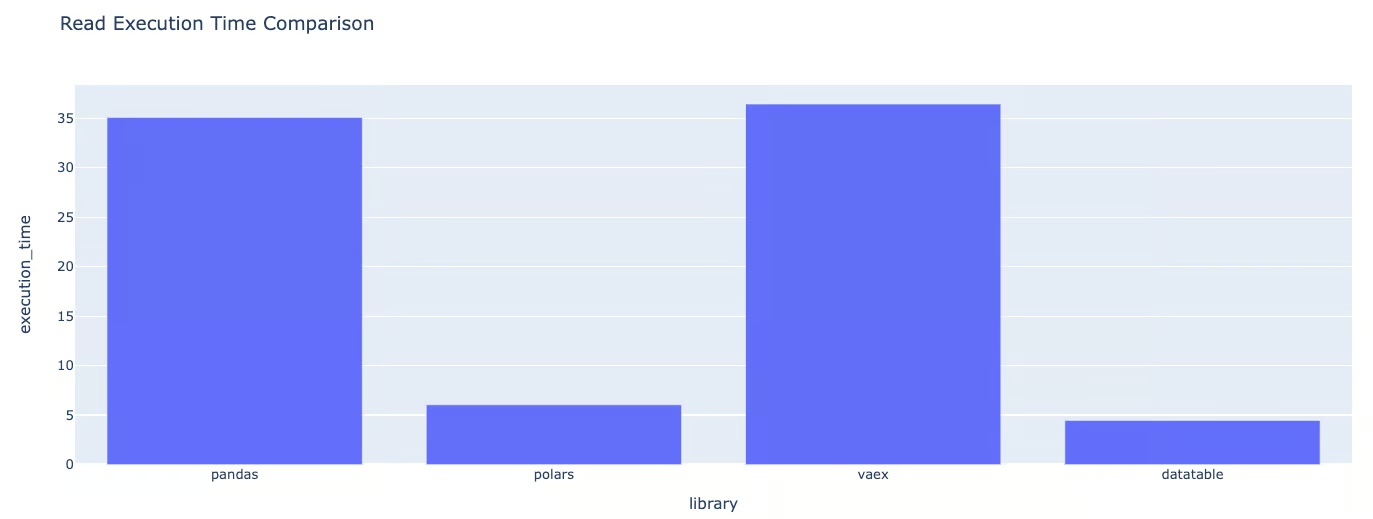
Représentation graphique des temps d’exécution pour le chargement
Selon le graphique, nous pouvons conclure :
- Polars est 1,35 fois plus lent que Datatable.
- Pandas est 7,87 fois plus lent que Datatable.
- Vaex est environ 8,17 fois plus lent que Datatable.
Regroupement des données
De même, group_data_with_time mesure le temps d’exécution pour regrouper selon la colonne passée en paramètre. Ici, nous utilisons la colonne Pregnancies.
from time import time

def group_data_with_time(library_name, df, column_name='Pregnancies'):

 start_time = time()

 if library_name.lower() == 'polars':
     df_grouped = df.group_by(column_name).first()

 elif library_name.lower() == 'vaex':
     df_grouped = df.groupby(column_name, agg='first')

 elif library_name.lower() == 'pandas':
     df_grouped = df.groupby(column_name).first()

 elif library_name.lower() == 'datatable':
     df_grouped = df[:, dt.first(dt.f[:]), dt.by(column_name)]

 else:
     raise ValueError("Invalid library name. Must be 'polars', 'vaex', or 'datatable'")

 end_time = time()

 final_time = end_time - start_time

 return {"library": library_name, "execution_time": final_time}
pandas_time = group_data_with_time('pandas', pandas_df)
polars_time = group_data_with_time('polars', polars_df)
vaex_time = group_data_with_time('vaex', vaex_df)
datatable_time = group_data_with_time('datatable', dt_df)exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Grouping Execution Time Comparison"){'library': 'pandas', 'execution_time': 2.382519245147705}
{'library': 'pandas', 'execution_time'': 1.0898876190185547}
{'library': 'pandas', 'execution_time': 0.8506548404693604}
{'library': 'pandas', 'execution_time': 0.34698963165283203}
Représentation graphique des temps d’exécution pour le regroupement
Pour cette tâche de regroupement, en comparant la bibliothèque la plus rapide, Datatable, aux autres :
Datatable ressort comme la plus rapide parmi les bibliothèques évaluées.
- Vaex est 2,45 fois plus lent que Datatable.
- Polars est 3,14 fois plus lent que Datatable.
- Pandas est 6,87 fois plus lent que Datatable.
Cette analyse met en évidence la supériorité de Datatable pour le regroupement, avec Vaex relativement proche. Polars et pandas affichent des temps comparables, tous deux nettement plus lents que Datatable.
Tri de colonnes
Avec la même approche, la fonction de tri ordonne la colonne indiquée dans chaque bibliothèque.
def sort_data_with_time(library_name, df, column_name='Pregnancies'):

	start_time = time()

	if library_name.lower() == 'polars':
    	df_sorted = df.sort(column_name)
	elif library_name.lower() == 'vaex':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'datatable':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'pandas':
    	df_sorted = pd.DataFrame(df).sort_values(column_name)
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
pandas_time = sort_data_with_time('pandas', pandas_df)
polars_time = sort_data_with_time('polars', polars_df)
vaex_time = sort_data_with_time('vaex', vaex_df)
datatable_time = sort_data_with_time('datatable', dt_df){'library': 'pandas', 'execution_time': 6.735127687454224}
{'library': 'polars', 'execution_time': 4.119458436965942}
{'library': 'vaex', 'execution_time': 1.0371737480163574}
{'library': 'datatable', 'execution_time': 0.3971593379974365}Format dictionnaire des temps d’exécution pour le tri
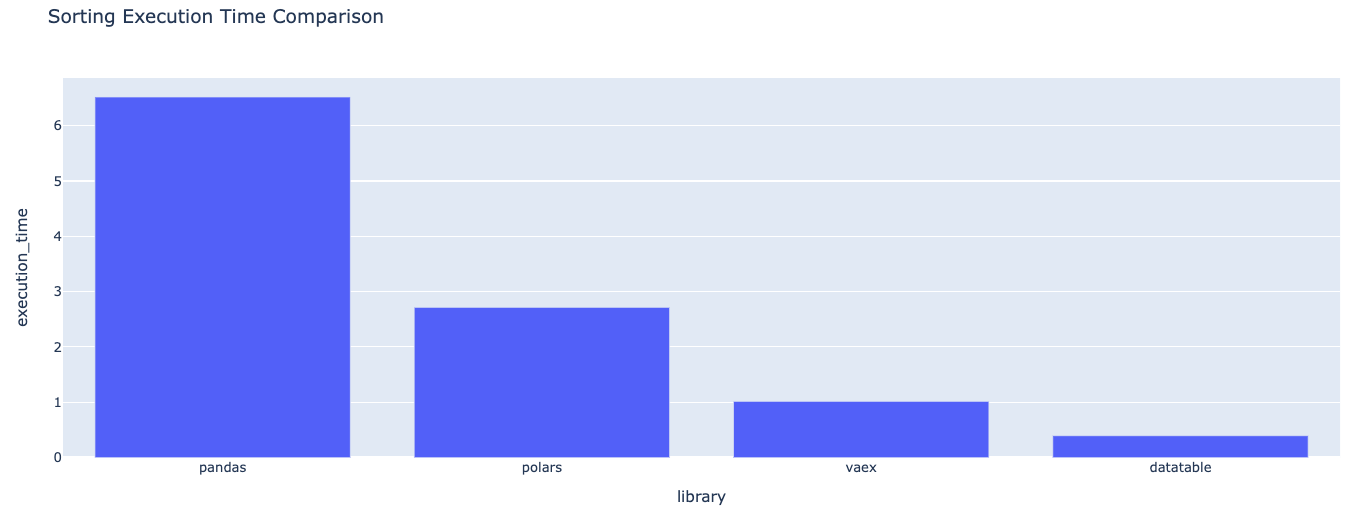
Représentation graphique des temps d’exécution pour le tri
Pour le tri, Datatable est la bibliothèque la plus rapide.
- Vaex est 2,61 fois plus lent que Datatable.
- Polars est 10,37 fois plus lent que Datatable.
- Pandas est 16,96 fois plus lent que Datatable.
Datatable se démarque nettement sur le tri, devant Vaex, Polars et pandas ; Vaex reste le plus proche mais demeure plus de deux fois plus lent.
Offloading des données
L’« offloading » consiste ici à convertir les données originales dans un autre format, en l’occurrence un tableau NumPy.
def offload_data_with_time(library_name, df):

	start_time = time()

	if library_name.lower() == 'polars':
    	array = df.to_numpy()

	elif library_name.lower() == 'vaex':
    	array = df.to_pandas_df().values

	elif library_name.lower() == 'datatable':
    	array = df.to_numpy()

	elif library_name.lower() == 'pandas':
    	array = pd.DataFrame(df).values
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Data offloading Execution Time Comparison"){'library': 'pandas', 'execution_time': 1.8406445980072021}
{'library': 'polars', 'execution_time': 3.238591432571411}
{'library': 'vaex', 'execution_time': 6.945307970046997}
{'library': 'datatable', 'execution_time': 2.634136438369751}Format dictionnaire des temps d’exécution pour l’offloading
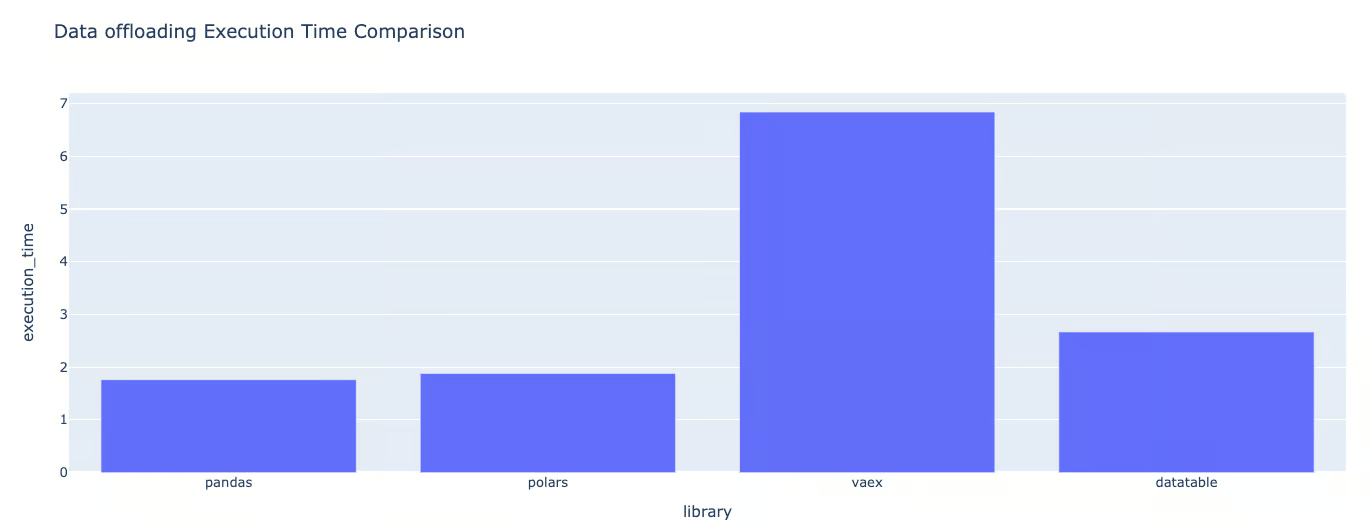
Représentation graphique des temps d’exécution pour l’offloading
L’offloading clôt la série de benchmarks sur le temps d’exécution.
Ici, Vaex présente le temps le plus élevé. Par rapport à pandas, on observe :
- Datatable est 1,43 fois plus lent que pandas.
- Polars est 1,76 fois plus lent que pandas.
- Vaex est 3,77 fois plus lent que pandas.
Benchmark de l’usage mémoire
Le temps d’exécution n’est pas le seul critère. La façon dont chaque bibliothèque gère la mémoire est tout aussi importante. Cette section illustre deux mesures via la bibliothèque tracemalloc :
- Mémoire utilisée actuelle : quantité totale de mémoire utilisée au moment de l’exécution avec une bibliothèque donnée. Elle correspond à l’espace RAM occupé à cet instant.
- Pic de mémoire : quantité maximale de mémoire utilisée par le programme. Le pic est toujours supérieur à la mémoire actuelle.
Ces visualisations aident à identifier les bibliothèques susceptibles de provoquer des erreurs de mémoire insuffisante, surtout sur de très grands jeux de données.
Outre tracemalloc, la bibliothèque os est requise.
import tracemalloc as tm
import os
Avant de commencer, créons une liste vide pour stocker les mesures mémoire.
list_memory_usage = []Pour chaque bibliothèque, l’estimation de l’usage mémoire suit la même trame que ci-dessous (exemple avec Vaex). Nous nous concentrons ici sur l’offloading.
tm.start()
vaex_time = offload_data_with_time('vaex', vaex_df)
memory_usage = tm.get_traced_memory()
tm.stop()

list_memory_usage.append({
	'library': 'vaex',
	'memory_usage': memory_usage
})
La syntaxe est identique pour les autres bibliothèques ; voici respectivement pour Polars, pandas et Datatable :
tm.start()
polars_time = offload_data_with_time('polars', polars_df)
memory_usage = tm.get_traced_memory()

tm.stop()

list_memory_usage.append({
	'library': 'polars',
	'memory_usage': memory_usage
})
tm.start()
offload_data_with_time('pandas', pandas_df)
# Get the memory usage
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'pandas',
'memory_usage': memory_usage
})tm.start()
datatable_time = offload_data_with_time('datatable', datatable_df)
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'datatable',
'memory_usage': memory_usage
})Après exécution de tout le code précédent, nous pouvons tracer le graphique via la fonction utilitaire ci-dessous :
def plot_memory_usage(list_memory_usage, graph_title='Memory Usage by Library'):

	df = pd.DataFrame(list_memory_usage)

	# separate the memory usage tuple into two columns: current_memory and peak_memory
	df[['current_memory', 'peak_memory']] = pd.DataFrame(df['memory_usage'].tolist(), index=df.index)

	# now we no longer need the memory_usage column
	df = df.drop(columns='memory_usage')

	# melt the DataFrame to make it suitable for grouped bar chart
	df_melted = df.melt(id_vars='library', var_name='memory_type', value_name='memory')

	# create the grouped bar chart
	fig = px.bar(df_melted, x='library', y='memory', color='memory_type', barmode='group',
             	labels={'memory':'Memory Usage (bytes)', 'library':'Library', 'memory_type':'Memory Type'},
             	title=graph_title)

	fig.update_layout(yaxis_type="log")
	fig.show()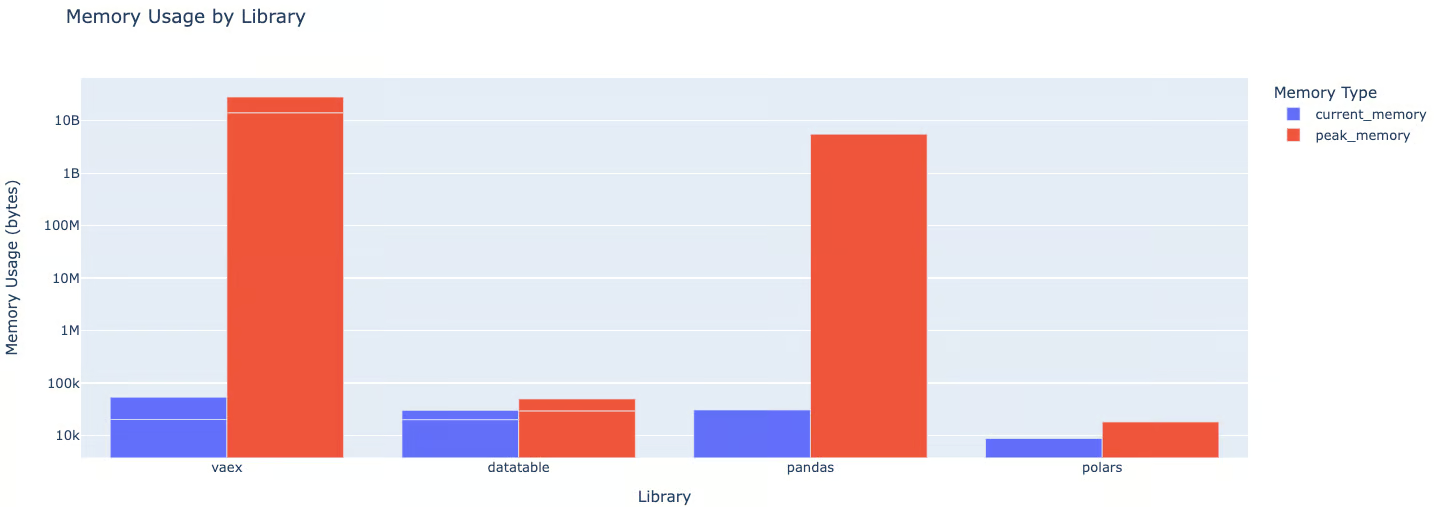
On observe :
- Pandas utilise environ 1100 fois plus de mémoire actuelle que Polars, 7,4 fois plus que Vaex et 29,4 fois plus que Datatable.
- Concernant le pic de mémoire, pandas et Vaex consomment tous deux environ 963 000 fois plus que Polars et 131 000 fois plus que Datatable.
D’autres analyses, comme une comparaison Dask vs pandas, offriraient une vue plus large.
Tableau comparatif des alternatives à pandas
Nous avons synthétisé ci-dessous nos constats dans un tableau comparatif entre Polars, Vaex et Datatable :
|
Critères de benchmark |
Polars |
Vaex |
Datatable |
|
Temps de chargement |
Plus rapide que Vaex, plus lent que Datatable |
Plus lent que Polars et Datatable |
Le plus rapide des trois |
|
Temps de regroupement |
Le plus lent des trois |
Plus rapide que Polars, plus lent que Datatable |
Le plus rapide des trois |
|
Temps de tri |
Plus rapide que Vaex, plus lent que Datatable |
Plus lent que Polars et Datatable |
Le plus rapide des trois |
|
Temps d’offloading |
Plus rapide que Vaex, plus lent que Datatable |
Le plus lent des trois |
Plus rapide que Polars, plus lent que Vaex |
|
Mémoire actuelle |
Consomme le moins |
Plus que Polars mais moins que Datatable |
Consomme le plus des trois |
|
Pic de mémoire |
Consomme le moins |
Plus que Polars mais moins que Datatable |
Consomme le plus des trois |
|
Évolutivité |
Évolue avec la taille des données |
Évolue avec la taille, mais peut consommer davantage en grandissant |
Très forte évolutivité |
|
Facilité d’utilisation |
API Python complète, compatible Apache Arrow |
Évaluation paresseuse, compatible avec pandas |
Interopérable avec Pandas/NumPy/Python pur |
Conclusion
Plusieurs facteurs entrent en jeu lorsqu’on évalue l’évolutivité et la facilité d’intégration. Notre benchmark montre que, même si pandas est établi, convivial et présente une courbe d’apprentissage modérée, il gère moins efficacement les très grands volumes de données.
Il existe toutefois des leviers pour accélérer pandas ; notre article High-Performance Data Manipulation in Python: Pandas 2.0 vs Polars vous guide pas à pas.
Les performances de Vaex varient selon la tâche. Le choix d’une alternative à pandas dépendra donc de vos besoins, de la taille des jeux de données et de votre capacité à gérer la courbe d’apprentissage et l’intégration.