Introdução
Pandas é uma ferramenta extremamente poderosa no ecossistema de ciência de dados em Python, oferecendo vários recursos de manipulação e limpeza de dados. No entanto, embora seja ótimo para conjuntos de dados médios, pode enfrentar problemas de desempenho ao lidar com volumes muito grandes, o que abre espaço para alternativas de alto desempenho.
Este artigo apresenta algumas dessas alternativas e as compara por meio de benchmarks, considerando tempo de carregamento, tempo de execução, uso de memória, escalabilidade e facilidade de uso.
Observação: os resultados de benchmarks variam bastante dependendo da configuração do seu hardware.
Entendendo os benchmarks
Benchmarks são pontos de referência usados para comparar software ou hardware em avaliações de desempenho. Eles são essenciais na otimização de performance de software, pois permitem medir a eficiência de diferentes métodos, algoritmos ou ferramentas. Neste contexto, as principais métricas para avaliar bibliotecas de manipulação de dados incluem tempo de execução, uso de memória, escalabilidade e facilidade de uso.
Introdução às alternativas de alto desempenho
As principais alternativas em Python são Polars, Vaex e Datatable. Antes da análise comparativa, vamos a um breve panorama de cada uma.
Polars
Três características definem o Polars. Primeiro, ele oferece uma API completa em Python, com inúmeras funções para trabalhar com DataFrames. Segundo, pode cumprir duplo papel — tanto como biblioteca de DataFrames quanto como mecanismo de consultas para modelos de dados. Por fim, ao incorporar a implementação segura Arrow2 da especificação Apache Arrow, o Polars se torna altamente eficiente no processamento de grandes volumes de dados.
Confira nosso tutorial de introdução ao Polars, além de uma comparação entre pandas 2.0 e Polars.
Vaex
Vaex trabalha com DataFrames preguiçosos (lazy) e out-of-core (sem caber na memória), semelhantes ao Pandas, para visualizar e explorar grandes conjuntos de dados tabulares. Pode ser muito eficiente, pois adia operações até que sejam necessárias (avaliação preguiçosa), reduzindo uso de memória e tempo.
Datatable
O Datatable permite processar grandes volumes de dados (até 100 GB) em uma única máquina, buscando a maior velocidade possível. Um dos diferenciais é a interoperabilidade com Pandas/NumPy/Python puro, facilitando a conversão para outros frameworks de processamento de dados.
Para saber mais sobre pandas, nosso pandas Tutorial Dataframes in Python é um ótimo ponto de partida.
Além disso, o pandas Cheat Sheet for Data Science in Python traz um guia rápido dos fundamentos da biblioteca, com exemplos de código.
Configurando o ambiente de benchmarking
Nesta seção, criamos os dados do benchmark e instalamos todas as bibliotecas envolvidas na análise.
Dados para o benchmark
O conjunto de dados tem 5,7 GB — tamanho suficiente para uma boa comparação. Cada linha foi duplicada 100000 vezes, resultando em 76.800.000 linhas. O conjunto de dados de diabetes é o original utilizado e está disponível gratuitamente no Kaggle.
O notebook final do benchmark está disponível no GitHub.
import pandas as pd

data_URL = "https://raw.githubusercontent.com/keitazoumana/Experimentation-Data/main/diabetes.csv"

original_data = pd.read_csv(data_URL)

# Duplicate each row 100000 times
benchmarking_df = original_data.loc[original_data.index.repeat(100000)]

# Save the result as a CSV file for future use.
file_name = "benchmarking_data.csv"

benchmarking_df.to_csv(file_name, index=False)
Instalação das bibliotecas
Agora podemos instalar todas as bibliotecas usadas na análise.
Em um ambiente Jupyter Notebook, a instalação é feita via pip install, assim:
%%bash
pip3 -q install -U polars
pip3 -q install vaex
pip -q install datatable
Após executar o bloco acima com sucesso, podemos importá-las:
import pandas as pd
from time import time
import polars as pl
import vaex as vx
import datatable as dt
Além disso, usaremos a biblioteca plotly para visualização.
import plotly.express as pxPronto! Agora podemos seguir com o benchmarking.
Benchmarking do tempo de execução
O tempo de execução será avaliado nas seguintes operações: carregamento de dados, exportação/conversão de dados, agregação e filtragem. Uma função auxiliar é implementada para cada tarefa e retorna um dicionário com duas chaves principais: o nome da biblioteca e o tempo de execução.
A função de plot de métricas é usada para exibir o resultado em um gráfico com a Plotly Express. Ela recebe dois parâmetros: a lista de dicionários retornados pelas funções auxiliares e o título do gráfico.
def plot_metrics(list_exec_time, graph_title):

	df = pd.DataFrame(list_exec_time)

	fig = px.bar(df, x='library', y= 'execution_time', title=graph_title)

	fig.show()
Carregamento de dados
A função auxiliar read_csv_with_time tem dois parâmetros principais: o nome do arquivo a ser lido e o nome da biblioteca.
def read_csv_with_time(library_name, file_name):

	final_time = 0

	start_time = time.time()

	if library_name.lower() == 'polars':
    	df = pl.read_csv(file_name)

	elif library_name.lower() == 'pandas':
    	df = pd.read_csv(file_name)

	elif library_name.lower() == 'vaex':
    	df = vx.read_csv(file_name)

	elif library_name.lower() == 'datatable':
    	df = dt.fread(file_name)

	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'pandas', 'vaex', or 'datatable'")

	end_time = time.time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
A função pode ser aplicada com cada biblioteca, começando por pandas.
pandas_time, pandas_df = read_csv_with_time('pandas', file_name)
polars_time, polars_df = read_csv_with_time('polars', file_name)
vaex_time, vaex_df = read_csv_with_time('vaex', file_name)
datatable_time, dt_df = read_csv_with_time('datatable', file_name)
Os dicionários resultantes podem ser combinados em uma lista e plotados assim:
exec_times = [pandas_time, polars_time,
           vaex_time, datatable_time]

def plot_metrics(list_exec_time, graph_title):

 [print(exec_time) for exec_time in list_exec_time]
 df = pd.DataFrame(exec_times)

 # Plot bar plot using Plotly Express
 fig = px.bar(df, x='library', y='execution_time', title=graph_title)
 fig.show()

plot_metrics(exec_times, "Read Execution Time Comparison")
{'library': 'pandas', 'execution_time': 35.07908916473389}
{'library': 'polars', 'execution_time': 6.041005373001099}
{'library': 'vaex', 'execution_time': 36.431522607803345}
{'library': 'datatable', 'execution_time': 4.4584901332855225}Formato de dicionário dos tempos de execução no carregamento de dados
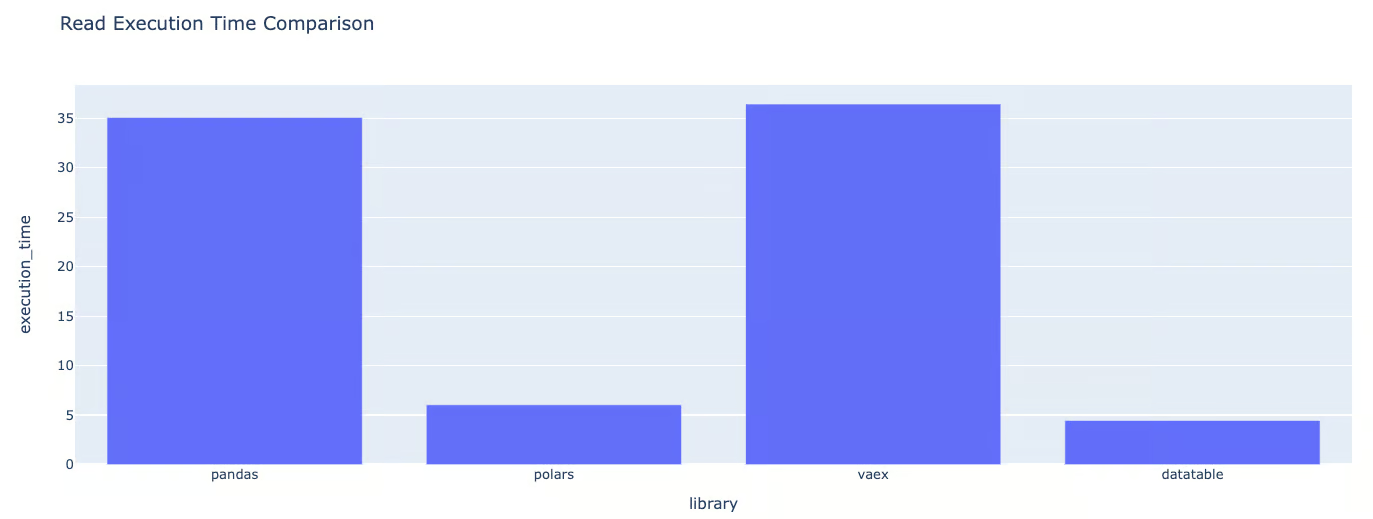
Gráfico dos tempos de execução no carregamento de dados
Com base nos gráficos, podemos concluir que:
- Polars é 1,35 vez mais lento que o Datatable.
- Pandas é 7,87 vezes mais lento que o Datatable.
- Vaex é aproximadamente 8,17 vezes mais lento que o Datatable.
Agrupamento de dados
Da mesma forma, a função group_data_with_time mede o tempo de execução para agrupar a coluna informada no parâmetro. Neste caso, usamos a coluna Pregnancies.
from time import time

def group_data_with_time(library_name, df, column_name='Pregnancies'):

 start_time = time()

 if library_name.lower() == 'polars':
     df_grouped = df.group_by(column_name).first()

 elif library_name.lower() == 'vaex':
     df_grouped = df.groupby(column_name, agg='first')

 elif library_name.lower() == 'pandas':
     df_grouped = df.groupby(column_name).first()

 elif library_name.lower() == 'datatable':
     df_grouped = df[:, dt.first(dt.f[:]), dt.by(column_name)]

 else:
     raise ValueError("Invalid library name. Must be 'polars', 'vaex', or 'datatable'")

 end_time = time()

 final_time = end_time - start_time

 return {"library": library_name, "execution_time": final_time}
pandas_time = group_data_with_time('pandas', pandas_df)
polars_time = group_data_with_time('polars', polars_df)
vaex_time = group_data_with_time('vaex', vaex_df)
datatable_time = group_data_with_time('datatable', dt_df)exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Grouping Execution Time Comparison"){'library': 'pandas', 'execution_time': 2.382519245147705}
{'library': 'pandas', 'execution_time'': 1.0898876190185547}
{'library': 'pandas', 'execution_time': 0.8506548404693604}
{'library': 'pandas', 'execution_time': 0.34698963165283203}
Gráfico dos tempos de execução no agrupamento de dados
Para a tarefa de agrupamento, comparando a biblioteca mais rápida (Datatable) com as demais:
Vemos que o Datatable é o mais rápido entre as bibliotecas avaliadas.
- Vaex é 2,45 vezes mais lento que o Datatable.
- Polars é 3,14 vezes mais lento que o Datatable.
- Pandas é 6,87 vezes mais lento que o Datatable.
Essa análise demonstra a superior eficiência do Datatable em tarefas de agrupamento de dados, com o Vaex relativamente próximo. Polars e Pandas apresentam tempos semelhantes, ambos significativamente mais lentos que o Datatable.
Ordenação de colunas
Seguindo a mesma abordagem, a função de ordenação classifica a coluna indicada em cada biblioteca.
def sort_data_with_time(library_name, df, column_name='Pregnancies'):

	start_time = time()

	if library_name.lower() == 'polars':
    	df_sorted = df.sort(column_name)
	elif library_name.lower() == 'vaex':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'datatable':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'pandas':
    	df_sorted = pd.DataFrame(df).sort_values(column_name)
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
pandas_time = sort_data_with_time('pandas', pandas_df)
polars_time = sort_data_with_time('polars', polars_df)
vaex_time = sort_data_with_time('vaex', vaex_df)
datatable_time = sort_data_with_time('datatable', dt_df){'library': 'pandas', 'execution_time': 6.735127687454224}
{'library': 'polars', 'execution_time': 4.119458436965942}
{'library': 'vaex', 'execution_time': 1.0371737480163574}
{'library': 'datatable', 'execution_time': 0.3971593379974365}Formato de dicionário dos tempos de execução na ordenação
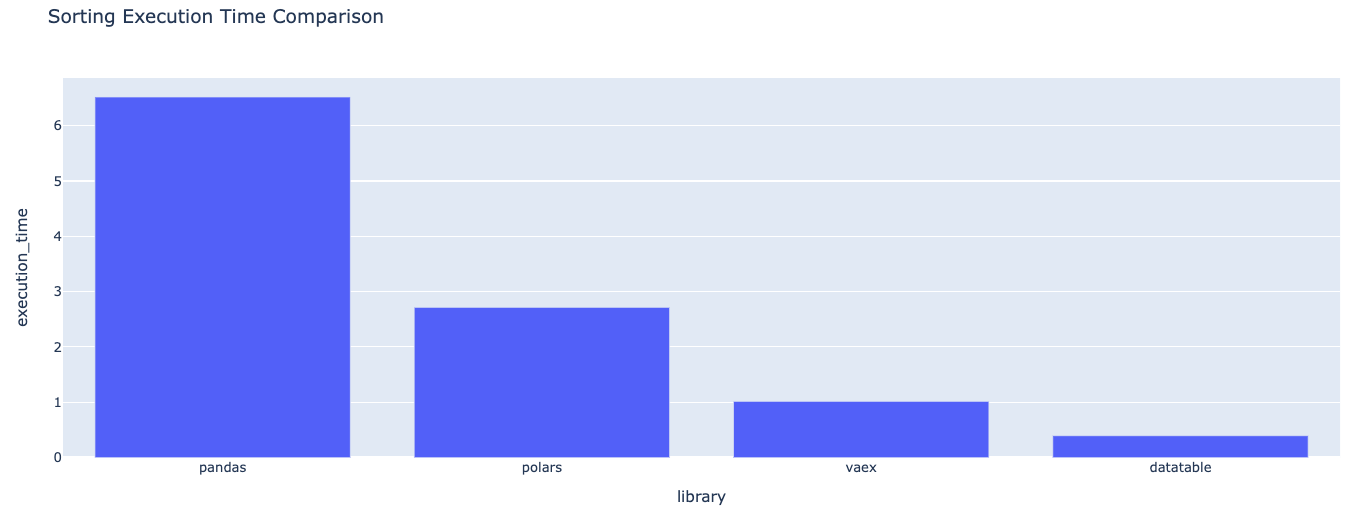
Gráfico dos tempos de execução na ordenação
Na tarefa de ordenação, o Datatable é o mais rápido entre as bibliotecas avaliadas.
- Vaex é 2,61 vezes mais lento que o Datatable.
- Polars é 10,37 vezes mais lento que o Datatable.
- Pandas é 16,96 vezes mais lento que o Datatable.
Essa análise mostra a superioridade do Datatable na ordenação, superando com folga Vaex, Polars e Pandas — com o Vaex sendo o mais próximo, ainda que mais que duas vezes mais lento.
Exportação/conversão de dados
Aqui, a ideia é converter os dados originais para outro formato — neste caso, um array do NumPy.
def offload_data_with_time(library_name, df):

	start_time = time()

	if library_name.lower() == 'polars':
    	array = df.to_numpy()

	elif library_name.lower() == 'vaex':
    	array = df.to_pandas_df().values

	elif library_name.lower() == 'datatable':
    	array = df.to_numpy()

	elif library_name.lower() == 'pandas':
    	array = pd.DataFrame(df).values
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Data offloading Execution Time Comparison"){'library': 'pandas', 'execution_time': 1.8406445980072021}
{'library': 'polars', 'execution_time': 3.238591432571411}
{'library': 'vaex', 'execution_time': 6.945307970046997}
{'library': 'datatable', 'execution_time': 2.634136438369751}Formato de dicionário dos tempos de execução na exportação/conversão
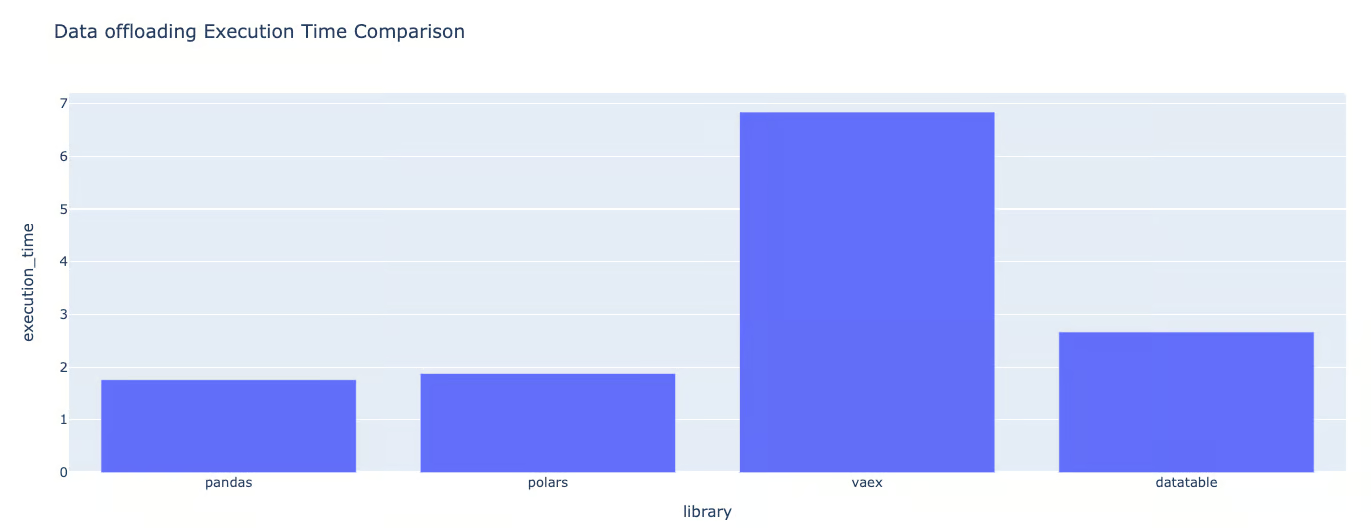
Gráfico dos tempos de execução na exportação/conversão
A exportação/conversão encerra a rodada de benchmarks de tempo de execução.
Desta vez, o Vaex apresenta o maior tempo. Comparando o pandas às demais bibliotecas, vemos que seu tempo é, aproximadamente:
- Datatable é 1,43 vez mais lento que o Pandas.
- Polars é 1,76 vez mais lento que o Pandas.
- Vaex é 3,77 vezes mais lento que o Pandas.
Benchmarking do uso de memória
Tempo de execução não é o único critério na comparação entre bibliotecas. É importante entender como elas utilizam memória. Esta seção mostra duas medições usando a biblioteca tracemalloc:
- Uso de memória atual: a quantidade total de memória usada durante a execução com uma biblioteca específica. Corresponde ao espaço de RAM ocupado naquele momento.
- Pico de memória: a quantidade máxima de memória usada pelo programa. Em geral, o pico é sempre maior que o uso atual.
Ter essas visualizações ajuda a entender quais programas consomem mais memória, o que pode levar a erros de falta de memória — especialmente com conjuntos de dados grandes.
Além do tracemalloc, também usaremos a biblioteca os.
import tracemalloc as tm
import os
Antes de começar, criamos uma lista vazia para armazenar os resultados de uso de memória.
list_memory_usage = []Para cada biblioteca, a estimativa de uso de memória segue a sintaxe abaixo (exemplo com Vaex). Aqui focamos apenas no uso de memória na tarefa de exportação/conversão.
tm.start()
vaex_time = offload_data_with_time('vaex', vaex_df)
memory_usage = tm.get_traced_memory()
tm.stop()

list_memory_usage.append({
	'library': 'vaex',
	'memory_usage': memory_usage
})
A sintaxe é a mesma para as demais bibliotecas; veja as instruções para Polars, pandas e Datatable, respectivamente:
tm.start()
polars_time = offload_data_with_time('polars', polars_df)
memory_usage = tm.get_traced_memory()

tm.stop()

list_memory_usage.append({
	'library': 'polars',
	'memory_usage': memory_usage
})
tm.start()
offload_data_with_time('pandas', pandas_df)
# Get the memory usage
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'pandas',
'memory_usage': memory_usage
})tm.start()
datatable_time = offload_data_with_time('datatable', datatable_df)
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'datatable',
'memory_usage': memory_usage
})Depois de executar todo o código anterior, podemos plotar o gráfico com a função auxiliar abaixo:
def plot_memory_usage(list_memory_usage, graph_title='Memory Usage by Library'):

	df = pd.DataFrame(list_memory_usage)

	# separate the memory usage tuple into two columns: current_memory and peak_memory
	df[['current_memory', 'peak_memory']] = pd.DataFrame(df['memory_usage'].tolist(), index=df.index)

	# now we no longer need the memory_usage column
	df = df.drop(columns='memory_usage')

	# melt the DataFrame to make it suitable for grouped bar chart
	df_melted = df.melt(id_vars='library', var_name='memory_type', value_name='memory')

	# create the grouped bar chart
	fig = px.bar(df_melted, x='library', y='memory', color='memory_type', barmode='group',
             	labels={'memory':'Memory Usage (bytes)', 'library':'Library', 'memory_type':'Memory Type'},
             	title=graph_title)

	fig.update_layout(yaxis_type="log")
	fig.show()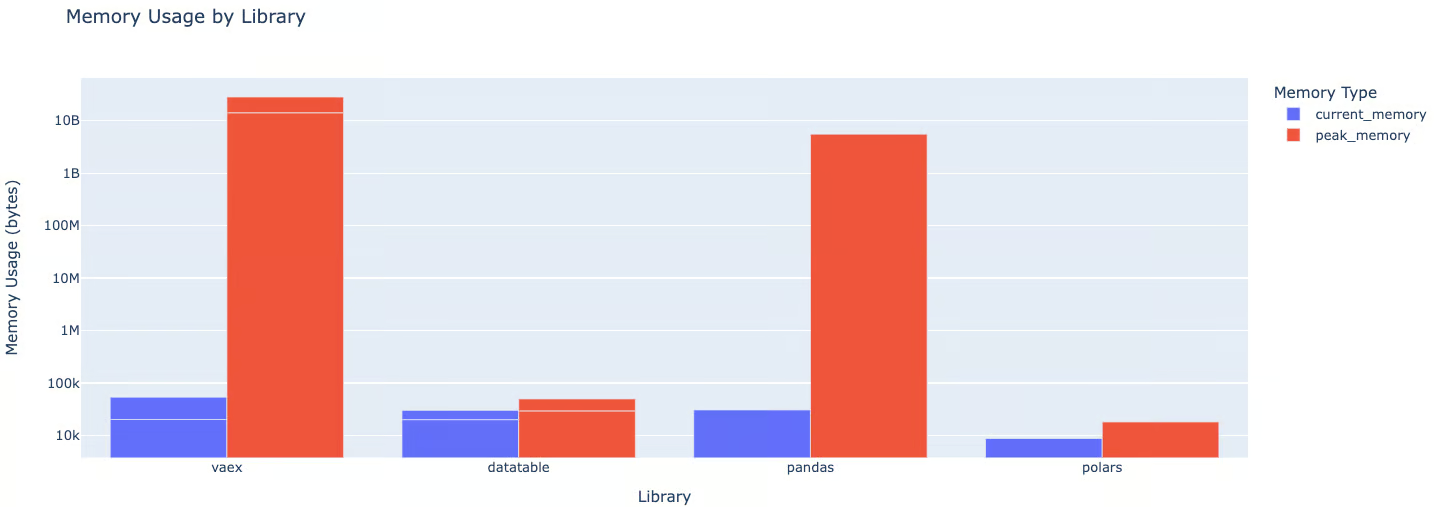
Podemos observar que:
- Pandas usa aproximadamente 1100 vezes mais memória atual que o Polars, 7,4 vezes mais que o Vaex e 29,4 vezes mais que o Datatable.
- No pico de memória, tanto pandas quanto Vaex usam cerca de 963 mil vezes mais memória que o Polars e 131 mil vezes mais que o Datatable.
Análises adicionais, como comparação de velocidade entre Dask e pandas, podem oferecer uma visão mais ampla.
Tabela comparativa de alternativas ao pandas
Abaixo, reunimos os achados em uma tabela comparando Polars, Vaex e Datatable:
|
Critério do benchmark |
Polars |
Vaex |
Datatable |
|
Tempo de carregamento |
Mais rápido que o Vaex, mais lento que o Datatable |
Mais lento que Polars e Datatable |
O mais rápido entre os três |
|
Tempo de agrupamento |
Mais lento entre os três |
Mais rápido que o Polars, mais lento que o Datatable |
O mais rápido entre os três |
|
Tempo de ordenação |
Mais rápido que o Vaex, mais lento que o Datatable |
Mais lento que Polars e Datatable |
O mais rápido entre os três |
|
Tempo de exportação/conversão |
Mais rápido que o Vaex, mais lento que o Datatable |
Mais lento entre os três |
Mais rápido que o Polars, mais lento que o Vaex |
|
Uso de memória atual |
Usa menos memória |
Usa mais memória que o Polars, mas menos que o Datatable |
Usa mais memória entre os três |
|
Pico de memória |
Usa menos memória |
Usa mais memória que o Polars, mas menos que o Datatable |
Usa mais memória entre os três |
|
Escalabilidade |
Escala com o tamanho dos dados |
Escala com o tamanho dos dados, mas pode consumir mais memória conforme o volume cresce |
Altamente escalável com o tamanho dos dados |
|
Facilidade de uso |
Tem uma API Python completa e é compatível com Apache Arrow |
Utiliza avaliação preguiçosa e é compatível com Pandas |
Oferece interoperabilidade com Pandas/NumPy/Python puro |
Conclusão
Vários fatores devem ser considerados ao avaliar escalabilidade e facilidade de integração. Nosso benchmark destacou que, embora o pandas seja consolidado, fácil de usar e tenha uma curva de aprendizado mais suave, ele não lida bem com conjuntos de dados muito grandes.
Ainda assim, há diferentes estratégias para acelerar o pandas, e nosso conteúdo High-Performance Data Manipulation in Python: Pandas 2.0 vs Polars pode ajudar nisso.
O desempenho do Vaex varia conforme a tarefa. Portanto, a escolha de uma alternativa ao pandas depende das demandas específicas, do tamanho dos dados e da disposição do usuário em encarar a curva de aprendizado e a integração.