Last chance! 50% off DataCamp Premium
Sale ends in
Pandas, Python'un veri bilimi ekosisteminde son derece güçlü bir araçtır ve çeşitli veri işleme ve temizleme yetenekleri sunar. Ancak, orta ölçekli veri kümeleri için harika olsa da, büyük veri kümeleriyle çalışırken performans sorunları yaşayabilir; bu da yüksek performanslı alternatiflere olan ihtiyacı gündeme getirir.
Bu kapsamlı yazı, bu alternatiflerden bazılarını tanıtır ve veri yükleme süresi, yürütme süresi, bellek kullanımı, ölçeklenebilirlik ve kullanım kolaylığı açısından karşılaştırmalı testlerle değerlendirir.
Not: Karşılaştırmalı test sonuçları, donanım kurulumunuza bağlı olarak ciddi ölçüde değişebilir.
Karşılaştırmalı testler, yazılım veya donanımın performans değerlendirmesi için kıyaslanabileceği bir referans noktasıdır. Bu referans, farklı yöntemlerin, algoritmaların veya araçların verimliliğini ölçmemize olanak tanıdığı için yazılım performansı optimizasyonunda önemlidir. Bu bağlamda, veri işleme kütüphanelerinin karşılaştırmalı testlerindeki temel metrikler yürütme süresi, bellek kullanımı, ölçeklenebilirlik ve kullanım kolaylığıdır.
Başlıca alternatif Python araçları Polars, Vaex ve Datatable'dır. Karşılaştırmalı analizlerine geçmeden önce, bu araçların her birine hızlıca göz atalım.
Polars'ı üç temel özellikle özetleyebiliriz. İlk olarak, DataFrame'leri işlemek için çok sayıda fonksiyon içeren kapsamlı bir Python API'si sunar. İkinci olarak, iki amaçlı kullanılabilir: DataFrame'ler için bir kütüphane olarak veya veri modelleri için altta yatan sorgu motoru olarak. Son olarak, Apache Arrow spesifikasyonunun güvenli Arrow2 uygulamasını dahil ederek, Polars büyük miktarda veriyi verimli şekilde işleyen son derece etkili bir araca dönüşür.
Polars'a giriş eğitimimize ve ayrıca pandas 2.0 ile Polars karşılaştırmasına göz atabilirsiniz.
Vaex, büyük tablo biçimli veri kümelerini görselleştirmek ve keşfetmek için tembel (lazy), çekirdek-dışı (out-of-core) DataFrame'ler (Pandas'a benzer) sunar. İşlemleri gerekli olana kadar ertelediği (tembel değerlendirme) için bellek kullanımını ve süreyi azaltarak oldukça verimli olabilir.
Datatable, tek düğümlü bir makinede mümkün olan en yüksek hızda büyük veri işlemleri (100 GB'a kadar) için kullanılabilir. Datatable'ın önemli özelliklerinden biri, Pandas/NumPy/saf Python ile birlikte çalışabilirliğidir; bu sayede kullanıcılar başka bir veri işleme çerçevesine kolayca dönüştürebilir.
Pandas hakkında daha fazla bilgi edinmek için Python'da Pandas DataFrame Eğitimi iyi bir başlangıç noktasıdır.
Ayrıca, Python'da Veri Bilimi için Pandas El Kartı, Python veri analizi kütüphanesinin temellerine hızlı bir rehber sunar ve kod örnekleri içerir.
Bu bölüm, karşılaştırmalı test verilerinin oluşturulmasını ve analizde yer alan tüm kütüphanelerin kurulumunu kapsar.
Karşılaştırma veri kümesi 5,7 GB büyüklüğündedir; bu da makul bir kıyaslama için yeterlidir. Her satır 100000 kez çoğaltılmıştır ve sonuçta 76.800.000 satır elde edilmiştir. Kullanılan orijinal Diyabet verisi Kaggle'da ücretsiz olarak mevcuttur.
Nihai karşılaştırma not defteri GitHub'da bulunmaktadır.
import pandas as pd

data_URL = "https://raw.githubusercontent.com/keitazoumana/Experimentation-Data/main/diabetes.csv"

original_data = pd.read_csv(data_URL)

# Duplicate each row 100000 times
benchmarking_df = original_data.loc[original_data.index.repeat(100000)]

# Save the result as a CSV file for future use.
file_name = "benchmarking_data.csv"

benchmarking_df.to_csv(file_name, index=False)Şimdi, karşılaştırmalı analizde yer alan tüm kütüphanelerin kurulumuna geçebiliriz.
Bir Jupyter notebook ortamında, tüm kurulumlar aşağıdaki gibi pip install komutlarıyla yapılır:
%%bash
pip3 -q install -U polars
pip3 -q install vaex
pip -q install datatable
Yukarıdaki kod bloğu başarıyla çalıştırıldıktan sonra, import deyimiyle içe aktarabiliriz:
import pandas as pd
from time import time
import polars as pl
import vaex as vx
import datatable as dt
Ayrıca, görselleştirme amacıyla plotly kütüphanesini kullanıyoruz.
import plotly.express as pxArtık karşılaştırmalı analizle devam etmeye hazırız.
Yürütme süresi şu işlemler için değerlendirilecektir: veri yükleme, veri boşaltma, veri toplulaştırma ve veri filtreleme. Her görev için bir yardımcı fonksiyon uygulanmıştır ve iki ana anahtar içeren bir sözlük döndürecektir: kütüphane adı ve yürütme süresi.
Ardından, Plotly Express kütüphanesini kullanarak sonucu grafiksel olarak çizmek için metrik çizim fonksiyonu kullanılır. Bu fonksiyonun iki parametresi vardır: önceki yardımcı fonksiyonlardan gelen tüm sözlüklerin listesi ve alttaki grafiğin başlığı.
def plot_metrics(list_exec_time, graph_title):

	df = pd.DataFrame(list_exec_time)

	fig = px.bar(df, x='library', y= 'execution_time', title=graph_title)

fig.show()read_csv_with_time yardımcı fonksiyonunun iki temel parametresi vardır: okunacak dosya adı ve kütüphane adı.
def read_csv_with_time(library_name, file_name):

	final_time = 0

	start_time = time.time()

	if library_name.lower() == 'polars':
    	df = pl.read_csv(file_name)

	elif library_name.lower() == 'pandas':
    	df = pd.read_csv(file_name)

	elif library_name.lower() == 'vaex':
    	df = vx.read_csv(file_name)

	elif library_name.lower() == 'datatable':
    	df = dt.fread(file_name)

	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'pandas', 'vaex', or 'datatable'")

	end_time = time.time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
Fonksiyon her bir kütüphane ile, pandas'tan başlayarak uygulanabilir.
pandas_time, pandas_df = read_csv_with_time('pandas', file_name)
polars_time, polars_df = read_csv_with_time('polars', file_name)
vaex_time, vaex_df = read_csv_with_time('vaex', file_name)
datatable_time, dt_df = read_csv_with_time('datatable', file_name)
Ortaya çıkan sözlükler bir liste olarak birleştirilebilir ve aşağıdaki ifade kullanılarak görselleştirilebilir.
exec_times = [pandas_time, polars_time,
           vaex_time, datatable_time]

def plot_metrics(list_exec_time, graph_title):

 [print(exec_time) for exec_time in list_exec_time]
 df = pd.DataFrame(exec_times)

 # Plot bar plot using Plotly Express
 fig = px.bar(df, x='library', y='execution_time', title=graph_title)
 fig.show()

plot_metrics(exec_times, "Read Execution Time Comparison")
{'library': 'pandas', 'execution_time': 35.07908916473389}
{'library': 'polars', 'execution_time': 6.041005373001099}
{'library': 'vaex', 'execution_time': 36.431522607803345}
{'library': 'datatable', 'execution_time': 4.4584901332855225}Veri yükleme için yürütme sürelerinin sözlük formatı
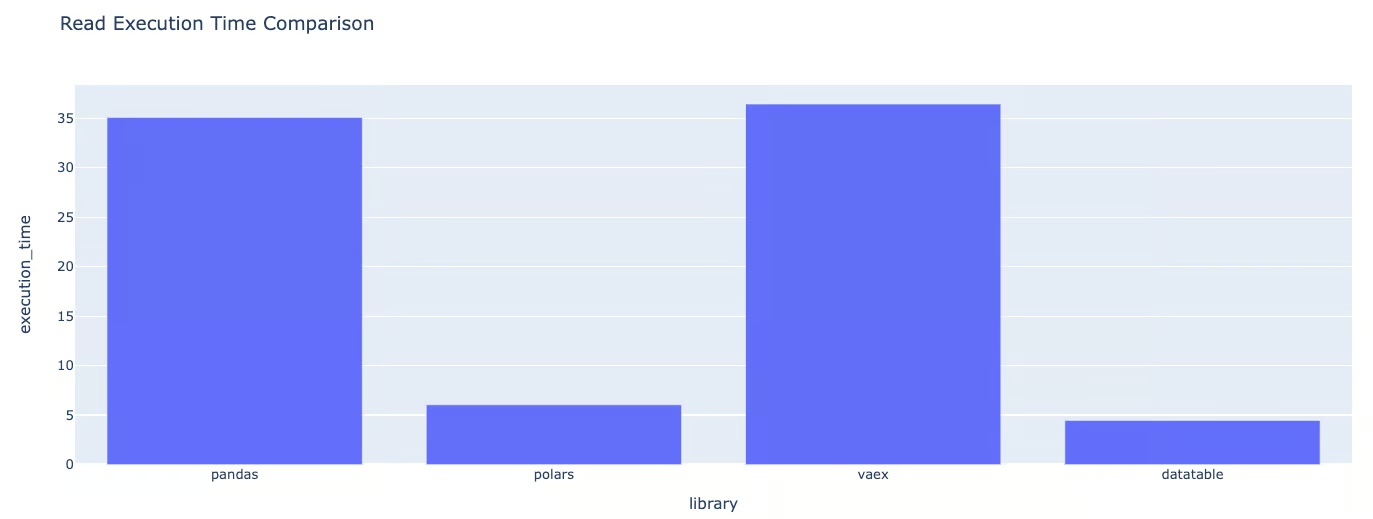
Veri yükleme için yürütme sürelerinin grafik formatı
Grafiklere dayanarak şu sonuca varabiliriz:
Benzer şekilde, group_data_with_time fonksiyonu, parametre olarak verilen sütunun gruplanması için yürütme süresini izlemekten sorumludur. Bu örnekte Pregnancies sütununu kullanıyoruz.
from time import time

def group_data_with_time(library_name, df, column_name='Pregnancies'):

 start_time = time()

 if library_name.lower() == 'polars':
     df_grouped = df.group_by(column_name).first()

 elif library_name.lower() == 'vaex':
     df_grouped = df.groupby(column_name, agg='first')

 elif library_name.lower() == 'pandas':
     df_grouped = df.groupby(column_name).first()

 elif library_name.lower() == 'datatable':
     df_grouped = df[:, dt.first(dt.f[:]), dt.by(column_name)]

 else:
     raise ValueError("Invalid library name. Must be 'polars', 'vaex', or 'datatable'")

 end_time = time()

 final_time = end_time - start_time

 return {"library": library_name, "execution_time": final_time}
pandas_time = group_data_with_time('pandas', pandas_df)
polars_time = group_data_with_time('polars', polars_df)
vaex_time = group_data_with_time('vaex', vaex_df)
datatable_time = group_data_with_time('datatable', dt_df)exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Grouping Execution Time Comparison"){'library': 'pandas', 'execution_time': 2.382519245147705}
{'library': 'pandas', 'execution_time'': 1.0898876190185547}
{'library': 'pandas', 'execution_time': 0.8506548404693604}
{'library': 'pandas', 'execution_time': 0.34698963165283203}
Veri gruplama için yürütme sürelerinin grafik formatı
Güncellenmiş veri gruplama görevi için, en hızlı kütüphane DataTable diğerleriyle karşılaştırıldığında:
DataTable'ın değerlendirilen kütüphaneler arasında en hızlı olduğunu görebiliyoruz.
Bu analiz, veri gruplama görevleri için DataTable'ın üstün verimliliğini gösterir; Vaex göreceli olarak yakın bir performans sergiler. Polars ve Pandas benzer yürütme süreleri sunar ve her ikisi de DataTable'dan belirgin şekilde daha yavaştır.
Aynı yaklaşımı kullanarak, sütun sıralama fonksiyonu verilen sütunu her kütüphaneyle sıralar.
def sort_data_with_time(library_name, df, column_name='Pregnancies'):

	start_time = time()

	if library_name.lower() == 'polars':
    	df_sorted = df.sort(column_name)
	elif library_name.lower() == 'vaex':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'datatable':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'pandas':
    	df_sorted = pd.DataFrame(df).sort_values(column_name)
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
pandas_time = sort_data_with_time('pandas', pandas_df)
polars_time = sort_data_with_time('polars', polars_df)
vaex_time = sort_data_with_time('vaex', vaex_df)
datatable_time = sort_data_with_time('datatable', dt_df){'library': 'pandas', 'execution_time': 6.735127687454224}
{'library': 'polars', 'execution_time': 4.119458436965942}
{'library': 'vaex', 'execution_time': 1.0371737480163574}
{'library': 'datatable', 'execution_time': 0.3971593379974365}Veri sıralama için yürütme sürelerinin sözlük formatı
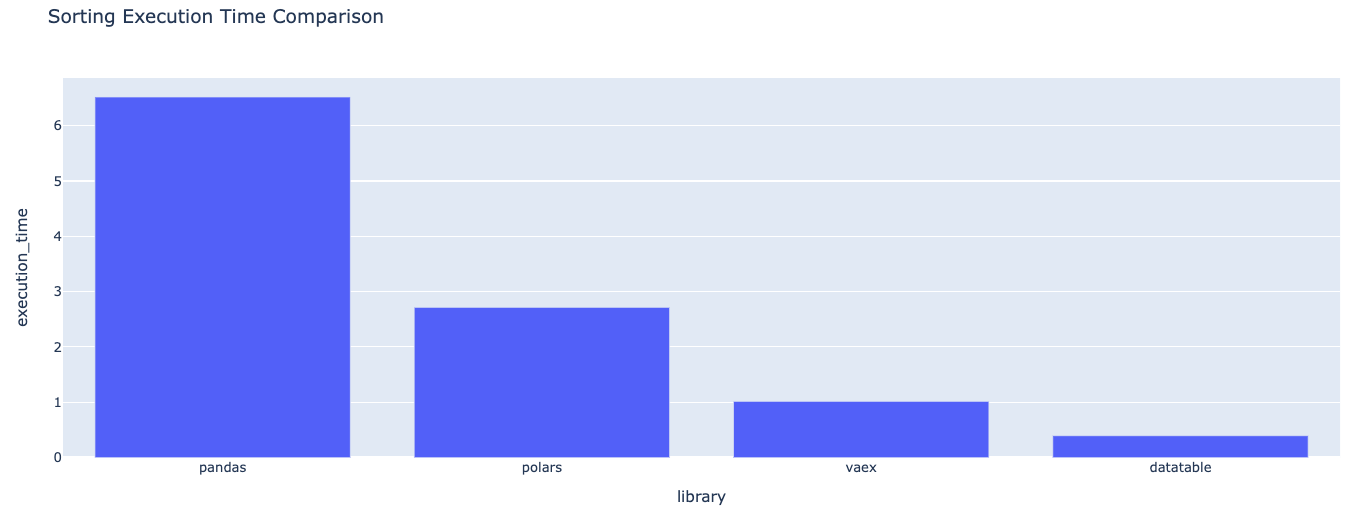
Veri sıralama için yürütme sürelerinin grafik formatı
Veri sıralama görevi için DataTable, değerlendirilen kütüphaneler arasında en hızlısıdır.
Bu analiz, veri sıralama görevlerini ele almada DataTable'ın üstün performansını gösterir; Vaex en yakın performansı sergilese de hâlâ iki kattan daha yavaştır.
Veri boşaltmada amaç, orijinal veriyi farklı bir formata dönüştürmektir; bu özel senaryoda numpy dizisine.
def offload_data_with_time(library_name, df):

	start_time = time()

	if library_name.lower() == 'polars':
    	array = df.to_numpy()

	elif library_name.lower() == 'vaex':
    	array = df.to_pandas_df().values

	elif library_name.lower() == 'datatable':
    	array = df.to_numpy()

	elif library_name.lower() == 'pandas':
    	array = pd.DataFrame(df).values
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
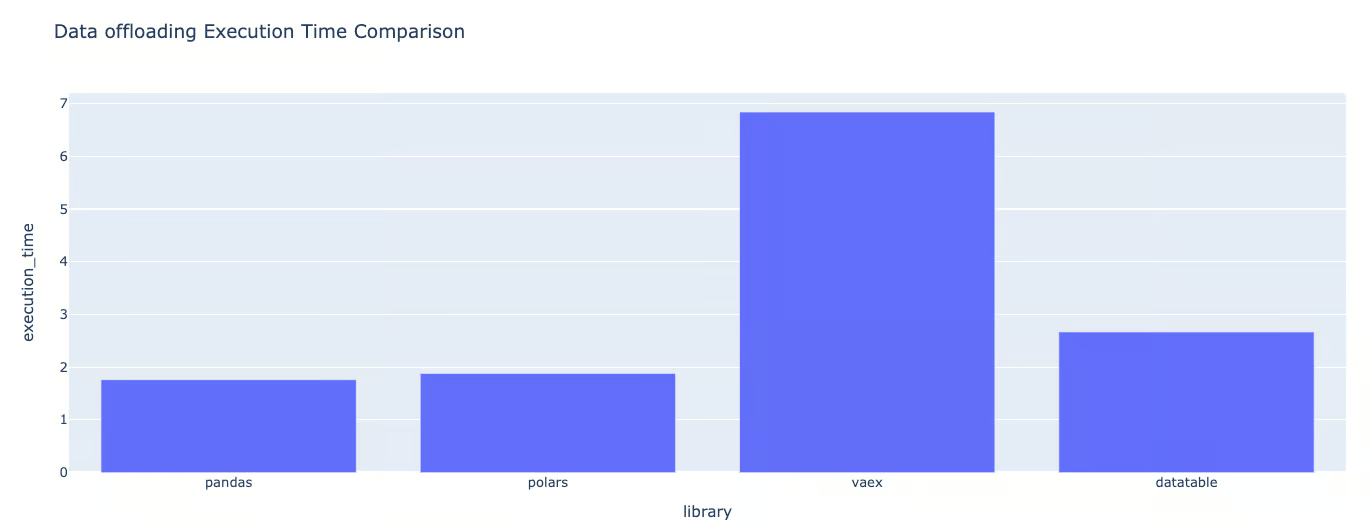
exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Data offloading Execution Time Comparison"){'library': 'pandas', 'execution_time': 1.8406445980072021} {'library': 'polars', 'execution_time': 3.238591432571411} {'library': 'vaex', 'execution_time': 6.945307970046997} {'library': 'datatable', 'execution_time': 2.634136438369751}Veri boşaltma için yürütme sürelerinin sözlük formatı
Veri boşaltma için yürütme sürelerinin grafik formatı
Veri boşaltma, yürütme süresi için karşılaştırmalı testin son turudur.
Bu kez en yüksek yürütme süresine sahip olan Vaex'tir. Pandas'ı bu kütüphanelerle karşılaştırdığımızda yaklaşık olarak şunları görüyoruz:
Farklı kütüphaneleri karşılaştırırken yalnızca yürütme süresi kriter değildir. Belleği ne kadar verimli yönettiklerini bilmek de önemlidir. Bu bölümde, tracemalloc kütüphanesini kullanarak iki farklı bellek kullanımı gösterilmektedir:
Bu görselleştirmelere sahip olmak, özellikle büyük veri kümeleriyle çalışırken bellek taşma hatalarına yol açabilecek ölçüde hangi programın ne kadar bellek kullandığını anlamaya yardımcı olur.
Tracemalloc'a ek olarak os kütüphanesi de gereklidir.
import tracemalloc as tm
import os
Başlamadan önce, her bir bellek kullanımı değerinin sonucunu tutacak boş bir liste oluşturuyoruz.
list_memory_usage = []Her kütüphane için, bellek kullanımının tahmini aşağıdaki genel sözdizimiyle yapılır; bu, Vaex kütüphanesiyle yürütmeye karşılık gelir. Ayrıca, bu yalnızca veri boşaltma görevlerinin bellek kullanımına odaklanır.
tm.start()
vaex_time = offload_data_with_time('vaex', vaex_df)
memory_usage = tm.get_traced_memory()
tm.stop()

list_memory_usage.append({
	'library': 'vaex',
	'memory_usage': memory_usage
})
Sözdizimi kalan kütüphaneler için de aynıdır ve sırasıyla Polars, pandas ve Datatable için aşağıdaki talimatları elde ederiz:
tm.start()
polars_time = offload_data_with_time('polars', polars_df)
memory_usage = tm.get_traced_memory()

tm.stop()

list_memory_usage.append({
	'library': 'polars',
	'memory_usage': memory_usage
})
tm.start()
offload_data_with_time('pandas', pandas_df)
# Get the memory usage
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'pandas',
'memory_usage': memory_usage
})tm.start()
datatable_time = offload_data_with_time('datatable', datatable_df)
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'datatable',
'memory_usage': memory_usage
})Önceki tüm kodların yürütülmesinden sonra, aşağıdaki yardımcı fonksiyonu kullanarak grafiği çizebiliriz:
def plot_memory_usage(list_memory_usage, graph_title='Memory Usage by Library'):

	df = pd.DataFrame(list_memory_usage)

	# separate the memory usage tuple into two columns: current_memory and peak_memory
	df[['current_memory', 'peak_memory']] = pd.DataFrame(df['memory_usage'].tolist(), index=df.index)

	# now we no longer need the memory_usage column
	df = df.drop(columns='memory_usage')

	# melt the DataFrame to make it suitable for grouped bar chart
	df_melted = df.melt(id_vars='library', var_name='memory_type', value_name='memory')

	# create the grouped bar chart
	fig = px.bar(df_melted, x='library', y='memory', color='memory_type', barmode='group',
             	labels={'memory':'Memory Usage (bytes)', 'library':'Library', 'memory_type':'Memory Type'},
             	title=graph_title)

	fig.update_layout(yaxis_type="log")
	fig.show()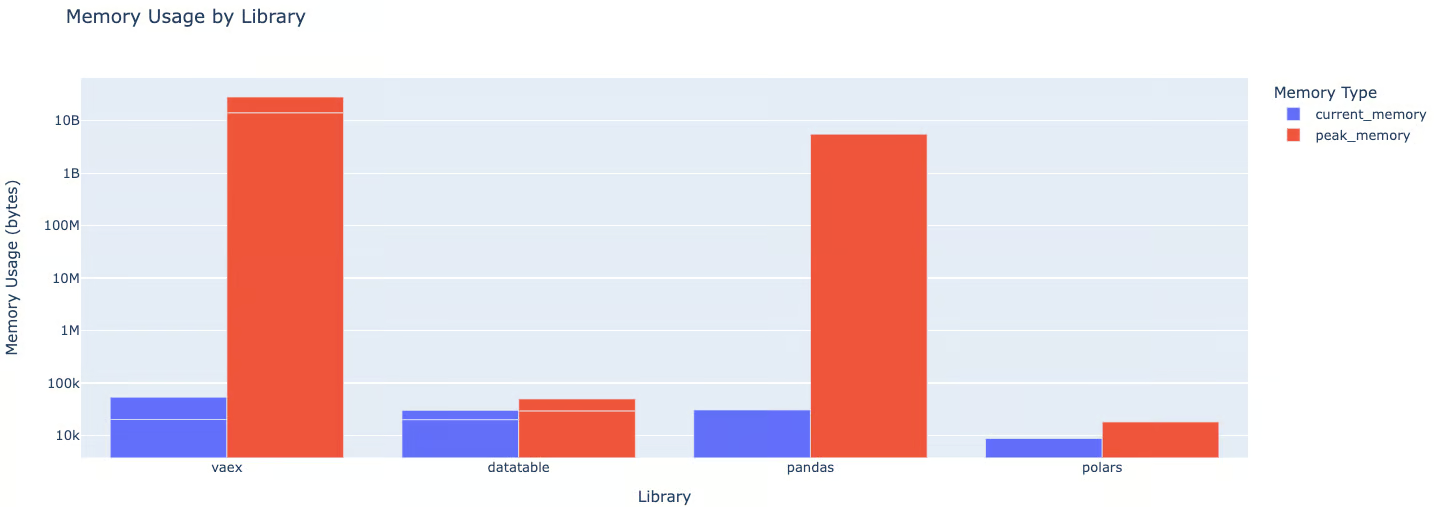
Şunları gözlemleyebiliriz:
Dask ile pandas hız karşılaştırması gibi daha ileri analizler daha geniş bir bakış sağlayabilir.
Aşağıda bulgularımızı bir karşılaştırma tablosunda derledik; Polars, Vaex ve Datatable arasındaki farkları gösteriyoruz:
|
Karşılaştırma Kriteri |
Polars |
Vaex |
Datatable |
|
Veri Yükleme Süresi |
Vaex'ten hızlı, Datatable'dan yavaş |
Hem Polars hem de Datatable'dan yavaş |
Üçü arasında en hızlı |
|
Veri Gruplama Süresi |
Üçü arasında en yavaş |
Polars'tan hızlı, Datatable'dan yavaş |
Üçü arasında en hızlı |
|
Veri Sıralama Süresi |
Vaex'ten hızlı, Datatable'dan yavaş |
Hem Polars hem de Datatable'dan yavaş |
Üçü arasında en hızlı |
|
Veri Boşaltma Süresi |
Vaex'ten hızlı, Datatable'dan yavaş |
Üçü arasında en yavaş |
Polars'tan hızlı, Vaex'ten yavaş |
|
Güncel Bellek Kullanımı |
En az bellek kullanır |
Polars'tan fazla, Datatable'dan az bellek kullanır |
Üçü arasında en fazla bellek kullanır |
|
Tepe Bellek Kullanımı |
En az bellek kullanır |
Polars'tan fazla, Datatable'dan az bellek kullanır |
Üçü arasında en fazla bellek kullanır |
|
Ölçeklenebilirlik |
Veri boyutuyla ölçeklenebilir |
Veri boyutuyla ölçeklenebilir ama veri büyüdükçe daha fazla bellek kullanabilir |
Veri boyutuyla yüksek derecede ölçeklenebilir |
|
Kullanım kolaylığı |
Eksiksiz bir Python API'ye sahiptir ve Apache Arrow ile uyumludur |
Tembel değerlendirme kullanır ve Pandas ile uyumludur |
Pandas/NumPy/saf Python ile birlikte çalışabilirlik sunar |
Ölçeklenebilirlik ve entegrasyon kolaylığı analizinde farklı faktörler dikkate alınmalıdır. Karşılaştırmalı testimiz, pandas'ın köklü ve kullanıcı dostu olmasına ve daha dik bir öğrenme eğrisine sahip olmasına rağmen, büyük veri kümelerini verimli şekilde işlemediğini vurguladı.
Bununla birlikte, pandas'ı hızlandırmaya yönelik farklı yollar mevcuttur ve Python'da Yüksek Performanslı Veri İşleme: Pandas 2.0 vs Polars içeriğimiz bu konuda yardımcı olabilir.
Vaex'in performansı göreve bağlı olarak değişir. Dolayısıyla, Pandas'a alternatif seçimi; kullanıcıların özel gereksinimlerine, veri kümesi boyutlarına ve öğrenme eğrisi ile entegrasyonu karşılama yeteneklerine bağlıdır.
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.