Giới thiệu
Pandas là một công cụ cực kỳ mạnh mẽ trong hệ sinh thái khoa học dữ liệu của Python, cung cấp nhiều khả năng thao tác và làm sạch dữ liệu. Tuy nhiên, dù rất phù hợp cho các tập dữ liệu kích thước trung bình, pandas có thể gặp vấn đề về hiệu năng khi xử lý các tập dữ liệu lớn, từ đó nảy sinh nhu cầu về các giải pháp thay thế có hiệu suất cao.
Bài viết toàn diện này giới thiệu một số lựa chọn thay thế và so sánh chúng thông qua các phép đo hiệu năng theo thời gian tải dữ liệu, thời gian thực thi, mức sử dụng bộ nhớ, khả năng mở rộng và mức độ dễ sử dụng.
Lưu ý: Kết quả đo hiệu năng có thể khác biệt đáng kể tùy theo cấu hình phần cứng của bạn.
Tìm hiểu về các phép đo hiệu năng
Benchmark là điểm tham chiếu để so sánh phần mềm hoặc phần cứng nhằm đánh giá hiệu năng. Tham chiếu này đặc biệt quan trọng trong tối ưu hóa hiệu năng phần mềm vì cho phép đo lường hiệu quả của các phương pháp, thuật toán hoặc công cụ khác nhau. Trong bối cảnh này, các chỉ số chính để đo hiệu năng các thư viện thao tác dữ liệu gồm có thời gian thực thi, mức sử dụng bộ nhớ, khả năng mở rộng và mức độ dễ sử dụng.
Giới thiệu các lựa chọn thay thế hiệu suất cao
Các công cụ thay thế chính trong Python là Polars, Vaex và Datatable. Trước khi đi vào phân tích so sánh, hãy điểm qua nhanh từng công cụ.
Polars
Polars có thể được mô tả bằng ba đặc điểm chính. Thứ nhất, nó cung cấp API Python toàn diện với nhiều hàm để xử lý DataFrame. Thứ hai, nó có thể phục vụ hai mục đích — vừa dùng như một thư viện DataFrame, vừa làm động cơ truy vấn nền tảng cho mô hình dữ liệu. Cuối cùng, nhờ tích hợp Arrow2 an toàn theo đặc tả Apache Arrow, Polars trở thành công cụ cực kỳ hiệu quả để xử lý lượng dữ liệu lớn.
Bạn có thể xem bài hướng dẫn giới thiệu Polars của chúng tôi, cũng như so sánh giữa pandas 2.0 và Polars.
Vaex
Vaex dành cho DataFrame lười thực thi (lazy) và out-of-core (tương tự Pandas) để trực quan hóa và khám phá các tập dữ liệu dạng bảng lớn. Nó có thể rất hiệu quả vì trì hoãn thao tác cho đến khi cần thiết (đánh giá lười), giúp giảm sử dụng bộ nhớ và thời gian.
Datatable
Datatable có thể được dùng để xử lý dữ liệu lớn (lên đến 100GB) trên một máy đơn ở tốc độ tối đa có thể. Một tính năng quan trọng của Datatable là khả năng tương tác với Pandas/NumPy/thuần Python, cho phép người dùng dễ dàng chuyển đổi sang khung xử lý dữ liệu khác.
Để tìm hiểu thêm về pandas, hướng dẫn DataFrame với pandas trong Python của chúng tôi là điểm khởi đầu tuyệt vời.
Ngoài ra, Pandas Cheat Sheet cho Khoa học Dữ liệu bằng Python cung cấp hướng dẫn nhanh về những điều cơ bản của thư viện phân tích dữ liệu Python, kèm theo mẫu mã.
Thiết lập môi trường đo hiệu năng
Phần này trình bày việc tạo dữ liệu dùng để đo hiệu năng và cài đặt toàn bộ các thư viện liên quan trong phân tích.
Dữ liệu đo hiệu năng
Tập dữ liệu dùng để đo hiệu năng có kích thước 5,7 GB, đủ lớn để thực hiện so sánh hợp lý. Mỗi hàng đã được nhân bản 100000 lần, tạo thành 76.800.000 hàng. Dữ liệu tiểu đường là bản gốc được sử dụng và có sẵn miễn phí trên Kaggle.
Notebook đo hiệu năng cuối cùng có sẵn trên GitHub.
import pandas as pd

data_URL = "https://raw.githubusercontent.com/keitazoumana/Experimentation-Data/main/diabetes.csv"

original_data = pd.read_csv(data_URL)

# Duplicate each row 100000 times
benchmarking_df = original_data.loc[original_data.index.repeat(100000)]

# Save the result as a CSV file for future use.
file_name = "benchmarking_data.csv"

benchmarking_df.to_csv(file_name, index=False)
Cài đặt các thư viện
Giờ đây, chúng ta có thể tiến hành cài đặt tất cả thư viện tham gia vào phân tích đo hiệu năng.
Trong môi trường Jupyter notebook, toàn bộ việc cài đặt được thực hiện bằng lệnh pip install như sau:
%%bash
pip3 -q install -U polars
pip3 -q install vaex
pip -q install datatable
Sau khi chạy thành công khối mã trên, chúng ta có thể import bằng câu lệnh import:
import pandas as pd
from time import time
import polars as pl
import vaex as vx
import datatable as dt
Ngoài ra, chúng ta sử dụng thư viện plotly cho mục đích trực quan hóa.
import plotly.express as pxGiờ thì mọi thứ đã sẵn sàng để bắt đầu phân tích đo hiệu năng.
Đo hiệu năng theo thời gian thực thi
Thời gian thực thi sẽ được đánh giá cho các thao tác sau: tải dữ liệu, chuyển đổi/xuất dữ liệu, tổng hợp dữ liệu và lọc dữ liệu. Một hàm hỗ trợ được triển khai cho mỗi tác vụ và sẽ trả về một dictionary với hai khóa chính: tên thư viện và thời gian thực thi.
Sau đó, hàm vẽ chỉ số được dùng để biểu diễn kết quả dưới dạng đồ thị bằng thư viện Plotly Express. Hàm có hai tham số: danh sách tất cả dictionary từ các hàm hỗ trợ trước đó và tiêu đề của biểu đồ tương ứng.
def plot_metrics(list_exec_time, graph_title):

	df = pd.DataFrame(list_exec_time)

	fig = px.bar(df, x='library', y= 'execution_time', title=graph_title)

	fig.show()
Tải dữ liệu
Hàm hỗ trợ read_csv_with_time có hai tham số chính: tên tệp cần đọc và tên thư viện.
def read_csv_with_time(library_name, file_name):

	final_time = 0

	start_time = time.time()

	if library_name.lower() == 'polars':
    	df = pl.read_csv(file_name)

	elif library_name.lower() == 'pandas':
    	df = pd.read_csv(file_name)

	elif library_name.lower() == 'vaex':
    	df = vx.read_csv(file_name)

	elif library_name.lower() == 'datatable':
    	df = dt.fread(file_name)

	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'pandas', 'vaex', or 'datatable'")

	end_time = time.time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
Hàm có thể được áp dụng với từng thư viện, bắt đầu từ pandas.
pandas_time, pandas_df = read_csv_with_time('pandas', file_name)
polars_time, polars_df = read_csv_with_time('polars', file_name)
vaex_time, vaex_df = read_csv_with_time('vaex', file_name)
datatable_time, dt_df = read_csv_with_time('datatable', file_name)
Các dictionary kết quả có thể được gộp thành một danh sách và vẽ bằng biểu thức sau.
exec_times = [pandas_time, polars_time,
           vaex_time, datatable_time]

def plot_metrics(list_exec_time, graph_title):

 [print(exec_time) for exec_time in list_exec_time]
 df = pd.DataFrame(exec_times)

 # Plot bar plot using Plotly Express
 fig = px.bar(df, x='library', y='execution_time', title=graph_title)
 fig.show()

plot_metrics(exec_times, "Read Execution Time Comparison")
{'library': 'pandas', 'execution_time': 35.07908916473389}
{'library': 'polars', 'execution_time': 6.041005373001099}
{'library': 'vaex', 'execution_time': 36.431522607803345}
{'library': 'datatable', 'execution_time': 4.4584901332855225}Dạng dictionary của thời gian thực thi cho việc tải dữ liệu
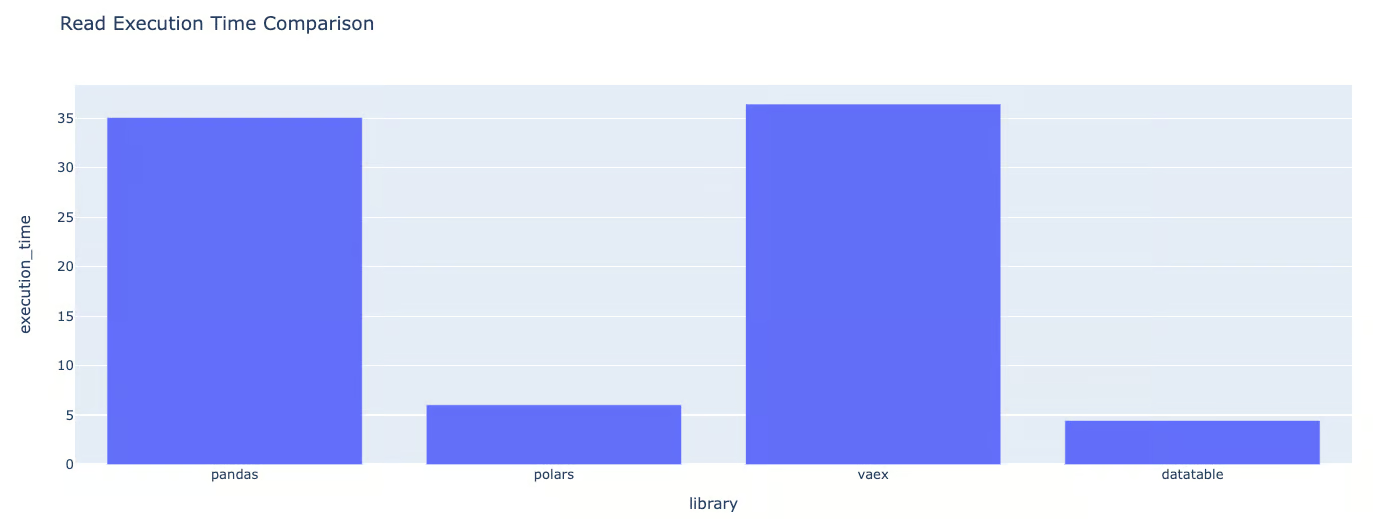
Dạng đồ thị của thời gian thực thi cho việc tải dữ liệu
Dựa trên đồ thị, có thể kết luận rằng Polars:
- Polars chậm hơn Datatable 1,35 lần
- Pandas chậm hơn DataTable 7,87 lần.
- Vaex chậm hơn DataTable xấp xỉ 8,17 lần.
Nhóm dữ liệu
Tương tự, group_data_with_time chịu trách nhiệm theo dõi thời gian thực thi cho việc nhóm cột được truyền vào tham số. Trong trường hợp này, chúng ta sử dụng cột Pregnancies.
from time import time

def group_data_with_time(library_name, df, column_name='Pregnancies'):

 start_time = time()

 if library_name.lower() == 'polars':
     df_grouped = df.group_by(column_name).first()

 elif library_name.lower() == 'vaex':
     df_grouped = df.groupby(column_name, agg='first')

 elif library_name.lower() == 'pandas':
     df_grouped = df.groupby(column_name).first()

 elif library_name.lower() == 'datatable':
     df_grouped = df[:, dt.first(dt.f[:]), dt.by(column_name)]

 else:
     raise ValueError("Invalid library name. Must be 'polars', 'vaex', or 'datatable'")

 end_time = time()

 final_time = end_time - start_time

 return {"library": library_name, "execution_time": final_time}
pandas_time = group_data_with_time('pandas', pandas_df)
polars_time = group_data_with_time('polars', polars_df)
vaex_time = group_data_with_time('vaex', vaex_df)
datatable_time = group_data_with_time('datatable', dt_df)exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Grouping Execution Time Comparison"){'library': 'pandas', 'execution_time': 2.382519245147705}
{'library': 'pandas', 'execution_time'': 1.0898876190185547}
{'library': 'pandas', 'execution_time': 0.8506548404693604}
{'library': 'pandas', 'execution_time': 0.34698963165283203}
Dạng đồ thị của thời gian thực thi cho việc nhóm dữ liệu
Đối với tác vụ nhóm dữ liệu (đã cập nhật), so sánh thư viện nhanh nhất là DataTable với các thư viện còn lại:
Có thể thấy DataTable là nhanh nhất trong số các thư viện được đánh giá.
- Vaex chậm hơn DataTable 2,45 lần.
- Polars chậm hơn DataTable 3,14 lần.
- Pandas chậm hơn DataTable 6,87 lần.
Phân tích này cho thấy hiệu quả vượt trội của DataTable cho các tác vụ nhóm dữ liệu, với Vaex có hiệu năng tương đối gần. Polars và Pandas có thời gian thực thi tương tự nhau, đều chậm đáng kể so với DataTable.
Sắp xếp cột
Với cùng cách tiếp cận, hàm sắp xếp cột sẽ sắp xếp cột được chỉ định bằng từng thư viện.
def sort_data_with_time(library_name, df, column_name='Pregnancies'):

	start_time = time()

	if library_name.lower() == 'polars':
    	df_sorted = df.sort(column_name)
	elif library_name.lower() == 'vaex':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'datatable':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'pandas':
    	df_sorted = pd.DataFrame(df).sort_values(column_name)
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
pandas_time = sort_data_with_time('pandas', pandas_df)
polars_time = sort_data_with_time('polars', polars_df)
vaex_time = sort_data_with_time('vaex', vaex_df)
datatable_time = sort_data_with_time('datatable', dt_df){'library': 'pandas', 'execution_time': 6.735127687454224}
{'library': 'polars', 'execution_time': 4.119458436965942}
{'library': 'vaex', 'execution_time': 1.0371737480163574}
{'library': 'datatable', 'execution_time': 0.3971593379974365}Dạng dictionary của thời gian thực thi cho việc sắp xếp dữ liệu
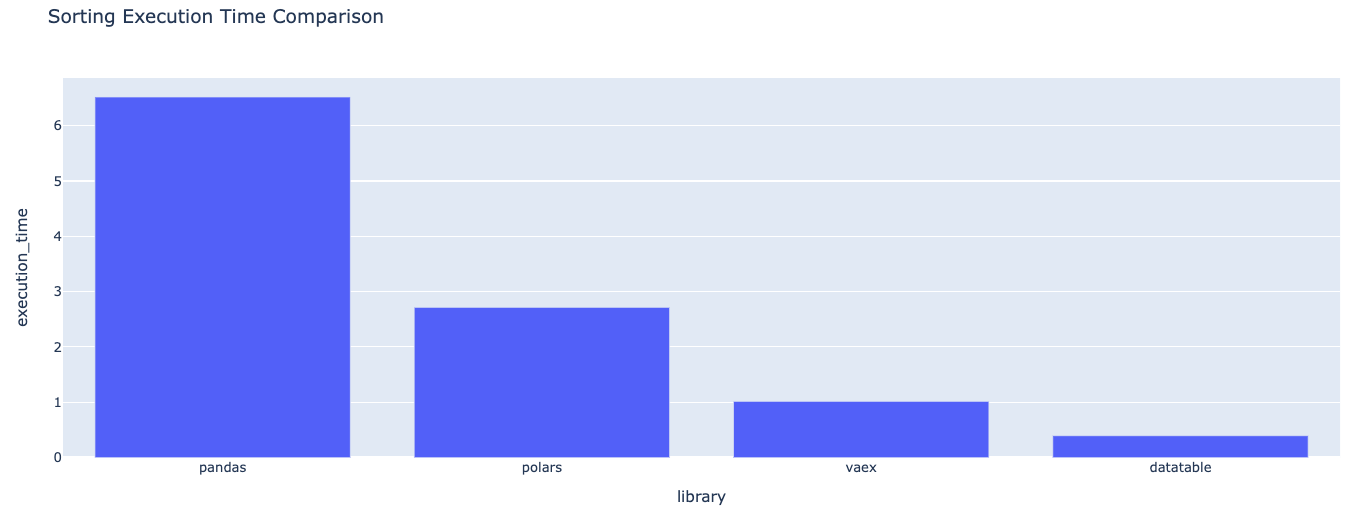
Dạng đồ thị của thời gian thực thi cho việc sắp xếp dữ liệu
Đối với tác vụ sắp xếp dữ liệu, DataTable là nhanh nhất trong số các thư viện được đánh giá.
- Vaex chậm hơn DataTable 2,61 lần.
- Polars chậm hơn DataTable 10,37 lần.
- Pandas chậm hơn DataTable 16,96 lần.
Phân tích này cho thấy hiệu năng vượt trội của DataTable trong xử lý tác vụ sắp xếp dữ liệu, vượt xa Vaex, Polars và Pandas, với Vaex là gần nhất nhưng vẫn chậm hơn hơn gấp đôi.
Chuyển đổi/xuất dữ liệu
Với chuyển đổi/xuất dữ liệu, ý tưởng là chuyển đổi dữ liệu gốc sang một định dạng khác, cụ thể trong trường hợp này là mảng numpy.
def offload_data_with_time(library_name, df):

	start_time = time()

	if library_name.lower() == 'polars':
    	array = df.to_numpy()

	elif library_name.lower() == 'vaex':
    	array = df.to_pandas_df().values

	elif library_name.lower() == 'datatable':
    	array = df.to_numpy()

	elif library_name.lower() == 'pandas':
    	array = pd.DataFrame(df).values
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Data offloading Execution Time Comparison"){'library': 'pandas', 'execution_time': 1.8406445980072021}
{'library': 'polars', 'execution_time': 3.238591432571411}
{'library': 'vaex', 'execution_time': 6.945307970046997}
{'library': 'datatable', 'execution_time': 2.634136438369751}Dạng dictionary của thời gian thực thi cho việc chuyển đổi/xuất dữ liệu
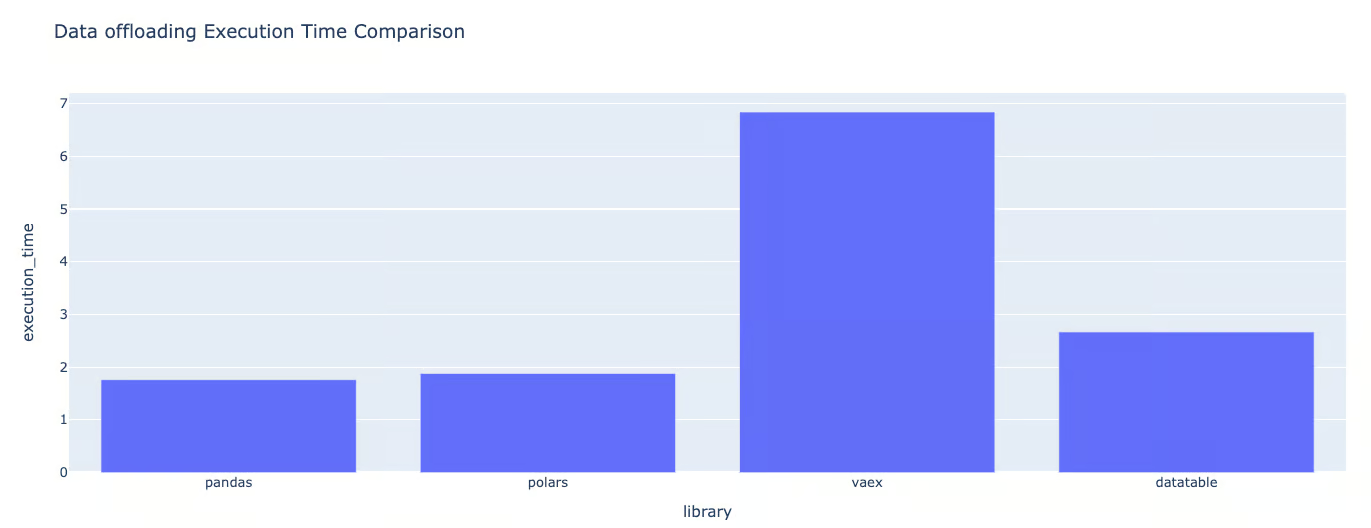
Dạng đồ thị của thời gian thực thi cho việc chuyển đổi/xuất dữ liệu
Chuyển đổi/xuất dữ liệu là vòng cuối cùng trong phần đo thời gian thực thi.
Lần này, Vaex có thời gian thực thi cao nhất. So sánh pandas với các thư viện này, có thể thấy thời gian thực thi của nó xấp xỉ:
- DataTable chậm hơn Pandas 1,43 lần.
- Polars chậm hơn Pandas 1,76 lần.
- Vaex chậm hơn Pandas 3,77 lần.
Đo hiệu năng về mức sử dụng bộ nhớ
Thời gian thực thi không phải là tiêu chí duy nhất khi so sánh các thư viện. Biết cách chúng quản lý bộ nhớ hiệu quả ra sao cũng rất quan trọng. Phần này trình bày hai thước đo sử dụng bộ nhớ bằng thư viện tracemalloc:
- Mức sử dụng bộ nhớ hiện tại. Tổng lượng bộ nhớ được sử dụng trong quá trình thực thi với một thư viện cụ thể. Tương ứng với phần RAM đang bị chiếm dụng tại thời điểm đó.
- Mức sử dụng bộ nhớ đỉnh. Tương ứng với lượng bộ nhớ tối đa mà chương trình sử dụng. Lưu ý rằng bộ nhớ đỉnh luôn cao hơn bộ nhớ hiện tại.
Các trực quan hóa này giúp hiểu chương trình nào sử dụng nhiều bộ nhớ, dễ dẫn đến lỗi hết bộ nhớ, đặc biệt khi làm việc với tập dữ liệu lớn.
Bên cạnh tracemalloc, thư viện os cũng được yêu cầu.
import tracemalloc as tm
import os
Trước khi bắt đầu, chúng ta tạo một danh sách trống để lưu kết quả của từng giá trị sử dụng bộ nhớ.
list_memory_usage = []Với mỗi thư viện, việc ước lượng sử dụng bộ nhớ được thực hiện theo cú pháp tổng quát dưới đây tương ứng với thực thi bằng thư viện Vaex. Ngoài ra, phần này chỉ tập trung vào mức sử dụng bộ nhớ cho tác vụ chuyển đổi/xuất dữ liệu.
tm.start()
vaex_time = offload_data_with_time('vaex', vaex_df)
memory_usage = tm.get_traced_memory()
tm.stop()

list_memory_usage.append({
	'library': 'vaex',
	'memory_usage': memory_usage
})
Cú pháp tương tự cho các thư viện còn lại, và chúng ta có các lệnh sau, lần lượt cho Polars, pandas và Datatable:
tm.start()
polars_time = offload_data_with_time('polars', polars_df)
memory_usage = tm.get_traced_memory()

tm.stop()

list_memory_usage.append({
	'library': 'polars',
	'memory_usage': memory_usage
})
tm.start()
offload_data_with_time('pandas', pandas_df)
# Get the memory usage
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'pandas',
'memory_usage': memory_usage
})tm.start()
datatable_time = offload_data_with_time('datatable', datatable_df)
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'datatable',
'memory_usage': memory_usage
})Sau khi thực thi toàn bộ mã trên, chúng ta có thể vẽ đồ thị bằng hàm hỗ trợ dưới đây:
def plot_memory_usage(list_memory_usage, graph_title='Memory Usage by Library'):

	df = pd.DataFrame(list_memory_usage)

	# separate the memory usage tuple into two columns: current_memory and peak_memory
	df[['current_memory', 'peak_memory']] = pd.DataFrame(df['memory_usage'].tolist(), index=df.index)

	# now we no longer need the memory_usage column
	df = df.drop(columns='memory_usage')

	# melt the DataFrame to make it suitable for grouped bar chart
	df_melted = df.melt(id_vars='library', var_name='memory_type', value_name='memory')

	# create the grouped bar chart
	fig = px.bar(df_melted, x='library', y='memory', color='memory_type', barmode='group',
             	labels={'memory':'Memory Usage (bytes)', 'library':'Library', 'memory_type':'Memory Type'},
             	title=graph_title)

	fig.update_layout(yaxis_type="log")
	fig.show()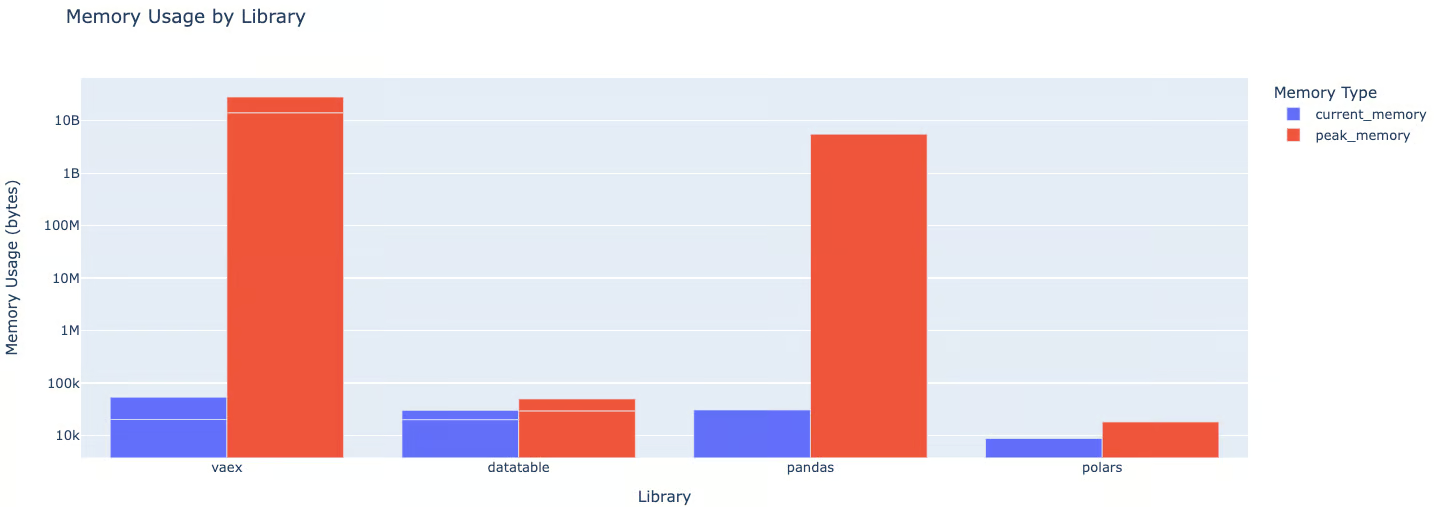
Có thể nhận thấy rằng:
- Pandas dùng bộ nhớ hiện tại nhiều hơn Polars khoảng 1100 lần, nhiều hơn Vaex 7,4 lần và nhiều hơn Datatable 29,4 lần.
- Về mức sử dụng bộ nhớ đỉnh, cả pandas và Vaex đều dùng nhiều hơn Polars khoảng 963 nghìn lần và nhiều hơn Datatable 131 nghìn lần.
Phân tích sâu hơn, như so sánh tốc độ Dask so với pandas, có thể mang lại cái nhìn tổng quan rộng hơn.
Bảng so sánh các lựa chọn thay thế cho Pandas
Bên dưới, chúng tôi tổng hợp phát hiện vào một bảng so sánh, thể hiện khác biệt giữa Polars, Vaex và Datatables:
|
Tiêu chí đo hiệu năng |
Polars |
Vaex |
Datatable |
|
Thời gian tải dữ liệu |
Nhanh hơn Vaex, chậm hơn Datatable |
Chậm hơn cả Polars và Datatable |
Nhanh nhất trong ba |
|
Thời gian nhóm dữ liệu |
Chậm nhất trong ba |
Nhanh hơn Polars, chậm hơn Datatable |
Nhanh nhất trong ba |
|
Thời gian sắp xếp dữ liệu |
Nhanh hơn Vaex, chậm hơn Datatable |
Chậm hơn cả Polars và Datatable |
Nhanh nhất trong ba |
|
Thời gian chuyển đổi/xuất dữ liệu |
Nhanh hơn Vaex, chậm hơn Datatable |
Chậm nhất trong ba |
Nhanh hơn Polars, chậm hơn Vaex |
|
Mức sử dụng bộ nhớ hiện tại |
Dùng ít bộ nhớ nhất |
Dùng nhiều bộ nhớ hơn Polars nhưng ít hơn Datatable |
Dùng nhiều bộ nhớ nhất trong ba |
|
Mức sử dụng bộ nhớ đỉnh |
Dùng ít bộ nhớ nhất |
Dùng nhiều bộ nhớ hơn Polars nhưng ít hơn Datatable |
Dùng nhiều bộ nhớ nhất trong ba |
|
Khả năng mở rộng |
Mở rộng theo kích thước dữ liệu |
Mở rộng theo kích thước dữ liệu, nhưng có thể dùng nhiều bộ nhớ hơn khi dữ liệu tăng |
Mở rộng rất tốt theo kích thước dữ liệu |
|
Mức độ dễ sử dụng |
Có API Python đầy đủ và tương thích với Apache Arrow |
Sử dụng đánh giá lười và tương thích với Pandas |
Cung cấp khả năng tương tác với Pandas/NumPy/thuần Python |
Kết luận
Cần cân nhắc nhiều yếu tố khi phân tích khả năng mở rộng và mức độ dễ tích hợp. Đo hiệu năng của chúng tôi cho thấy mặc dù pandas lâu đời, thân thiện với người dùng và có đường cong học tập dốc, nhưng nó không xử lý hiệu quả các tập dữ liệu lớn.
Tuy nhiên, có nhiều cách có thể áp dụng để tăng tốc pandas, và High-Performance Data Manipulation in Python: Pandas 2.0 vs Polars của chúng tôi có thể giúp bạn.
Hiệu năng của Vaex thay đổi tùy theo tác vụ. Vì vậy, việc chọn lựa thay thế cho Pandas phụ thuộc vào nhu cầu cụ thể của người dùng, kích thước tập dữ liệu và khả năng chinh phục đường cong học tập cũng như tích hợp.

