Introduzione
Pandas è uno strumento straordinariamente potente nell'ecosistema della data science in Python, con numerose funzionalità per la manipolazione e la pulizia dei dati. Tuttavia, pur essendo ottimo per dataset di medie dimensioni, può incontrare problemi di performance con dataset molto grandi, rendendo necessarie alternative ad alte prestazioni.
Questo articolo offre una panoramica completa di alcune di queste alternative e le confronta tramite benchmark in termini di tempo di caricamento dei dati, tempo di esecuzione, uso della memoria, scalabilità e facilità d'uso.
Nota: i risultati dei benchmark variano molto in base alla configurazione hardware.
Capire i benchmark
I benchmark sono punti di riferimento rispetto ai quali è possibile confrontare software o hardware per valutarne le prestazioni. Questo riferimento è fondamentale nell'ottimizzazione delle prestazioni software perché permette di misurare l'efficienza di diversi metodi, algoritmi o strumenti. In questo contesto, le metriche chiave per il benchmarking delle librerie di manipolazione dati includono tempo di esecuzione, uso della memoria, scalabilità e facilità d'uso.
Introduzione alle alternative ad alte prestazioni
Le principali alternative in Python sono Polars, Vaex e Datatable. Prima di entrare nell'analisi comparativa, vediamo rapidamente di cosa si tratta.
Polars
Polars può essere descritto con tre caratteristiche chiave. Primo, offre una completa API Python ricca di funzioni per lavorare con i DataFrame. Secondo, può avere un duplice scopo: può essere usato come libreria per DataFrame o come motore di query sottostante per i modelli di dati. Infine, grazie all'integrazione della sicura implementazione Arrow2 della specifica Apache Arrow, Polars diventa uno strumento altamente efficiente per elaborare grandi volumi di dati.
Puoi dare un'occhiata alla nostra introduzione a Polars, così come a un confronto tra pandas 2.0 e Polars.
Vaex
Vaex è pensato per DataFrame lazy, out-of-core (simili a Pandas) per visualizzare ed esplorare grandi dataset tabellari. Può essere molto efficiente perché posticipa le operazioni fino a quando sono necessarie (lazy evaluation), riducendo uso di memoria e tempo.
Datatable
Datatable può essere utilizzato per l'elaborazione di grandi volumi di dati (fino a 100 GB) su una macchina a singolo nodo alla massima velocità possibile. Una delle caratteristiche importanti di Datatable è l'interoperabilità con Pandas/NumPy/Python puro, che consente di convertire facilmente verso un altro framework di data processing.
Per saperne di più su pandas, il nostro tutorial su DataFrame di pandas in Python è un ottimo punto di partenza.
Inoltre, il pandas Cheat Sheet per la Data Science in Python offre una guida rapida alle basi della libreria di analisi dati in Python, con esempi di codice.
Configurazione dell'ambiente per i benchmark
Questa sezione copre la creazione dei dati per il benchmarking e l'installazione di tutte le librerie coinvolte nell'analisi.
Dati per il benchmarking
Il dataset per il benchmarking è di 5,7 GB, sufficiente per un confronto attendibile. Ogni riga è stata duplicata 100000 volte, per un totale di 76.800.000 righe. I dati sul diabete sono l'originale utilizzato e sono liberamente disponibili su Kaggle.
Il notebook finale del benchmarking è disponibile su GitHub.
import pandas as pd

data_URL = "https://raw.githubusercontent.com/keitazoumana/Experimentation-Data/main/diabetes.csv"

original_data = pd.read_csv(data_URL)

# Duplicate each row 100000 times
benchmarking_df = original_data.loc[original_data.index.repeat(100000)]

# Save the result as a CSV file for future use.
file_name = "benchmarking_data.csv"

benchmarking_df.to_csv(file_name, index=False)
Installazione delle librerie
Ora possiamo procedere con l'installazione di tutte le librerie coinvolte nell'analisi di benchmarking.
Da un ambiente Jupyter notebook, tutta l'installazione viene eseguita con il comando pip install come segue:
%%bash
pip3 -q install -U polars
pip3 -q install vaex
pip -q install datatable
Dopo aver eseguito con successo il blocco di codice sopra, possiamo importarle con l'istruzione import:
import pandas as pd
from time import time
import polars as pl
import vaex as vx
import datatable as dt
Inoltre, utilizziamo la libreria plotly per la visualizzazione.
import plotly.express as pxOra è tutto pronto per procedere con l'analisi di benchmarking.
Benchmarking del tempo di esecuzione
Il tempo di esecuzione verrà valutato per le seguenti operazioni: caricamento dati, offloading dei dati, aggregazione dei dati e filtraggio dei dati. Per ogni attività è implementata una funzione helper che restituirà un dizionario con due chiavi principali: il nome della libreria e il tempo di esecuzione.
La funzione plot metrics viene poi utilizzata per rappresentare graficamente il risultato utilizzando la libreria Plotly Express. Ha due parametri: la lista di tutti i dizionari delle precedenti funzioni helper e il titolo del grafico sottostante.
def plot_metrics(list_exec_time, graph_title):

	df = pd.DataFrame(list_exec_time)

	fig = px.bar(df, x='library', y= 'execution_time', title=graph_title)

	fig.show()
Caricamento dati
La funzione helper read_csv_with_time ha due parametri principali: il nome del file da leggere e il nome della libreria.
def read_csv_with_time(library_name, file_name):

	final_time = 0

	start_time = time.time()

	if library_name.lower() == 'polars':
    	df = pl.read_csv(file_name)

	elif library_name.lower() == 'pandas':
    	df = pd.read_csv(file_name)

	elif library_name.lower() == 'vaex':
    	df = vx.read_csv(file_name)

	elif library_name.lower() == 'datatable':
    	df = dt.fread(file_name)

	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'pandas', 'vaex', or 'datatable'")

	end_time = time.time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
La funzione può essere applicata utilizzando ciascuna delle librerie, partendo da pandas.
pandas_time, pandas_df = read_csv_with_time('pandas', file_name)
polars_time, polars_df = read_csv_with_time('polars', file_name)
vaex_time, vaex_df = read_csv_with_time('vaex', file_name)
datatable_time, dt_df = read_csv_with_time('datatable', file_name)
I dizionari risultanti possono essere combinati in una lista e tracciati usando la seguente espressione.
exec_times = [pandas_time, polars_time,
           vaex_time, datatable_time]

def plot_metrics(list_exec_time, graph_title):

 [print(exec_time) for exec_time in list_exec_time]
 df = pd.DataFrame(exec_times)

 # Plot bar plot using Plotly Express
 fig = px.bar(df, x='library', y='execution_time', title=graph_title)
 fig.show()

plot_metrics(exec_times, "Read Execution Time Comparison")
{'library': 'pandas', 'execution_time': 35.07908916473389}
{'library': 'polars', 'execution_time': 6.041005373001099}
{'library': 'vaex', 'execution_time': 36.431522607803345}
{'library': 'datatable', 'execution_time': 4.4584901332855225}Formato dizionario dei tempi di esecuzione per il caricamento dei dati
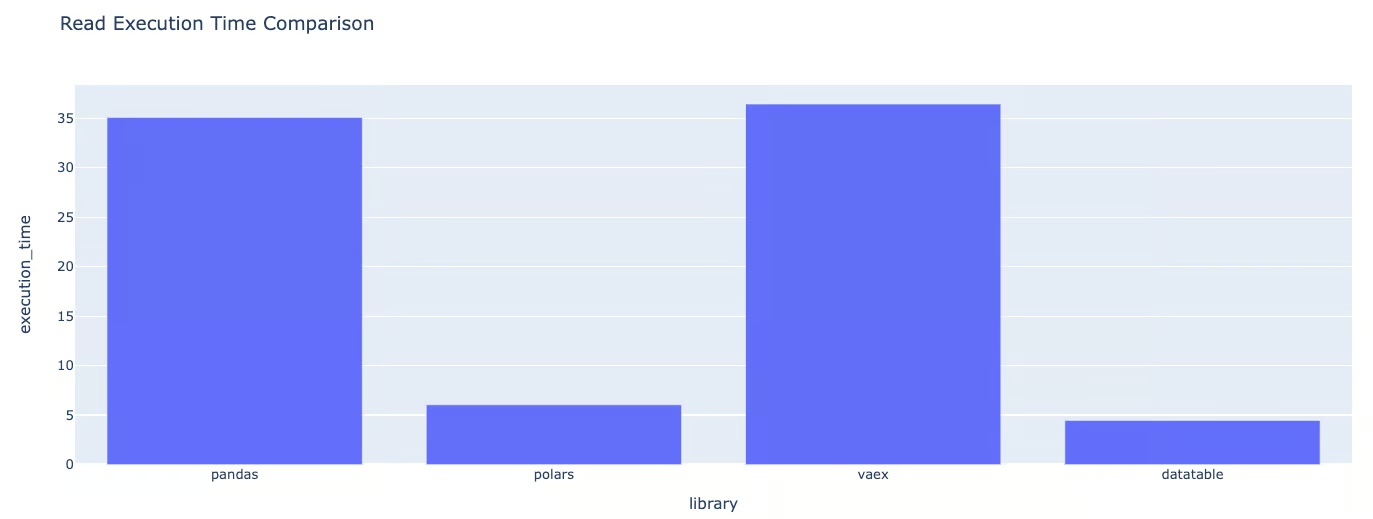
Formato grafico dei tempi di esecuzione per il caricamento dei dati
Dai grafici possiamo concludere che Polars è:
- Polars è 1,35 volte più lento di Datatable
- Pandas è 7,87 volte più lento di DataTable.
- Vaex è circa 8,17 volte più lento di DataTable.
Raggruppamento dati
Allo stesso modo, group_data_with_time si occupa di misurare il tempo di esecuzione per il raggruppamento della colonna fornita come parametro. In questo caso, utilizziamo la colonna Pregnancies.
from time import time

def group_data_with_time(library_name, df, column_name='Pregnancies'):

 start_time = time()

 if library_name.lower() == 'polars':
     df_grouped = df.group_by(column_name).first()

 elif library_name.lower() == 'vaex':
     df_grouped = df.groupby(column_name, agg='first')

 elif library_name.lower() == 'pandas':
     df_grouped = df.groupby(column_name).first()

 elif library_name.lower() == 'datatable':
     df_grouped = df[:, dt.first(dt.f[:]), dt.by(column_name)]

 else:
     raise ValueError("Invalid library name. Must be 'polars', 'vaex', or 'datatable'")

 end_time = time()

 final_time = end_time - start_time

 return {"library": library_name, "execution_time": final_time}
pandas_time = group_data_with_time('pandas', pandas_df)
polars_time = group_data_with_time('polars', polars_df)
vaex_time = group_data_with_time('vaex', vaex_df)
datatable_time = group_data_with_time('datatable', dt_df)exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Grouping Execution Time Comparison"){'library': 'pandas', 'execution_time': 2.382519245147705}
{'library': 'pandas', 'execution_time'': 1.0898876190185547}
{'library': 'pandas', 'execution_time': 0.8506548404693604}
{'library': 'pandas', 'execution_time': 0.34698963165283203}
Formato grafico dei tempi di esecuzione per il raggruppamento dei dati
Per l'attività aggiornata di raggruppamento dati, confrontando la libreria più veloce DataTable con le altre:
Si vede che DataTable è la più veloce tra le librerie valutate.
- Vaex è 2,45 volte più lento di DataTable.
- Polars è 3,14 volte più lento di DataTable.
- Pandas è 6,87 volte più lento di DataTable.
Questa analisi dimostra l'efficienza superiore di DataTable nei compiti di raggruppamento dati, con Vaex relativamente vicino come prestazioni. Polars e Pandas mostrano tempi di esecuzione simili, entrambi significativamente più lenti di DataTable.
Ordinamento di colonne
Con lo stesso approccio, la funzione di ordinamento ordina la colonna indicata utilizzando ciascuna libreria.
def sort_data_with_time(library_name, df, column_name='Pregnancies'):

	start_time = time()

	if library_name.lower() == 'polars':
    	df_sorted = df.sort(column_name)
	elif library_name.lower() == 'vaex':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'datatable':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'pandas':
    	df_sorted = pd.DataFrame(df).sort_values(column_name)
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
pandas_time = sort_data_with_time('pandas', pandas_df)
polars_time = sort_data_with_time('polars', polars_df)
vaex_time = sort_data_with_time('vaex', vaex_df)
datatable_time = sort_data_with_time('datatable', dt_df){'library': 'pandas', 'execution_time': 6.735127687454224}
{'library': 'polars', 'execution_time': 4.119458436965942}
{'library': 'vaex', 'execution_time': 1.0371737480163574}
{'library': 'datatable', 'execution_time': 0.3971593379974365}Formato dizionario dei tempi di esecuzione per l'ordinamento dei dati
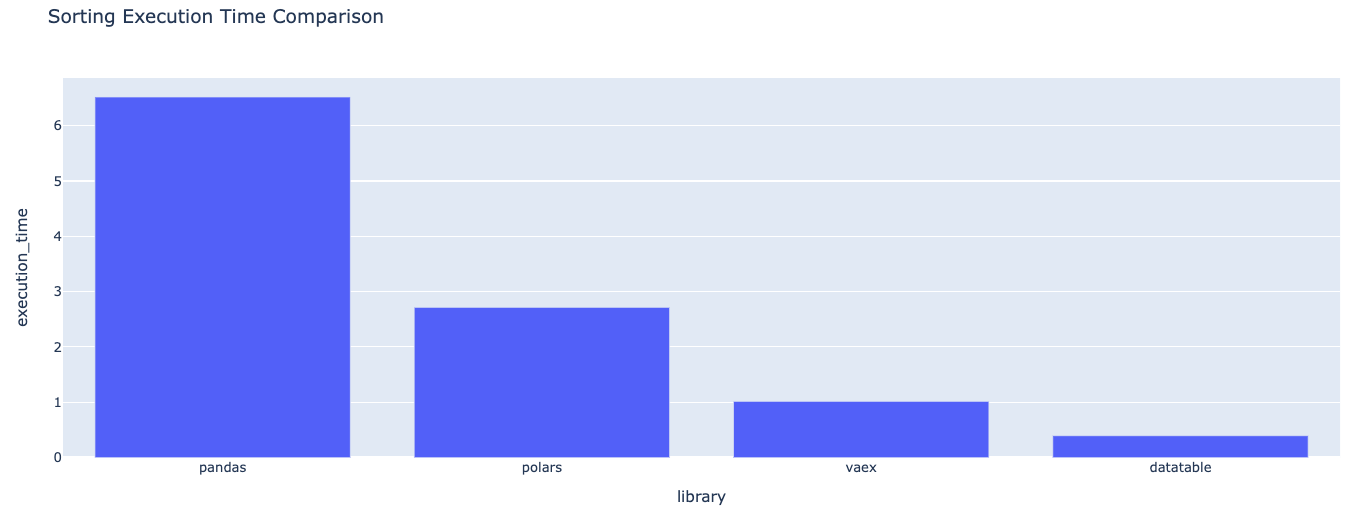
Formato grafico dei tempi di esecuzione per l'ordinamento dei dati
Per il compito di ordinamento, DataTable è la più veloce tra le librerie valutate.
- Vaex è 2,61 volte più lento di DataTable.
- Polars è 10,37 volte più lento di DataTable.
- Pandas è 16,96 volte più lento di DataTable.
Questa analisi mostra le prestazioni superiori di DataTable nella gestione dei compiti di ordinamento, superando nettamente Vaex, Polars e Pandas, con Vaex che è la più vicina in termini di performance ma comunque oltre il doppio più lenta.
Offloading dei dati
Con l'offloading dei dati, l'idea è convertire i dati originali in un formato diverso, in questo caso un array numpy.
def offload_data_with_time(library_name, df):

	start_time = time()

	if library_name.lower() == 'polars':
    	array = df.to_numpy()

	elif library_name.lower() == 'vaex':
    	array = df.to_pandas_df().values

	elif library_name.lower() == 'datatable':
    	array = df.to_numpy()

	elif library_name.lower() == 'pandas':
    	array = pd.DataFrame(df).values
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Data offloading Execution Time Comparison"){'library': 'pandas', 'execution_time': 1.8406445980072021}
{'library': 'polars', 'execution_time': 3.238591432571411}
{'library': 'vaex', 'execution_time': 6.945307970046997}
{'library': 'datatable', 'execution_time': 2.634136438369751}Formato dizionario dei tempi di esecuzione per l'offloading dei dati
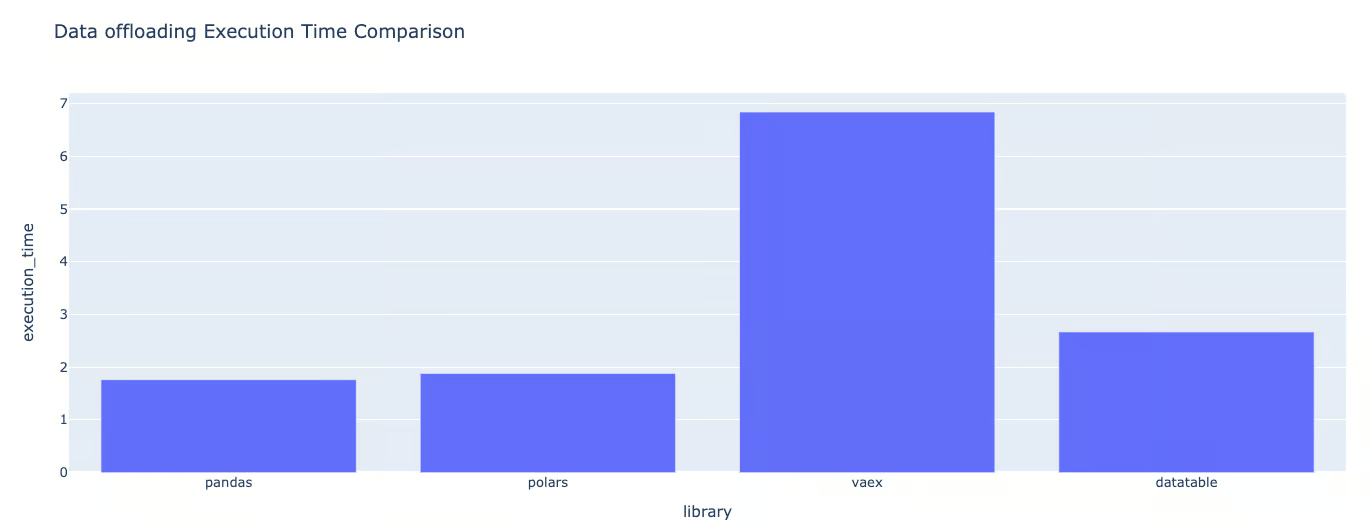
Formato grafico dei tempi di esecuzione per l'offloading dei dati
L'offloading dei dati è l'ultimo round del benchmarking per il tempo di esecuzione.
Questa volta, Vaex è quello con il tempo di esecuzione più alto. Confrontando pandas con queste librerie, vediamo che il suo tempo di esecuzione è approssimativamente:
- DataTable è 1,43 volte più lento di Pandas.
- Polars è 1,76 volte più lento di Pandas.
- Vaex è 3,77 volte più lento di Pandas.
Benchmarking dell'uso della memoria
Il tempo di esecuzione non è l'unico criterio quando si confrontano librerie diverse. È anche importante considerare quanto efficientemente gestiscono la memoria. Questa sezione mostra due diverse misure di utilizzo della memoria utilizzando la libreria tracemalloc:
- Uso corrente della memoria. La quantità totale di memoria utilizzata durante l'esecuzione con una specifica libreria. Corrisponde allo spazio RAM occupato in quel momento.
- Picco di memoria. Corrisponde alla quantità massima di memoria utilizzata dal programma. È importante sapere che il picco di memoria è sempre superiore all'uso corrente della memoria.
Queste visualizzazioni aiutano a capire quale programma utilizza più memoria, portando a errori di out-of-memory, soprattutto quando si lavora con dataset di grandi dimensioni.
Oltre a tracemalloc, è necessaria anche la libreria os.
import tracemalloc as tm
import os
Prima di iniziare, creiamo una lista vuota che conterrà il risultato di ciascun valore di utilizzo della memoria.
list_memory_usage = []Per ciascuna libreria, la stima dell'uso della memoria viene effettuata con la sintassi generale sotto, corrispondente all'esecuzione con la libreria Vaex. Inoltre, ci concentriamo solo sull'uso della memoria per i compiti di offloading dei dati.
tm.start()
vaex_time = offload_data_with_time('vaex', vaex_df)
memory_usage = tm.get_traced_memory()
tm.stop()

list_memory_usage.append({
	'library': 'vaex',
	'memory_usage': memory_usage
})
La sintassi è la stessa per le restanti librerie; otteniamo le seguenti istruzioni, rispettivamente per Polars, pandas e Datatable:
tm.start()
polars_time = offload_data_with_time('polars', polars_df)
memory_usage = tm.get_traced_memory()

tm.stop()

list_memory_usage.append({
	'library': 'polars',
	'memory_usage': memory_usage
})
tm.start()
offload_data_with_time('pandas', pandas_df)
# Get the memory usage
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'pandas',
'memory_usage': memory_usage
})tm.start()
datatable_time = offload_data_with_time('datatable', datatable_df)
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'datatable',
'memory_usage': memory_usage
})Dopo l'esecuzione di tutto il codice precedente, possiamo tracciare il grafico utilizzando la funzione helper seguente:
def plot_memory_usage(list_memory_usage, graph_title='Memory Usage by Library'):

	df = pd.DataFrame(list_memory_usage)

	# separate the memory usage tuple into two columns: current_memory and peak_memory
	df[['current_memory', 'peak_memory']] = pd.DataFrame(df['memory_usage'].tolist(), index=df.index)

	# now we no longer need the memory_usage column
	df = df.drop(columns='memory_usage')

	# melt the DataFrame to make it suitable for grouped bar chart
	df_melted = df.melt(id_vars='library', var_name='memory_type', value_name='memory')

	# create the grouped bar chart
	fig = px.bar(df_melted, x='library', y='memory', color='memory_type', barmode='group',
             	labels={'memory':'Memory Usage (bytes)', 'library':'Library', 'memory_type':'Memory Type'},
             	title=graph_title)

	fig.update_layout(yaxis_type="log")
	fig.show()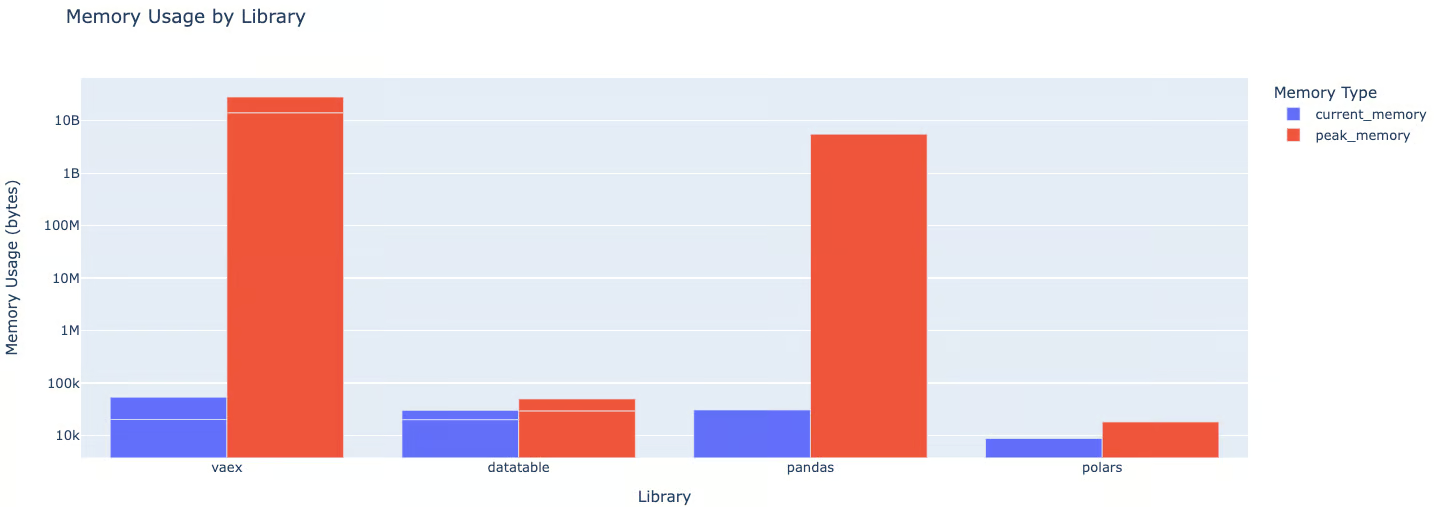
Possiamo notare che:
- Pandas utilizza circa 1100 volte più memoria corrente di Polars, 7,4 volte più di Vaex e 29,4 volte più di Datatable.
- Per quanto riguarda il picco di memoria, sia pandas che Vaex utilizzano circa 963.000 volte più memoria di Polars e 131.000 volte più di Datatable.
Ulteriori analisi, come la velocità di Dask vs pandas, potrebbero offrire una panoramica più ampia.
Tabella di confronto delle alternative a pandas
Di seguito, abbiamo riassunto i risultati in una tabella di confronto, che mostra le differenze tra Polars, Vaex e Datatables:
|
Criterio di benchmark |
Polars |
Vaex |
Datatable |
|
Tempo di caricamento dati |
Più veloce di Vaex, più lento di Datatable |
Più lento sia di Polars che di Datatable |
Il più veloce tra i tre |
|
Tempo di raggruppamento dati |
Il più lento tra i tre |
Più veloce di Polars, più lento di Datatable |
Il più veloce tra i tre |
|
Tempo di ordinamento dati |
Più veloce di Vaex, più lento di Datatable |
Più lento sia di Polars che di Datatable |
Il più veloce tra i tre |
|
Tempo di offloading dei dati |
Più veloce di Vaex, più lento di Datatable |
Il più lento tra i tre |
Più veloce di Polars, più lento di Vaex |
|
Uso corrente della memoria |
Usa meno memoria |
Usa più memoria di Polars ma meno di Datatable |
Usa più memoria tra i tre |
|
Picco di memoria |
Usa meno memoria |
Usa più memoria di Polars ma meno di Datatable |
Usa più memoria tra i tre |
|
Scalabilità |
Scalabile con la dimensione dei dati |
Scalabile con la dimensione dei dati, ma può usare più memoria all'aumentare dei dati |
Altamente scalabile con la dimensione dei dati |
|
Facilità d'uso |
Ha una completa API Python ed è compatibile con Apache Arrow |
Utilizza la valutazione lazy ed è compatibile con Pandas |
Offre interoperabilità con Pandas/NumPy/Python puro |
Conclusione
Diversi fattori devono essere considerati quando si analizzano scalabilità e facilità d'integrazione. Il nostro benchmarking ha evidenziato che, sebbene pandas sia consolidato e facile da usare e abbia una curva di apprendimento più ripida, non gestisce in modo efficiente i dataset di grandi dimensioni.
Tuttavia, esistono diversi modi che si possono adottare per velocizzare pandas, e il nostro High-Performance Data Manipulation in Python: Pandas 2.0 vs Polars può aiutarti in questo.
Le prestazioni di Vaex variano a seconda del compito. Quindi, la scelta di un'alternativa a Pandas dipende dalle esigenze specifiche degli utenti, dalle dimensioni del dataset e dalla loro capacità di affrontare la curva di apprendimento e l'integrazione.




