Introducción
Pandas es una herramienta extraordinariamente potente dentro del ecosistema de ciencia de datos en Python, con múltiples capacidades para manipular y limpiar datos. Sin embargo, aunque funciona muy bien con conjuntos de datos medianos, puede tener problemas de rendimiento al trabajar con datos masivos, lo que nos lleva a buscar alternativas de alto rendimiento.
En este artículo repasamos algunas de esas alternativas y las comparamos mediante benchmarks en términos de tiempo de carga de datos, tiempo de ejecución, uso de memoria, escalabilidad y facilidad de uso.
Nota: los resultados de los benchmarks pueden variar mucho según tu hardware.
Cómo entender los benchmarks
Los benchmarks son un punto de referencia con el que comparar software o hardware para evaluar su rendimiento. Son clave en la optimización de rendimiento porque permiten medir la eficiencia de distintos métodos, algoritmos o herramientas. En este contexto, las métricas principales para evaluar librerías de manipulación de datos son el tiempo de ejecución, el uso de memoria, la escalabilidad y la facilidad de uso.
Alternativas de alto rendimiento
Las principales alternativas en Python son Polars, Vaex y Datatable. Antes de entrar en la comparación, hagamos una breve introducción a cada una.
Polars
Polars se puede resumir en tres rasgos clave. Primero, ofrece una API de Python muy completa, con numerosas funciones para trabajar con DataFrames. Segundo, sirve a un doble propósito: puede usarse como librería de DataFrames o como motor de consultas subyacente para modelos de datos. Por último, al incorporar la implementación segura Arrow2 de la especificación Apache Arrow, Polars se convierte en una herramienta altamente eficiente para procesar grandes volúmenes de datos.
Puedes echar un vistazo a nuestro tutorial de introducción a Polars, así como a la comparativa entre pandas 2.0 y Polars.
Vaex
Vaex ofrece DataFrames perezosos (lazy) y out-of-core (similares a pandas) para visualizar y explorar grandes conjuntos de datos tabulares. Puede ser muy eficiente, ya que retrasa las operaciones hasta que son necesarias (evaluación perezosa), reduciendo el uso de memoria y el tiempo.
Datatable
Datatable permite procesar grandes volúmenes de datos (hasta 100 GB) en una máquina de un solo nodo a la máxima velocidad posible. Una de sus características más importantes es su interoperabilidad con Pandas/NumPy/Python puro, lo que facilita convertir los datos a otros marcos de procesamiento.
Si quieres aprender más sobre pandas, nuestro tutorial de DataFrames en Python con pandas es un gran punto de partida.
Además, la chuleta de pandas para ciencia de datos en Python ofrece una guía rápida de lo básico de la librería, con ejemplos de código.
Configuración del entorno de benchmarking
En esta sección se explica cómo crear los datos del benchmark e instalar todas las librerías utilizadas en el análisis.
Datos para el benchmark
El conjunto de datos del benchmark ocupa 5,7 GB, suficiente para una comparación razonable. Cada fila se ha duplicado 100000 veces, dando como resultado 76 800 000 filas. El conjunto original utilizado es el de Diabetes, disponible gratuitamente en Kaggle.
El cuaderno final del benchmark está disponible en GitHub.
import pandas as pd

data_URL = "https://raw.githubusercontent.com/keitazoumana/Experimentation-Data/main/diabetes.csv"

original_data = pd.read_csv(data_URL)

# Duplicate each row 100000 times
benchmarking_df = original_data.loc[original_data.index.repeat(100000)]

# Save the result as a CSV file for future use.
file_name = "benchmarking_data.csv"

benchmarking_df.to_csv(file_name, index=False)
Instalación de las librerías
Ahora podemos instalar todas las librerías que intervienen en el análisis del benchmark.
Desde un entorno Jupyter Notebook, la instalación se realiza con pip install de la siguiente forma:
%%bash
pip3 -q install -U polars
pip3 -q install vaex
pip -q install datatable
Tras ejecutar correctamente el bloque anterior, las importamos con las sentencias import:
import pandas as pd
from time import time
import polars as pl
import vaex as vx
import datatable as dt
Además, usamos la librería plotly para la visualización.
import plotly.express as pxCon esto ya estamos listos para seguir con el benchmark.
Benchmark de tiempo de ejecución
Evaluaremos el tiempo de ejecución para las siguientes operaciones: carga de datos, exportación de datos, agregación y filtrado. Para cada tarea implementamos una función auxiliar que devuelve un diccionario con dos claves principales: el nombre de la librería y el tiempo de ejecución.
Después, la función plot metrics representa los resultados de forma gráfica con Plotly Express. Tiene dos parámetros: la lista con todos los diccionarios devueltos por las funciones auxiliares y el título del gráfico.
def plot_metrics(list_exec_time, graph_title):

	df = pd.DataFrame(list_exec_time)

	fig = px.bar(df, x='library', y= 'execution_time', title=graph_title)

	fig.show()
Carga de datos
La función auxiliar read_csv_with_time tiene dos parámetros principales: el nombre del archivo a leer y la librería.
def read_csv_with_time(library_name, file_name):

	final_time = 0

	start_time = time.time()

	if library_name.lower() == 'polars':
    	df = pl.read_csv(file_name)

	elif library_name.lower() == 'pandas':
    	df = pd.read_csv(file_name)

	elif library_name.lower() == 'vaex':
    	df = vx.read_csv(file_name)

	elif library_name.lower() == 'datatable':
    	df = dt.fread(file_name)

	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'pandas', 'vaex', or 'datatable'")

	end_time = time.time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
Podemos aplicarla con cada librería, empezando por pandas.
pandas_time, pandas_df = read_csv_with_time('pandas', file_name)
polars_time, polars_df = read_csv_with_time('polars', file_name)
vaex_time, vaex_df = read_csv_with_time('vaex', file_name)
datatable_time, dt_df = read_csv_with_time('datatable', file_name)
Los diccionarios resultantes se combinan en una lista y se representan así:
exec_times = [pandas_time, polars_time,
           vaex_time, datatable_time]

def plot_metrics(list_exec_time, graph_title):

 [print(exec_time) for exec_time in list_exec_time]
 df = pd.DataFrame(exec_times)

 # Plot bar plot using Plotly Express
 fig = px.bar(df, x='library', y='execution_time', title=graph_title)
 fig.show()

plot_metrics(exec_times, "Read Execution Time Comparison")
{'library': 'pandas', 'execution_time': 35.07908916473389}
{'library': 'polars', 'execution_time': 6.041005373001099}
{'library': 'vaex', 'execution_time': 36.431522607803345}
{'library': 'datatable', 'execution_time': 4.4584901332855225}Formato diccionario de los tiempos de ejecución en la carga de datos
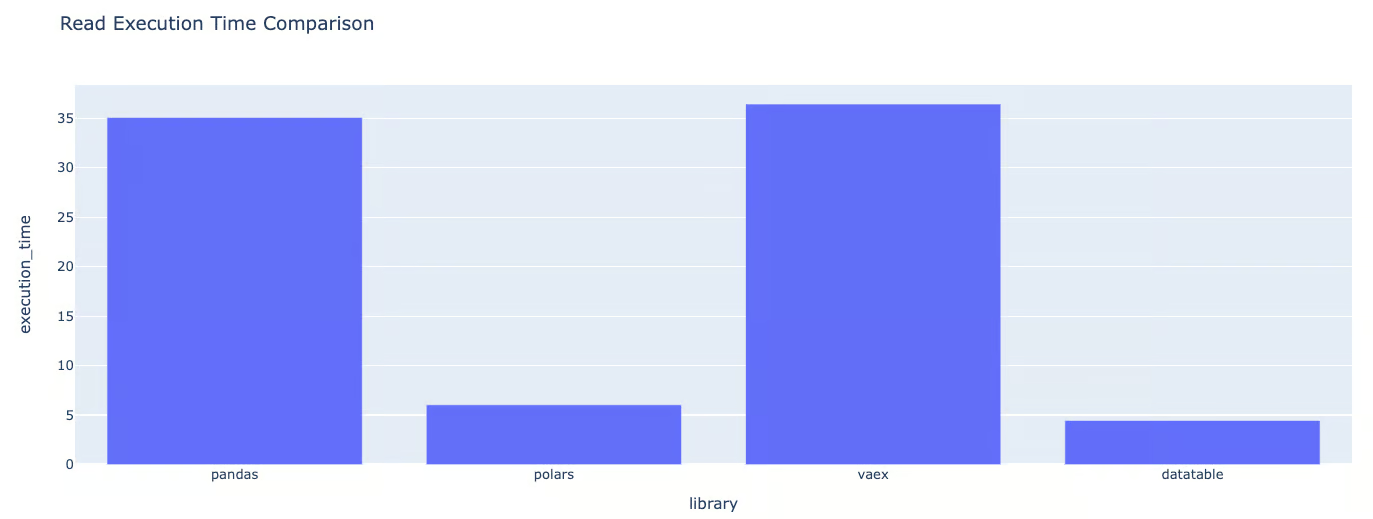
Formato gráfico de los tiempos de ejecución en la carga de datos
A partir de las gráficas, podemos concluir que:
- Polars es 1,35 veces más lento que Datatable.
- Pandas es 7,87 veces más lento que Datatable.
- Vaex es aproximadamente 8,17 veces más lento que Datatable.
Agrupación de datos
De forma similar, group_data_with_time mide el tiempo de ejecución al agrupar por la columna indicada. En este caso, usamos la columna Pregnancies.
from time import time

def group_data_with_time(library_name, df, column_name='Pregnancies'):

 start_time = time()

 if library_name.lower() == 'polars':
     df_grouped = df.group_by(column_name).first()

 elif library_name.lower() == 'vaex':
     df_grouped = df.groupby(column_name, agg='first')

 elif library_name.lower() == 'pandas':
     df_grouped = df.groupby(column_name).first()

 elif library_name.lower() == 'datatable':
     df_grouped = df[:, dt.first(dt.f[:]), dt.by(column_name)]

 else:
     raise ValueError("Invalid library name. Must be 'polars', 'vaex', or 'datatable'")

 end_time = time()

 final_time = end_time - start_time

 return {"library": library_name, "execution_time": final_time}
pandas_time = group_data_with_time('pandas', pandas_df)
polars_time = group_data_with_time('polars', polars_df)
vaex_time = group_data_with_time('vaex', vaex_df)
datatable_time = group_data_with_time('datatable', dt_df)exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Grouping Execution Time Comparison"){'library': 'pandas', 'execution_time': 2.382519245147705}
{'library': 'pandas', 'execution_time'': 1.0898876190185547}
{'library': 'pandas', 'execution_time': 0.8506548404693604}
{'library': 'pandas', 'execution_time': 0.34698963165283203}
Formato gráfico de los tiempos de ejecución en la agrupación de datos
Para la tarea de agrupación, comparando la librería más rápida, Datatable, con el resto:
Se observa que Datatable es la más rápida entre las evaluadas.
- Vaex es 2,45 veces más lento que Datatable.
- Polars es 3,14 veces más lento que Datatable.
- Pandas es 6,87 veces más lento que Datatable.
Este análisis demuestra la superior eficiencia de Datatable en tareas de agrupación de datos, con Vaex relativamente cerca. Polars y pandas presentan tiempos similares, ambos significativamente más lentos que Datatable.
Ordenación de columnas
Con el mismo enfoque, la función de ordenación clasifica la columna indicada con cada librería.
def sort_data_with_time(library_name, df, column_name='Pregnancies'):

	start_time = time()

	if library_name.lower() == 'polars':
    	df_sorted = df.sort(column_name)
	elif library_name.lower() == 'vaex':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'datatable':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'pandas':
    	df_sorted = pd.DataFrame(df).sort_values(column_name)
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
pandas_time = sort_data_with_time('pandas', pandas_df)
polars_time = sort_data_with_time('polars', polars_df)
vaex_time = sort_data_with_time('vaex', vaex_df)
datatable_time = sort_data_with_time('datatable', dt_df){'library': 'pandas', 'execution_time': 6.735127687454224}
{'library': 'polars', 'execution_time': 4.119458436965942}
{'library': 'vaex', 'execution_time': 1.0371737480163574}
{'library': 'datatable', 'execution_time': 0.3971593379974365}Formato diccionario de los tiempos de ejecución en la ordenación
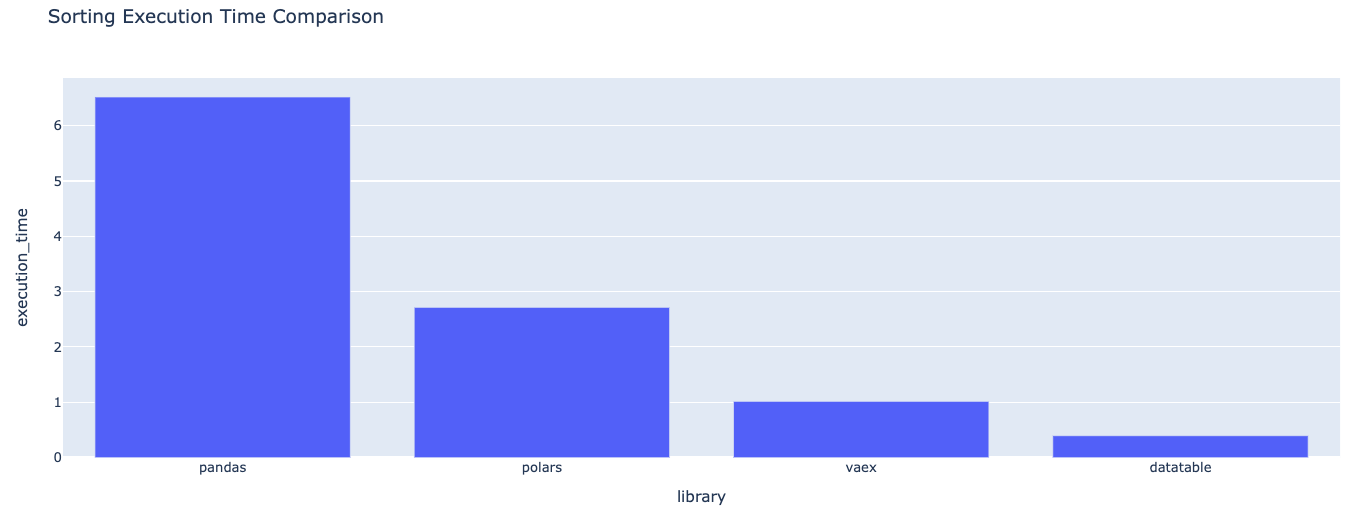
Formato gráfico de los tiempos de ejecución en la ordenación
En la ordenación de datos, Datatable es la más rápida entre las librerías evaluadas.
- Vaex es 2,61 veces más lento que Datatable.
- Polars es 10,37 veces más lento que Datatable.
- Pandas es 16,96 veces más lento que Datatable.
Este análisis muestra el claro liderazgo de Datatable en tareas de ordenación, superando con holgura a Vaex, Polars y pandas; Vaex es la que más se acerca, aunque sigue siendo más del doble de lenta.
Exportación/descarga de datos
En la exportación de datos, la idea es convertir los datos originales a otro formato; en este caso, a un array de NumPy.
def offload_data_with_time(library_name, df):

	start_time = time()

	if library_name.lower() == 'polars':
    	array = df.to_numpy()

	elif library_name.lower() == 'vaex':
    	array = df.to_pandas_df().values

	elif library_name.lower() == 'datatable':
    	array = df.to_numpy()

	elif library_name.lower() == 'pandas':
    	array = pd.DataFrame(df).values
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Data offloading Execution Time Comparison"){'library': 'pandas', 'execution_time': 1.8406445980072021}
{'library': 'polars', 'execution_time': 3.238591432571411}
{'library': 'vaex', 'execution_time': 6.945307970046997}
{'library': 'datatable', 'execution_time': 2.634136438369751}Formato diccionario de los tiempos de ejecución en la exportación de datos
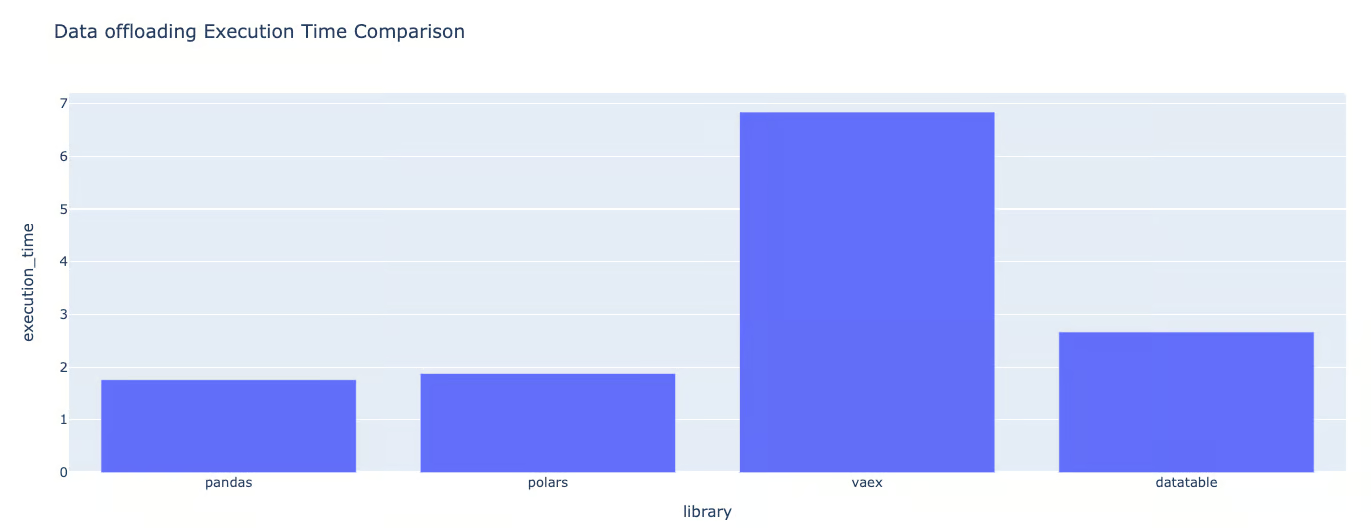
Formato gráfico de los tiempos de ejecución en la exportación de datos
La exportación de datos cierra la ronda de benchmarks de tiempo de ejecución.
En este caso, Vaex es la que más tarda. Comparando pandas con el resto, su tiempo de ejecución es aproximadamente:
- Datatable es 1,43 veces más lento que pandas.
- Polars es 1,76 veces más lento que pandas.
- Vaex es 3,77 veces más lento que pandas.
Benchmark de uso de memoria
El tiempo de ejecución no es el único criterio al comparar librerías. También es importante saber cómo gestionan la memoria. En esta sección mostramos dos métricas de uso de memoria con la librería tracemalloc:
- Uso de memoria actual. Cantidad total de memoria utilizada durante la ejecución con una librería concreta. Corresponde al espacio de RAM ocupado en ese momento.
- Pico de memoria. Máxima cantidad de memoria usada por el programa. Ten en cuenta que el pico siempre es mayor que la memoria actual.
Visualizar estas métricas ayuda a entender qué programa consume más memoria y puede llevar a errores de falta de memoria, especialmente con datasets muy grandes.
Además de tracemalloc, también necesitaremos la librería os.
import tracemalloc as tm
import os
Antes de empezar, creamos una lista vacía donde almacenaremos los resultados de cada medición.
list_memory_usage = []Para cada librería, estimamos el uso de memoria con la sintaxis general que se muestra abajo para Vaex. Nos centramos únicamente en el uso de memoria de la tarea de exportación de datos.
tm.start()
vaex_time = offload_data_with_time('vaex', vaex_df)
memory_usage = tm.get_traced_memory()
tm.stop()

list_memory_usage.append({
	'library': 'vaex',
	'memory_usage': memory_usage
})
La sintaxis es la misma para el resto, y obtenemos las siguientes instrucciones, respectivamente para Polars, pandas y Datatable:
tm.start()
polars_time = offload_data_with_time('polars', polars_df)
memory_usage = tm.get_traced_memory()

tm.stop()

list_memory_usage.append({
	'library': 'polars',
	'memory_usage': memory_usage
})
tm.start()
offload_data_with_time('pandas', pandas_df)
# Get the memory usage
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'pandas',
'memory_usage': memory_usage
})tm.start()
datatable_time = offload_data_with_time('datatable', datatable_df)
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'datatable',
'memory_usage': memory_usage
})Tras ejecutar todo el código anterior, representamos el gráfico con esta función auxiliar:
def plot_memory_usage(list_memory_usage, graph_title='Memory Usage by Library'):

	df = pd.DataFrame(list_memory_usage)

	# separate the memory usage tuple into two columns: current_memory and peak_memory
	df[['current_memory', 'peak_memory']] = pd.DataFrame(df['memory_usage'].tolist(), index=df.index)

	# now we no longer need the memory_usage column
	df = df.drop(columns='memory_usage')

	# melt the DataFrame to make it suitable for grouped bar chart
	df_melted = df.melt(id_vars='library', var_name='memory_type', value_name='memory')

	# create the grouped bar chart
	fig = px.bar(df_melted, x='library', y='memory', color='memory_type', barmode='group',
             	labels={'memory':'Memory Usage (bytes)', 'library':'Library', 'memory_type':'Memory Type'},
             	title=graph_title)

	fig.update_layout(yaxis_type="log")
	fig.show()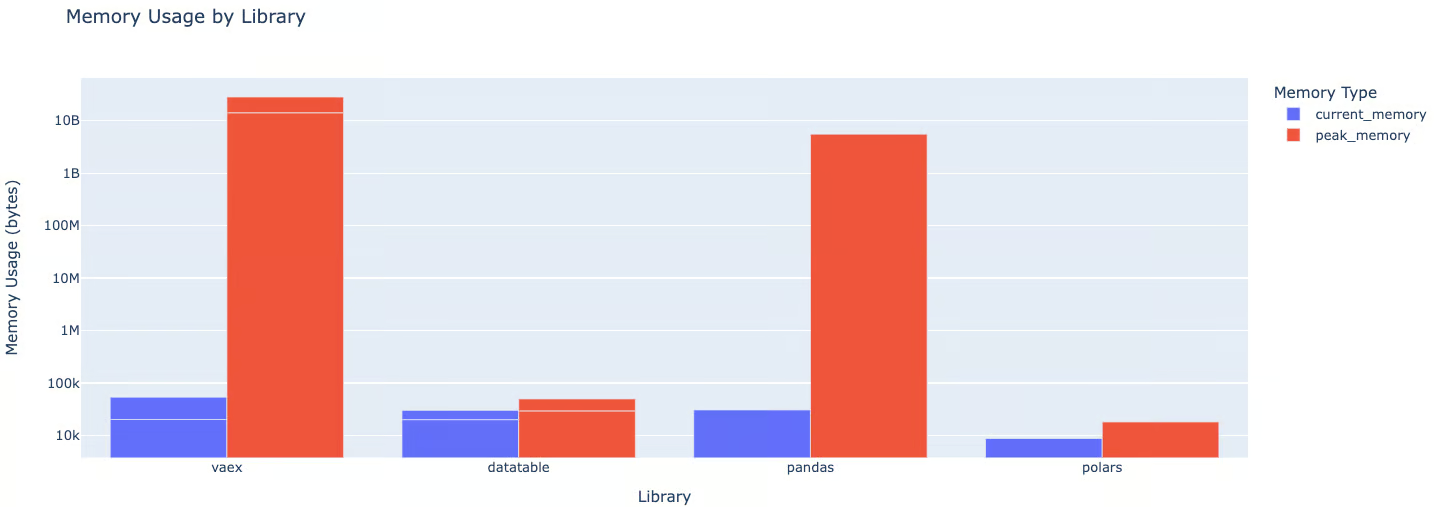
Podemos observar que:
- Pandas usa aproximadamente 1100 veces más memoria actual que Polars, 7,4 veces más que Vaex y 29,4 veces más que Datatable.
- En el pico de memoria, tanto pandas como Vaex usan alrededor de 963 mil veces más que Polars y 131 mil veces más que Datatable.
Un análisis adicional, como una comparativa de velocidad entre Dask y pandas, podría ofrecer una visión más amplia.
Tabla comparativa de alternativas a pandas
A continuación, reunimos los hallazgos en una tabla comparativa con las diferencias entre Polars, Vaex y Datatable:
|
Criterio del benchmark |
Polars |
Vaex |
Datatable |
|
Tiempo de carga |
Más rápido que Vaex, más lento que Datatable |
Más lento que Polars y Datatable |
El más rápido de los tres |
|
Tiempo de agrupación |
El más lento de los tres |
Más rápido que Polars, más lento que Datatable |
El más rápido de los tres |
|
Tiempo de ordenación |
Más rápido que Vaex, más lento que Datatable |
Más lento que Polars y Datatable |
El más rápido de los tres |
|
Tiempo de exportación |
Más rápido que Vaex, más lento que Datatable |
El más lento de los tres |
Más rápido que Polars, más lento que Vaex |
|
Memoria actual |
La que menos memoria usa |
Usa más que Polars pero menos que Datatable |
La que más memoria usa |
|
Pico de memoria |
La que menos memoria usa |
Usa más que Polars pero menos que Datatable |
La que más memoria usa |
|
Escalabilidad |
Escala con el tamaño de los datos |
Escala con el tamaño, pero puede usar más memoria al crecer |
Alta capacidad de escala con el tamaño de los datos |
|
Facilidad de uso |
API de Python completa y compatible con Apache Arrow |
Evaluación perezosa y compatible con pandas |
Interoperabilidad con Pandas/NumPy/Python puro |
Conclusión
Al analizar escalabilidad y facilidad de integración hay que considerar varios factores. Nuestros benchmarks ponen de relieve que, aunque pandas está muy asentada y es fácil de usar y aprender, no gestiona con eficiencia los conjuntos de datos muy grandes.
Dicho esto, hay distintas formas de acelerar pandas, y nuestra guía High-Performance Data Manipulation in Python: Pandas 2.0 vs Polars puede ayudarte.
El rendimiento de Vaex varía según la tarea. En definitiva, elegir una alternativa a pandas depende de las necesidades concretas, el tamaño de los datos y la disposición para asumir la curva de aprendizaje y la integración.