परिचय
Pandas, Python के डेटा साइंस इकोसिस्टम में एक असाधारण रूप से शक्तिशाली टूल है, जो डेटा में बदलाव और सफाई की कई क्षमताएँ प्रदान करता है। हालांकि, मध्यम आकार के डेटासेट के लिए यह शानदार है, बड़े डेटासेट पर काम करते समय इसमें प्रदर्शन से जुड़ी समस्याएँ आ सकती हैं, जिससे उच्च-प्रदर्शन विकल्पों की आवश्यकता महसूस होती है।
यह व्यापक लेख इन विकल्पों का परिचय देता है और डेटा लोडिंग समय, निष्पादन समय, मेमोरी उपयोग, स्केलेबिलिटी और उपयोग में सरलता के संदर्भ में बेंचमार्किंग के जरिए उनकी तुलना करता है।
नोट: बेंचमार्किंग के परिणाम आपके हार्डवेयर सेटअप के अनुसार काफी भिन्न हो सकते हैं।
बेंचमार्क्स को समझना
बेंचमार्क वह संदर्भ बिंदु होते हैं जिनके आधार पर सॉफ्टवेयर या हार्डवेयर के प्रदर्शन का मूल्यांकन किया जा सकता है। सॉफ्टवेयर प्रदर्शन अनुकूलन में यह संदर्भ इसलिए महत्त्वपूर्ण है क्योंकि यह विभिन्न विधियों, एल्गोरिद्मों या टूल्स की दक्षता मापने की सुविधा देता है। इस संदर्भ में, डेटा मैनिपुलेशन लाइब्रेरियों की बेंचमार्किंग के प्रमुख मेट्रिक्स हैं: निष्पादन समय, मेमोरी उपयोग, स्केलेबिलिटी, और उपयोग में सरलता।
उच्च-प्रदर्शन विकल्पों का परिचय
मुख्य वैकल्पिक Python टूल्स हैं Polars, Vaex, और Datatable। उनकी तुलनात्मक समीक्षा में जाने से पहले, प्रत्येक टूल का संक्षिप्त अवलोकन कर लेते हैं।
Polars
Polars को तीन प्रमुख विशेषताएँ परिभाषित करती हैं। पहला, यह DataFrames को संभालने के लिए अनेक फंक्शनों से भरा एक व्यापक Python API प्रदान करता है। दूसरा, यह द्वि-उद्देश्यीय है — इसे DataFrames के लिए लाइब्रेरी की तरह या डेटा मॉडलों के लिए अंतर्निहित क्वेरी इंजन की तरह उपयोग किया जा सकता है। तीसरा, Apache Arrow स्पेसिफिकेशन के सुरक्षित Arrow2 इम्प्लीमेंटेशन को सम्मिलित करने से Polars बड़े पैमाने पर डेटा प्रोसेसिंग के लिए अत्यंत कुशल टूल बन जाता है।
आप हमारा Polars का परिचय ट्यूटोरियल और pandas 2.0 और Polars की तुलना देख सकते हैं।
Vaex
Vaex लेज़ी, आउट-ऑफ-कोर DataFrames (Pandas के समान) के लिए है, ताकि बड़े टैब्यूलर डेटासेट का विज़ुअलाइज़ेशन और अन्वेषण किया जा सके। यह ऑपरेशन को आवश्यक होने तक टालकर (लेज़ी इवैल्यूएशन) मेमोरी उपयोग और समय कम कर, बहुत प्रभावी हो सकता है।
Datatable
Datatable का उपयोग एकल-नोड मशीन पर अधिकतम संभव गति से बड़े डेटा प्रोसेसिंग (100GB तक) के लिए किया जा सकता है। Datatable की एक महत्त्वपूर्ण विशेषता है इसका Pandas/NumPy/शुद्ध Python के साथ इंटरऑपरेबिलिटी, जो उपयोगकर्ताओं को किसी अन्य डेटा-प्रोसेसिंग फ्रेमवर्क में आसानी से रूपांतरण करने देता है।
pandas के बारे में और जानने के लिए, हमारा pandas ट्यूटोरियल: Python में DataFrames एक बेहतरीन शुरुआती संसाधन है।
साथ ही, pandas चीट शीट फॉर डेटा साइंस इन Python मूल बातें और कोड नमूनों का त्वरित मार्गदर्शन देती है।
बेंचमार्किंग वातावरण तैयार करना
इस खंड में बेंचमार्किंग डेटा का निर्माण और बेंचमार्किंग विश्लेषण में शामिल सभी लाइब्रेरियों की स्थापना शामिल है।
बेंचमार्किंग डेटा
बेंचमार्किंग डेटासेट 5.7 GB का है, जो एक अच्छी तुलना करने के लिए पर्याप्त बड़ा है। प्रत्येक पंक्ति को 100000 बार डुप्लिकेट किया गया है, जिससे 76,800,000 पंक्तियाँ बनती हैं। Diabetes डेटा मूल डेटा है जिसका उपयोग किया गया है और यह Kaggle पर नि:शुल्क उपलब्ध है।
अंतिम बेंचमार्किंग नोटबुक GitHub पर उपलब्ध है।
import pandas as pd

data_URL = "https://raw.githubusercontent.com/keitazoumana/Experimentation-Data/main/diabetes.csv"

original_data = pd.read_csv(data_URL)

# Duplicate each row 100000 times
benchmarking_df = original_data.loc[original_data.index.repeat(100000)]

# Save the result as a CSV file for future use.
file_name = "benchmarking_data.csv"

benchmarking_df.to_csv(file_name, index=False)
लाइब्रेरियों की स्थापना
अब, हम बेंचमार्किंग विश्लेषण में शामिल सभी लाइब्रेरियों की स्थापना कर सकते हैं।
Jupyter नोटबुक वातावरण से, सारी स्थापना निम्न प्रकार pip install कमांड से की जाती है:
%%bash
pip3 -q install -U polars
pip3 -q install vaex
pip -q install datatable
उपरोक्त कोड ब्लॉक को सफलतापूर्वक चलाने के बाद, हम इन्हें import स्टेटमेंट से इम्पोर्ट कर सकते हैं:
import pandas as pd
from time import time
import polars as pl
import vaex as vx
import datatable as dt
इसके अलावा, विज़ुअलाइज़ेशन के लिए हम plotly लाइब्रेरी का उपयोग करते हैं।
import plotly.express as pxअब हम बेंचमार्किंग विश्लेषण आगे बढ़ाने के लिए तैयार हैं।
निष्पादन समय की बेंचमार्किंग
निष्पादन समय का आकलन निम्न कार्यों के लिए किया जाएगा: डेटा लोडिंग, डेटा ऑफलोडिंग, डेटा एग्रीगेशन, और डेटा फिल्टरिंग। प्रत्येक कार्य के लिए एक हेल्पर फंक्शन लागू किया गया है और वह दो मुख्य कुंजियों वाला एक डिक्शनरी लौटाएगा: लाइब्रेरी का नाम और निष्पादन समय।
इसके बाद plot metrics फंक्शन Plotly Express लाइब्रेरी का उपयोग करके परिणाम को ग्राफिकल रूप में प्लॉट करने के लिए इस्तेमाल किया जाता है। इसके दो पैरामीटर हैं: पिछले हेल्पर फंक्शनों से प्राप्त सभी डिक्शनरी की सूची और अंतर्निहित ग्राफ़िक का शीर्षक।
def plot_metrics(list_exec_time, graph_title):

	df = pd.DataFrame(list_exec_time)

	fig = px.bar(df, x='library', y= 'execution_time', title=graph_title)

	fig.show()
डेटा लोडिंग
हेल्पर फंक्शन read_csv_with_time के दो मुख्य पैरामीटर हैं: पढ़ी जाने वाली फ़ाइल का नाम और लाइब्रेरी का नाम।
def read_csv_with_time(library_name, file_name):

	final_time = 0

	start_time = time.time()

	if library_name.lower() == 'polars':
    	df = pl.read_csv(file_name)

	elif library_name.lower() == 'pandas':
    	df = pd.read_csv(file_name)

	elif library_name.lower() == 'vaex':
    	df = vx.read_csv(file_name)

	elif library_name.lower() == 'datatable':
    	df = dt.fread(file_name)

	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'pandas', 'vaex', or 'datatable'")

	end_time = time.time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
इस फंक्शन को प्रत्येक लाइब्रेरी के साथ, pandas से शुरू करते हुए, लागू किया जा सकता है।
pandas_time, pandas_df = read_csv_with_time('pandas', file_name)
polars_time, polars_df = read_csv_with_time('polars', file_name)
vaex_time, vaex_df = read_csv_with_time('vaex', file_name)
datatable_time, dt_df = read_csv_with_time('datatable', file_name)
प्राप्त डिक्शनरी को सूची के रूप में संयोजित किया जा सकता है और निम्न अभिव्यक्ति का उपयोग करके प्लॉट किया जा सकता है।
exec_times = [pandas_time, polars_time,
           vaex_time, datatable_time]

def plot_metrics(list_exec_time, graph_title):

 [print(exec_time) for exec_time in list_exec_time]
 df = pd.DataFrame(exec_times)

 # Plot bar plot using Plotly Express
 fig = px.bar(df, x='library', y='execution_time', title=graph_title)
 fig.show()

plot_metrics(exec_times, "Read Execution Time Comparison")
{'library': 'pandas', 'execution_time': 35.07908916473389}
{'library': 'polars', 'execution_time': 6.041005373001099}
{'library': 'vaex', 'execution_time': 36.431522607803345}
{'library': 'datatable', 'execution_time': 4.4584901332855225}डेटा लोडिंग के निष्पादन समय का डिक्शनरी प्रारूप
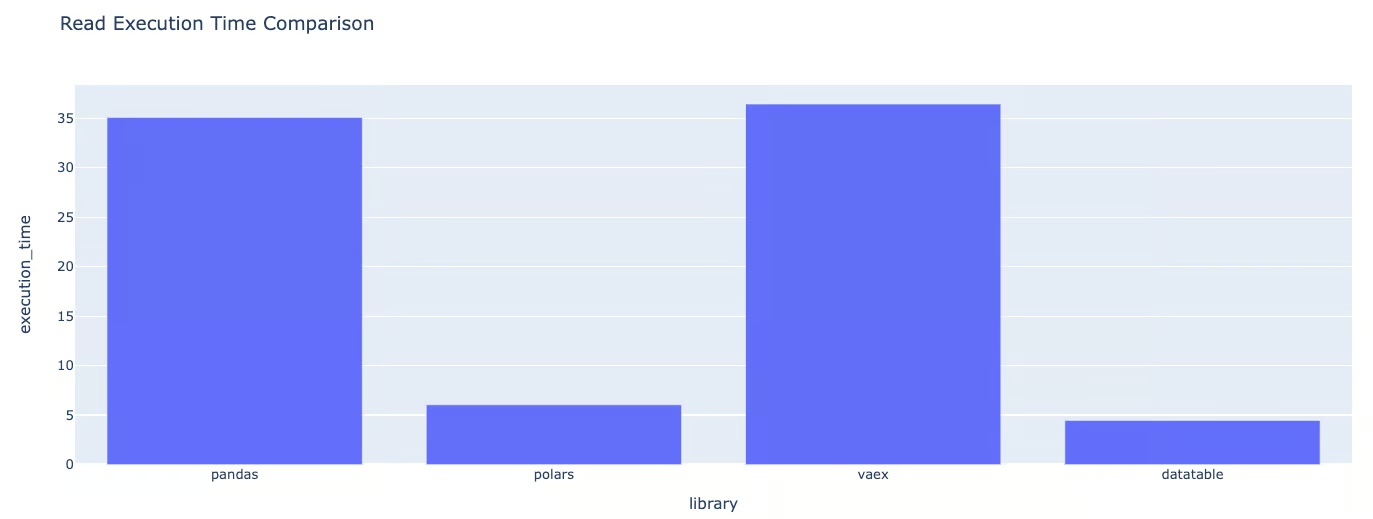
डेटा लोडिंग के निष्पादन समय का ग्राफिक प्रारूप
ग्राफ़िक्स के आधार पर, हम निष्कर्ष निकाल सकते हैं कि Polars:
- Datatable की तुलना में 1.35 गुना धीमा है
- Pandas, DataTable की तुलना में 7.87 गुना धीमा है।
- Vaex, DataTable की तुलना में लगभग 8.17 गुना धीमा है।
डेटा ग्रुपिंग
इसी प्रकार, group_data_with_time वह कॉलम ग्रुप करने के निष्पादन समय को ट्रैक करने के लिए जिम्मेदार है जो पैरामीटर में दिया गया है। इस केस में, हम Pregnancies कॉलम का उपयोग कर रहे हैं।
from time import time

def group_data_with_time(library_name, df, column_name='Pregnancies'):

 start_time = time()

 if library_name.lower() == 'polars':
     df_grouped = df.group_by(column_name).first()

 elif library_name.lower() == 'vaex':
     df_grouped = df.groupby(column_name, agg='first')

 elif library_name.lower() == 'pandas':
     df_grouped = df.groupby(column_name).first()

 elif library_name.lower() == 'datatable':
     df_grouped = df[:, dt.first(dt.f[:]), dt.by(column_name)]

 else:
     raise ValueError("Invalid library name. Must be 'polars', 'vaex', or 'datatable'")

 end_time = time()

 final_time = end_time - start_time

 return {"library": library_name, "execution_time": final_time}
pandas_time = group_data_with_time('pandas', pandas_df)
polars_time = group_data_with_time('polars', polars_df)
vaex_time = group_data_with_time('vaex', vaex_df)
datatable_time = group_data_with_time('datatable', dt_df)exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Grouping Execution Time Comparison"){'library': 'pandas', 'execution_time': 2.382519245147705}
{'library': 'pandas', 'execution_time'': 1.0898876190185547}
{'library': 'pandas', 'execution_time': 0.8506548404693604}
{'library': 'pandas', 'execution_time': 0.34698963165283203}
डेटा ग्रुपिंग के निष्पादन समय का ग्राफिक प्रारूप
अपडेटेड डेटा ग्रुपिंग कार्य के लिए, सबसे तेज़ लाइब्रेरी DataTable की तुलना अन्य से करते हुए:
हम देखते हैं कि आकलित लाइब्रेरियों में DataTable सबसे तेज़ है।
- Vaex, DataTable की तुलना में 2.45 गुना धीमा है।
- Polars, DataTable की तुलना में 3.14 गुना धीमा है।
- Pandas, DataTable की तुलना में 6.87 गुना धीमा है।
यह विश्लेषण डेटा ग्रुपिंग कार्यों में DataTable की उच्च दक्षता दर्शाता है, जबकि Vaex प्रदर्शन में अपेक्षाकृत काफ़ी नज़दीक है। Polars और Pandas समान निष्पादन समय दिखाते हैं, जो दोनों ही DataTable से काफ़ी धीमे हैं।
कॉलम सॉर्टिंग
उसी दृष्टिकोण का उपयोग करते हुए, कॉलम सॉर्टिंग फंक्शन प्रत्येक लाइब्रेरी का उपयोग करके दिए गए कॉलम को सॉर्ट करता है।
def sort_data_with_time(library_name, df, column_name='Pregnancies'):

	start_time = time()

	if library_name.lower() == 'polars':
    	df_sorted = df.sort(column_name)
	elif library_name.lower() == 'vaex':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'datatable':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'pandas':
    	df_sorted = pd.DataFrame(df).sort_values(column_name)
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
pandas_time = sort_data_with_time('pandas', pandas_df)
polars_time = sort_data_with_time('polars', polars_df)
vaex_time = sort_data_with_time('vaex', vaex_df)
datatable_time = sort_data_with_time('datatable', dt_df){'library': 'pandas', 'execution_time': 6.735127687454224}
{'library': 'polars', 'execution_time': 4.119458436965942}
{'library': 'vaex', 'execution_time': 1.0371737480163574}
{'library': 'datatable', 'execution_time': 0.3971593379974365}डेटा सॉर्टिंग के निष्पादन समय का डिक्शनरी प्रारूप
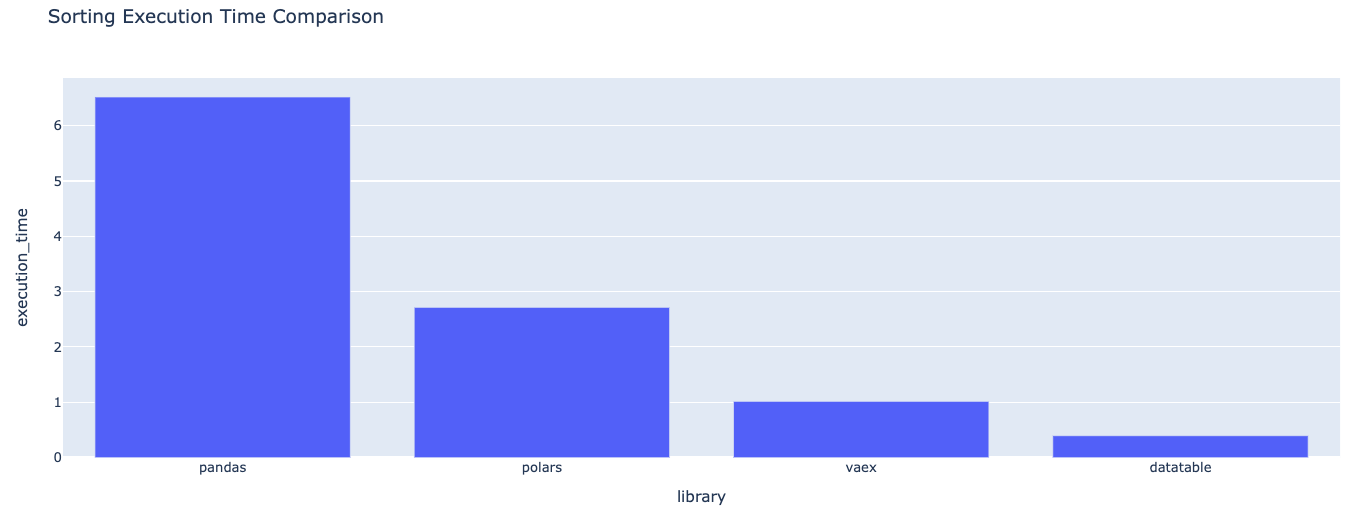
डेटा सॉर्टिंग के निष्पादन समय का ग्राफिक प्रारूप
डेटा सॉर्टिंग कार्य के लिए, आकलित लाइब्रेरियों में DataTable सबसे तेज़ है।
- Vaex, DataTable की तुलना में 2.61 गुना धीमा है।
- Polars, DataTable की तुलना में 10.37 गुना धीमा है।
- Pandas, DataTable की तुलना में 16.96 गुना धीमा है।
यह विश्लेषण दर्शाता है कि DataTable, डेटा सॉर्टिंग कार्यों को संभालने में उल्लेखनीय रूप से श्रेष्ठ प्रदर्शन करता है, और Vaex, Polars तथा Pandas से काफ़ी आगे है। Vaex प्रदर्शन में सबसे नज़दीक है, लेकिन फिर भी दो गुने से अधिक धीमा है।
डेटा ऑफलोडिंग
डेटा ऑफलोडिंग में विचार यह है कि मूल डेटा को किसी अन्य फ़ॉर्मेट में बदला जाए — इस विशिष्ट परिदृश्य में numpy array में।
def offload_data_with_time(library_name, df):

	start_time = time()

	if library_name.lower() == 'polars':
    	array = df.to_numpy()

	elif library_name.lower() == 'vaex':
    	array = df.to_pandas_df().values

	elif library_name.lower() == 'datatable':
    	array = df.to_numpy()

	elif library_name.lower() == 'pandas':
    	array = pd.DataFrame(df).values
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Data offloading Execution Time Comparison"){'library': 'pandas', 'execution_time': 1.8406445980072021}
{'library': 'polars', 'execution_time': 3.238591432571411}
{'library': 'vaex', 'execution_time': 6.945307970046997}
{'library': 'datatable', 'execution_time': 2.634136438369751}डेटा ऑफलोडिंग के निष्पादन समय का डिक्शनरी प्रारूप
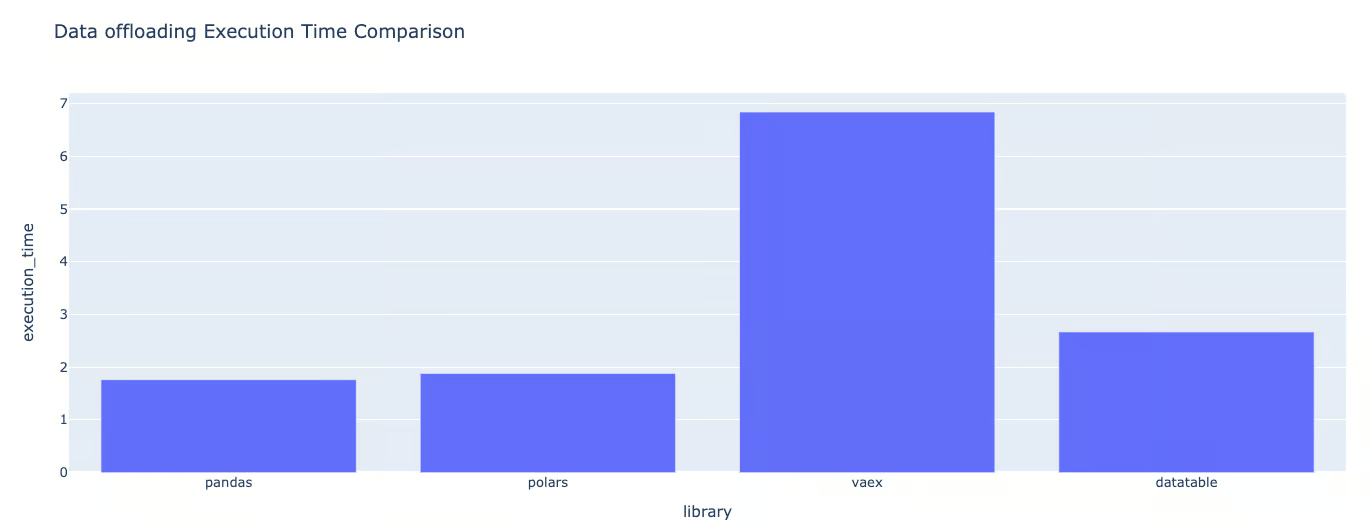
डेटा ऑफलोडिंग के निष्पादन समय का ग्राफिक प्रारूप
डेटा ऑफलोडिंग, निष्पादन समय की बेंचमार्किंग का अंतिम दौर है।
इस बार, सबसे अधिक निष्पादन समय Vaex का है। pandas की तुलना इन लाइब्रेरियों से करने पर, हम देखते हैं कि इसका निष्पादन समय लगभग:
- DataTable, Pandas की तुलना में 1.43 गुना धीमा है।
- Polars, Pandas की तुलना में 1.76 गुना धीमा है।
- Vaex, Pandas की तुलना में 3.77 गुना धीमा है।
मेमोरी उपयोग की बेंचमार्किंग
विभिन्न लाइब्रेरियों की तुलना करते समय केवल निष्पादन समय ही मानदंड नहीं है। यह जानना भी महत्त्वपूर्ण है कि वे मेमोरी के साथ कितनी दक्षता से काम करती हैं। इस खंड में tracemalloc लाइब्रेरी का उपयोग करते हुए मेमोरी उपयोग के दो भिन्न प्रकार दिखाए गए हैं:
- वर्तमान मेमोरी उपयोग: किसी विशिष्ट लाइब्रेरी का उपयोग करते हुए निष्पादन के दौरान उपयोग की गई कुल मेमोरी। यह उस समय कब्जा की गई RAM स्पेस के अनुरूप है।
- पीक मेमोरी उपयोग: प्रोग्राम द्वारा उपयोग की गई मेमोरी की अधिकतम मात्रा। यह जानना महत्त्वपूर्ण है कि पीक मेमोरी हमेशा वर्तमान मेमोरी से अधिक होती है।
इन विज़ुअलाइज़ेशनों से यह समझने में मदद मिलती है कि कौन सा प्रोग्राम कितनी मेमोरी उपयोग करता है, जिससे बड़े डेटासेट पर काम करते समय out-of-memory त्रुटियाँ हो सकती हैं।
tracemalloc के अलावा, os लाइब्रेरी भी आवश्यक है।
import tracemalloc as tm
import os
शुरू करने से पहले, हम एक खाली सूची बनाते हैं जो प्रत्येक मेमोरी उपयोग मान के परिणाम को रखेगी।
list_memory_usage = []प्रत्येक लाइब्रेरी के लिए, मेमोरी उपयोग का आकलन नीचे दिए गए सामान्य सिंटैक्स से किया जाता है, जो यहाँ Vaex लाइब्रेरी के साथ निष्पादन के अनुरूप है। साथ ही, यह केवल डेटा ऑफलोडिंग कार्यों के मेमोरी उपयोग पर केंद्रित है।
tm.start()
vaex_time = offload_data_with_time('vaex', vaex_df)
memory_usage = tm.get_traced_memory()
tm.stop()

list_memory_usage.append({
	'library': 'vaex',
	'memory_usage': memory_usage
})
शेष लाइब्रेरियों के लिए भी सिंटैक्स समान है, और हमें क्रमशः Polars, pandas और Datatable के लिए निम्न निर्देश मिलते हैं:
tm.start()
polars_time = offload_data_with_time('polars', polars_df)
memory_usage = tm.get_traced_memory()

tm.stop()

list_memory_usage.append({
	'library': 'polars',
	'memory_usage': memory_usage
})
tm.start()
offload_data_with_time('pandas', pandas_df)
# Get the memory usage
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'pandas',
'memory_usage': memory_usage
})tm.start()
datatable_time = offload_data_with_time('datatable', datatable_df)
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'datatable',
'memory_usage': memory_usage
})उपरोक्त सभी कोड के निष्पादन के बाद, हम नीचे दिए गए हेल्पर फंक्शन का उपयोग कर ग्राफिक प्लॉट कर सकते हैं:
def plot_memory_usage(list_memory_usage, graph_title='Memory Usage by Library'):

	df = pd.DataFrame(list_memory_usage)

	# separate the memory usage tuple into two columns: current_memory and peak_memory
	df[['current_memory', 'peak_memory']] = pd.DataFrame(df['memory_usage'].tolist(), index=df.index)

	# now we no longer need the memory_usage column
	df = df.drop(columns='memory_usage')

	# melt the DataFrame to make it suitable for grouped bar chart
	df_melted = df.melt(id_vars='library', var_name='memory_type', value_name='memory')

	# create the grouped bar chart
	fig = px.bar(df_melted, x='library', y='memory', color='memory_type', barmode='group',
             	labels={'memory':'Memory Usage (bytes)', 'library':'Library', 'memory_type':'Memory Type'},
             	title=graph_title)

	fig.update_layout(yaxis_type="log")
	fig.show()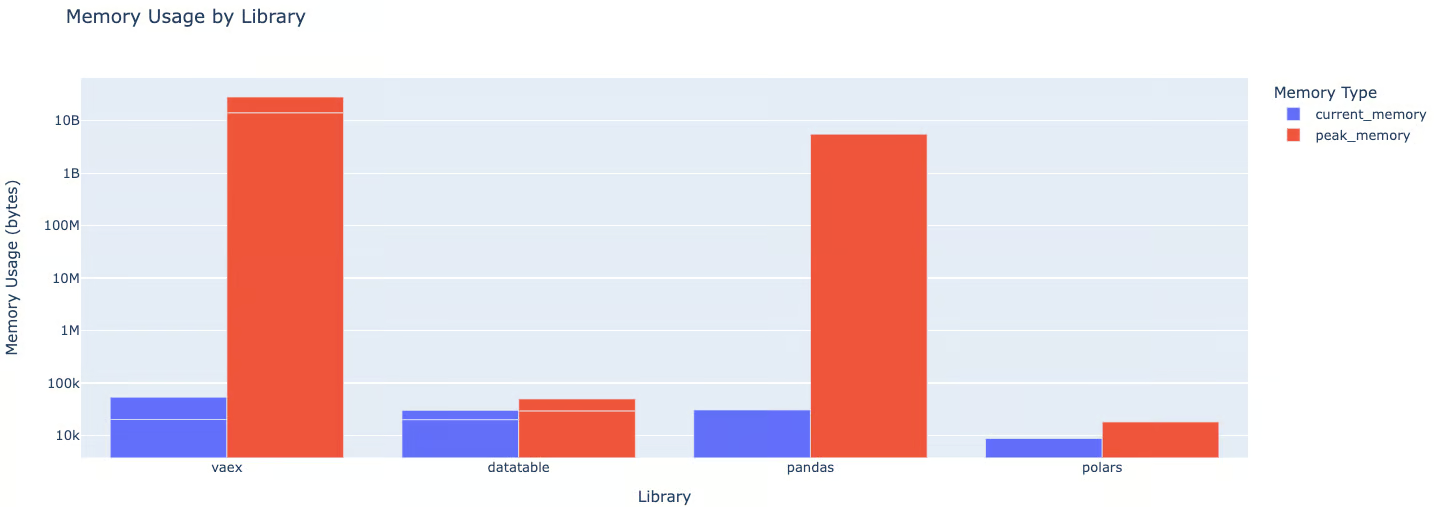
हम यह देख सकते हैं कि:
- Pandas, Polars की तुलना में लगभग 1100 गुना अधिक वर्तमान मेमोरी, Vaex से 7.4 गुना अधिक, और Datatable से 29.4 गुना अधिक मेमोरी उपयोग करता है।
- पीक मेमोरी उपयोग की बात करें तो, pandas और Vaex दोनों, Polars से लगभग 963K गुना और Datatable से 131K गुना अधिक मेमोरी उपयोग करते हैं।
आगे का विश्लेषण, जैसे Dask बनाम pandas गति, व्यापक परिदृश्य प्रदान कर सकता है।
Pandas विकल्पों की तुलना तालिका
नीचे, हमने अपने निष्कर्षों को एक तुलना तालिका में संकलित किया है, जो Polars, Vaex, और Datatables के बीच अंतर दिखाती है:
|
बेंचमार्क मानदंड |
Polars |
Vaex |
Datatable |
|
डेटा लोडिंग समय |
Vaex से तेज़, Datatable से धीमा |
Polars और Datatable दोनों से धीमा |
तीनों में सबसे तेज़ |
|
डेटा ग्रुपिंग समय |
तीनों में सबसे धीमा |
Polars से तेज़, Datatable से धीमा |
तीनों में सबसे तेज़ |
|
डेटा सॉर्टिंग समय |
Vaex से तेज़, Datatable से धीमा |
Polars और Datatable दोनों से धीमा |
तीनों में सबसे तेज़ |
|
डेटा ऑफलोडिंग समय |
Vaex से तेज़, Datatable से धीमा |
तीनों में सबसे धीमा |
Polars से तेज़, Vaex से धीमा |
|
वर्तमान मेमोरी उपयोग |
सबसे कम मेमोरी उपयोग |
Polars से अधिक, पर Datatable से कम मेमोरी उपयोग |
तीनों में सबसे अधिक मेमोरी उपयोग |
|
पीक मेमोरी उपयोग |
सबसे कम मेमोरी उपयोग |
Polars से अधिक, पर Datatable से कम मेमोरी उपयोग |
तीनों में सबसे अधिक मेमोरी उपयोग |
|
स्केलेबिलिटी |
डेटा आकार के साथ स्केलेबल |
डेटा आकार के साथ स्केलेबल, लेकिन डेटा आकार बढ़ने पर अधिक मेमोरी उपयोग कर सकता है |
डेटा आकार के साथ अत्यधिक स्केलेबल |
|
उपयोग में सरलता |
पूर्ण Python API है और Apache Arrow के साथ संगत |
लेज़ी इवैल्यूएशन का उपयोग करता है और Pandas के साथ संगत |
Pandas/NumPy/शुद्ध Python के साथ इंटरऑपरेबिलिटी प्रदान करता है |
निष्कर्ष
स्केलेबिलिटी और एकीकरण की सरलता का विश्लेषण करते समय कई कारकों पर विचार करना आवश्यक है। हमारी बेंचमार्किंग ने रौशनी डाली कि भले ही pandas पुराना, उपयोगकर्ता के अनुकूल और अपेक्षाकृत आसान हो, यह बड़े डेटासेट को कुशलता से संभाल नहीं पाता।
हालाँकि, pandas को तेज़ करने के अलग-अलग तरीके अपनाए जा सकते हैं, और हमारा High-Performance Data Manipulation in Python: Pandas 2.0 vs Polars इसमें सहायक हो सकता है।
Vaex का प्रदर्शन कार्य के अनुसार भिन्न होता है। इसलिए, Pandas के विकल्प का चयन उपयोगकर्ताओं की विशिष्ट आवश्यकताओं, डेटासेट के आकार और सीखने की कर्व तथा एकीकरण संभालने की उनकी क्षमता पर निर्भर करता है।
