Einführung
pandas ist ein außerordentlich leistungsfähiges Werkzeug im Python-Ökosystem für Data Science und bietet zahlreiche Möglichkeiten zur Datenmanipulation und -bereinigung. Für mittelgroße Datensätze ist es hervorragend geeignet, stößt bei sehr großen Datenmengen jedoch an Performance-Grenzen. Das macht leistungsstarke Alternativen interessant.
Dieser umfassende Artikel stellt einige dieser Alternativen vor und vergleicht sie per Benchmarking in Bezug auf Ladezeit, Ausführungszeit, Speicherbedarf, Skalierbarkeit und Bedienkomfort.
Hinweis: Benchmark-Ergebnisse hängen stark von deiner Hardware ab.
Benchmarks verstehen
Benchmarks sind Referenzwerte, an denen Software oder Hardware zur Leistungseinschätzung gemessen werden. Sie sind für die Optimierung von Software-Performance relevant, weil sie uns erlauben, die Effizienz verschiedener Methoden, Algorithmen oder Tools zu messen. In diesem Kontext sind die wichtigsten Metriken für Datenmanipulations-Bibliotheken Ausführungszeit, Speichernutzung, Skalierbarkeit und Bedienfreundlichkeit.
Überblick über High-Performance-Alternativen
Die wichtigsten Alternativen in Python sind Polars, Vaex und Datatable. Bevor wir in den Vergleich einsteigen, hier ein kurzer Überblick über die einzelnen Tools.
Polars
Polars zeichnet sich durch drei zentrale Eigenschaften aus. Erstens bietet es eine umfassende Python-API mit vielen Funktionen für die Arbeit mit DataFrames. Zweitens lässt es sich doppelt einsetzen – als DataFrame-Bibliothek oder als zugrunde liegende Query-Engine für Datenmodelle. Drittens wird durch die sichere Arrow2-Implementierung der Apache-Arrow-Spezifikation eine sehr effiziente Verarbeitung großer Datenmengen möglich.
Sieh dir unser Polars-Intro an sowie den Vergleich zwischen pandas 2.0 und Polars.
Vaex
Vaex bietet Lazy, Out-of-Core DataFrames (ähnlich wie pandas), um große tabellarische Datensätze zu visualisieren und zu erkunden. Durch verzögerte Ausführung (Lazy Evaluation) kann es sehr effizient sein, weil Operationen erst bei Bedarf erfolgen – das reduziert Speicherverbrauch und Zeit.
Datatable
Datatable ermöglicht die Verarbeitung großer Datenmengen (bis zu 100 GB) auf einer Single-Node-Maschine mit maximaler Geschwindigkeit. Ein wichtiges Feature ist die Interoperabilität mit pandas/NumPy/purem Python, sodass sich Daten leicht in andere Frameworks überführen lassen.
Wenn du mehr über pandas lernen willst, ist unser pandas-Tutorial zu DataFrames in Python ein guter Einstieg.
Außerdem liefert das pandas Cheat Sheet für Data Science in Python eine kompakte Übersicht über die Grundlagen der Python-Analysebibliothek inklusive Codebeispielen.
Einrichtung der Benchmarking-Umgebung
In diesem Abschnitt erstellen wir die Benchmarking-Daten und installieren alle Bibliotheken, die in der Analyse zum Einsatz kommen.
Benchmarking-Daten
Der Benchmarking-Datensatz ist 5,7 GB groß – ausreichend für einen aussagekräftigen Vergleich. Jede Zeile wurde 100000-mal dupliziert, sodass 76.800.000 Zeilen entstehen. Die Diabetes-Daten dienen als Ausgangsbasis und sind frei auf Kaggle verfügbar.
Das finale Benchmarking-Notebook findest du auf GitHub.
import pandas as pd

data_URL = "https://raw.githubusercontent.com/keitazoumana/Experimentation-Data/main/diabetes.csv"

original_data = pd.read_csv(data_URL)

# Duplicate each row 100000 times
benchmarking_df = original_data.loc[original_data.index.repeat(100000)]

# Save the result as a CSV file for future use.
file_name = "benchmarking_data.csv"

benchmarking_df.to_csv(file_name, index=False)
Installation der Bibliotheken
Als Nächstes installieren wir alle Bibliotheken, die wir für die Benchmark-Analyse benötigen.
In einer Jupyter-Notebook-Umgebung erfolgt die Installation per pip install wie folgt:
%%bash
pip3 -q install -U polars
pip3 -q install vaex
pip -q install datatable
Nach erfolgreicher Ausführung können wir sie wie gewohnt importieren:
import pandas as pd
from time import time
import polars as pl
import vaex as vx
import datatable as dt
Für die Visualisierung nutzen wir außerdem die Bibliothek Plotly.
import plotly.express as pxDamit ist alles vorbereitet für die Benchmarking-Analyse.
Benchmarking der Ausführungszeit
Die Ausführungszeit wird für folgende Operationen gemessen: Daten laden, Daten auslagern, Daten aggregieren und Daten filtern. Für jede Aufgabe ist eine Helferfunktion implementiert, die ein Dictionary mit zwei Schlüsseln zurückgibt: dem Bibliotheksnamen und der Ausführungszeit.
Die Funktion plot_metrics visualisiert die Ergebnisse anschließend mit Plotly Express. Sie erwartet zwei Parameter: die Liste aller Dictionaries aus den Helferfunktionen und den Titel der Grafik.
def plot_metrics(list_exec_time, graph_title):

	df = pd.DataFrame(list_exec_time)

	fig = px.bar(df, x='library', y= 'execution_time', title=graph_title)

	fig.show()
Daten laden
Die Helferfunktion read_csv_with_time hat zwei Hauptparameter: den zu lesenden Dateinamen und den Bibliotheksnamen.
def read_csv_with_time(library_name, file_name):

	final_time = 0

	start_time = time.time()

	if library_name.lower() == 'polars':
    	df = pl.read_csv(file_name)

	elif library_name.lower() == 'pandas':
    	df = pd.read_csv(file_name)

	elif library_name.lower() == 'vaex':
    	df = vx.read_csv(file_name)

	elif library_name.lower() == 'datatable':
    	df = dt.fread(file_name)

	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'pandas', 'vaex', or 'datatable'")

	end_time = time.time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
Die Funktion wird mit jeder Bibliothek angewendet, beginnend mit pandas.
pandas_time, pandas_df = read_csv_with_time('pandas', file_name)
polars_time, polars_df = read_csv_with_time('polars', file_name)
vaex_time, vaex_df = read_csv_with_time('vaex', file_name)
datatable_time, dt_df = read_csv_with_time('datatable', file_name)
Die entstehenden Dictionaries lassen sich zu einer Liste kombinieren und wie folgt plotten.
exec_times = [pandas_time, polars_time,
           vaex_time, datatable_time]

def plot_metrics(list_exec_time, graph_title):

 [print(exec_time) for exec_time in list_exec_time]
 df = pd.DataFrame(exec_times)

 # Plot bar plot using Plotly Express
 fig = px.bar(df, x='library', y='execution_time', title=graph_title)
 fig.show()

plot_metrics(exec_times, "Read Execution Time Comparison")
{'library': 'pandas', 'execution_time': 35.07908916473389}
{'library': 'polars', 'execution_time': 6.041005373001099}
{'library': 'vaex', 'execution_time': 36.431522607803345}
{'library': 'datatable', 'execution_time': 4.4584901332855225}Dictionary-Format der Ausführungszeiten beim Laden
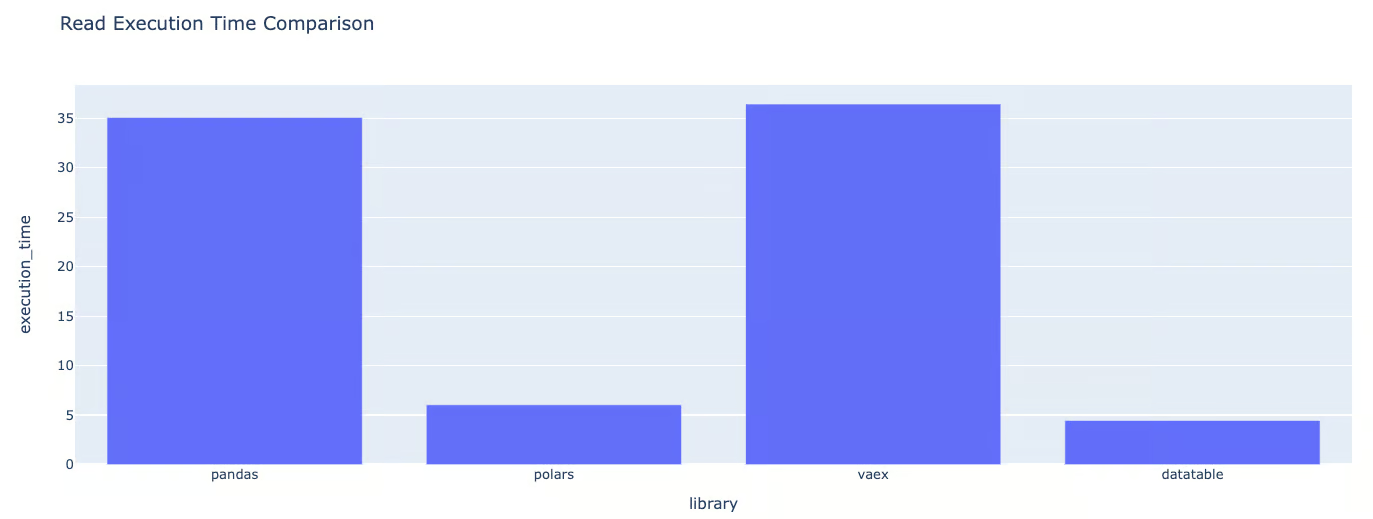
Grafische Darstellung der Ausführungszeiten beim Laden
Aus den Grafiken lässt sich schließen:
- Polars ist 1,35-mal langsamer als Datatable.
- pandas ist 7,87-mal langsamer als Datatable.
- Vaex ist etwa 8,17-mal langsamer als Datatable.
Datengruppierung
Analog protokolliert group_data_with_time die Ausführungszeit für die Gruppierung nach der übergebenen Spalte. In unserem Fall ist das die Spalte Pregnancies.
from time import time

def group_data_with_time(library_name, df, column_name='Pregnancies'):

 start_time = time()

 if library_name.lower() == 'polars':
     df_grouped = df.group_by(column_name).first()

 elif library_name.lower() == 'vaex':
     df_grouped = df.groupby(column_name, agg='first')

 elif library_name.lower() == 'pandas':
     df_grouped = df.groupby(column_name).first()

 elif library_name.lower() == 'datatable':
     df_grouped = df[:, dt.first(dt.f[:]), dt.by(column_name)]

 else:
     raise ValueError("Invalid library name. Must be 'polars', 'vaex', or 'datatable'")

 end_time = time()

 final_time = end_time - start_time

 return {"library": library_name, "execution_time": final_time}
pandas_time = group_data_with_time('pandas', pandas_df)
polars_time = group_data_with_time('polars', polars_df)
vaex_time = group_data_with_time('vaex', vaex_df)
datatable_time = group_data_with_time('datatable', dt_df)exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Grouping Execution Time Comparison"){'library': 'pandas', 'execution_time': 2.382519245147705}
{'library': 'pandas', 'execution_time'': 1.0898876190185547}
{'library': 'pandas', 'execution_time': 0.8506548404693604}
{'library': 'pandas', 'execution_time': 0.34698963165283203}
Grafische Darstellung der Ausführungszeiten bei der Gruppierung
Für die aktualisierte Gruppierungsaufgabe, im Vergleich zur schnellsten Bibliothek Datatable:
Datatable ist hier am schnellsten.
- Vaex ist 2,45-mal langsamer als Datatable.
- Polars ist 3,14-mal langsamer als Datatable.
- pandas ist 6,87-mal langsamer als Datatable.
Diese Analyse zeigt die überlegene Effizienz von Datatable bei Gruppierungsaufgaben. Vaex liegt relativ nahe dahinter, während Polars und pandas ähnliche, aber deutlich höhere Ausführungszeiten als Datatable aufweisen.
Spaltensortierung
Nach dem gleichen Prinzip sortiert die Sortierfunktion die angegebene Spalte jeweils mit der entsprechenden Bibliothek.
def sort_data_with_time(library_name, df, column_name='Pregnancies'):

	start_time = time()

	if library_name.lower() == 'polars':
    	df_sorted = df.sort(column_name)
	elif library_name.lower() == 'vaex':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'datatable':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'pandas':
    	df_sorted = pd.DataFrame(df).sort_values(column_name)
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
pandas_time = sort_data_with_time('pandas', pandas_df)
polars_time = sort_data_with_time('polars', polars_df)
vaex_time = sort_data_with_time('vaex', vaex_df)
datatable_time = sort_data_with_time('datatable', dt_df){'library': 'pandas', 'execution_time': 6.735127687454224}
{'library': 'polars', 'execution_time': 4.119458436965942}
{'library': 'vaex', 'execution_time': 1.0371737480163574}
{'library': 'datatable', 'execution_time': 0.3971593379974365}Dictionary-Format der Ausführungszeiten beim Sortieren
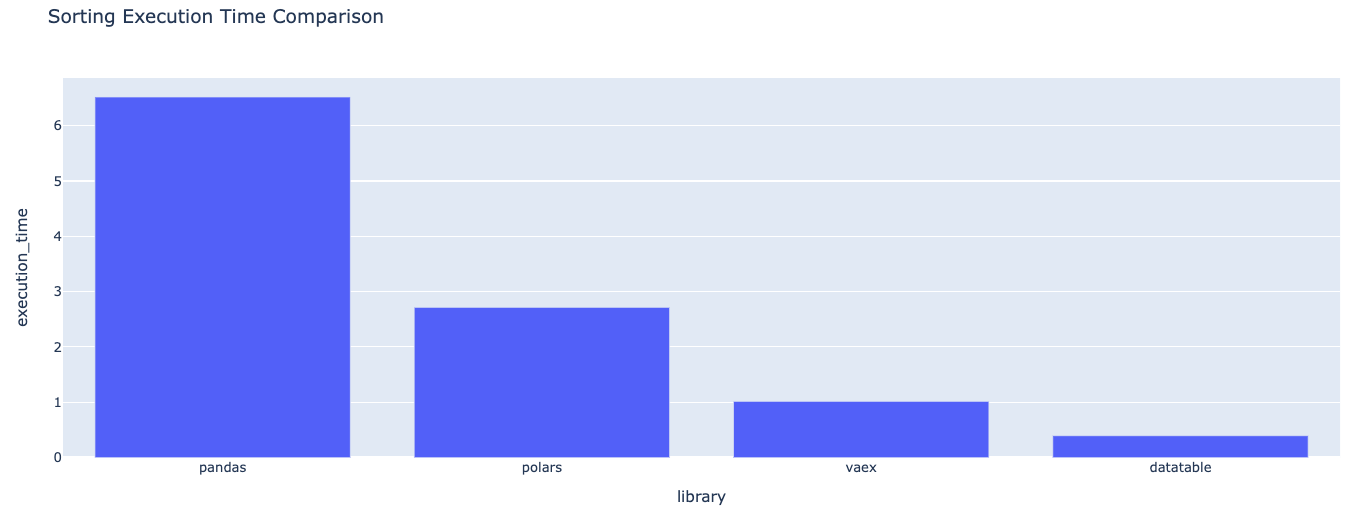
Grafische Darstellung der Ausführungszeiten beim Sortieren
Beim Sortieren ist Datatable die schnellste der untersuchten Bibliotheken.
- Vaex ist 2,61-mal langsamer als Datatable.
- Polars ist 10,37-mal langsamer als Datatable.
- pandas ist 16,96-mal langsamer als Datatable.
Damit zeigt sich Datatables klare Überlegenheit beim Sortieren – deutlich vor Vaex, Polars und pandas. Vaex ist am nächsten dran, aber immer noch mehr als doppelt so langsam.
Daten auslagern
Beim Auslagern geht es darum, die ursprünglichen Daten in ein anderes Format zu überführen – hier in ein NumPy-Array.
def offload_data_with_time(library_name, df):

	start_time = time()

	if library_name.lower() == 'polars':
    	array = df.to_numpy()

	elif library_name.lower() == 'vaex':
    	array = df.to_pandas_df().values

	elif library_name.lower() == 'datatable':
    	array = df.to_numpy()

	elif library_name.lower() == 'pandas':
    	array = pd.DataFrame(df).values
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Data offloading Execution Time Comparison"){'library': 'pandas', 'execution_time': 1.8406445980072021}
{'library': 'polars', 'execution_time': 3.238591432571411}
{'library': 'vaex', 'execution_time': 6.945307970046997}
{'library': 'datatable', 'execution_time': 2.634136438369751}Dictionary-Format der Ausführungszeiten beim Auslagern
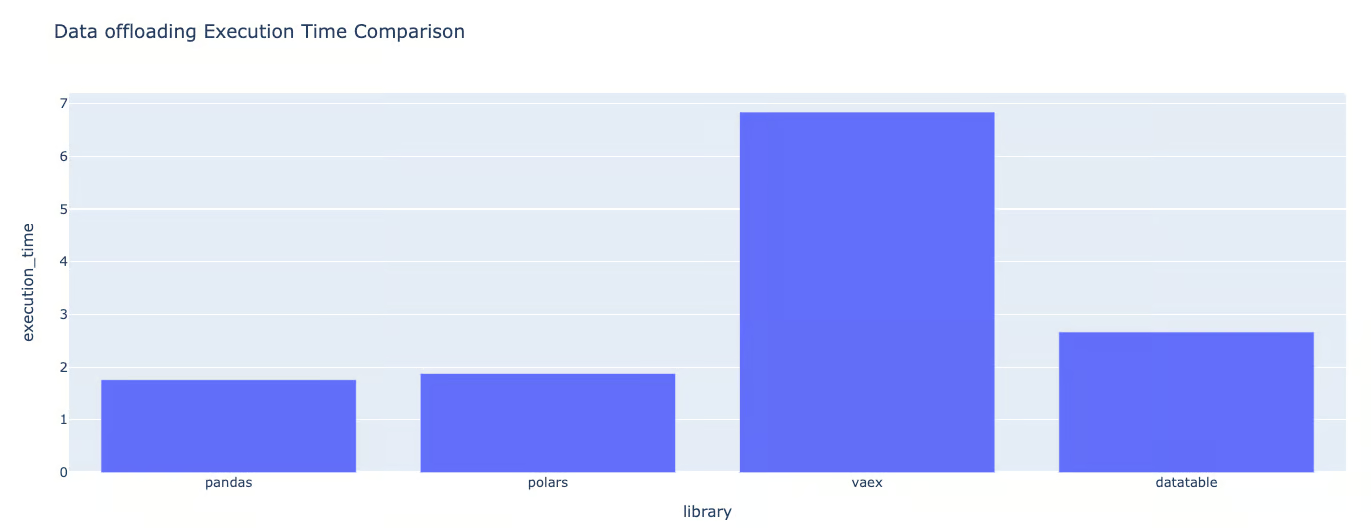
Grafische Darstellung der Ausführungszeiten beim Auslagern
Das Auslagern ist die letzte Runde der Ausführungszeit-Benchmarks.
Hier hat Vaex die höchste Ausführungszeit. Im Vergleich zu pandas zeigt sich:
- Datatable ist 1,43-mal langsamer als pandas.
- Polars ist 1,76-mal langsamer als pandas.
- Vaex ist 3,77-mal langsamer als pandas.
Benchmarking der Speichernutzung
Die Ausführungszeit ist nicht das einzige Kriterium beim Vergleich. Genauso wichtig ist, wie effizient die Bibliotheken mit Speicher umgehen. Dieser Abschnitt zeigt zwei Kennzahlen zur Speichernutzung mit tracemalloc:
- Aktuelle Speichernutzung. Die gesamte Speichermenge, die während der Ausführung mit einer spezifischen Bibliothek genutzt wird. Das entspricht dem zu diesem Zeitpunkt belegten RAM.
- Spitzen-Speichernutzung. Der maximal vom Programm genutzte Speicher. Dieser Wert ist immer höher als die aktuelle Speichernutzung.
Diese Visualisierungen helfen zu erkennen, welche Programme viel Speicher verbrauchen und so insbesondere bei großen Datensätzen zu Out-of-Memory-Fehlern führen können.
Zusätzlich zu tracemalloc wird auch die os-Bibliothek benötigt.
import tracemalloc as tm
import os
Vorab legen wir eine leere Liste an, die die Ergebnisse der Speichermessungen aufnimmt.
list_memory_usage = []Für jede Bibliothek erfolgt die Schätzung der Speichernutzung nach folgendem Muster – hier am Beispiel Vaex. Der Fokus liegt dabei ausschließlich auf der Speichernutzung beim Auslagern.
tm.start()
vaex_time = offload_data_with_time('vaex', vaex_df)
memory_usage = tm.get_traced_memory()
tm.stop()

list_memory_usage.append({
	'library': 'vaex',
	'memory_usage': memory_usage
})
Für die übrigen Bibliotheken ist die Syntax identisch. Entsprechend erhalten wir für Polars, pandas und Datatable:
tm.start()
polars_time = offload_data_with_time('polars', polars_df)
memory_usage = tm.get_traced_memory()

tm.stop()

list_memory_usage.append({
	'library': 'polars',
	'memory_usage': memory_usage
})
tm.start()
offload_data_with_time('pandas', pandas_df)
# Get the memory usage
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'pandas',
'memory_usage': memory_usage
})tm.start()
datatable_time = offload_data_with_time('datatable', datatable_df)
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'datatable',
'memory_usage': memory_usage
})Nach der Ausführung aller Schritte können wir die Grafik mit der folgenden Helferfunktion erzeugen:
def plot_memory_usage(list_memory_usage, graph_title='Memory Usage by Library'):

	df = pd.DataFrame(list_memory_usage)

	# separate the memory usage tuple into two columns: current_memory and peak_memory
	df[['current_memory', 'peak_memory']] = pd.DataFrame(df['memory_usage'].tolist(), index=df.index)

	# now we no longer need the memory_usage column
	df = df.drop(columns='memory_usage')

	# melt the DataFrame to make it suitable for grouped bar chart
	df_melted = df.melt(id_vars='library', var_name='memory_type', value_name='memory')

	# create the grouped bar chart
	fig = px.bar(df_melted, x='library', y='memory', color='memory_type', barmode='group',
             	labels={'memory':'Memory Usage (bytes)', 'library':'Library', 'memory_type':'Memory Type'},
             	title=graph_title)

	fig.update_layout(yaxis_type="log")
	fig.show()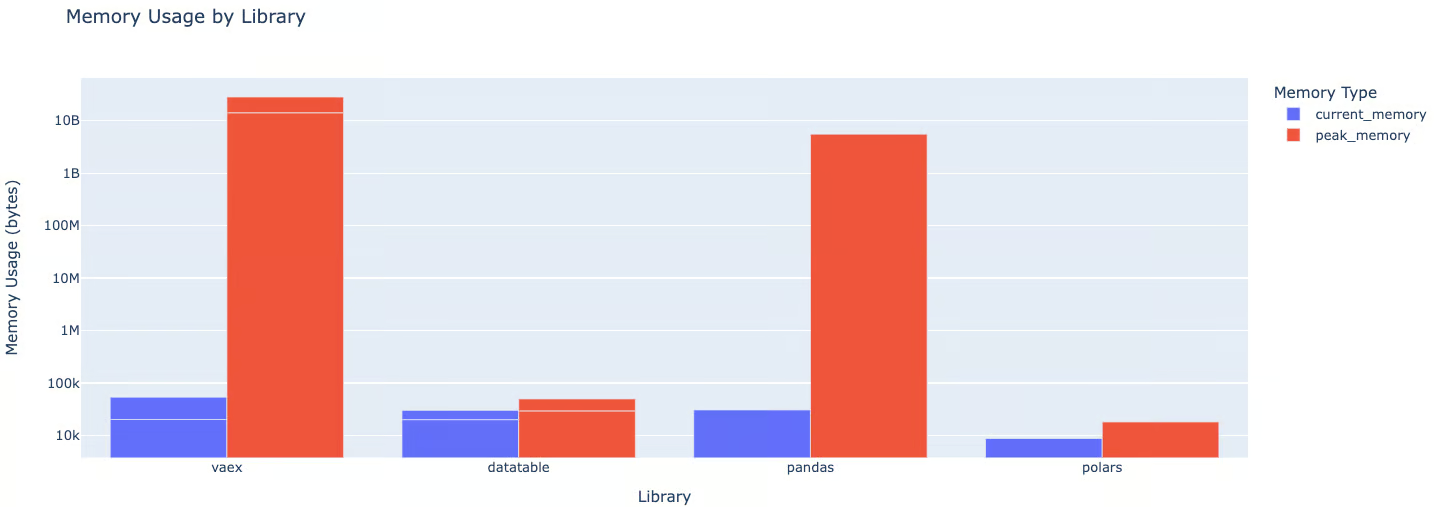
Auffällig ist:
- pandas nutzt aktuell etwa 1100-mal mehr Speicher als Polars, 7,4-mal mehr als Vaex und 29,4-mal mehr als Datatable.
- Bei der Spitzen-Speichernutzung verwenden sowohl pandas als auch Vaex rund 963.000-mal mehr Speicher als Polars und 131.000-mal mehr als Datatable.
Weitere Analysen, etwa zum Vergleich Dask vs. pandas in puncto Geschwindigkeit, könnten das Bild abrunden.
Vergleichstabelle zu pandas-Alternativen
Im Folgenden haben wir unsere Ergebnisse in einer Vergleichstabelle zusammengefasst – mit den Unterschieden zwischen Polars, Vaex und Datatable:
|
Benchmark-Kriterium |
Polars |
Vaex |
Datatable |
|
Ladezeit |
Schneller als Vaex, langsamer als Datatable |
Langsamer als Polars und Datatable |
Am schnellsten |
|
Gruppierungszeit |
Am langsamsten |
Schneller als Polars, langsamer als Datatable |
Am schnellsten |
|
Sortierzeit |
Schneller als Vaex, langsamer als Datatable |
Langsamer als Polars und Datatable |
Am schnellsten |
|
Zeit fürs Auslagern |
Schneller als Vaex, langsamer als Datatable |
Am langsamsten |
Schneller als Polars, langsamer als Vaex |
|
Aktuelle Speichernutzung |
Niedrigster Verbrauch |
Mehr als Polars, weniger als Datatable |
Höchster Verbrauch |
|
Spitzen-Speichernutzung |
Niedrigster Verbrauch |
Mehr als Polars, weniger als Datatable |
Höchster Verbrauch |
|
Skalierbarkeit |
Skaliert mit der Datenmenge |
Skaliert mit der Datenmenge, benötigt bei wachsender Größe teils mehr Speicher |
Sehr hohe Skalierbarkeit |
|
Bedienfreundlichkeit |
Umfassende Python-API, kompatibel mit Apache Arrow |
Nutzt Lazy Evaluation, kompatibel mit pandas |
Interoperabel mit pandas/NumPy/purem Python |
Fazit
Bei der Bewertung von Skalierbarkeit und Integrationsaufwand spielen mehrere Faktoren zusammen. Unser Benchmarking zeigt: Obwohl pandas etabliert, benutzerfreundlich und leicht zu erlernen ist, skaliert es bei sehr großen Datensätzen nicht effizient.
Es gibt jedoch verschiedene Ansätze, um pandas zu beschleunigen. Unser Artikel High-Performance Data Manipulation in Python: Pandas 2.0 vs Polars hilft dir dabei.
Die Performance von Vaex variiert je nach Aufgabe. Die Wahl einer Alternative zu pandas hängt daher von deinen Anforderungen, der Datensatzgröße und deiner Bereitschaft ab, dich in neue Workflows und Integrationen einzuarbeiten.