Introductie
Pandas is een bijzonder krachtig hulpmiddel binnen het data-science-ecosysteem van Python, met tal van mogelijkheden voor datamanipulatie en -opschoning. Voor middelgrote datasets werkt het uitstekend, maar bij zeer grote datasets kunnen prestatieproblemen optreden, waardoor de behoefte aan high-performance-alternatieven ontstaat.
Dit uitgebreide artikel introduceert enkele van die alternatieven en vergelijkt ze via benchmarking op het gebied van laadtijd, uitvoeringstijd, geheugengebruik, schaalbaarheid en gebruiksgemak.
Let op: Benchmarkresultaten variëren sterk afhankelijk van je hardwareconfiguratie.
De benchmarks begrijpen
Benchmarks zijn referentiepunten waarmee software of hardware kan worden vergeleken voor prestatie-evaluatie. Deze referentie is relevant bij het optimaliseren van softwareprestaties, omdat we zo de efficiëntie van verschillende methoden, algoritmen of tools kunnen meten. In deze context zijn de belangrijkste metrics voor het benchmarken van bibliotheken voor datamanipulatie uitvoeringstijd, geheugengebruik, schaalbaarheid en gebruiksgemak.
Introductie van high-performance-alternatieven
De belangrijkste alternatieven in Python zijn Polars, Vaex en Datatable. Voordat we ze inhoudelijk vergelijken, volgt een korte introductie van elk van deze tools.
Polars
Polars laat zich samenvatten in drie kernpunten. Ten eerste biedt het een uitgebreide Python-API met talloze functies voor het werken met DataFrames. Ten tweede heeft het een dubbele rol: het is te gebruiken als DataFrame-bibliotheek én als onderliggende query-engine voor datamodellen. Tot slot, door de veilige Arrow2-implementatie van de Apache Arrow-specificatie te integreren, is Polars uiterst efficiënt voor het verwerken van grote hoeveelheden data.
Bekijk onze tutorial introductie tot Polars, evenals een vergelijking tussen pandas 2.0 en Polars.
Vaex
Vaex biedt luie, out-of-core DataFrames (vergelijkbaar met Pandas) om grote tabeldata te visualiseren en te verkennen. Het kan zeer efficiënt zijn doordat bewerkingen worden uitgesteld tot ze nodig zijn (luie evaluatie), wat geheugen- en tijdsverbruik vermindert.
Datatable
Datatable kan grote dataverwerking (tot 100 GB) op een single-node machine uitvoeren met maximale snelheid. Een belangrijk kenmerk is de interoperabiliteit met Pandas/NumPy/pure Python, waardoor je eenvoudig kunt converteren naar een ander dataverwerkingsframework.
Wil je meer leren over pandas? Onze pandas-tutorial DataFrames in Python is een goed startpunt.
Ook de pandas Cheat Sheet voor Data Science in Python biedt een snel overzicht van de basis van de Python-bibliotheek voor data-analyse, inclusief codevoorbeelden.
De benchmarkomgeving opzetten
Deze sectie behandelt het aanmaken van de benchmarkdata en de installatie van alle bibliotheken die in de benchmarkanalyse worden gebruikt.
Benchmarkdata
De benchmarkdataset is 5,7 GB groot, ruim voldoende voor een degelijke vergelijking. Elke rij is 100000 keer gedupliceerd, wat resulteert in 76.800.000 rijen. De originele data zijn de diabetesdata, vrij beschikbaar op Kaggle.
De uiteindelijke benchmark-notebook is te vinden op GitHub.
import pandas as pd

data_URL = "https://raw.githubusercontent.com/keitazoumana/Experimentation-Data/main/diabetes.csv"

original_data = pd.read_csv(data_URL)

# Duplicate each row 100000 times
benchmarking_df = original_data.loc[original_data.index.repeat(100000)]

# Save the result as a CSV file for future use.
file_name = "benchmarking_data.csv"

benchmarking_df.to_csv(file_name, index=False)
Installatie van de bibliotheken
Nu kunnen we doorgaan met de installatie van alle bibliotheken die bij de benchmarkanalyse betrokken zijn.
In een Jupyter-notebook worden alle installaties uitgevoerd met het pip install-commando als volgt:
%%bash
pip3 -q install -U polars
pip3 -q install vaex
pip -q install datatable
Na het succesvol uitvoeren van bovenstaande codeblok kunnen we ze importeren met het import-statement:
import pandas as pd
from time import time
import polars as pl
import vaex as vx
import datatable as dt
Verder gebruiken we de plotly-bibliotheek voor visualisatie.
import plotly.express as pxWe zijn nu klaar om te beginnen met de benchmarkanalyse.
Benchmarking van uitvoeringstijd
De uitvoeringstijd wordt geëvalueerd voor de volgende bewerkingen: data laden, data offloaden, data aggregeren en data filteren. Voor elke taak is er een hulpfunctie geïmplementeerd die een woordenboek retourneert met twee hoofdkeys: de naam van de bibliotheek en de uitvoeringstijd.
De plot-metrics-functie wordt vervolgens gebruikt om het resultaat grafisch weer te geven met de Plotly Express-bibliotheek. Ze heeft twee parameters: de lijst met alle woordenboeken van de vorige hulpfuncties en de titel van de onderliggende grafiek.
def plot_metrics(list_exec_time, graph_title):

	df = pd.DataFrame(list_exec_time)

	fig = px.bar(df, x='library', y= 'execution_time', title=graph_title)

	fig.show()
Data laden
De hulpfunctie read_csv_with_time heeft twee hoofdparameters: de bestandsnaam die gelezen moet worden en de naam van de bibliotheek.
def read_csv_with_time(library_name, file_name):

	final_time = 0

	start_time = time.time()

	if library_name.lower() == 'polars':
    	df = pl.read_csv(file_name)

	elif library_name.lower() == 'pandas':
    	df = pd.read_csv(file_name)

	elif library_name.lower() == 'vaex':
    	df = vx.read_csv(file_name)

	elif library_name.lower() == 'datatable':
    	df = dt.fread(file_name)

	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'pandas', 'vaex', or 'datatable'")

	end_time = time.time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
De functie kan worden toegepast met elk van de bibliotheken, te beginnen met pandas.
pandas_time, pandas_df = read_csv_with_time('pandas', file_name)
polars_time, polars_df = read_csv_with_time('polars', file_name)
vaex_time, vaex_df = read_csv_with_time('vaex', file_name)
datatable_time, dt_df = read_csv_with_time('datatable', file_name)
De resulterende woordenboeken kunnen worden gecombineerd tot een lijst en geplot met de volgende expressie.
exec_times = [pandas_time, polars_time,
           vaex_time, datatable_time]

def plot_metrics(list_exec_time, graph_title):

 [print(exec_time) for exec_time in list_exec_time]
 df = pd.DataFrame(exec_times)

 # Plot bar plot using Plotly Express
 fig = px.bar(df, x='library', y='execution_time', title=graph_title)
 fig.show()

plot_metrics(exec_times, "Read Execution Time Comparison")
{'library': 'pandas', 'execution_time': 35.07908916473389}
{'library': 'polars', 'execution_time': 6.041005373001099}
{'library': 'vaex', 'execution_time': 36.431522607803345}
{'library': 'datatable', 'execution_time': 4.4584901332855225}Woordenboekweergave van de uitvoeringstijden voor dataladen
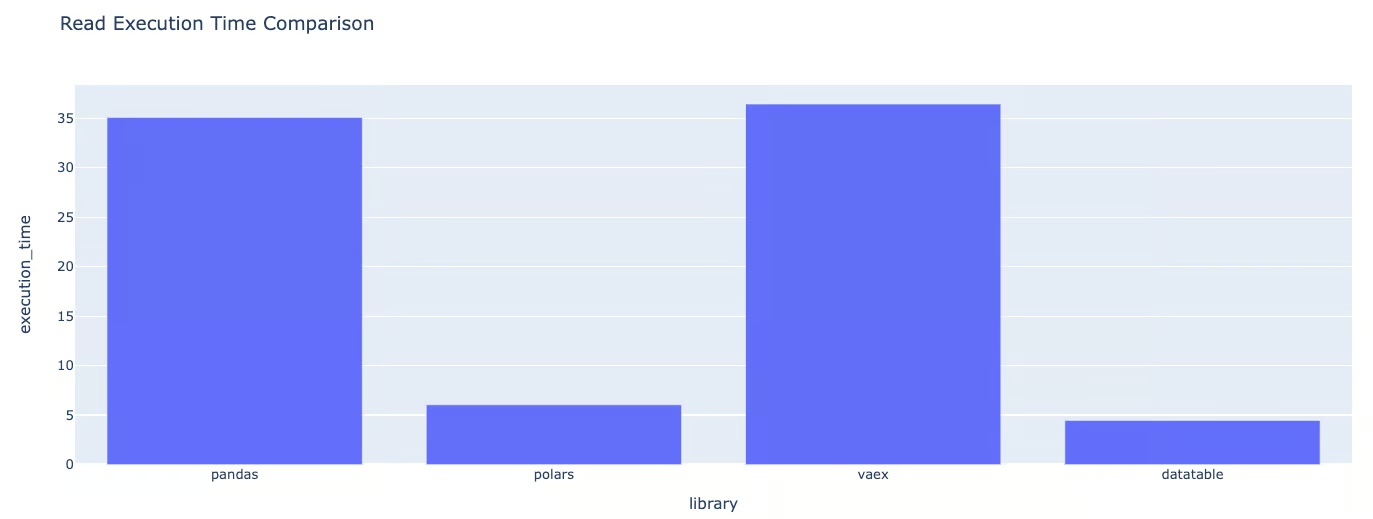
Grafische weergave van de uitvoeringstijden voor dataladen
Op basis van de grafiek kunnen we concluderen dat Polars:
- Polars is 1,35 keer zo traag als Datatable
- Pandas is 7,87 keer zo traag als Datatable.
- Vaex is ongeveer 8,17 keer zo traag als Datatable.
Data groeperen
Op vergelijkbare manier houdt group_data_with_time de uitvoeringstijd bij voor het groeperen op de in de parameter opgegeven kolom. In dit geval gebruiken we de kolom Pregnancies.
from time import time

def group_data_with_time(library_name, df, column_name='Pregnancies'):

 start_time = time()

 if library_name.lower() == 'polars':
     df_grouped = df.group_by(column_name).first()

 elif library_name.lower() == 'vaex':
     df_grouped = df.groupby(column_name, agg='first')

 elif library_name.lower() == 'pandas':
     df_grouped = df.groupby(column_name).first()

 elif library_name.lower() == 'datatable':
     df_grouped = df[:, dt.first(dt.f[:]), dt.by(column_name)]

 else:
     raise ValueError("Invalid library name. Must be 'polars', 'vaex', or 'datatable'")

 end_time = time()

 final_time = end_time - start_time

 return {"library": library_name, "execution_time": final_time}
pandas_time = group_data_with_time('pandas', pandas_df) polars_time = group_data_with_time('polars', polars_df) vaex_time = group_data_with_time('vaex', vaex_df) datatable_time = group_data_with_time('datatable', dt_df)exec_times = [pandas_time, polars_time, vaex_time, datatable_time] plot_metrics(exec_times, "Grouping Execution Time Comparison"){'library': 'pandas', 'execution_time': 2.382519245147705} {'library': 'pandas', 'execution_time'': 1.0898876190185547} {'library': 'pandas', 'execution_time': 0.8506548404693604} {'library': 'pandas', 'execution_time': 0.34698963165283203}
Grafische weergave van de uitvoeringstijden voor datagroepering
Voor de geüpdatete datagroeperingstaak, waarbij we de snelste bibliotheek DataTable vergelijken met de anderen:
We zien dat DataTable de snelste is van de geëvalueerde bibliotheken.

- Vaex is 2,45 keer zo traag als DataTable.
- Polars is 3,14 keer zo traag als DataTable.
- Pandas is 6,87 keer zo traag als DataTable.
Deze analyse toont de superieure efficiëntie van DataTable voor groeperingstaken, met Vaex relatief dicht in de buurt. Polars en Pandas laten vergelijkbare uitvoeringstijden zien en zijn beide aanzienlijk trager dan DataTable.
Kolommen sorteren
Met dezelfde aanpak sorteert de kolomsorteerfunctie de opgegeven kolom met elke bibliotheek.
def sort_data_with_time(library_name, df, column_name='Pregnancies'):

	start_time = time()

	if library_name.lower() == 'polars':
    	df_sorted = df.sort(column_name)
	elif library_name.lower() == 'vaex':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'datatable':
    	df_sorted = df.sort(column_name)

	elif library_name.lower() == 'pandas':
    	df_sorted = pd.DataFrame(df).sort_values(column_name)
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
pandas_time = sort_data_with_time('pandas', pandas_df)
polars_time = sort_data_with_time('polars', polars_df)
vaex_time = sort_data_with_time('vaex', vaex_df)
datatable_time = sort_data_with_time('datatable', dt_df){'library': 'pandas', 'execution_time': 6.735127687454224}
{'library': 'polars', 'execution_time': 4.119458436965942}
{'library': 'vaex', 'execution_time': 1.0371737480163574}
{'library': 'datatable', 'execution_time': 0.3971593379974365}Woordenboekweergave van de uitvoeringstijden voor datasortering
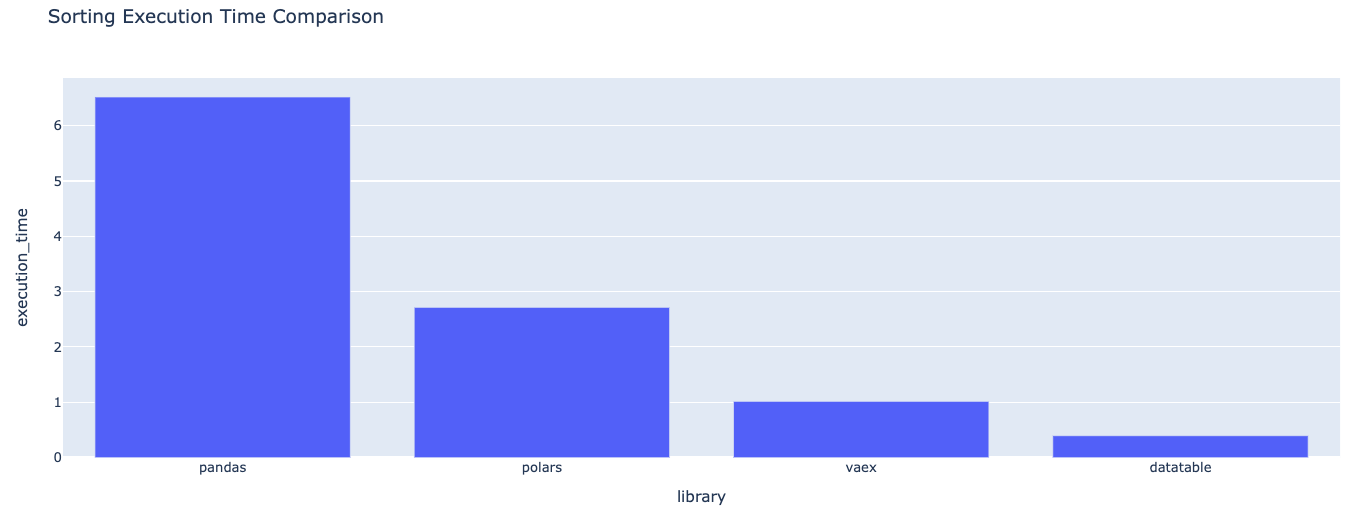
Grafische weergave van de uitvoeringstijden voor datasortering
Voor de sorteertaak is DataTable de snelste van de geëvalueerde bibliotheken.
- Vaex is 2,61 keer zo traag als DataTable.
- Polars is 10,37 keer zo traag als DataTable.
- Pandas is 16,96 keer zo traag als DataTable.
Deze analyse toont de superieure prestaties van DataTable bij het sorteren van data: het laat Vaex, Polars en Pandas ver achter zich, met Vaex als dichtstbijzijnde, maar nog steeds meer dan twee keer zo traag.
Data offloaden
Bij data offloaden is het idee om de oorspronkelijke data naar een ander formaat te converteren; in dit specifieke scenario naar een numpy-array.
def offload_data_with_time(library_name, df):

	start_time = time()

	if library_name.lower() == 'polars':
    	array = df.to_numpy()

	elif library_name.lower() == 'vaex':
    	array = df.to_pandas_df().values

	elif library_name.lower() == 'datatable':
    	array = df.to_numpy()

	elif library_name.lower() == 'pandas':
    	array = pd.DataFrame(df).values
	else:
    	raise ValueError("Invalid library name. Must be 'polars', 'vaex', 'datatable', or 'pandas'")

	end_time = time()

	final_time = end_time - start_time

	return {"library": library_name, "execution_time": final_time}
exec_times = [pandas_time, polars_time,
vaex_time, datatable_time]
plot_metrics(exec_times, "Data offloading Execution Time Comparison"){'library': 'pandas', 'execution_time': 1.8406445980072021}
{'library': 'polars', 'execution_time': 3.238591432571411}
{'library': 'vaex', 'execution_time': 6.945307970046997}
{'library': 'datatable', 'execution_time': 2.634136438369751}Woordenboekweergave van de uitvoeringstijden voor data offloaden
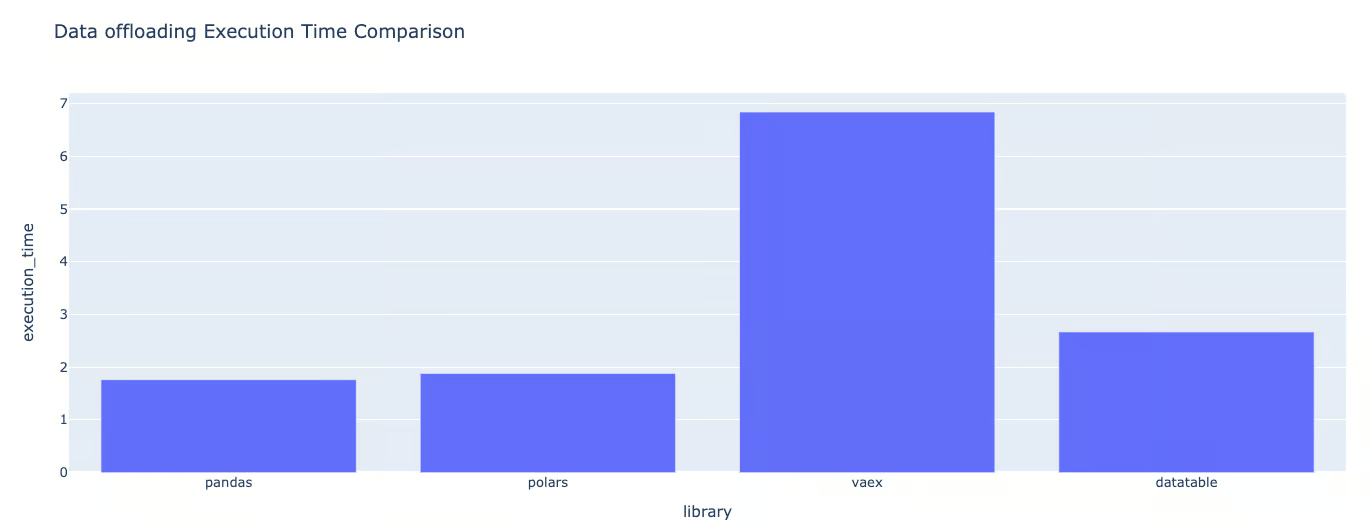
Grafische weergave van de uitvoeringstijden voor data offloaden
Data offloaden is de laatste ronde van de benchmarking voor de uitvoeringstijd.
Dit keer heeft Vaex de hoogste uitvoeringstijd. Vergeleken met deze bibliotheken zien we voor pandas dat de uitvoeringstijd ongeveer als volgt is:
- DataTable is 1,43 keer zo traag als Pandas.
- Polars is 1,76 keer zo traag als Pandas.
- Vaex is 3,77 keer zo traag als Pandas.
Benchmarking van geheugengebruik
Uitvoeringstijd is niet het enige criterium bij het vergelijken van bibliotheken. Het is ook belangrijk te weten hoe efficiënt ze met geheugen omgaan. Deze sectie toont twee soorten geheugengebruik met de tracemalloc-bibliotheek:
- Huidig geheugengebruik. De totale hoeveelheid geheugen die tijdens de uitvoering met een specifieke bibliotheek wordt gebruikt. Dit komt overeen met de RAM-ruimte die op dat moment bezet is.
- Piekgeheugengebruik. Komt overeen met de maximale hoeveelheid geheugen die door het programma is gebruikt. Belangrijk om te weten: het piekgeheugen ligt altijd hoger dan het huidige geheugen.
Door deze visualisaties begrijp je beter welke programma’s veel geheugen gebruiken, wat kan leiden tot out-of-memory-fouten, zeker bij grote datasets.
Naast tracemalloc is ook de os-bibliotheek nodig.
import tracemalloc as tm
import os
Voor we beginnen maken we een lege lijst aan die de resultaten van elk geheugengebruiksgetal zal bevatten.
list_memory_usage = []Voor elke bibliotheek wordt het geheugengebruik geschat met de algemene syntax hieronder, hier toegepast op Vaex. Ook focussen we hier alleen op het geheugengebruik voor de data-offloadtaken.
tm.start()
vaex_time = offload_data_with_time('vaex', vaex_df)
memory_usage = tm.get_traced_memory()
tm.stop()

list_memory_usage.append({
	'library': 'vaex',
	'memory_usage': memory_usage
})
De syntax is hetzelfde voor de overige bibliotheken. We krijgen de volgende instructies, respectievelijk voor Polars, pandas en Datatable:
tm.start()
polars_time = offload_data_with_time('polars', polars_df)
memory_usage = tm.get_traced_memory()

tm.stop()

list_memory_usage.append({
	'library': 'polars',
	'memory_usage': memory_usage
})
tm.start()
offload_data_with_time('pandas', pandas_df)
# Get the memory usage
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'pandas',
'memory_usage': memory_usage
})tm.start()
datatable_time = offload_data_with_time('datatable', datatable_df)
memory_usage = tm.get_traced_memory()
tm.stop()
list_memory_usage.append({
'library': 'datatable',
'memory_usage': memory_usage
})Na de uitvoering van alle bovenstaande code kunnen we de grafiek plotten met de onderstaande hulpfunctie:
def plot_memory_usage(list_memory_usage, graph_title='Memory Usage by Library'):

	df = pd.DataFrame(list_memory_usage)

	# separate the memory usage tuple into two columns: current_memory and peak_memory
	df[['current_memory', 'peak_memory']] = pd.DataFrame(df['memory_usage'].tolist(), index=df.index)

	# now we no longer need the memory_usage column
	df = df.drop(columns='memory_usage')

	# melt the DataFrame to make it suitable for grouped bar chart
	df_melted = df.melt(id_vars='library', var_name='memory_type', value_name='memory')

	# create the grouped bar chart
	fig = px.bar(df_melted, x='library', y='memory', color='memory_type', barmode='group',
             	labels={'memory':'Memory Usage (bytes)', 'library':'Library', 'memory_type':'Memory Type'},
             	title=graph_title)

	fig.update_layout(yaxis_type="log")
	fig.show()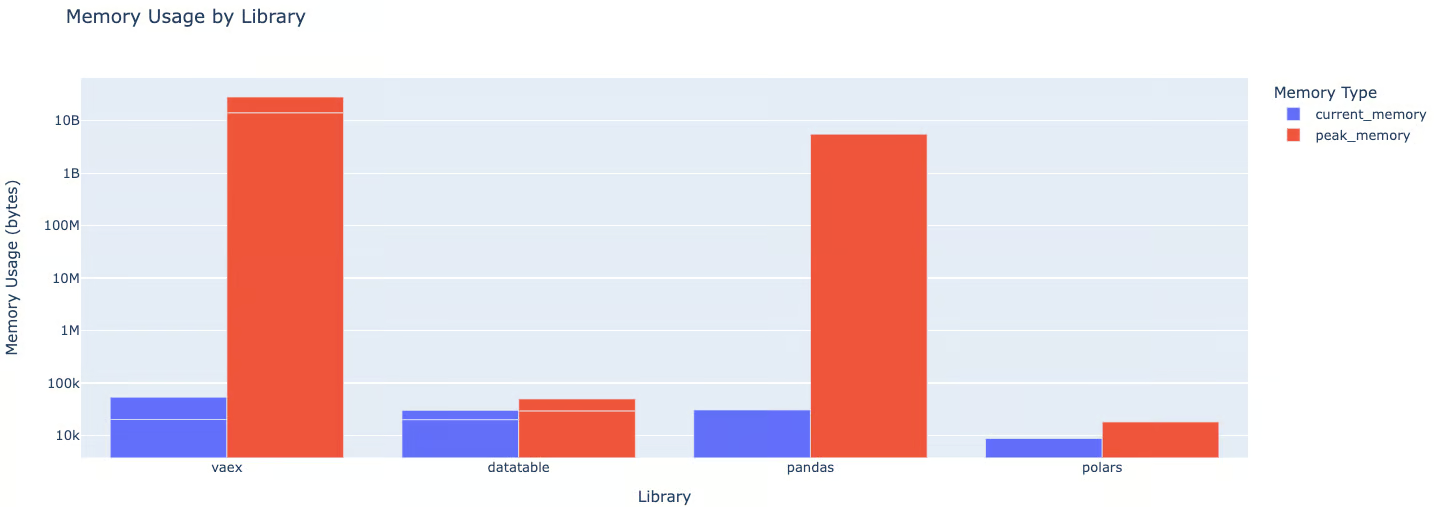
We merken dat:
- Pandas ongeveer 1100 keer meer huidig geheugen gebruikt dan Polars, 7,4 keer meer dan Vaex en 29,4 keer meer dan Datatable.
- Wat piekgeheugengebruik betreft, gebruiken zowel pandas als Vaex ongeveer 963K keer meer geheugen dan Polars en 131K keer meer dan Datatable.
Vervolgonderzoek, zoals Dask versus pandas qua snelheid, kan een breder beeld geven.
Vergelijkingstabel voor pandas-alternatieven
Hieronder hebben we onze bevindingen samengevat in een vergelijkingstabel, met de verschillen tussen Polars, Vaex en Datatable:
|
Benchmarkcriteria |
Polars |
Vaex |
Datatable |
|
Tijd voor dataladen |
Sneller dan Vaex, trager dan Datatable |
Trager dan zowel Polars als Datatable |
Snelste van de drie |
|
Tijd voor datagroepering |
Traagste van de drie |
Sneller dan Polars, trager dan Datatable |
Snelste van de drie |
|
Tijd voor datasortering |
Sneller dan Vaex, trager dan Datatable |
Trager dan zowel Polars als Datatable |
Snelste van de drie |
|
Tijd voor data offloaden |
Sneller dan Vaex, trager dan Datatable |
Traagste van de drie |
Sneller dan Polars, trager dan Vaex |
|
Huidig geheugengebruik |
Gebruikt het minste geheugen |
Gebruikt meer geheugen dan Polars maar minder dan Datatable |
Gebruikt het meeste geheugen van de drie |
|
Piekgeheugengebruik |
Gebruikt het minste geheugen |
Gebruikt meer geheugen dan Polars maar minder dan Datatable |
Gebruikt het meeste geheugen van de drie |
|
Schaalbaarheid |
Schaalbaar met de databomvang |
Schaalbaar met de databomvang, maar kan meer geheugen gebruiken naarmate de data toeneemt |
Zeer schaalbaar met de databomvang |
|
Gebruiksgemak |
Heeft een complete Python-API en is compatibel met Apache Arrow |
Maakt gebruik van luie evaluatie en is compatibel met Pandas |
Biedt interoperabiliteit met Pandas/NumPy/pure Python |
Conclusie
Bij het beoordelen van schaalbaarheid en integratiegemak spelen meerdere factoren. Onze benchmarking liet zien dat, hoewel pandas gevestigd en gebruiksvriendelijk is en een steilere leercurve heeft, het grote datasets niet efficiënt afhandelt.
Er zijn echter verschillende manieren om pandas te versnellen, en onze High-Performance Data Manipulation in Python: Pandas 2.0 vs Polars kan daarbij helpen.
De prestaties van Vaex variëren per taak. Een alternatief voor Pandas kiezen hangt daarom af van de specifieke behoeften van gebruikers, de omvang van datasets en hun vermogen om met de leercurve en integratie om te gaan.


