
Kursus
Claude Code 101
3 jam
27.9K
Pembaruan (1 Juli 2026): Akses ke Claude Fable 5 telah dipulihkan, kini tersedia secara global di Claude Platform, Claude.ai, Claude Code, dan Claude Cowork setelah perintah pengendalian ekspor dicabut. Mythos 5 tetap terbatas untuk mitra Project Glasswing yang telah diverifikasi.
Pembaruan (2 September 2026): Anthropic telah merilis model penerus Fable 5. Saya sarankan membaca panduan Claude Fable 5.1 kami untuk semua detailnya.
Saat saya menguji model baru melalui API, saya kurang memedulikan catatan peluncuran dan lebih fokus pada bagian yang harus saya sambungkan ke kode: seperti apa panggilan API itu, apa yang berubah dari model sebelumnya, berapa biayanya, dan apa yang terjadi saat lapisan keamanan menolak?
Artikel ikhtisar tentang Claude Fable 5 membahas peluncuran, hasil benchmark, dan pengaturan keamanan yang membuat Fable 5 unik. Kode di bawah melanjutkan dari sana. Secara khusus, kita akan menggunakan Developer Task Assistant yang menerima permintaan fitur perangkat lunak dan mengembalikan rencana implementasi terstruktur, lalu menambahkan streaming, penggunaan tool, pelacakan biaya, dan endpoint FastAPI.
Kita akan melalui:
Claude Fable 5 adalah model Anthropic yang dirilis pada 9 Juni 2026 dengan string model API claude-fable-5. Anthropic menjelaskannya sebagai model dasar yang sama dengan Claude Mythos 5, tetapi dengan classifier keamanan yang diterapkan untuk ketersediaan umum. Mythos 5 tetap terbatas untuk Project Glasswing, program terbatas bagi organisasi keamanan tepercaya.
Bagi pengembang, detail API yang relevan adalah:
Konteks 1 juta token dan hingga 128k token keluaran per permintaan
Harga $10 per sejuta token input dan $50 per sejuta token output, dua kali lipat Opus 4.8
Adaptive thinking selalu aktif. Anda tidak dapat menonaktifkannya. Parameter effort mengatur kedalaman; penalaran internal model dihasilkan dan ditagihkan terlepas dari apakah Anda menampilkannya atau tidak
Ini adalah "Covered Model," artinya retensi data 30 hari bersifat wajib. Zero Data Retention tidak tersedia untuk model ini.
Saya tidak akan menggunakannya untuk setiap panggilan API. Lebih masuk akal untuk tugas yang memerlukan penalaran lintas arsitektur, edge case, dan detail implementasi. Untuk pekerjaan yang lebih sederhana, Sonnet 4.6 atau Haiku 4.5 kemungkinan sudah cukup.
Asisten yang akan kita bangun menerima permintaan fitur perangkat lunak dan mengembalikan rencana terstruktur: ringkasan teknis, langkah implementasi berurutan, kemungkinan perubahan file, risiko, dan pengujian.
Saya menggunakan contoh ini karena memaksa detail API yang biasanya penting dalam integrasi nyata: keluaran terstruktur, streaming, panggilan tool, biaya, dan penanganan penolakan. Ini kecil, tetapi bukan sekadar Hello World.
Bagian-bagian di bawah ini membangun komponen tersebut satu per satu.
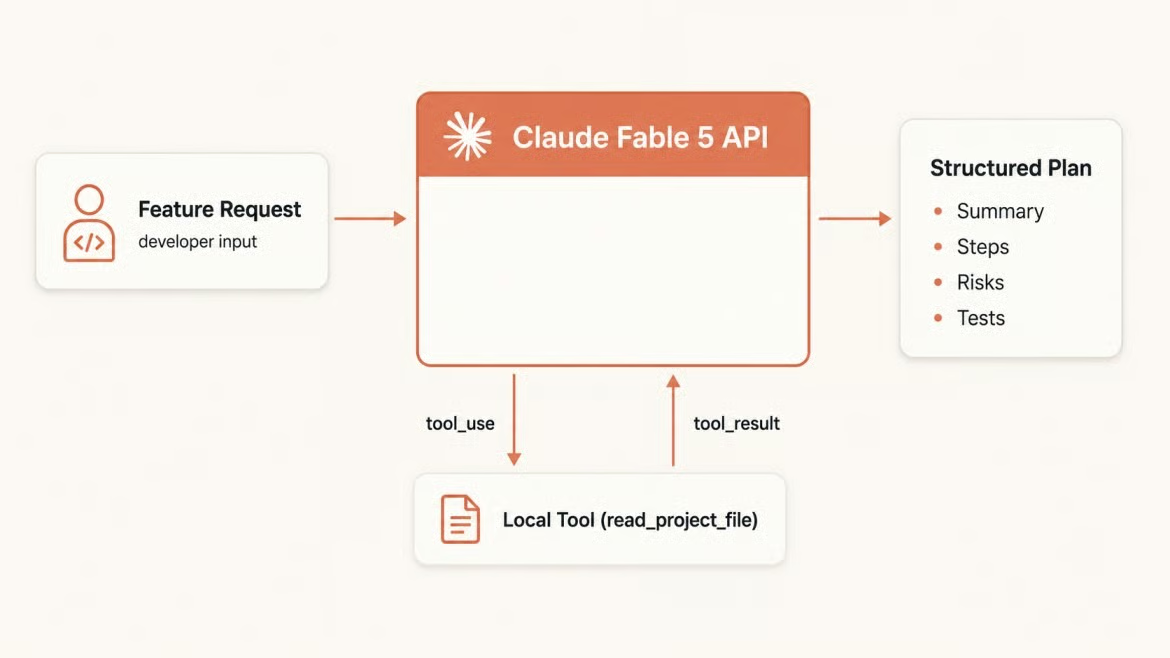
Permintaan fitur mengalir ke rencana terstruktur. Gambar oleh Penulis.
Kode utama berada di task_assistant.py untuk skrip lokal dan app.py untuk endpoint FastAPI.
Untuk mengikutinya, Anda memerlukan:
Python 3.9 atau lebih baru (tutorial menggunakan fitur 3.10+ seperti type hints bawaan di model Pydantic, tetapi SDK sendiri mendukung 3.9+)
Kunci API Anthropic dengan akses ke claude-fable-5
Pemahaman dasar tentang variabel lingkungan, JSON, dan HTTP API
Terminal dan editor kode
Mulailah dengan membuat folder proyek dan virtual environment.
mkdir task-assistant
cd task-assistant
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
Instal Anthropic SDK, FastAPI, dan beberapa helper.
pip install anthropic fastapi uvicorn python-dotenv pydanticBuat file .env di root proyek dengan kunci API Anda. Jangan pernah commit file ini ke version control.
ANTHROPIC_API_KEY=sk-ant-...Muat di bagian atas skrip Anda. Anthropic() membaca ANTHROPIC_API_KEY dari lingkungan secara otomatis.
from dotenv import load_dotenv
from anthropic import Anthropic

load_dotenv()
client = Anthropic()
Inisialisasi klien sekali di level modul dan gunakan kembali di seluruh tutorial.
Sebelum menambahkan logika proyek, saya suka mengirim permintaan minimal untuk memastikan penyiapan berfungsi. Messages API menerima string model, batas max_tokens, dan array messages. max_tokens wajib; SDK akan melempar TypeError jika Anda mengabaikannya.
MODEL = "claude-fable-5"

def get_text(response):
    """Return the first text block, skipping thinking or tool blocks."""
    return next((b.text for b in response.content if b.type == "text"), "")

response = client.messages.create(
    model=MODEL,
    max_tokens=512,
    messages=[{"role": "user", "content": "Reply in one sentence to confirm the API connection is working."}]
)

print(get_text(response))
print(f"Model: {response.model}")
print(f"Input tokens: {response.usage.input_tokens}")
print(f"Output tokens: {response.usage.output_tokens}")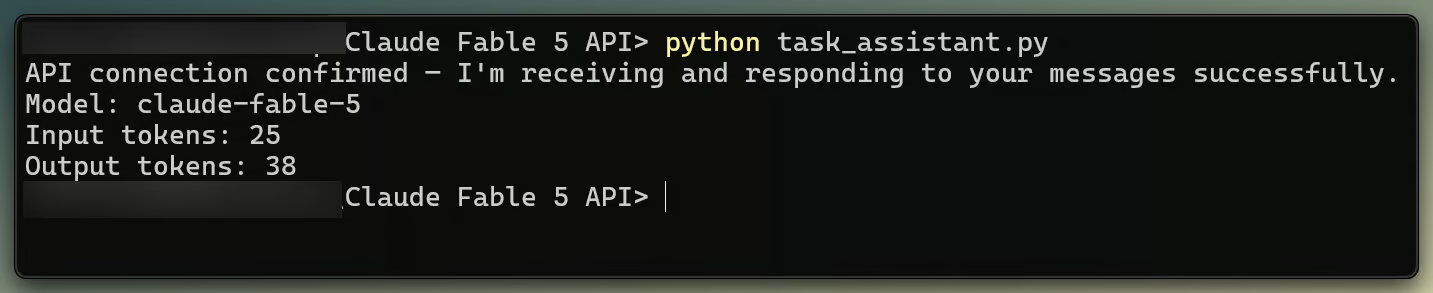
Respons API Fable 5 dan token. Gambar oleh Penulis.
response.content adalah daftar content block, bukan string biasa. Karena perilaku adaptive thinking yang disebutkan di atas, block pertama sering kali adalah thinking block, dan content[0].text dapat memicu AttributeError. Helper get_text memfilter berdasarkan block.type == "text" sebagai gantinya.
Objek usage memberi Anda jumlah token input dan output setelah setiap permintaan. response.model melaporkan model mana yang menjawab, yang penting saat fallback dikonfigurasi.
Parameter effort yang dilewatkan di dalam output_config adalah kendali untuk kedalaman penalaran tersebut.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": feature_request}]
)
Default-nya adalah "high". Saya akan mulai dari sana, lalu gunakan "low" atau "medium" saat latensi lebih penting dan "xhigh" atau "max" untuk masalah yang lebih panjang. Effort mengubah berapa banyak thinking token yang dihasilkan model, bukan apakah ia menghasilkannya.
Parameter system adalah field tingkat atas dalam permintaan, terpisah dari array messages . Apa pun yang Anda letakkan di sana berlaku untuk setiap giliran, yang berarti ia bekerja lebih banyak per kata daripada instruksi satu giliran.
Untuk Developer Task Assistant, saya menjaga system prompt tetap sempit: kembalikan rencana rekayasa yang ringkas alih-alih analisis luas.
SYSTEM_PROMPT = """You are a senior software engineer who reviews feature requests and returns
implementation plans. For every request:
- Write a one sentence technical summary
- List the implementation steps in order
- Name the files or components most likely to change
- Call out at most three risks or edge cases
- Suggest concrete tests
Do not narrate options you won't pursue. Act on what you know; ask only when key details are missing."""
Instruksi terakhir itu penting. Fable 5 bisa menambahkan terlalu banyak perencanaan untuk permintaan sederhana, jadi prompt membatasi keluaran sebelum respons melenceng.
Lewatkan system prompt bersama setiap panggilan.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature_request}]
)
Prefilling giliran asisten tidak didukung di Fable 5. Jika Anda memiliki kode Claude lama yang memulai giliran asisten dengan {"role": "assistant", "content": "{"} untuk memaksa keluaran JSON, hapus itu. Pola tersebut mengembalikan 400 di Fable 5, yang mudah menjebak saat mem-porting kode lama.
Merencanakan fitur berarti melacak arsitektur, mode kegagalan, dan strategi pengujian dalam satu respons. Ini adalah alur kerja pertama yang baik karena cukup kecil untuk diperiksa, tetapi bukan sekadar prompt mainan.
feature = (
    "Add password reset to our Django app. "
    "Users should receive a token via email and land on a form to set a new password."
)

response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)

print(get_text(response))
Respons khas mencakup pembuatan token, pengiriman email, penanganan formulir, dan pembersihan kedaluwarsa dalam satu kali proses.
Teks biasa memadai di terminal. Setelah rencana perlu menjadi data aplikasi, keluaran terstruktur lebih mudah digunakan. Claude API mendukung keluaran terstruktur melalui client.messages.parse() dan model Pydantic, dan ini berfungsi dengan claude-fable-5.
Definisikan bentuk keluaran yang diharapkan sebagai model Pydantic.
from pydantic import BaseModel

class FeaturePlan(BaseModel):
    summary: str
    steps: list[str]
    files: list[str]
    risks: list[str]
    tests: list[str]
Lewatkan kelas sebagai output_format. SDK mengubahnya menjadi skema JSON, menjalankan constrained decoding di server Anthropic, dan mengembalikan objek bertipe di response.parsed_output.
response = client.messages.parse(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}],
    output_format=FeaturePlan
)

plan = response.parsed_output
if plan is not None:
    print(f"Summary: {plan.summary}")
    print(f"Steps: {plan.steps}")
Periksa parsed_output apakah None sebelum menggunakannya. Penolakan saat streaming atau pemotongan awal max_tokens dapat membuatnya kosong. Jalur ini juga menghindari masalah thinking block karena Anda membaca parsed_output alih-alih masuk ke content.
Jika Anda membutuhkan keluaran terstruktur pada model yang tidak mendukungnya di API, mintalah JSON di prompt dan validasi dengan FeaturePlan.model_validate_json(text), coba ulang sekali jika gagal. Jangan memasangkan keluaran terstruktur dengan prefilling giliran asisten; Fable 5 mengembalikan 400 untuk pola itu.
Perilaku adaptive thinking yang sama dapat meningkatkan waktu tunggu sebelum token pertama pada prompt yang kompleks. Streaming mencetak potongan teks saat tiba.
Gunakan context manager client.messages.stream() . stream.text_stream menghasilkan potongan teks dan otomatis melewati thinking block.
with client.messages.stream(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
) as stream:
    for chunk in stream.text_stream:
        print(chunk, end="", flush=True)

final = stream.get_final_message()
print(f"\nInput tokens: {final.usage.input_tokens}")
print(f"Output tokens: {final.usage.output_tokens}")
Panggil get_final_message() setelah blok with ditutup, bukan di dalamnya. Di situlah alasan berhenti dan hitungan penggunaan berada.
Streaming dan keluaran terstruktur bisa berdampingan, tetapi kumpulkan respons penuh sebelum Anda mem-parsenya. JSON parsial bukan JSON yang valid.
Penggunaan tool memungkinkan model meminta informasi alih-alih hanya mengandalkan prompt. Saya menjaga tool pertama tetap kecil: read_project_file. Model meminta membaca file, kode Anda membacanya, dan model menggunakan temuan tersebut.
Tool loop memiliki bentuk tetap. Claude mengembalikan stop_reason: "tool_use" saat ingin memanggil tool, Anda mengeksekusi tool dan mengirim kembali block tool_result, dan loop berlanjut hingga stop_reason adalah "end_turn" atau "refusal".
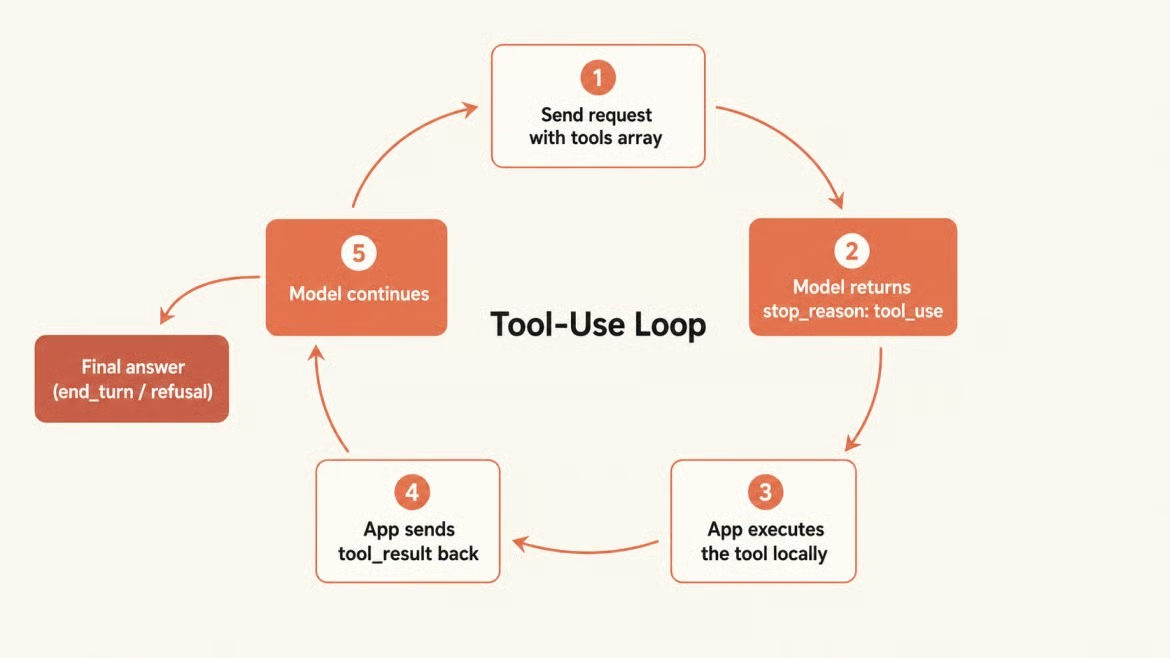
Loop tool dari permintaan hingga jawaban. Gambar oleh Penulis.
READ_FILE_TOOL = {
    "name": "read_project_file",
    "description": "Read the contents of a file in the project.",
    "input_schema": {
        "type": "object",
        "properties": {
            "path": {"type": "string", "description": "Relative path to the file"}
        },
        "required": ["path"]
    }
}

messages = [{"role": "user", "content": feature}]

while True:
    response = client.messages.create(
        model=MODEL,
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        tools=[READ_FILE_TOOL],
        messages=messages
    )

    if response.stop_reason in ("end_turn", "refusal"):
        break

    if response.stop_reason == "tool_use":
        tool_block = next(b for b in response.content if b.type == "tool_use")

        # Execute the tool locally
        try:
            with open(tool_block.input["path"]) as f:
                result = f.read()[:2000]
        except FileNotFoundError:
            result = f"File not found: {tool_block.input['path']}"

        messages.append({"role": "assistant", "content": response.content})
        messages.append({
            "role": "user",
            "content": [{
                "type": "tool_result",
                "tool_use_id": tool_block.id,
                "content": result
            }]
        })

# Read the final answer
text_block = next((b for b in response.content if b.type == "text"), None)
print(text_block.text if text_block else "No text in final response")
Model tidak pernah mengeksekusi kode ini. Model mengeluarkan permintaan terstruktur dengan nama tool dan input JSON; aplikasi Anda yang menjalankan pembacaan file. Jangan menambahkan teks percakapan dalam giliran pengguna yang sama dengan block tool_result , atau model mungkin berhenti alih-alih melanjutkan rencana.
Sebelum mengubah ini menjadi aplikasi, periksa bentuk biayanya. Fable 5 berbiaya $10 per sejuta token input dan $50 per sejuta token output. Output biasanya menjadi pos terbesar: rencana 2.000 token berharga $0,10 untuk output saja.
Berikut tabel harga di seluruh keluarga Anthropic.
|
Model |
Input (per MTok) |
Output (per MTok) |
Catatan |
|
Haiku 4.5 |
$1 |
$5 |
Tercepat, kualitas mendekati frontier |
|
Sonnet 4.6 |
$3 |
$15 |
Keseimbangan kuat antara kecepatan dan kedalaman |
|
Opus 4.8 |
$5 |
$25 |
Tingkat Opus teratas |
|
Fable 5 |
$10 |
$50 |
Model paling andal yang dirilis luas |
Caching prompt dapat mengurangi biaya pembacaan system prompt yang berulang. Setelah block system prompt dicache, pembacaan berulang berbiaya $1 per sejuta token, bukan $10. Block minimum yang dapat dicache adalah 512 token di Claude API.
# Count tokens before sending an expensive request
count = client.messages.count_tokens(
    model=MODEL,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)
print(f"Estimated input tokens: {count.input_tokens}")

# Calculate actual cost after each request
INPUT_PRICE = 10.0 / 1_000_000
OUTPUT_PRICE = 50.0 / 1_000_000

response = client.messages.create(...)
cost = (
    response.usage.input_tokens * INPUT_PRICE +
    response.usage.output_tokens * OUTPUT_PRICE
)
print(f"Total cost: ${cost:.6f}")
count_tokens tidak berbiaya uang dan tidak dihitung terhadap batas laju output Anda. Gunakan untuk menyaring permintaan mahal. Untuk pekerjaan yang tidak memerlukan interaksi, Batch API memangkas harga input dan output menjadi setengahnya.
Fable 5 menggunakan tokenizer yang diperkenalkan dengan Opus 4.7, yang dapat menghasilkan kira-kira 30% lebih banyak token pada teks yang sama dibanding model Claude yang lebih lama. Perhitungkan ini saat migrasi dari Claude 4.6.
Fable 5 menjalankan classifier keamanan bersamaan dengan generasi. Saat salah satunya terpicu, API mengembalikan HTTP 200 yang berhasil, bukan error, dan satu-satunya sinyal adalah stop_reason: "refusal". Penanganan error yang hanya menangkap exception akan melewatkan penolakan seluruhnya, dan aplikasi Anda akan diam-diam tidak mengembalikan apa pun.
Selalu periksa alasan berhenti.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}]
)

if response.stop_reason == "refusal":
    category = (
        response.stop_details.category
        if response.stop_details else "policy"
    )
    print(f"Request declined ({category}). Please rephrase and try again.")
else:
    print(get_text(response))
Dalam pengujian saya, Fable 5 sering menolak permintaan batas abu-abu dalam teks biasa, mengembalikan end_turn normal. Penolakan classifier keras, dengan stop_reason: "refusal" dan content kosong, lebih jarang. Pemeriksaan di atas menangani jalur itu agar aplikasi Anda tidak diam-diam tidak mengembalikan apa pun.
stop_details.category dapat berupa "cyber", "bio", atau "reasoning_extraction". Yang terakhir menyala ketika prompt mencoba mengekstrak chain-of-thought internal model. Untuk tool pengembang yang memeriksa pemindai keamanan jaringan atau pipeline data biologis, Anda mungkin terkena false positive classifier. Mengubah redaksi agar tugas jelas bersifat defensif sering kali menyelesaikannya.
Untuk sistem terpasang, Anda dapat mengonfigurasi fallback otomatis ke Opus 4.8 dengan fallbacks beta yang berjalan di server dalam Claude API dan Claude Platform di AWS. Itu tidak sama dengan Amazon Bedrock: Bedrock, Vertex AI, dan Foundry memerlukan logika fallback di aplikasi Anda.
response = client.beta.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}],
    fallbacks=[{"model": "claude-opus-4-8"}],
    betas=["server-side-fallback-2026-06-01"]
)
Permintaan yang ditolak yang tidak menghasilkan output tidak ditagihkan. Penolakan di tengah streaming ditagihkan untuk apa pun yang dihasilkan sebelum classifier aktif.
Jika aplikasi Anda hanya menangani teks, Anda bisa melewati bagian ini. Bagian ini terpisah dari alur perencanaan, tetapi menggunakan bentuk Messages API yang sama. Fable 5 menerima input gambar sebagai block yang dikodekan base64 atau URL. Salah satu kasus penggunaan adalah ulasan tangkapan layar UI terhadap kebutuhan fitur.
import base64

with open("login_form.png", "rb") as f:
    img_data = base64.standard_b64encode(f.read()).decode("utf-8")

response = client.messages.create(
    model=MODEL,
    max_tokens=1024,
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "image",
                "source": {
                    "type": "base64",
                    "media_type": "image/png",
                    "data": img_data
                }
            },
            {
                "type": "text",
                "text": "Review this UI against the requirement: add a 'Forgot password' link below the login button. Is it present? If not, describe what needs to change."
            }
        ]
    }]
)
print(get_text(response))
Gambar ukuran penuh berbiaya sekitar 4.784 token input terlepas dari apa yang ditampilkan, jadi ubah ukuran atau kompres sebelum mengirim jika Anda tidak membutuhkan resolusi penuh. Fable 5 memproses gambar hingga lebar 2.576 px dan menskalakan turun apa pun yang lebih besar. Format yang didukung adalah JPEG, PNG, GIF, dan WebP.
Pada titik ini, skrip lokal telah memiliki alur kerja lengkap. Bungkus asisten dalam route FastAPI agar frontend atau layanan dapat memanggilnya. Gunakan AsyncAnthropic di dalam route async, karena klien sinkron memblokir event loop. Inisialisasi sekali saat startup, bukan per permintaan.
from contextlib import asynccontextmanager
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from anthropic import AsyncAnthropic

client_instance: AsyncAnthropic | None = None

@asynccontextmanager
async def lifespan(app: FastAPI):
    global client_instance
    client_instance = AsyncAnthropic()
    yield
    await client_instance.close()

app = FastAPI(lifespan=lifespan)

class PlanRequest(BaseModel):
    feature_request: str

@app.post("/plan")
async def create_plan(body: PlanRequest):
    response = await client_instance.messages.create(
        model="claude-fable-5",
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        messages=[{"role": "user", "content": body.feature_request}]
    )

    if response.stop_reason == "refusal":
        raise HTTPException(status_code=400, detail="Request declined by safety classifier.")

    return {
        "plan": get_text(response),
        "input_tokens": response.usage.input_tokens,
        "output_tokens": response.usage.output_tokens
    }
Jalankan dengan uvicorn app:app --reload dan uji endpoint /plan melalui dokumentasi FastAPI di http://localhost:8000/docs.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt




