
Corso
Claude Code 101
3 ore
27.6K
Aggiornamento (1 luglio 2026): L’accesso a Claude Fable 5 è stato ripristinato ed è ora disponibile a livello globale su Claude Platform, Claude.ai, Claude Code e Claude Cowork dopo la revoca dell’ordine di controllo all’esportazione. Mythos 5 resta limitato ai partner selezionati del Project Glasswing.
Aggiornamento (2 settembre 2026): Anthropic ha pubblicato il modello successore di Fable 5. Ti consiglio di leggere la nostra guida su Claude Fable 5.1 per tutti i dettagli.
Quando testo un nuovo modello tramite API, mi interessano meno le note di lancio e più le parti che devo collegare al codice: com’è l’API call, cosa è cambiato rispetto al modello precedente, quanto costerà e cosa succede quando il livello di sicurezza dice di no?
Il nostro articolo panoramico su Claude Fable 5 ha coperto il lancio, i benchmark e l’impostazione di sicurezza che rende Fable 5 unico. Il codice qui sotto riparte da lì. In particolare, useremo un Developer Task Assistant che prende una richiesta di funzionalità software e restituisce un piano di implementazione strutturato, poi aggiungeremo streaming, uso di tool, tracciamento dei costi e un endpoint FastAPI.
Percorreremo:
Claude Fable 5 è un modello Anthropic rilasciato il 9 giugno 2026, con la stringa modello API claude-fable-5. Anthropic lo descrive come lo stesso modello base di Claude Mythos 5, ma con classificatori di sicurezza applicati per la disponibilità generale. Mythos 5 rimane limitato a Project Glasswing, un programma ristretto per organizzazioni di sicurezza fidate.
Per gli sviluppatori, i dettagli API rilevanti sono:
Una finestra di contesto da 1M token e fino a 128k token di output per richiesta
Prezzo di $10 per milione di token in input e $50 per milione di token in output, il doppio di Opus 4.8
L’adaptive thinking è sempre attivo. Non puoi disabilitarlo. Il parametro effort controlla la profondità; il ragionamento interno del modello viene generato e fatturato a prescindere dal fatto che tu lo mostri o meno
È un “Covered Model”, il che significa che la conservazione dei dati per 30 giorni è obbligatoria. Zero Data Retention non è disponibile per questo modello.
Non lo userei per ogni chiamata API. Ha più senso per attività che richiedono ragionamento su architettura, edge case e dettagli di implementazione. Per lavori più semplici, Sonnet 4.6 o Haiku 4.5 probabilmente bastano.
L’assistente che costruiremo accetta una richiesta di funzionalità software e restituisce un piano strutturato: un riassunto tecnico, passaggi di implementazione ordinati, probabili modifiche ai file, rischi e test.
Uso questo esempio perché costringe a trattare i dettagli API che di solito contano in un’integrazione reale: output strutturato, streaming, chiamate a tool, costi e gestione dei rifiuti. È piccolo, ma non è un semplice Hello World.
Le sezioni seguenti costruiscono questi pezzi uno alla volta.
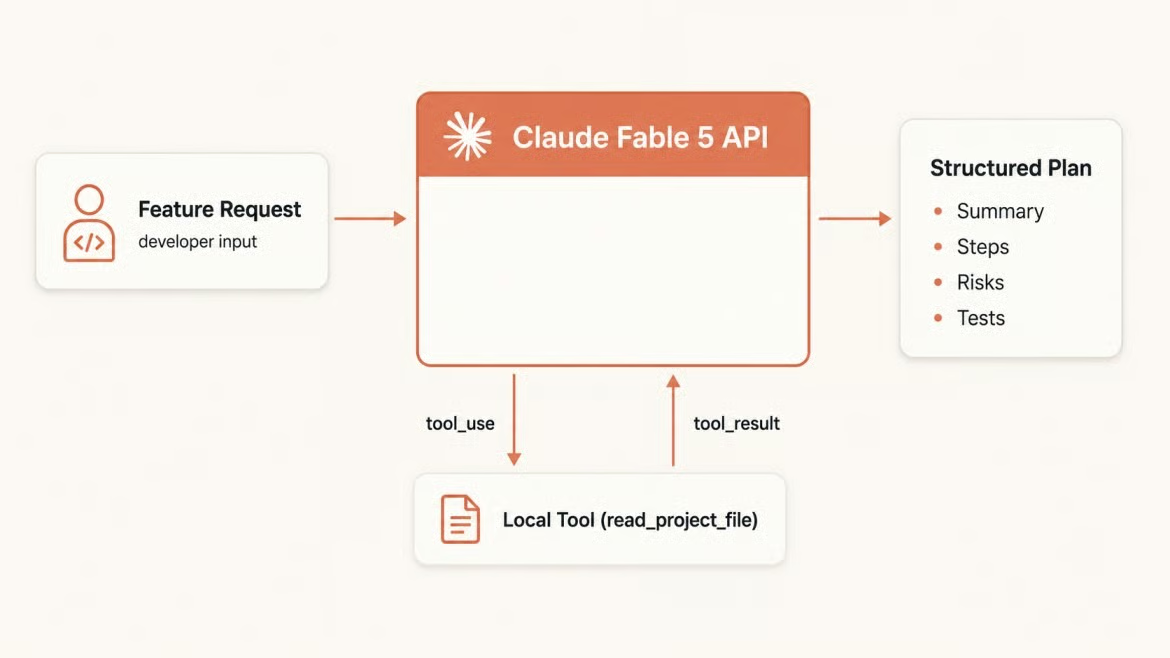
La richiesta di funzionalità fluisce in un piano strutturato. Immagine dell’autore.
Il codice principale vive in task_assistant.py per lo script locale e in app.py per l’endpoint FastAPI.
Per seguire il tutorial, ti serviranno:
Python 3.9 o successivo (il tutorial usa funzioni di 3.10+ come gli hint di tipo integrati nei modelli Pydantic, ma l’SDK in sé supporta 3.9+)
Una chiave API Anthropic con accesso a claude-fable-5
Familiarità di base con variabili d’ambiente, JSON e API HTTP
Un terminale e un editor di codice
Inizia creando una cartella di progetto e un ambiente virtuale.
mkdir task-assistant
cd task-assistant
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
Installa l’SDK Anthropic, FastAPI e qualche helper.
pip install anthropic fastapi uvicorn python-dotenv pydanticCrea un file .env nella root del progetto con la tua chiave API. Non effettuare mai il commit di questo file nel controllo versione.
ANTHROPIC_API_KEY=sk-ant-...Caricalo all’inizio del tuo script. Anthropic() legge ANTHROPIC_API_KEY dall’ambiente automaticamente.
from dotenv import load_dotenv
from anthropic import Anthropic

load_dotenv()
client = Anthropic()
Inizializza il client una sola volta a livello di modulo e riutilizzalo lungo tutto il tutorial.
Prima di aggiungere la logica del progetto, mi piace inviare una richiesta minima per confermare che la configurazione funzioni. La Messages API accetta una stringa modello, un limite max_tokens e un array di messaggi. max_tokens è obbligatorio; l’SDK solleva un TypeError se lo ometti.
MODEL = "claude-fable-5"

def get_text(response):
    """Return the first text block, skipping thinking or tool blocks."""
    return next((b.text for b in response.content if b.type == "text"), "")

response = client.messages.create(
    model=MODEL,
    max_tokens=512,
    messages=[{"role": "user", "content": "Reply in one sentence to confirm the API connection is working."}]
)

print(get_text(response))
print(f"Model: {response.model}")
print(f"Input tokens: {response.usage.input_tokens}")
print(f"Output tokens: {response.usage.output_tokens}")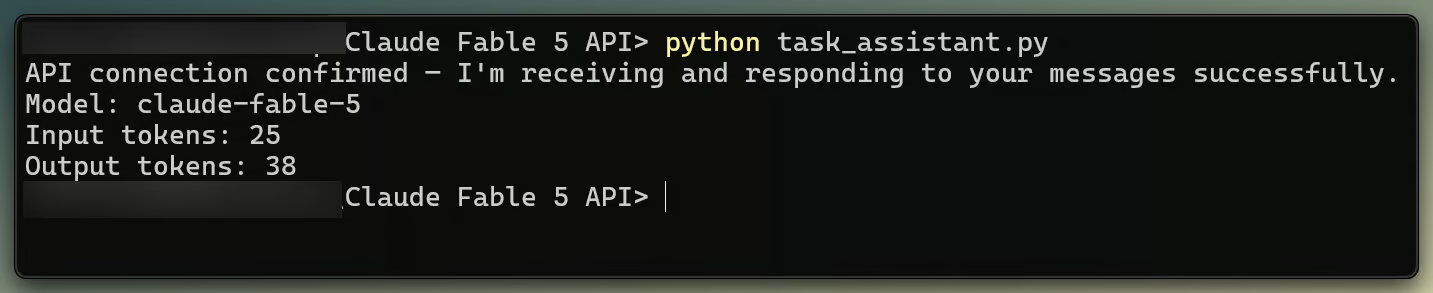
Risposta API Fable 5 e token. Immagine dell’autore.
response.content è un elenco di blocchi di contenuto, non una semplice stringa. A causa del comportamento di adaptive thinking menzionato sopra, il primo blocco è spesso un blocco di pensiero, e content[0].text può sollevare un AttributeError. L’helper get_text filtra invece per block.type == "text".
L’oggetto usage ti fornisce i conteggi dei token in input e output dopo ogni richiesta. response.model riporta quale modello ha risposto, informazione utile quando sono configurati fallback.
Il parametro effort passato dentro output_config è il controllo per quella profondità di ragionamento.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": feature_request}]
)
Il valore predefinito è "high". Partirei da lì, poi userei "low" o "medium" quando la latenza conta di più e "xhigh" o "max" per problemi più lunghi. Effort cambia quanti token di pensiero il modello genera, non se li genera.
Il parametro system è un campo di primo livello nella richiesta, separato dall’array messages . Qualunque cosa inserisci lì si applica a ogni turno, quindi fa più lavoro per parola di qualsiasi istruzione in un singolo turno.
Per il Developer Task Assistant, tengo il system prompt ristretto: restituisci un piano di ingegneria conciso invece di un’analisi ampia.
SYSTEM_PROMPT = """You are a senior software engineer who reviews feature requests and returns
implementation plans. For every request:
- Write a one sentence technical summary
- List the implementation steps in order
- Name the files or components most likely to change
- Call out at most three risks or edge cases
- Suggest concrete tests
Do not narrate options you won't pursue. Act on what you know; ask only when key details are missing."""
L’ultima istruzione è importante. Fable 5 può aggiungere troppa pianificazione per richieste semplici, quindi il prompt limita l’output prima che la risposta deragli.
Passa il system prompt insieme a ogni chiamata.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature_request}]
)
Il prefilling del turno dell’assistente non è supportato su Fable 5. Se hai codice Claude più vecchio che avvia il turno dell’assistente con {"role": "assistant", "content": "{"} per forzare l’output JSON, rimuovilo. Questo pattern restituisce un 400 su Fable 5, una trappola comune quando si porta codice più vecchio.
Pianificare una funzionalità significa tenere traccia di architettura, modalità di guasto e strategia di test in un’unica risposta. È un buon primo workflow perché è abbastanza piccolo da ispezionare, ma non è un prompt giocattolo.
feature = (
    "Add password reset to our Django app. "
    "Users should receive a token via email and land on a form to set a new password."
)

response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)

print(get_text(response))
Una risposta tipica copre in un unico passaggio generazione del token, invio dell’email, gestione del form e scadenza/cleanup.
Il testo semplice va bene in terminale. Quando il piano deve diventare dati dell’app, l’output strutturato è più facile da gestire. L’API di Claude supporta output strutturati tramite client.messages.parse() e un modello Pydantic, e funziona con claude-fable-5.
Definisci la forma dell’output atteso come modello Pydantic.
from pydantic import BaseModel

class FeaturePlan(BaseModel):
    summary: str
    steps: list[str]
    files: list[str]
    risks: list[str]
    tests: list[str]
Passa la classe come output_format. L’SDK la trasforma in uno schema JSON, esegue il decoding vincolato sui server di Anthropic e restituisce un oggetto tipizzato in response.parsed_output.
response = client.messages.parse(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}],
    output_format=FeaturePlan
)

plan = response.parsed_output
if plan is not None:
    print(f"Summary: {plan.summary}")
    print(f"Steps: {plan.steps}")
Controlla parsed_output per None prima di usarlo. Un rifiuto durante lo streaming o un taglio anticipato per max_tokens può lasciarlo vuoto. Questo percorso evita anche il problema dei blocchi di pensiero perché leggi parsed_output invece di entrare in content.
Se ti serve un output strutturato su un modello che non lo supporta via API, chiedi JSON nel prompt e validalo con FeaturePlan.model_validate_json(text), ritentando una volta in caso di fallimento. Non abbinare output strutturato al prefilling del turno dell’assistente; Fable 5 restituisce un 400 per quel pattern.
Lo stesso comportamento di adaptive thinking può aumentare l’attesa prima del primo token su prompt complessi. Lo streaming stampa i chunk di testo man mano che arrivano.
Usa il context manager client.messages.stream() . stream.text_stream restituisce chunk di testo e salta automaticamente i blocchi di pensiero.
with client.messages.stream(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
) as stream:
    for chunk in stream.text_stream:
        print(chunk, end="", flush=True)

final = stream.get_final_message()
print(f"\nInput tokens: {final.usage.input_tokens}")
print(f"Output tokens: {final.usage.output_tokens}")
Chiama get_final_message() dopo che il blocco with si è chiuso, non al suo interno. È lì che si trovano la stop reason e i conteggi di utilizzo.
Streaming e output strutturato possono coesistere, ma accumula l’intera risposta prima di farne il parsing. Un JSON parziale non è un JSON valido.
L’uso di tool consente al modello di richiedere informazioni invece di basarsi solo sul prompt. Tengo il primo tool piccolo: read_project_file. Il modello chiede di leggere un file, il tuo codice lo legge e il modello usa ciò che trova.
Il loop dei tool ha una forma fissa. Claude restituisce stop_reason: "tool_use" quando vuole chiamare un tool, tu esegui il tool e invii indietro un blocco tool_result, e il loop continua finché stop_reason non è "end_turn" o "refusal".
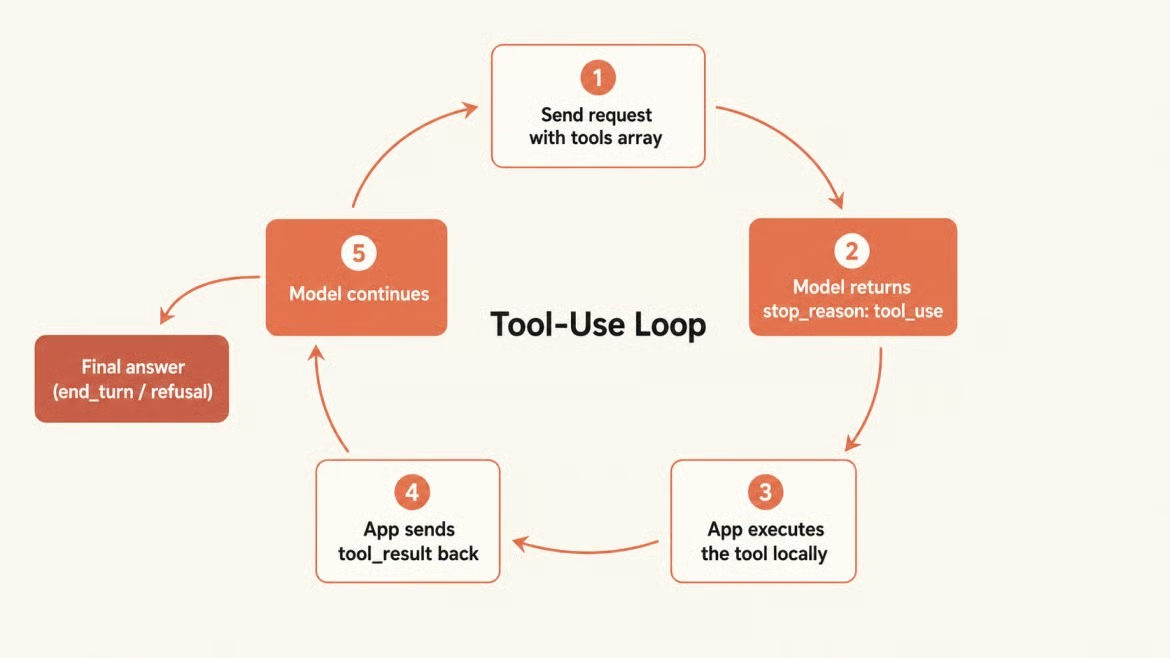
Loop dei tool dalla richiesta alla risposta. Immagine dell’autore.
READ_FILE_TOOL = {
    "name": "read_project_file",
    "description": "Read the contents of a file in the project.",
    "input_schema": {
        "type": "object",
        "properties": {
            "path": {"type": "string", "description": "Relative path to the file"}
        },
        "required": ["path"]
    }
}

messages = [{"role": "user", "content": feature}]

while True:
    response = client.messages.create(
        model=MODEL,
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        tools=[READ_FILE_TOOL],
        messages=messages
    )

    if response.stop_reason in ("end_turn", "refusal"):
        break

    if response.stop_reason == "tool_use":
        tool_block = next(b for b in response.content if b.type == "tool_use")

        # Execute the tool locally
        try:
            with open(tool_block.input["path"]) as f:
                result = f.read()[:2000]
        except FileNotFoundError:
            result = f"File not found: {tool_block.input['path']}"

        messages.append({"role": "assistant", "content": response.content})
        messages.append({
            "role": "user",
            "content": [{
                "type": "tool_result",
                "tool_use_id": tool_block.id,
                "content": result
            }]
        })

# Read the final answer
text_block = next((b for b in response.content if b.type == "text"), None)
print(text_block.text if text_block else "No text in final response")
Il modello non esegue mai questo codice. Emette una richiesta strutturata con un nome di tool e input JSON; la tua applicazione esegue la lettura del file. Non aggiungere testo conversazionale nello stesso turno utente di un blocco tool_result , altrimenti il modello potrebbe fermarsi invece di continuare il piano.
Prima di trasformarlo in un’app, verifica l’andamento dei costi. Fable 5 costa $10 per milione di token in input e $50 per milione di token in output. L’output è di solito la voce più grande: un piano da 2.000 token costa $0,10 solo di output.
Ecco la tabella prezzi per la famiglia Anthropic.
|
Modello |
Input (per MTok) |
Output (per MTok) |
Note |
|
Haiku 4.5 |
$1 |
$5 |
Il più veloce, qualità vicino al frontier |
|
Sonnet 4.6 |
$3 |
$15 |
Ottimo equilibrio tra velocità e profondità |
|
Opus 4.8 |
$5 |
$25 |
Top tier Opus |
|
Fable 5 |
$10 |
$50 |
Il modello più capace ampiamente rilasciato |
La cache del prompt può ridurre il costo del system prompt ripetuto. Una volta che il blocco di system prompt è in cache, le letture ripetute costano $1 per milione di token invece di $10. Il blocco minimo cacheable è 512 token sulla Claude API.
# Count tokens before sending an expensive request
count = client.messages.count_tokens(
    model=MODEL,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)
print(f"Estimated input tokens: {count.input_tokens}")

# Calculate actual cost after each request
INPUT_PRICE = 10.0 / 1_000_000
OUTPUT_PRICE = 50.0 / 1_000_000

response = client.messages.create(...)
cost = (
    response.usage.input_tokens * INPUT_PRICE +
    response.usage.output_tokens * OUTPUT_PRICE
)
print(f"Total cost: ${cost:.6f}")
count_tokens non costa denaro e non incide sul tuo rate limit di output. Usalo per bloccare richieste costose. Per job che non richiedono interazione, la Batch API dimezza i prezzi di input e output.
Fable 5 usa il tokenizer introdotto con Opus 4.7, che può produrre circa il 30% di token in più sullo stesso testo rispetto ai modelli Claude più vecchi. Tienine conto nelle migrazioni da Claude 4.6.
Fable 5 esegue classificatori di sicurezza in parallelo alla generazione. Quando uno si attiva, l’API restituisce un HTTP 200 di successo, non un errore, e l’unico segnale è stop_reason: "refusal". Una gestione degli errori che cattura solo eccezioni si perderà completamente i rifiuti, e la tua app restituirà silenziosamente il nulla.
Controlla sempre la stop reason.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}]
)

if response.stop_reason == "refusal":
    category = (
        response.stop_details.category
        if response.stop_details else "policy"
    )
    print(f"Request declined ({category}). Please rephrase and try again.")
else:
    print(get_text(response))
Nei miei test, Fable 5 spesso rifiutava richieste al limite in testo semplice, restituendo un normale end_turn. Il rifiuto da classificatore “hard”, con stop_reason: "refusal" e content vuoto, è più raro. Il controllo sopra gestisce quel percorso così la tua app non restituisce silenziosamente il nulla.
stop_details.category può essere "cyber", "bio", o "reasoning_extraction". L’ultima scatta quando un prompt prova a estrarre la catena di pensiero interna del modello. Per strumenti per sviluppatori che ispezionano scanner di sicurezza di rete o pipeline di dati biologici, potresti incorrere in falsi positivi del classificatore. Riformulare in modo da rendere chiaramente difensivo il compito spesso risolve.
Per sistemi in produzione, puoi configurare un fallback automatico a Opus 4.8 con la beta fallbacks che gira sul server nella Claude API e su Claude Platform su AWS. Non è la stessa cosa di Amazon Bedrock: Bedrock, Vertex AI e Foundry richiedono la logica di fallback nella tua applicazione.
response = client.beta.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}],
    fallbacks=[{"model": "claude-opus-4-8"}],
    betas=["server-side-fallback-2026-06-01"]
)
Una richiesta rifiutata che non genera output non viene fatturata. Un rifiuto a metà streaming fattura quanto generato prima dell’attivazione del classificatore.
Se la tua app gestisce solo testo, puoi saltare questa sezione. Questa parte è separata dal flusso di pianificazione, ma usa la stessa forma della Messages API. Fable 5 accetta input immagine come blocchi codificati base64 o URL. Un caso d’uso è la revisione di screenshot UI rispetto a un requisito di funzionalità.
import base64

with open("login_form.png", "rb") as f:
    img_data = base64.standard_b64encode(f.read()).decode("utf-8")

response = client.messages.create(
    model=MODEL,
    max_tokens=1024,
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "image",
                "source": {
                    "type": "base64",
                    "media_type": "image/png",
                    "data": img_data
                }
            },
            {
                "type": "text",
                "text": "Review this UI against the requirement: add a 'Forgot password' link below the login button. Is it present? If not, describe what needs to change."
            }
        ]
    }]
)
print(get_text(response))
Un’immagine a piena dimensione costa all’incirca 4.784 token di input indipendentemente da ciò che mostra, quindi ridimensionala o comprimila prima di inviare se non ti serve la piena risoluzione. Fable 5 elabora immagini fino a 2.576 px di larghezza e riduce qualsiasi cosa più grande. I formati supportati sono JPEG, PNG, GIF e WebP.
A questo punto, lo script locale ha l’intero workflow. Incapsula l’assistente in una route FastAPI così un frontend o un servizio può chiamarlo. Usa AsyncAnthropic dentro route async, perché il client sincrono blocca l’event loop. Inizializzalo una volta all’avvio, non per richiesta.
from contextlib import asynccontextmanager
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from anthropic import AsyncAnthropic

client_instance: AsyncAnthropic | None = None

@asynccontextmanager
async def lifespan(app: FastAPI):
    global client_instance
    client_instance = AsyncAnthropic()
    yield
    await client_instance.close()

app = FastAPI(lifespan=lifespan)

class PlanRequest(BaseModel):
    feature_request: str

@app.post("/plan")
async def create_plan(body: PlanRequest):
    response = await client_instance.messages.create(
        model="claude-fable-5",
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        messages=[{"role": "user", "content": body.feature_request}]
    )

    if response.stop_reason == "refusal":
        raise HTTPException(status_code=400, detail="Request declined by safety classifier.")

    return {
        "plan": get_text(response),
        "input_tokens": response.usage.input_tokens,
        "output_tokens": response.usage.output_tokens
    }
Eseguilo con uvicorn app:app --reload e testa l’endpoint /plan tramite la documentazione FastAPI su http://localhost:8000/docs.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



