Curso
Claude Code 101
3 h
26.7K
Atualização (1º de julho de 2026): O acesso ao Claude Fable 5 foi restaurado e agora está disponível globalmente no Claude Platform, Claude.ai, Claude Code e Claude Cowork após a suspensão da ordem de controle de exportação. Mythos 5 permanece limitado a parceiros aprovados do Project Glasswing.
Atualização (2 de setembro de 2026): A Anthropic publicou o modelo sucessor do Fable 5. Recomendo ler nosso guia do Claude Fable 5.1 com todos os detalhes.
Quando testo um novo modelo via API, me importo menos com as notas de lançamento e mais com o que preciso ligar no código: como é a chamada de API, o que mudou em relação ao modelo anterior, quanto vai custar e o que acontece quando a camada de segurança diz não?
Nosso artigo de visão geral do Claude Fable 5 cobriu o lançamento, os benchmarks e a configuração de segurança que torna o Fable 5 único. O código abaixo parte daí. Vamos usar um Developer Task Assistant que recebe um pedido de funcionalidade de software e retorna um plano de implementação estruturado; depois, adicionamos streaming, uso de ferramentas, rastreamento de custo e um endpoint FastAPI.
Vamos passar por:
Claude Fable 5 é um modelo da Anthropic lançado em 9 de junho de 2026, com o identificador de modelo na API claude-fable-5. A Anthropic o descreve como o mesmo modelo base do Claude Mythos 5, mas com classificadores de segurança aplicados para disponibilidade geral. O Mythos 5 segue restrito ao Project Glasswing, um programa limitado a organizações de segurança confiáveis.
Para desenvolvedores, os detalhes relevantes da API são:
Janela de contexto de 1M tokens e até 128k tokens de saída por requisição
Preço de US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de tokens de saída, o dobro do Opus 4.8
Raciocínio adaptativo sempre ativo. Você não pode desativá-lo. O parâmetro effort controla a profundidade; o raciocínio interno do modelo é gerado e cobrado independentemente de você exibi-lo ou não
É um "Covered Model", ou seja, a retenção de dados por 30 dias é obrigatória. Zero Data Retention não está disponível para este modelo.
Eu não usaria para toda chamada de API. Faz mais sentido para tarefas que exigem raciocínio sobre arquitetura, casos de borda e detalhes de implementação. Para trabalhos mais simples, Sonnet 4.6 ou Haiku 4.5 provavelmente dão conta.
O assistente que vamos criar recebe um pedido de funcionalidade de software e retorna um plano estruturado: um resumo técnico, etapas de implementação em ordem, arquivos prováveis a modificar, riscos e testes.
Uso este exemplo porque ele força os detalhes de API que importam numa integração real: output estruturado, streaming, chamadas de ferramentas, custo e tratamento de recusas. É pequeno, mas não é só um Hello World.
As seções abaixo montam essas peças, uma de cada vez.
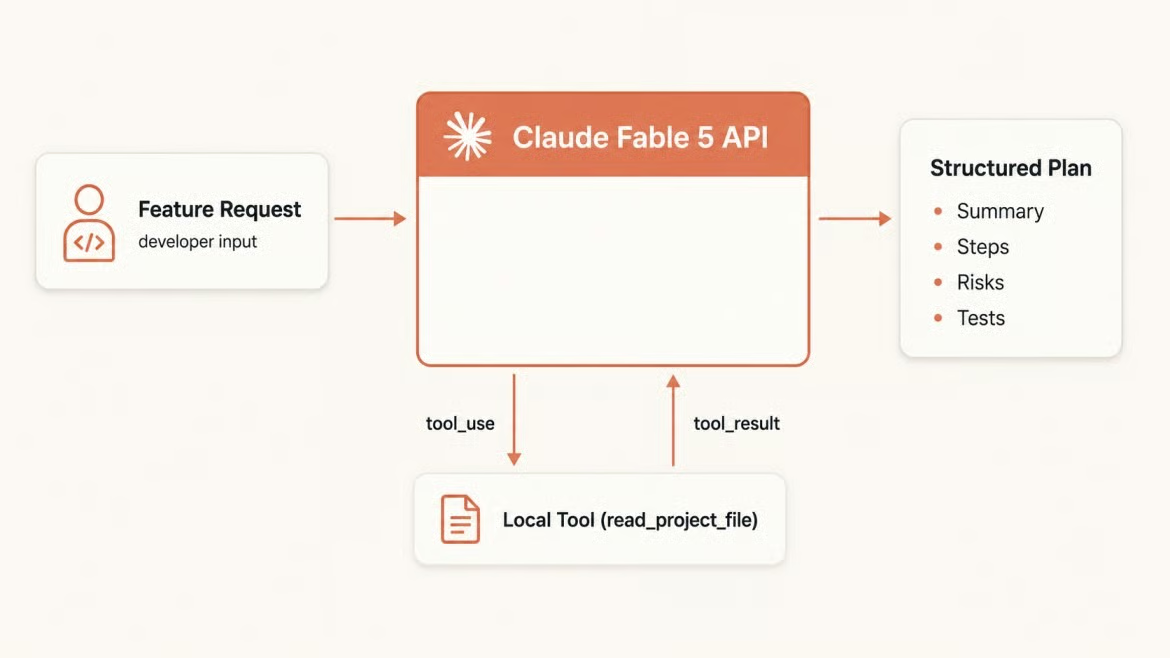
Pedido de feature vira plano estruturado. Imagem do autor.
O código principal fica em task_assistant.py para o script local e app.py para o endpoint FastAPI.
Para acompanhar, você vai precisar de:
Python 3.9 ou mais recente (o tutorial usa recursos do 3.10+, como type hints nativos em modelos Pydantic, mas o SDK em si suporta 3.9+)
Uma chave de API da Anthropic com acesso ao claude-fable-5
Noções básicas de variáveis de ambiente, JSON e HTTP APIs
Um terminal e um editor de código
Comece criando uma pasta de projeto e um ambiente virtual.
mkdir task-assistant
cd task-assistant
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
Instale o SDK da Anthropic, o FastAPI e alguns utilitários.
pip install anthropic fastapi uvicorn python-dotenv pydanticCrie um arquivo .env na raiz do projeto com sua chave de API. Nunca faça commit desse arquivo no controle de versão.
ANTHROPIC_API_KEY=sk-ant-...Carregue-o no topo do seu script. Anthropic() lê ANTHROPIC_API_KEY do ambiente automaticamente.
from dotenv import load_dotenv
from anthropic import Anthropic

load_dotenv()
client = Anthropic()
Inicialize o cliente uma vez no nível do módulo e reutilize-o ao longo do tutorial.
Antes de adicionar a lógica do projeto, gosto de enviar uma requisição mínima para confirmar que está tudo funcionando. A Messages API recebe a string do modelo, um limite de max_tokens e um array de mensagens. max_tokens é obrigatório; o SDK lança TypeError se você omitir.
MODEL = "claude-fable-5"

def get_text(response):
    """Return the first text block, skipping thinking or tool blocks."""
    return next((b.text for b in response.content if b.type == "text"), "")

response = client.messages.create(
    model=MODEL,
    max_tokens=512,
    messages=[{"role": "user", "content": "Reply in one sentence to confirm the API connection is working."}]
)

print(get_text(response))
print(f"Model: {response.model}")
print(f"Input tokens: {response.usage.input_tokens}")
print(f"Output tokens: {response.usage.output_tokens}")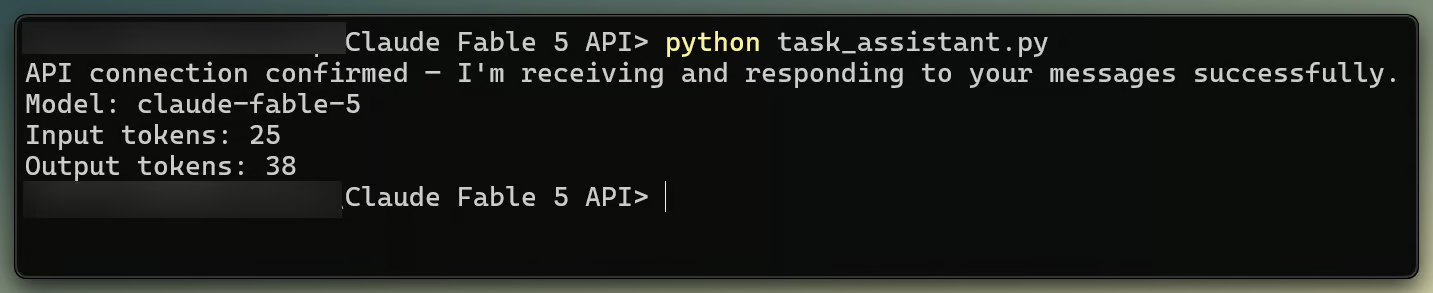
Resposta do Fable 5 e tokens. Imagem do autor.
response.content é uma lista de blocos de conteúdo, não uma string simples. Por conta do raciocínio adaptativo mencionado acima, o primeiro bloco costuma ser de "pensamento", e content[0].text pode gerar AttributeError. O helper get_text filtra por block.type == "text".
O objeto usage traz as contagens de tokens de entrada e saída após cada requisição. response.model informa qual modelo respondeu, o que importa quando há fallbacks configurados.
O parâmetro effort passado em output_config é o controle dessa profundidade de raciocínio.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": feature_request}]
)
O padrão é "high". Eu começaria por aí, depois usaria "low" ou "medium" quando latência pesar mais e "xhigh" ou "max" para problemas mais longos. Effort muda quantos tokens de pensamento o modelo gera, não se ele os gera.
O parâmetro system é um campo de nível superior na requisição, separado do array de messages . O que você coloca ali vale para todos os turnos, então cada palavra rende mais do que instruções em um turno específico.
Para o Developer Task Assistant, mantenho o prompt de sistema enxuto: devolver um plano de engenharia conciso em vez de uma análise ampla.
SYSTEM_PROMPT = """You are a senior software engineer who reviews feature requests and returns
implementation plans. For every request:
- Write a one sentence technical summary
- List the implementation steps in order
- Name the files or components most likely to change
- Call out at most three risks or edge cases
- Suggest concrete tests
Do not narrate options you won't pursue. Act on what you know; ask only when key details are missing."""
Essa última instrução importa. O Fable 5 pode planejar demais em pedidos simples, então o prompt limita o output antes que a resposta desvie.
Passe o prompt de sistema em todas as chamadas.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature_request}]
)
Pré-preenchimento do turno do assistente não é suportado no Fable 5. Se você tem código antigo do Claude que inicia o turno do assistente com {"role": "assistant", "content": "{"} para forçar JSON, remova isso. Esse padrão retorna 400 no Fable 5, uma armadilha comum ao portar código antigo.
Planejar uma feature significa acompanhar arquitetura, modos de falha e estratégia de testes numa única resposta. É um bom primeiro fluxo porque é pequeno o bastante para inspecionar, mas não é um prompt de brinquedo.
feature = (
    "Add password reset to our Django app. "
    "Users should receive a token via email and land on a form to set a new password."
)

response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)

print(get_text(response))
Uma resposta típica cobre geração de token, envio de e-mail, tratamento do formulário e limpeza de expiração numa passada só.
Texto puro serve no terminal. Quando o plano precisa virar dado de app, output estruturado é mais fácil de trabalhar. A Claude API dá suporte a outputs estruturados via client.messages.parse() e um modelo Pydantic, e funciona com claude-fable-5.
Defina o formato esperado como um modelo Pydantic.
from pydantic import BaseModel

class FeaturePlan(BaseModel):
    summary: str
    steps: list[str]
    files: list[str]
    risks: list[str]
    tests: list[str]
Passe a classe em output_format. O SDK transforma em um schema JSON, roda decodificação restrita nos servidores da Anthropic e retorna um objeto tipado em response.parsed_output.
response = client.messages.parse(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}],
    output_format=FeaturePlan
)

plan = response.parsed_output
if plan is not None:
    print(f"Summary: {plan.summary}")
    print(f"Steps: {plan.steps}")
Verifique parsed_output contra None antes de usar. Uma recusa durante o streaming ou corte antecipado por max_tokens pode deixá-lo vazio. Esse caminho também evita o problema do bloco de pensamento, pois você lê parsed_output em vez de acessar content.
Se você precisar de output estruturado em um modelo sem suporte na API, peça JSON no prompt e valide com FeaturePlan.model_validate_json(text), tentando novamente uma vez se falhar. Não combine output estruturado com pré-preenchimento de turno do assistente; o Fable 5 retorna 400 com esse padrão.
Esse mesmo raciocínio adaptativo pode aumentar a espera até o primeiro token em prompts complexos. Streaming imprime trechos de texto conforme chegam.
Use o gerenciador de contexto client.messages.stream(). stream.text_stream gera trechos de texto e ignora automaticamente blocos de pensamento.
with client.messages.stream(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
) as stream:
    for chunk in stream.text_stream:
        print(chunk, end="", flush=True)

final = stream.get_final_message()
print(f"\nInput tokens: {final.usage.input_tokens}")
print(f"Output tokens: {final.usage.output_tokens}")
Chame get_final_message() depois do bloco with fechar, não dentro. É lá que ficam o motivo de parada e as contagens de uso.
Streaming e output estruturado podem coexistir, mas acumule a resposta completa antes de fazer o parse. JSON parcial não é JSON válido.
Uso de ferramentas permite que o modelo solicite informações em vez de depender só do prompt. Começo com uma ferramenta pequena: read_project_file. O modelo pede para ler um arquivo, seu código lê, e o modelo usa o que encontrar.
O loop de ferramentas tem um formato fixo. O Claude retorna stop_reason: "tool_use" quando quer chamar uma ferramenta, você a executa e envia de volta um bloco tool_result, e o loop continua até stop_reason ser "end_turn" ou "refusal".
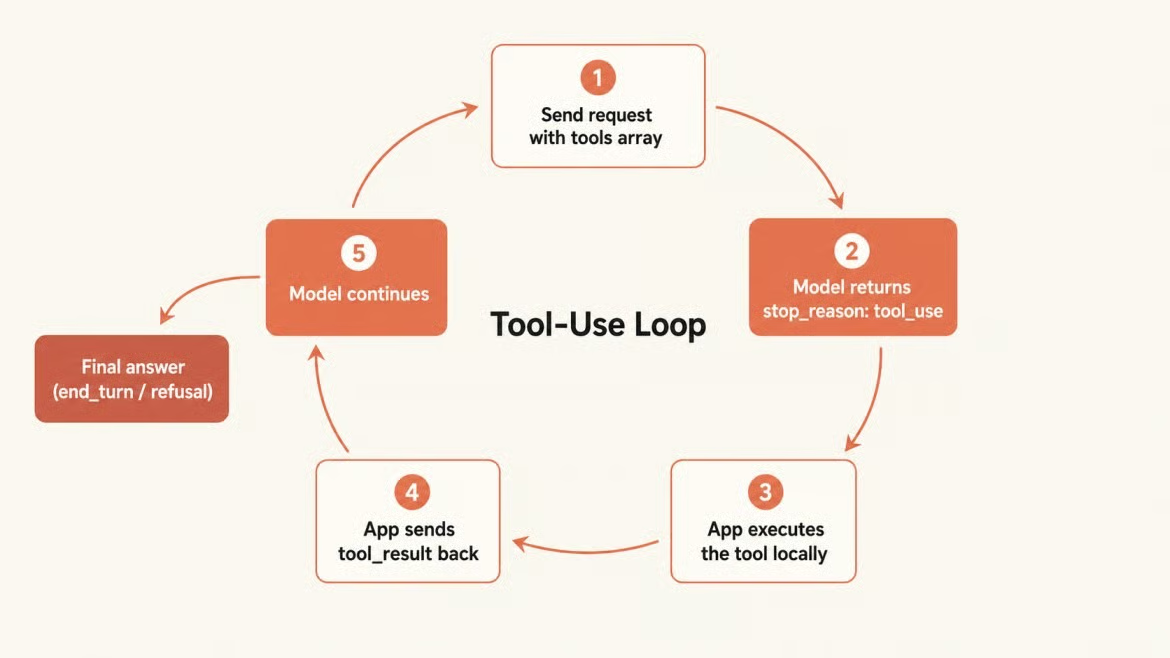
Loop de ferramentas do pedido à resposta. Imagem do autor.
READ_FILE_TOOL = {
    "name": "read_project_file",
    "description": "Read the contents of a file in the project.",
    "input_schema": {
        "type": "object",
        "properties": {
            "path": {"type": "string", "description": "Relative path to the file"}
        },
        "required": ["path"]
    }
}

messages = [{"role": "user", "content": feature}]

while True:
    response = client.messages.create(
        model=MODEL,
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        tools=[READ_FILE_TOOL],
        messages=messages
    )

    if response.stop_reason in ("end_turn", "refusal"):
        break

    if response.stop_reason == "tool_use":
        tool_block = next(b for b in response.content if b.type == "tool_use")

        # Execute the tool locally
        try:
            with open(tool_block.input["path"]) as f:
                result = f.read()[:2000]
        except FileNotFoundError:
            result = f"File not found: {tool_block.input['path']}"

        messages.append({"role": "assistant", "content": response.content})
        messages.append({
            "role": "user",
            "content": [{
                "type": "tool_result",
                "tool_use_id": tool_block.id,
                "content": result
            }]
        })

# Read the final answer
text_block = next((b for b in response.content if b.type == "text"), None)
print(text_block.text if text_block else "No text in final response")
O modelo nunca executa esse código. Ele emite um pedido estruturado com o nome da ferramenta e entradas JSON; sua aplicação faz a leitura do arquivo. Não anexe texto conversacional no mesmo turno do usuário que contém um bloco tool_result, ou o modelo pode parar em vez de continuar o plano.
Antes de transformar isso em app, confira o formato de custo. O Fable 5 custa US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de tokens de saída. Saída costuma ser o maior item: um plano de 2.000 tokens custa US$ 0,10 só de output.
Aqui está a tabela de preços na família Anthropic.
|
Modelo |
Entrada (por MTok) |
Saída (por MTok) |
Observações |
|
Haiku 4.5 |
US$ 1 |
US$ 5 |
Mais rápido, qualidade próxima à fronteira |
|
Sonnet 4.6 |
US$ 3 |
US$ 15 |
Bom equilíbrio entre velocidade e profundidade |
|
Opus 4.8 |
US$ 5 |
US$ 25 |
Camada superior do Opus |
|
Fable 5 |
US$ 10 |
US$ 50 |
Modelo mais capaz amplamente lançado |
O cache de prompts pode reduzir o custo repetido do prompt de sistema. Uma vez em cache, leituras repetidas custam US$ 1 por milhão de tokens em vez de US$ 10. O bloco mínimo em cache é 512 tokens na Claude API.
# Count tokens before sending an expensive request
count = client.messages.count_tokens(
    model=MODEL,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)
print(f"Estimated input tokens: {count.input_tokens}")

# Calculate actual cost after each request
INPUT_PRICE = 10.0 / 1_000_000
OUTPUT_PRICE = 50.0 / 1_000_000

response = client.messages.create(...)
cost = (
    response.usage.input_tokens * INPUT_PRICE +
    response.usage.output_tokens * OUTPUT_PRICE
)
print(f"Total cost: ${cost:.6f}")
count_tokens não custa dinheiro e não conta no seu limite de taxa de saída. Use para barrar requisições caras. Para jobs que não precisam de interação, a Batch API reduz pela metade os preços de entrada e saída.
O Fable 5 usa o tokenizador introduzido no Opus 4.7, que pode gerar cerca de 30% mais tokens no mesmo texto do que modelos Claude mais antigos. Considere isso ao migrar do Claude 4.6.
O Fable 5 roda classificadores de segurança junto com a geração. Quando um é acionado, a API retorna HTTP 200 (sucesso), não erro, e o único sinal é stop_reason: "refusal". Tratamento de erro que só captura exceções vai perder recusas e seu app pode retornar nada em silêncio.
Sempre verifique o motivo de parada.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}]
)

if response.stop_reason == "refusal":
    category = (
        response.stop_details.category
        if response.stop_details else "policy"
    )
    print(f"Request declined ({category}). Please rephrase and try again.")
else:
    print(get_text(response))
Nos meus testes, o Fable 5 frequentemente recusou pedidos de fronteira em texto normal, retornando um end_turn comum. A recusa dura do classificador, com stop_reason: "refusal" e content vazio, é mais rara. A checagem acima trata esse caminho para o app não retornar vazio em silêncio.
stop_details.category pode ser "cyber", "bio" ou "reasoning_extraction". A última dispara quando um prompt tenta extrair a cadeia de raciocínio interna do modelo. Em ferramentas de desenvolvedor que inspecionam scanners de segurança de rede ou pipelines de dados biológicos, você pode ter falsos positivos. Reformular deixando claro o caráter defensivo costuma resolver.
Para sistemas em produção, você pode configurar fallback automático para Opus 4.8 com o beta fallbacks que roda no servidor na Claude API e no Claude Platform na AWS. Não é o mesmo que Amazon Bedrock: Bedrock, Vertex AI e Foundry precisam de lógica de fallback na sua aplicação.
response = client.beta.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}],
    fallbacks=[{"model": "claude-opus-4-8"}],
    betas=["server-side-fallback-2026-06-01"]
)
Uma requisição recusada que não gera output não é cobrada. Uma recusa no meio do streaming cobra o que já foi gerado antes do classificador disparar.
Se seu app só lida com texto, pode pular esta parte. Esta seção é separada do fluxo de planejamento, mas usa o mesmo formato da Messages API. O Fable 5 aceita imagens como blocos base64 ou URLs. Um caso comum é revisar um print de UI frente a um requisito.
import base64

with open("login_form.png", "rb") as f:
    img_data = base64.standard_b64encode(f.read()).decode("utf-8")

response = client.messages.create(
    model=MODEL,
    max_tokens=1024,
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "image",
                "source": {
                    "type": "base64",
                    "media_type": "image/png",
                    "data": img_data
                }
            },
            {
                "type": "text",
                "text": "Review this UI against the requirement: add a 'Forgot password' link below the login button. Is it present? If not, describe what needs to change."
            }
        ]
    }]
)
print(get_text(response))
Uma imagem em tamanho cheio custa cerca de 4.784 tokens de entrada independentemente do conteúdo, então redimensione ou comprima antes de enviar se não precisar de alta resolução. O Fable 5 processa imagens de até 2.576 px de largura e reduz qualquer coisa maior. Formatos suportados: JPEG, PNG, GIF e WebP.
Neste ponto, o script local tem o fluxo completo. Envolva o assistente numa rota FastAPI para que um frontend ou serviço possa chamá-lo. Use AsyncAnthropic em rotas assíncronas, já que o cliente síncrono bloqueia o event loop. Inicialize-o uma vez na inicialização, não por requisição.
from contextlib import asynccontextmanager
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from anthropic import AsyncAnthropic

client_instance: AsyncAnthropic | None = None

@asynccontextmanager
async def lifespan(app: FastAPI):
    global client_instance
    client_instance = AsyncAnthropic()
    yield
    await client_instance.close()

app = FastAPI(lifespan=lifespan)

class PlanRequest(BaseModel):
    feature_request: str

@app.post("/plan")
async def create_plan(body: PlanRequest):
    response = await client_instance.messages.create(
        model="claude-fable-5",
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        messages=[{"role": "user", "content": body.feature_request}]
    )

    if response.stop_reason == "refusal":
        raise HTTPException(status_code=400, detail="Request declined by safety classifier.")

    return {
        "plan": get_text(response),
        "input_tokens": response.usage.input_tokens,
        "output_tokens": response.usage.output_tokens
    }
Rode com uvicorn app:app --reload e teste o endpoint /plan pela documentação do FastAPI em http://localhost:8000/docs.
Aprenda com a DataCamp
Curso
Curso
Curso
Tutorial
Abid Ali Awan
Tutorial
Zoumana Keita
14 min
Tutorial
Abid Ali Awan
8 min
Tutorial
Moez Ali
13 min
Tutorial
Tutorial
Nadia mhadhbi
15 min