
课程
Claude Code 101
3 小时
27.7K
更新(2026 年 7 月 1 日):对 Claude Fable 5 的访问已恢复,现已在 Claude Platform、Claude.ai、Claude Code 和 Claude Cowork 全球开放,因出口管制令已解除。Mythos 5 仍仅限审核通过的 Project Glasswing 合作伙伴使用。
更新(2026 年 9 月 2 日): Anthropic 已发布 Fable 5 的后继模型。建议阅读我们的 Claude Fable 5.1 指南了解详情。
当我通过 API 测试一款新模型时,我更关心需要接到代码里的部分,而不是发布说明:API 调用长什么样、与上一代模型有何不同、成本多少、安全层拒绝时会发生什么?
我们的Claude Fable 5 概览文章介绍了发布情况、基准测试结果,以及让 Fable 5 与众不同的安全设置。下面的代码在此基础上展开。具体来说,我们将使用一个开发者任务助手,接受软件功能需求并返回结构化的实现计划,然后加入流式输出、工具使用、成本跟踪和 FastAPI 端点。
我们将依次完成:
Claude Fable 5 是 Anthropic 于 2026 年 6 月 9 日发布的模型,对应的 API 模型字符串为 claude-fable-5。Anthropic 将其描述为与 Claude Mythos 5 共享相同基础模型,但应用了安全分类器以便广泛发布。Mythos 5 仍限于 Project Glasswing,这是面向可信安全组织的受限计划。
对开发者而言,相关 API 细节包括:
100 万 Token 的上下文窗口,以及每次请求最多 128k 的输出 Token
价格为每百万输入 Token 10 美元、每百万输出 Token 50 美元,是 Opus 4.8 的两倍
自适应思考始终开启,无法禁用。effort 参数用于控制深度;无论您是否展示,模型的内部推理都会生成并计费
这是“受覆盖模型(Covered Model)”,意味着必须保留数据 30 天。该模型不支持零数据保留。
我不会把它用于所有 API 调用。它更适合需要在架构、边界情况与实现细节间进行推理的任务。对于更简单的工作,Sonnet 4.6 或 Haiku 4.5 很可能就够了。
我们要构建的助手接受一条软件功能需求并返回结构化计划:技术概要、按序实施步骤、可能修改的文件、风险与测试。
我选择这个示例,是因为它迫使我们处理真实集成中常见的 API 细节:结构化输出、流式传输、工具调用、成本与拒绝处理。示例虽小,但不只是 Hello World。
下面的章节将这些部件逐一搭建。
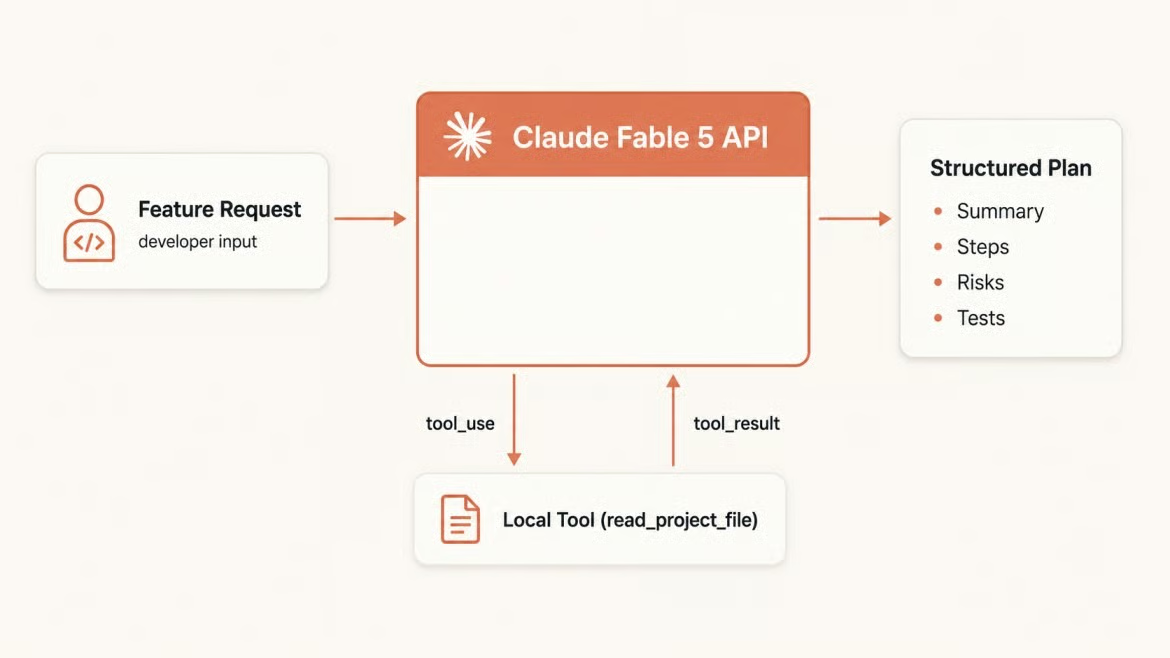
功能需求转为结构化计划。图片来源:作者。
主要代码位于本地脚本的 task_assistant.py 与 FastAPI 端点的 app.py。
要跟着做,您需要:
Python 3.9 或更高版本(本教程使用 3.10+ 的特性,如 Pydantic 模型中的内置类型标注,但 SDK 本身支持 3.9+)
具有 claude-fable-5 访问权限的 Anthropic API 密钥
对环境变量、JSON 和 HTTP API 的基础了解
一个终端和代码编辑器
先创建项目文件夹和虚拟环境。
mkdir task-assistant
cd task-assistant
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
安装 Anthropic SDK、FastAPI 和一些辅助库。
pip install anthropic fastapi uvicorn python-dotenv pydantic在项目根目录创建 .env 文件并写入您的 API 密钥。切勿将该文件提交到版本控制。
ANTHROPIC_API_KEY=sk-ant-...在脚本顶部加载它。Anthropic() 会自动从环境读取 ANTHROPIC_API_KEY。
from dotenv import load_dotenv
from anthropic import Anthropic

load_dotenv()
client = Anthropic()
在模块级初始化一次客户端,并在整个教程中复用。
在添加项目逻辑前,我喜欢先发送一个最小请求确认环境无误。Messages API 需要模型字符串、max_tokens 上限,以及一组 messages。max_tokens 是必填;若省略,SDK 会抛出 TypeError。
MODEL = "claude-fable-5"

def get_text(response):
    """Return the first text block, skipping thinking or tool blocks."""
    return next((b.text for b in response.content if b.type == "text"), "")

response = client.messages.create(
    model=MODEL,
    max_tokens=512,
    messages=[{"role": "user", "content": "Reply in one sentence to confirm the API connection is working."}]
)

print(get_text(response))
print(f"Model: {response.model}")
print(f"Input tokens: {response.usage.input_tokens}")
print(f"Output tokens: {response.usage.output_tokens}")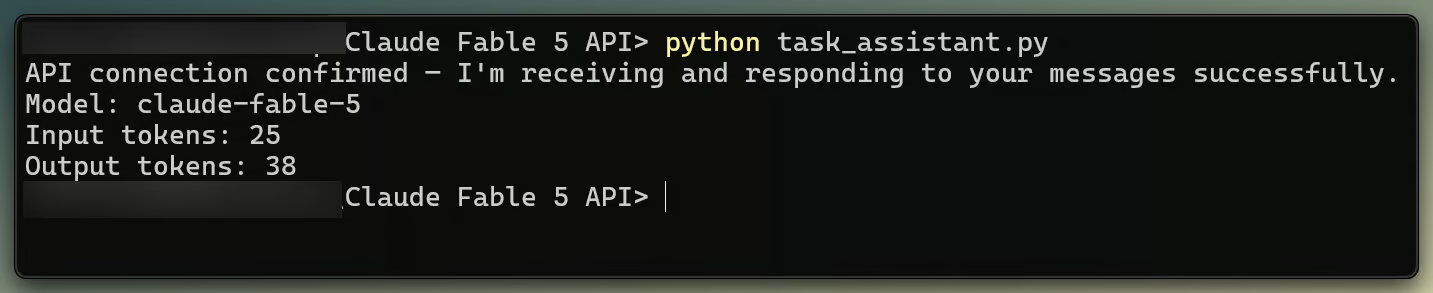
Fable 5 的 API 响应与 Token。图片来源:作者。
response.content 是内容块列表,而不是纯字符串。由于上文提到的自适应思考行为,首个块常常是思考块,直接访问 content[0].text 可能触发 AttributeError。get_text 助手函数改为按 block.type == "text" 过滤。
此外,usage 对象提供每次请求的输入与输出 Token 计数。 response.model 会报告实际响应的模型,这在配置了回退时尤为重要。
参数 effort 在 output_config 内传入,用于控制推理深度。
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": feature_request}]
)
默认值为 "high"。建议从此开始;当延迟更重要时用 "low" 或 "medium" ;而遇到更长的问题时用 "xhigh" 或 "max"。Effort 改变的是模型生成的思考 Token 数量,而不是是否生成。
参数 system 是请求的顶层字段,独立于 messages 数组。它适用于每一轮对话,因此每个字的作用都比单轮指令更大。
对开发者任务助手,我把 system 提示保持得很收敛:返回简明的工程计划,而非泛泛而谈的分析。
SYSTEM_PROMPT = """You are a senior software engineer who reviews feature requests and returns
implementation plans. For every request:
- Write a one sentence technical summary
- List the implementation steps in order
- Name the files or components most likely to change
- Call out at most three risks or edge cases
- Suggest concrete tests
Do not narrate options you won't pursue. Act on what you know; ask only when key details are missing."""
最后这条指令很重要。Fable 5 在简单需求上可能会过度规划,因此用提示先对输出设定边界,避免跑偏。
在每次调用时一并传入 system 提示。
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature_request}]
)
Fable 5 不支持预填充助手轮。如果您有较旧的 Claude 代码用 {"role": "assistant", "content": "{"} 开启助手轮以强制输出 JSON,请移除。该模式在 Fable 5 上会返回 400,这是移植旧代码时容易踩的坑。
规划一个功能意味着要在一次响应中兼顾架构、失效模式与测试策略。这是一个很好的入门工作流:足够小便于审查,但并非玩具级提示。
feature = (
    "Add password reset to our Django app. "
    "Users should receive a token via email and land on a form to set a new password."
)

response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)

print(get_text(response))
典型响应会在同一轮中覆盖 Token 生成、邮件发送、表单处理与过期清理。
纯文本在终端中尚可。一旦计划要落地成应用数据,结构化输出更易处理。Claude API 通过 client.messages.parse() 搭配 Pydantic 模型支持结构化输出,且可用于 claude-fable-5。
将期望的输出结构定义为 Pydantic 模型。
from pydantic import BaseModel

class FeaturePlan(BaseModel):
    summary: str
    steps: list[str]
    files: list[str]
    risks: list[str]
    tests: list[str]
将该类作为 output_format 传入。SDK 会将其转为 JSON 架构,在 Anthropic 服务器上进行受限解码,并在 response.parsed_output 返回类型化对象。
response = client.messages.parse(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}],
    output_format=FeaturePlan
)

plan = response.parsed_output
if plan is not None:
    print(f"Summary: {plan.summary}")
    print(f"Steps: {plan.steps}")
在使用前检查 parsed_output 是否为 None。在流式过程中发生拒绝或提前 max_tokens 截断都可能令其为空。此路径也可避免思考块的问题,因为您读取的是 parsed_output,而不是深入 content。
若您需要在不支持结构化输出的模型上实现类似能力,可在提示中要求返回 JSON,并用 FeaturePlan.model_validate_json(text) 校验,失败时重试一次。不要将结构化输出与助手轮预填充同时使用;Fable 5 会对此返回 400。
同样的自适应思考行为会在复杂提示上增加首 Token 等待时间。流式传输可在文本到达时立即打印分片。
使用 client.messages.stream() 上下文管理器。stream.text_stream 会产出文本分片并自动跳过思考块。
with client.messages.stream(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
) as stream:
    for chunk in stream.text_stream:
        print(chunk, end="", flush=True)

final = stream.get_final_message()
print(f"\nInput tokens: {final.usage.input_tokens}")
print(f"Output tokens: {final.usage.output_tokens}")
在 with 块结束后再调用 get_final_message()。停用原因与用量统计在此处提供。
流式与结构化输出可以共存,但需先累积完整响应再解析。部分 JSON 并非有效 JSON。
工具使用让模型可以请求信息,而不只依赖提示。我先从一个很小的工具开始: read_project_file。模型请求读取文件,您的代码执行读取,模型再利用结果。
工具循环有固定形状:当模型想调用工具时,会返回 stop_reason: "tool_use";您执行工具并返回一个 tool_result 块;循环继续,直到 stop_reason 为 "end_turn" 或 "refusal"。
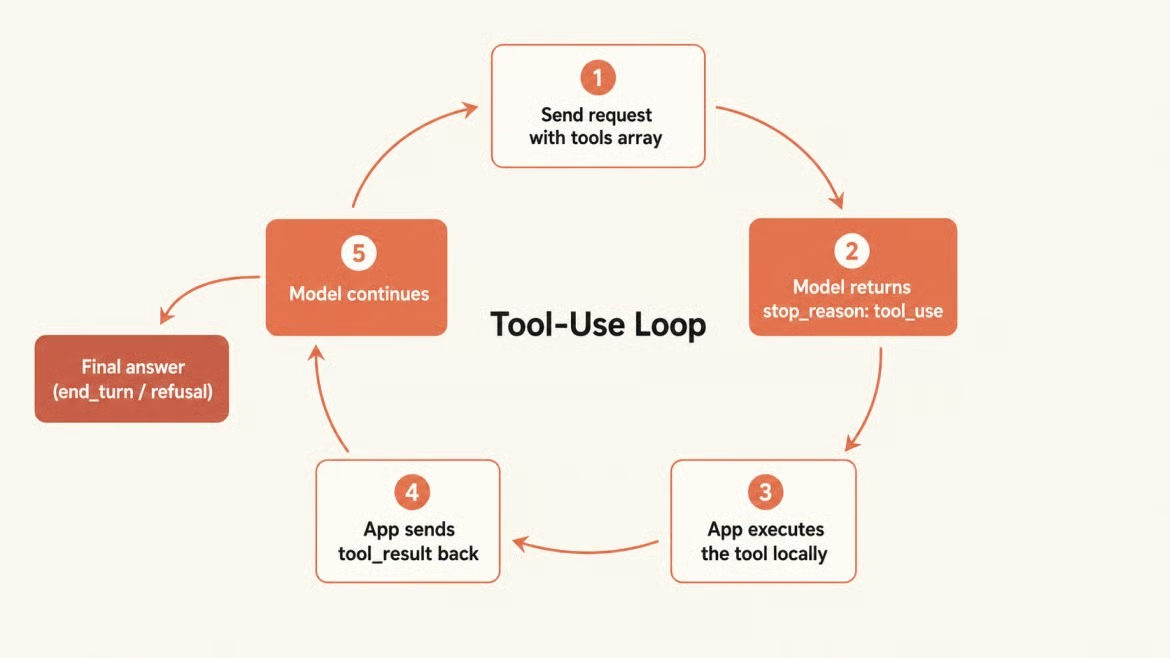
从请求到答案的工具循环。图片来源:作者。
READ_FILE_TOOL = {
    "name": "read_project_file",
    "description": "Read the contents of a file in the project.",
    "input_schema": {
        "type": "object",
        "properties": {
            "path": {"type": "string", "description": "Relative path to the file"}
        },
        "required": ["path"]
    }
}

messages = [{"role": "user", "content": feature}]

while True:
    response = client.messages.create(
        model=MODEL,
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        tools=[READ_FILE_TOOL],
        messages=messages
    )

    if response.stop_reason in ("end_turn", "refusal"):
        break

    if response.stop_reason == "tool_use":
        tool_block = next(b for b in response.content if b.type == "tool_use")

        # Execute the tool locally
        try:
            with open(tool_block.input["path"]) as f:
                result = f.read()[:2000]
        except FileNotFoundError:
            result = f"File not found: {tool_block.input['path']}"

        messages.append({"role": "assistant", "content": response.content})
        messages.append({
            "role": "user",
            "content": [{
                "type": "tool_result",
                "tool_use_id": tool_block.id,
                "content": result
            }]
        })

# Read the final answer
text_block = next((b for b in response.content if b.type == "text"), None)
print(text_block.text if text_block else "No text in final response")
模型不会执行这段代码。它会发出包含工具名称与 JSON 入参的结构化请求;您的应用负责读文件。不要在包含 tool_result 块的同一用户轮中追加对话文本,否则模型可能停止而不继续计划。
在将其做成应用之前,先看看成本结构。Fable 5 的价格为每百万输入 Token 10 美元、每百万输出 Token 50 美元。输出通常占大头:仅 2,000 Token 的计划,输出成本就有 0.10 美元。
下表是 Anthropic 家族的价格。
|
模型 |
输入(每百万 Token) |
输出(每百万 Token) |
备注 |
|
Haiku 4.5 |
$1 |
$5 |
最快,接近前沿质量 |
|
Sonnet 4.6 |
$3 |
$15 |
速度与深度的良好平衡 |
|
Opus 4.8 |
$5 |
$25 |
Opus 顶级档 |
|
Fable 5 |
$10 |
$50 |
最强大的广泛发布模型 |
提示缓存可以降低重复读取 system 提示的成本。一旦该块被缓存,重复读取的价格变为每百万 Token 1 美元而非 10 美元。Claude API 上可缓存的最小块为 512 Token。
# Count tokens before sending an expensive request
count = client.messages.count_tokens(
    model=MODEL,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)
print(f"Estimated input tokens: {count.input_tokens}")

# Calculate actual cost after each request
INPUT_PRICE = 10.0 / 1_000_000
OUTPUT_PRICE = 50.0 / 1_000_000

response = client.messages.create(...)
cost = (
    response.usage.input_tokens * INPUT_PRICE +
    response.usage.output_tokens * OUTPUT_PRICE
)
print(f"Total cost: ${cost:.6f}")
count_tokens 不收费,也不计入输出速率限制。用它来拦截高成本请求。对于无需交互的作业,Batch API 可将输入与输出价格各减半。
Fable 5 使用 Opus 4.7 引入的分词器,相比旧版 Claude 模型,在同样文本上大约会多出 30% 的 Token。将此因素纳入从 Claude 4.6 的迁移考量。
Fable 5 在生成过程中并行运行安全分类器。一旦触发,API 会返回成功的 HTTP 200,而不是错误;唯一的信号是 stop_reason: "refusal"。只捕获异常的错误处理将完全漏掉拒绝,您的应用会悄无声息地返回空结果。
务必检查停用原因(stop reason)。
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}]
)

if response.stop_reason == "refusal":
    category = (
        response.stop_details.category
        if response.stop_details else "policy"
    )
    print(f"Request declined ({category}). Please rephrase and try again.")
else:
    print(get_text(response))
在我的测试中,Fable 5 常会用普通文本拒绝边缘请求,并返回正常的 end_turn。而硬性分类器拒绝(stop_reason: "refusal" 且 content 为空)更少见。上述检查可覆盖该路径,避免应用静默返回空。
stop_details.category 可能为 "cyber"、"bio" 或 "reasoning_extraction"。最后一个在提示试图提取模型内部思维链时触发。若您在开发者工具中检查网络安全扫描器或生物数据管线,可能遇到分类器误报。将任务表述得更偏防御性,通常可以解决。
在部署系统中,您可以在 Claude API 与 Claude Platform on AWS 上通过 fallbacks beta 配置自动回退到 Opus 4.8,这是在服务器端运行的。它不同于 Amazon Bedrock:在 Bedrock、Vertex AI 与 Foundry 上,回退逻辑需要由您的应用实现。
response = client.beta.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}],
    fallbacks=[{"model": "claude-opus-4-8"}],
    betas=["server-side-fallback-2026-06-01"]
)
完全未生成输出的被拒请求不计费。中途被拒则会为分类器触发前已生成的内容计费。
如果您的应用只处理文本,可以跳过本节。本部分独立于规划流程,但使用相同的 Messages API 结构。Fable 5 接受 base64 编码块或 URL 形式的图像输入。一个用例是将 UI 截图与功能需求进行对照评审。
import base64

with open("login_form.png", "rb") as f:
    img_data = base64.standard_b64encode(f.read()).decode("utf-8")

response = client.messages.create(
    model=MODEL,
    max_tokens=1024,
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "image",
                "source": {
                    "type": "base64",
                    "media_type": "image/png",
                    "data": img_data
                }
            },
            {
                "type": "text",
                "text": "Review this UI against the requirement: add a 'Forgot password' link below the login button. Is it present? If not, describe what needs to change."
            }
        ]
    }]
)
print(get_text(response))
完整尺寸图像的成本大约为 4,784 个输入 Token,与图像内容无关,因此若不需要全分辨率,请先缩放或压缩。Fable 5 可处理宽度最高 2,576 像素的图像,更大的会被缩小。支持 JPEG、PNG、GIF 与 WebP。
此时,本地脚本已具备完整工作流。将助手封装进一个 FastAPI 路由,便于前端或服务调用。在异步路由中使用 AsyncAnthropic,因为同步客户端会阻塞事件循环。只在启动时初始化一次,而不是每个请求都初始化。
from contextlib import asynccontextmanager
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from anthropic import AsyncAnthropic

client_instance: AsyncAnthropic | None = None

@asynccontextmanager
async def lifespan(app: FastAPI):
    global client_instance
    client_instance = AsyncAnthropic()
    yield
    await client_instance.close()

app = FastAPI(lifespan=lifespan)

class PlanRequest(BaseModel):
    feature_request: str

@app.post("/plan")
async def create_plan(body: PlanRequest):
    response = await client_instance.messages.create(
        model="claude-fable-5",
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        messages=[{"role": "user", "content": body.feature_request}]
    )

    if response.stop_reason == "refusal":
        raise HTTPException(status_code=400, detail="Request declined by safety classifier.")

    return {
        "plan": get_text(response),
        "input_tokens": response.usage.input_tokens,
        "output_tokens": response.usage.output_tokens
    }
使用 uvicorn app:app --reload 启动,并通过 /plan 端点在 FastAPI 文档 http://localhost:8000/docs 中进行测试。
与 DataCamp 一起学习
课程
课程
课程