
Kurs
Claude Code 101
3 Std.
26.7K
Update (1. Juli 2026): Der Zugriff auf Claude Fable 5 ist wiederhergestellt und nun weltweit auf Claude Platform, Claude.ai, Claude Code und Claude Cowork verfügbar, nachdem die Exportbeschränkung aufgehoben wurde. Mythos 5 bleibt auf geprüfte Project-Glasswing-Partner beschränkt.
Update (2. September 2026): Anthropic hat den Nachfolger von Fable 5 veröffentlicht. Lies am besten unseren Guide zu Claude Fable 5.1 für alle Details.
Wenn ich ein neues Modell über eine API teste, interessieren mich weniger die Launch-Notes und mehr die Teile, die ich ins Codegerüst einbauen muss: Wie sieht der API-Call aus, was hat sich gegenüber dem Vorgängermodell geändert, was kostet es, und was passiert, wenn die Safety-Layer Nein sagt?
Unser Übersichtsartikel zu Claude Fable 5 deckt den Launch, Benchmarks und das Safety-Setup ab, das Fable 5 besonders macht. Der folgende Code knüpft daran an. Konkret nutzen wir einen Developer Task Assistant, der eine Feature-Anfrage entgegennimmt und einen strukturierten Implementierungsplan zurückgibt, dann fügen wir Streaming, Tool-Nutzung, Kostentracking und einen FastAPI-Endpunkt hinzu.
Wir gehen durch:
Claude Fable 5 ist ein Anthropic-Modell vom 9. Juni 2026 mit dem API-String claude-fable-5. Anthropic beschreibt es als dasselbe Basismodell wie Claude Mythos 5, jedoch mit angewendeten Safety-Klassifizierern für die breite Verfügbarkeit. Mythos 5 bleibt auf Project Glasswing beschränkt, ein Programm für vertrauenswürdige Sicherheitsorganisationen.
Für Entwickler sind diese API-Details relevant:
Ein Kontextfenster mit 1 Mio. Tokens und bis zu 128k Ausgabetokens pro Anfrage
Preis: $10 pro Million Input-Tokens und $50 pro Million Output-Tokens, doppelt so teuer wie Opus 4.8
Adaptive Thinking ist immer aktiv und kann nicht deaktiviert werden. Der effort-Parameter steuert die Tiefe; die interne Modellbegründung wird erzeugt und berechnet, egal ob du sie anzeigst oder nicht
Es ist ein „Covered Model“, d. h. 30 Tage Datenaufbewahrung sind verpflichtend. Zero Data Retention ist für dieses Modell nicht verfügbar.
Ich würde es nicht für jeden API-Call nutzen. Es lohnt sich für Aufgaben, die Begründung über Architektur, Edge Cases und Implementierungsdetails erfordern. Für Einfacheres reichen Sonnet 4.6 oder Haiku 4.5 vermutlich aus.
Der Assistent nimmt eine Feature-Anfrage entgegen und gibt einen strukturierten Plan zurück: eine technische Kurzfassung, geordnete Umsetzungsschritte, voraussichtliche Dateiänderungen, Risiken und Tests.
Ich nutze dieses Beispiel, weil es die API-Details erzwingt, die in echten Integrationen zählen: strukturierte Ausgabe, Streaming, Tool-Calls, Kosten und Refusal-Handling. Klein, aber mehr als nur ein Hello World.
Die folgenden Abschnitte bauen diese Bausteine Schritt für Schritt auf.
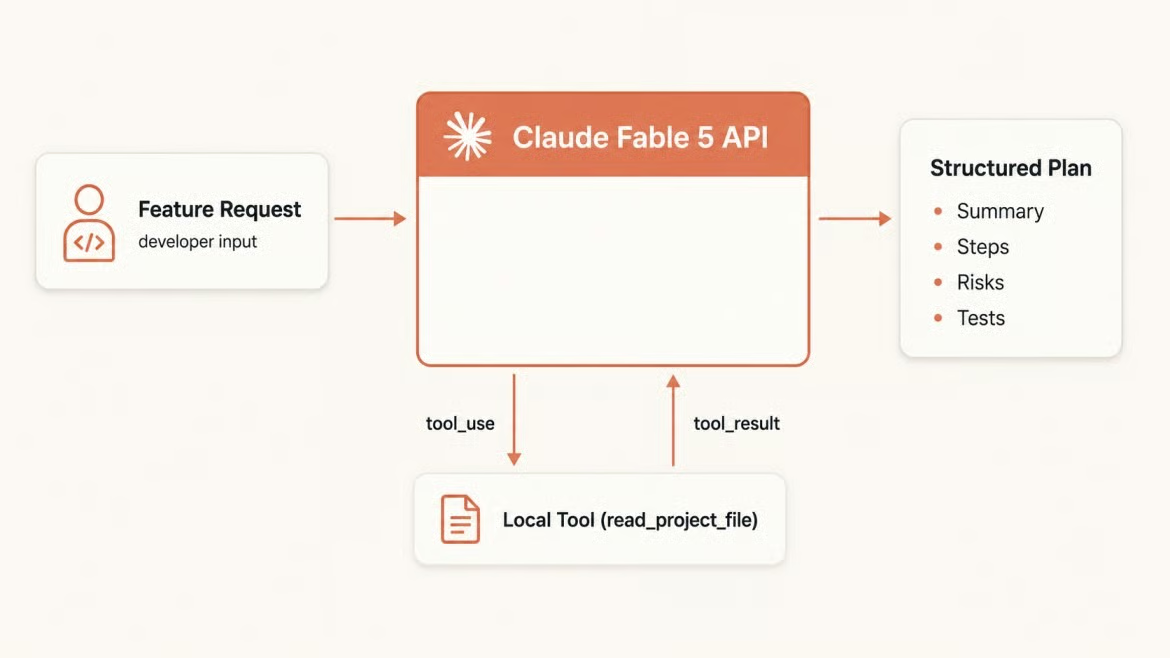
Feature-Anfrage führt zu strukturiertem Plan. Bild: Autor.
Der Hauptcode liegt in task_assistant.py für das lokale Skript und app.py für den FastAPI-Endpunkt.
Um mitzumachen, brauchst du:
Python 3.9 oder neuer (das Tutorial nutzt 3.10+-Features wie eingebaute Type Hints in Pydantic-Modellen, das SDK selbst unterstützt 3.9+)
Einen Anthropic-API-Schlüssel mit Zugriff auf claude-fable-5
Grundkenntnisse in Umgebungsvariablen, JSON und HTTP-APIs
Ein Terminal und einen Code-Editor
Lege zuerst einen Projektordner und eine virtuelle Umgebung an.
mkdir task-assistant
cd task-assistant
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
Installiere das Anthropic-SDK, FastAPI und ein paar Helfer.
pip install anthropic fastapi uvicorn python-dotenv pydanticErstelle im Projektstamm eine .env-Datei mit deinem API-Key. Diese Datei niemals ins Repo committen.
ANTHROPIC_API_KEY=sk-ant-...Lade sie am Anfang deines Skripts. Anthropic() liest ANTHROPIC_API_KEY automatisch aus der Umgebung.
from dotenv import load_dotenv
from anthropic import Anthropic

load_dotenv()
client = Anthropic()
Initialisiere den Client einmal auf Modulebene und verwende ihn im gesamten Tutorial wieder.
Bevor ich Logik hinzufüge, sende ich gern eine Minimalanfrage, um das Setup zu prüfen. Die Messages-API nimmt den Modellstring, ein max_tokens-Limit und ein Messages-Array entgegen. max_tokens ist Pflicht; das SDK wirft sonst einen TypeError.
MODEL = "claude-fable-5"

def get_text(response):
    """Return the first text block, skipping thinking or tool blocks."""
    return next((b.text for b in response.content if b.type == "text"), "")

response = client.messages.create(
    model=MODEL,
    max_tokens=512,
    messages=[{"role": "user", "content": "Reply in one sentence to confirm the API connection is working."}]
)

print(get_text(response))
print(f"Model: {response.model}")
print(f"Input tokens: {response.usage.input_tokens}")
print(f"Output tokens: {response.usage.output_tokens}")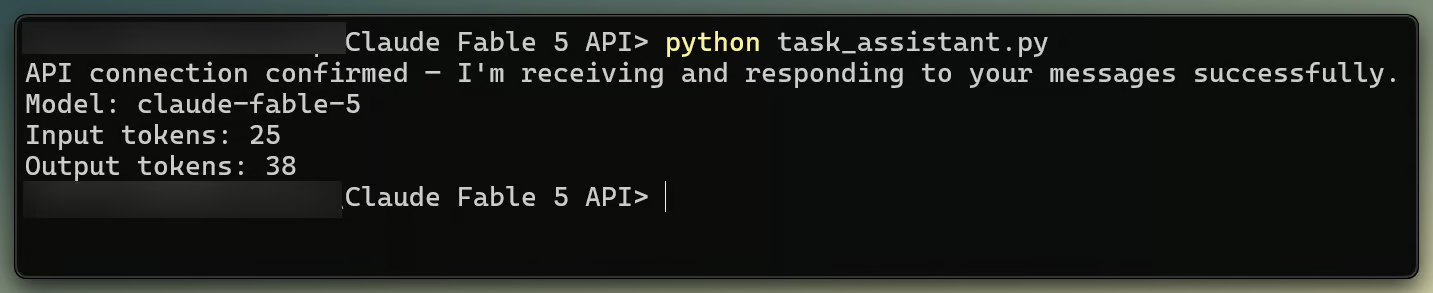
Fable-5-API-Antwort und Tokens. Bild: Autor.
response.content ist eine Liste von Inhaltsblöcken, kein einfacher String. Wegen des oben erwähnten Adaptive-Thinking-Verhaltens ist der erste Block oft ein Thinking-Block, und content[0].text kann einen AttributeError auslösen. Der get_text Helper filtert daher per block.type == "text".
Das usage-Objekt liefert dir die Input- und Output-Tokenzahlen nach jeder Anfrage. response.model zeigt, welches Modell geantwortet hat, was bei konfigurierten Fallbacks wichtig ist.
Der effort Parameter, übergeben in output_config, steuert diese Reasoning-Tiefe.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": feature_request}]
)
Der Standard ist "high". Ich würde damit starten, dann "low" oder "medium" nutzen, wenn Latenz wichtiger ist, und "xhigh" oder "max" für längere Probleme. Effort verändert, wie viele Thinking-Tokens das Modell erzeugt, nicht ob es sie erzeugt.
Der system-Parameter ist ein Top-Level-Feld in der Anfrage, getrennt vom messages Array. Alles, was du dort platzierst, gilt für jede Runde und leistet pro Wort mehr als eine Einzelanweisung.
Für den Developer Task Assistant halte ich den System-Prompt bewusst eng: Gib einen prägnanten Engineering-Plan statt einer breiten Analyse zurück.
SYSTEM_PROMPT = """You are a senior software engineer who reviews feature requests and returns
implementation plans. For every request:
- Write a one sentence technical summary
- List the implementation steps in order
- Name the files or components most likely to change
- Call out at most three risks or edge cases
- Suggest concrete tests
Do not narrate options you won't pursue. Act on what you know; ask only when key details are missing."""
Die letzte Anweisung ist wichtig. Fable 5 kann bei einfachen Anfragen zu viel planen, deshalb begrenzt der Prompt die Ausgabe, bevor sie abdriftet.
Übergebe den System-Prompt bei jedem Call.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature_request}]
)
Assistant-Pre-Filling wird bei Fable 5 nicht unterstützt. Wenn du älteren Claude-Code hast, der die Assistant-Runde mit {"role": "assistant", "content": "{"} startet, um JSON zu erzwingen, entferne das. Dieses Muster führt bei Fable 5 zu einem 400er und ist eine häufige Falle beim Portieren älterer Implementierungen.
Eine Feature-Planung bedeutet, Architektur, Fehlerszenarien und Teststrategie in einer Antwort zusammenzuführen. Ein guter erster Workflow: klein genug zum Prüfen, aber kein Spielzeugprompt.
feature = (
    "Add password reset to our Django app. "
    "Users should receive a token via email and land on a form to set a new password."
)

response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)

print(get_text(response))
Eine typische Antwort deckt Token-Generierung, E-Mail-Zustellung, Formular-Handling und Ablaufbereinigung in einem Durchgang ab.
Reintext ist im Terminal okay. Sobald der Plan zu App-Daten wird, ist eine strukturierte Ausgabe leichter zu verarbeiten. Die Claude-API unterstützt strukturierte Ausgaben über client.messages.parse() und ein Pydantic-Modell; das funktioniert mit claude-fable-5.
Definiere die erwartete Ausgabestruktur als Pydantic-Modell.
from pydantic import BaseModel

class FeaturePlan(BaseModel):
    summary: str
    steps: list[str]
    files: list[str]
    risks: list[str]
    tests: list[str]
Übergebe die Klasse als output_format. Das SDK erzeugt daraus ein JSON-Schema, führt constrained decoding auf den Anthropic-Servern aus und gibt ein typisiertes Objekt in response.parsed_output zurück.
response = client.messages.parse(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}],
    output_format=FeaturePlan
)

plan = response.parsed_output
if plan is not None:
    print(f"Summary: {plan.summary}")
    print(f"Steps: {plan.steps}")
Prüfe parsed_output auf None, bevor du es nutzt. Eine Refusal während des Streamings oder ein früher max_tokens-Cutoff kann es leer lassen. Dieser Weg umgeht auch das Thinking-Block-Thema, weil du parsed_output liest statt in content zu greifen.
Wenn du strukturierte Ausgabe auf einem Modell ohne API-Support brauchst, verlange JSON im Prompt und validiere es mit FeaturePlan.model_validate_json(text), mit einem Retry bei Fehlschlag. Kombiniere strukturierte Ausgabe nicht mit Assistant-Pre-Filling; Fable 5 liefert dafür einen 400er.
Dasselbe Adaptive-Thinking-Verhalten kann bei komplexen Prompts die Zeit bis zum ersten Token erhöhen. Streaming gibt Textstücke aus, sobald sie eintreffen.
Nutze den client.messages.stream() Context-Manager. stream.text_stream liefert Text-Chunks und überspringt Thinking-Blöcke automatisch.
with client.messages.stream(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
) as stream:
    for chunk in stream.text_stream:
        print(chunk, end="", flush=True)

final = stream.get_final_message()
print(f"\nInput tokens: {final.usage.input_tokens}")
print(f"Output tokens: {final.usage.output_tokens}")
Rufe get_final_message() nach dem with Block auf, nicht darin. Dort stehen Stop-Grund und Nutzungszahlen.
Streaming und strukturierte Ausgaben können koexistieren, aber sammle die vollständige Antwort, bevor du sie parsest. Teil-JSON ist kein gültiges JSON.
Mit Tools kann das Modell Informationen anfordern statt sich nur auf den Prompt zu stützen. Als erstes Tool halte ich es klein: read_project_file. Das Modell bittet um das Lesen einer Datei, dein Code liest sie, und das Modell nutzt die Inhalte.
Die Tool-Loop hat eine feste Form. Claude gibt stop_reason: "tool_use" zurück, wenn es ein Tool aufrufen will, du führst das Tool aus und sendest einen tool_result-Block zurück, und die Schleife läuft weiter, bis stop_reason "end_turn" oder "refusal" ist.
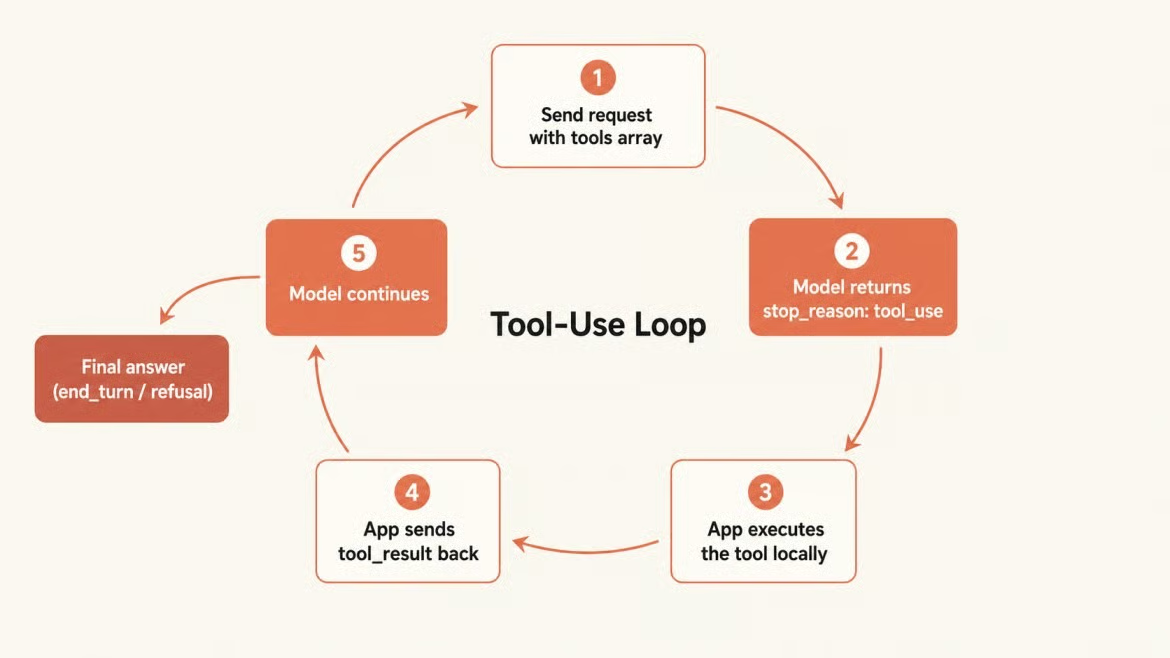
Tool-Loop vom Request zur Antwort. Bild: Autor.
READ_FILE_TOOL = {
    "name": "read_project_file",
    "description": "Read the contents of a file in the project.",
    "input_schema": {
        "type": "object",
        "properties": {
            "path": {"type": "string", "description": "Relative path to the file"}
        },
        "required": ["path"]
    }
}

messages = [{"role": "user", "content": feature}]

while True:
    response = client.messages.create(
        model=MODEL,
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        tools=[READ_FILE_TOOL],
        messages=messages
    )

    if response.stop_reason in ("end_turn", "refusal"):
        break

    if response.stop_reason == "tool_use":
        tool_block = next(b for b in response.content if b.type == "tool_use")

        # Execute the tool locally
        try:
            with open(tool_block.input["path"]) as f:
                result = f.read()[:2000]
        except FileNotFoundError:
            result = f"File not found: {tool_block.input['path']}"

        messages.append({"role": "assistant", "content": response.content})
        messages.append({
            "role": "user",
            "content": [{
                "type": "tool_result",
                "tool_use_id": tool_block.id,
                "content": result
            }]
        })

# Read the final answer
text_block = next((b for b in response.content if b.type == "text"), None)
print(text_block.text if text_block else "No text in final response")
Das Modell führt diesen Code nie aus. Es gibt eine strukturierte Anfrage mit Toolname und JSON-Inputs aus; deine Anwendung führt das Lesen aus. Hänge in derselben User-Runde wie ein tool_result-Block keinen Konversationstext an, sonst stoppt das Modell möglicherweise statt den Plan fortzusetzen.
Bevor es zur App wird, prüfe die Kostenseite. Fable 5 kostet $10 pro Million Input-Tokens und $50 pro Million Output-Tokens. Output ist meist der größere Posten: Ein Plan mit 2.000 Tokens kostet allein im Output $0,10.
Hier ist die Preistabelle in der Anthropic-Familie.
|
Modell |
Input (pro MTok) |
Output (pro MTok) |
Hinweise |
|
Haiku 4.5 |
$1 |
$5 |
Am schnellsten, Near-Frontier-Qualität |
|
Sonnet 4.6 |
$3 |
$15 |
Guter Mix aus Speed und Tiefe |
|
Opus 4.8 |
$5 |
$25 |
Top-Opus-Tier |
|
Fable 5 |
$10 |
$50 |
Leistungsstärkstes breit veröffentlichtes Modell |
Prompt-Caching kann die wiederholten Kosten für den System-Prompt senken. Ist der System-Prompt-Block gecacht, kosten wiederholte Reads $1 statt $10 pro Million Tokens. Der minimale cachebare Block sind 512 Tokens in der Claude-API.
# Tokens vor einer teuren Anfrage zählen
count = client.messages.count_tokens(
    model=MODEL,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)
print(f"Estimated input tokens: {count.input_tokens}")

# Tatsächliche Kosten nach jeder Anfrage berechnen
INPUT_PRICE = 10.0 / 1_000_000
OUTPUT_PRICE = 50.0 / 1_000_000

response = client.messages.create(...)
cost = (
    response.usage.input_tokens * INPUT_PRICE +
    response.usage.output_tokens * OUTPUT_PRICE
)
print(f"Total cost: ${cost:.6f}")
count_tokens kostet kein Geld und zählt nicht gegen dein Output-Rate-Limit. Nutze es, um teure Anfragen zu kontrollieren. Für Jobs ohne Interaktion halbiert die Batch-API sowohl Input- als auch Output-Preise.
Fable 5 nutzt den mit Opus 4.7 eingeführten Tokenizer, der auf demselben Text etwa 30% mehr Tokens erzeugen kann als ältere Claude-Modelle. Berücksichtige das bei Migrationen von Claude 4.6.
Fable 5 führt Safety-Klassifizierer parallel zur Generierung aus. Wenn einer anschlägt, liefert die API einen erfolgreichen HTTP 200, keinen Fehler, und das einzige Signal ist stop_reason: "refusal". Error-Handling, das nur Exceptions fängt, übersieht Refusals komplett, und deine App gibt stillschweigend nichts zurück.
Prüfe immer die Stop-Reason.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}]
)

if response.stop_reason == "refusal":
    category = (
        response.stop_details.category
        if response.stop_details else "policy"
    )
    print(f"Request declined ({category}). Please rephrase and try again.")
else:
    print(get_text(response))
In meinen Tests lehnte Fable 5 grenzwertige Anfragen oft in normalem Text ab und gab ein reguläres end_turn zurück. Die harte Klassifizierer-Refusal mit stop_reason: "refusal" und leerem content ist seltener. Die obige Prüfung behandelt diesen Pfad, damit deine App nicht stillschweigend nichts zurückgibt.
stop_details.category kann "cyber", "bio" oder "reasoning_extraction" sein. Letzteres greift, wenn ein Prompt versucht, die interne Chain of Thought des Modells zu extrahieren. Bei Developer-Tools, die Netzwerkscanner oder biologische Datenpipelines inspizieren, kann es zu False Positives kommen. Eine klar defensive Umformulierung löst das oft.
Für produktive Systeme kannst du einen automatischen Fallback auf Opus 4.8 mit dem fallbacks-Beta konfigurieren, der serverseitig in der Claude-API und der Claude Platform auf AWS läuft. Das ist nicht dasselbe wie Amazon Bedrock: Bedrock, Vertex AI und Foundry benötigen Fallback-Logik in deiner Anwendung.
response = client.beta.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}],
    fallbacks=[{"model": "claude-opus-4-8"}],
    betas=["server-side-fallback-2026-06-01"]
)
Eine abgelehnte Anfrage ohne Output wird nicht berechnet. Eine Refusal mitten im Stream berechnet, was bis zum Auslösen des Klassifizierers erzeugt wurde.
Wenn deine App nur Text verarbeitet, kannst du diesen Abschnitt überspringen. Dieser Teil ist getrennt vom Planungsflow, nutzt aber dieselbe Messages-API-Struktur. Fable 5 akzeptiert Bildeingaben als base64-kodierte Blöcke oder URLs. Ein Anwendungsfall ist die UI-Screenshot-Prüfung gegen eine Anforderung.
import base64

with open("login_form.png", "rb") as f:
    img_data = base64.standard_b64encode(f.read()).decode("utf-8")

response = client.messages.create(
    model=MODEL,
    max_tokens=1024,
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "image",
                "source": {
                    "type": "base64",
                    "media_type": "image/png",
                    "data": img_data
                }
            },
            {
                "type": "text",
                "text": "Review this UI against the requirement: add a 'Forgot password' link below the login button. Is it present? If not, describe what needs to change."
            }
        ]
    }]
)
print(get_text(response))
Ein Bild in voller Größe kostet grob 4.784 Input-Tokens, unabhängig vom Inhalt. Verkleinere oder komprimiere vor dem Senden, wenn du keine volle Auflösung brauchst. Fable 5 verarbeitet Bilder bis 2.576 px Breite und skaliert Größeres herunter. Unterstützte Formate sind JPEG, PNG, GIF und WebP.
An diesem Punkt hat das lokale Skript den kompletten Workflow. Kapsle den Assistenten in einer FastAPI-Route, damit Frontend oder Service ihn aufrufen können. Verwende AsyncAnthropic in asynchronen Routen, da der Sync-Client die Event-Loop blockiert. Initialisiere ihn einmal beim Start, nicht pro Request.
from contextlib import asynccontextmanager
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from anthropic import AsyncAnthropic

client_instance: AsyncAnthropic | None = None

@asynccontextmanager
async def lifespan(app: FastAPI):
    global client_instance
    client_instance = AsyncAnthropic()
    yield
    await client_instance.close()

app = FastAPI(lifespan=lifespan)

class PlanRequest(BaseModel):
    feature_request: str

@app.post("/plan")
async def create_plan(body: PlanRequest):
    response = await client_instance.messages.create(
        model="claude-fable-5",
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        messages=[{"role": "user", "content": body.feature_request}]
    )

    if response.stop_reason == "refusal":
        raise HTTPException(status_code=400, detail="Request declined by safety classifier.")

    return {
        "plan": get_text(response),
        "input_tokens": response.usage.input_tokens,
        "output_tokens": response.usage.output_tokens
    }
Starte mit uvicorn app:app --reload und teste den /plan-Endpunkt in den FastAPI-Dokumenten unter http://localhost:8000/docs.
Lerne mit DataCamp
Kurs
Kurs
Kurs