Curso
Claude Code 101
3 h
26.7K
Actualización (1 de julio de 2026): Se ha restablecido el acceso a Claude Fable 5; ahora está disponible en todo el mundo en Claude Platform, Claude.ai, Claude Code y Claude Cowork tras el levantamiento de la orden de control de exportaciones. Mythos 5 sigue limitado a socios validados de Project Glasswing.
Actualización (2 de septiembre de 2026): Anthropic ha publicado el modelo sucesor de Fable 5. Te recomiendo leer nuestra guía de Claude Fable 5.1 con todos los detalles.
Cuando pruebo un modelo nuevo vía API, me importan menos las notas de lanzamiento y más las partes que tengo que conectar en el código: cómo es la llamada a la API, qué cambió respecto al modelo anterior, cuánto costará y qué pasa cuando la capa de seguridad dice que no.
Nuestro artículo de resumen sobre Claude Fable 5 cubrió el lanzamiento, los benchmarks y la configuración de seguridad que hace único a Fable 5. El código de abajo parte desde ahí. En concreto, usaremos un asistente de tareas para desarrolladores que recibe una petición de funcionalidad y devuelve un plan de implementación estructurado; después añadiremos streaming, uso de herramientas, control de costes y un endpoint en FastAPI.
Veremos:
Claude Fable 5 es un modelo de Anthropic lanzado el 9 de junio de 2026, con la cadena de modelo de API claude-fable-5. Anthropic lo describe como el mismo modelo base que Claude Mythos 5, pero con clasificadores de seguridad aplicados para su disponibilidad general. Mythos 5 sigue limitado a Project Glasswing, un programa restringido para organizaciones de seguridad de confianza.
Para desarrolladores, los detalles de API relevantes son:
Una ventana de contexto de 1M de tokens y hasta 128k tokens de salida por petición
Precio de 10 $ por millón de tokens de entrada y 50 $ por millón de tokens de salida, el doble que Opus 4.8
El razonamiento adaptativo siempre está activo. No puedes desactivarlo. El parámetro effort controla la profundidad; el razonamiento interno del modelo se genera y factura independientemente de si lo muestras o no
Es un "Covered Model", lo que implica una retención de datos obligatoria de 30 días. Zero Data Retention no está disponible para este modelo.
Yo no lo usaría para todas las llamadas. Tiene más sentido en tareas que requieren razonar sobre arquitectura, casos límite y detalles de implementación. Para trabajos más simples, Sonnet 4.6 o Haiku 4.5 probablemente sean suficientes.
El asistente que vamos a crear acepta una petición de funcionalidad y devuelve un plan estructurado: un resumen técnico, pasos de implementación ordenados, cambios de archivos probables, riesgos y pruebas.
Uso este ejemplo porque obliga a tocar los detalles de API que suelen importar en una integración real: salida estructurada, streaming, llamadas a herramientas, coste y gestión de rechazos. Es pequeño, pero no es un "Hola mundo".
Las secciones siguientes construyen esas piezas una a una.
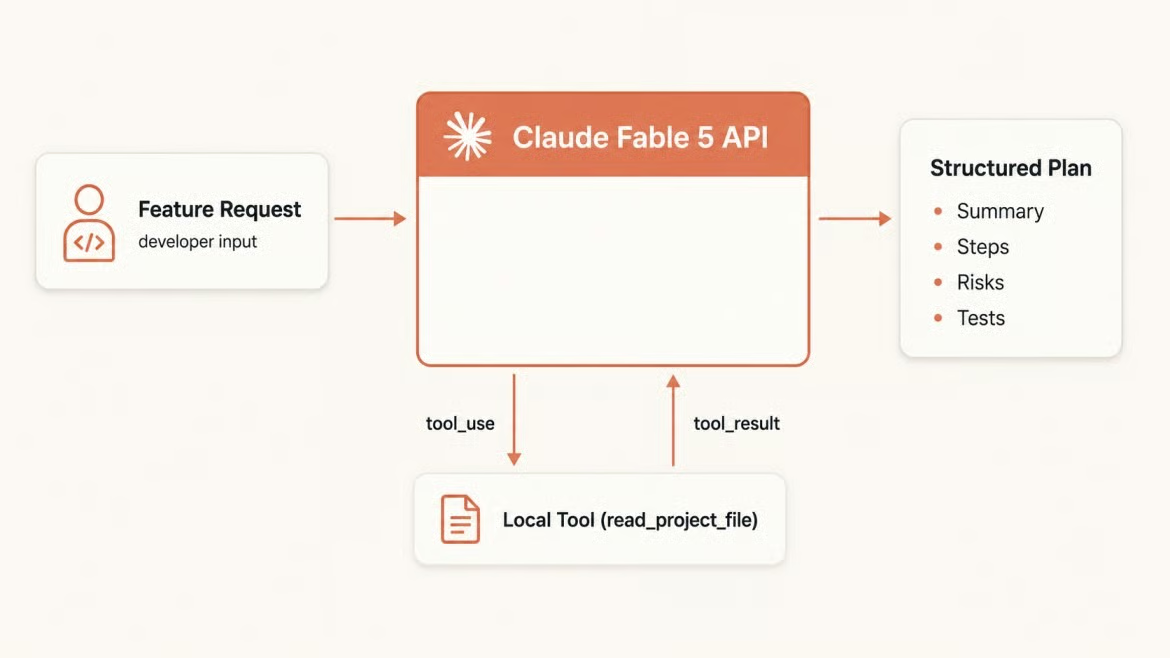
La petición de funcionalidad se convierte en un plan estructurado. Imagen del autor.
El código principal vive en task_assistant.py para el script local y en app.py para el endpoint de FastAPI.
Para seguir el tutorial, necesitas:
Python 3.9 o superior (el tutorial usa características de 3.10+ como type hints integrados en modelos Pydantic, pero el SDK en sí soporta 3.9+)
Una clave de API de Anthropic con acceso a claude-fable-5
Conocimientos básicos de variables de entorno, JSON y APIs HTTP
Un terminal y un editor de código
Empieza creando una carpeta de proyecto y un entorno virtual.
mkdir task-assistant
cd task-assistant
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
Instala el SDK de Anthropic, FastAPI y algunos ayudantes.
pip install anthropic fastapi uvicorn python-dotenv pydanticCrea un archivo .env en la raíz del proyecto con tu clave de API. Nunca lo subas al control de versiones.
ANTHROPIC_API_KEY=sk-ant-...Cárgalo al inicio del script. Anthropic() lee ANTHROPIC_API_KEY del entorno automáticamente.
from dotenv import load_dotenv
from anthropic import Anthropic

load_dotenv()
client = Anthropic()
Inicializa el cliente una vez a nivel de módulo y reutilízalo a lo largo del tutorial.
Antes de añadir lógica de proyecto, me gusta enviar una petición mínima para confirmar que todo funciona. La Messages API recibe la cadena del modelo, un límite max_tokens y un array de mensajes. max_tokens es obligatorio; el SDK lanza un TypeError si lo omites.
MODEL = "claude-fable-5"

def get_text(response):
    """Return the first text block, skipping thinking or tool blocks."""
    return next((b.text for b in response.content if b.type == "text"), "")

response = client.messages.create(
    model=MODEL,
    max_tokens=512,
    messages=[{"role": "user", "content": "Reply in one sentence to confirm the API connection is working."}]
)

print(get_text(response))
print(f"Model: {response.model}")
print(f"Input tokens: {response.usage.input_tokens}")
print(f"Output tokens: {response.usage.output_tokens}")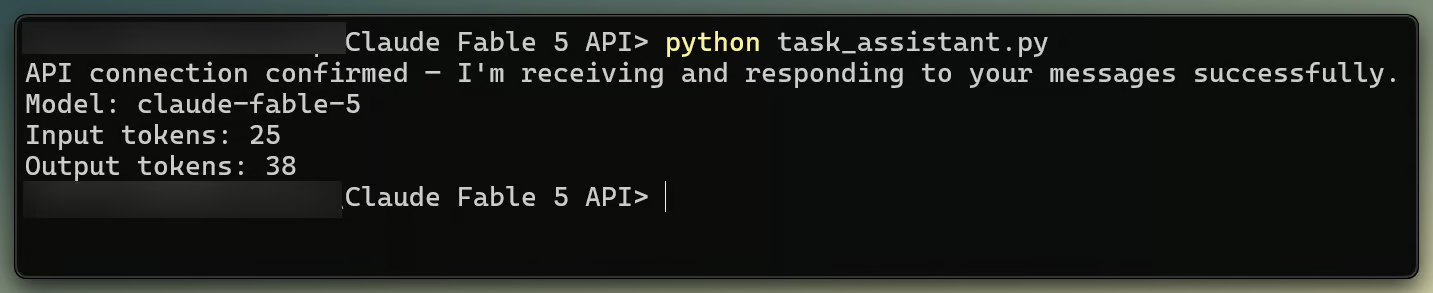
Respuesta de Fable 5 y tokens. Imagen del autor.
response.content es una lista de bloques de contenido, no una cadena simple. Por el comportamiento de razonamiento adaptativo, el primer bloque suele ser de "pensamiento", y content[0].text puede lanzar un AttributeError. El helper get_text filtra por block.type == "text".
El objeto usage te da el número de tokens de entrada y salida tras cada petición. response.model informa qué modelo respondió, algo importante cuando hay fallbacks configurados.
El parámetro effort que se pasa dentro de output_config controla esa profundidad de razonamiento.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": feature_request}]
)
El valor por defecto es "high". Yo empezaría ahí; usa "low" o "medium" cuando importe más la latencia, y "xhigh" o "max" para problemas más largos. Effort cambia cuántos tokens de pensamiento genera el modelo, no si los genera o no.
El parámetro system es un campo de nivel superior en la petición, separado del array messages . Lo que pongas ahí aplica a todos los turnos, así que rinde más por palabra que cualquier instrucción en un turno concreto.
Para el asistente de tareas, mantengo el prompt de sistema acotado: devolver un plan de ingeniería conciso en lugar de un análisis general.
SYSTEM_PROMPT = """You are a senior software engineer who reviews feature requests and returns
implementation plans. For every request:
- Write a one sentence technical summary
- List the implementation steps in order
- Name the files or components most likely to change
- Call out at most three risks or edge cases
- Suggest concrete tests
Do not narrate options you won't pursue. Act on what you know; ask only when key details are missing."""
Esa última instrucción importa. Fable 5 puede añadir demasiada planificación en peticiones sencillas, así que el prompt acota la salida antes de que se desvíe.
Pasa el prompt de sistema en cada llamada.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature_request}]
)
El prefilling del turno del asistente no está soportado en Fable 5. Si tienes código antiguo de Claude que inicia el turno del asistente con {"role": "assistant", "content": "{"} para forzar salida JSON, elimínalo. Ese patrón devuelve un 400 en Fable 5, una trampa común al portar código.
Planificar una funcionalidad implica controlar arquitectura, modos de fallo y estrategia de pruebas en una sola respuesta. Es un buen primer flujo porque es lo bastante pequeño para inspeccionarlo, pero no es un juguete.
feature = (
    "Add password reset to our Django app. "
    "Users should receive a token via email and land on a form to set a new password."
)

response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)

print(get_text(response))
Una respuesta típica cubre generación de tokens, envío de emails, gestión del formulario y limpieza por expiración en un solo paso.
El texto plano sirve en el terminal. Cuando el plan debe convertirse en datos de app, la salida estructurada es más manejable. La API de Claude soporta salidas estructuradas con client.messages.parse() y un modelo de Pydantic, y funciona con claude-fable-5.
Define la forma esperada como un modelo de Pydantic.
from pydantic import BaseModel

class FeaturePlan(BaseModel):
    summary: str
    steps: list[str]
    files: list[str]
    risks: list[str]
    tests: list[str]
Pasa la clase como output_format. El SDK la convierte en un esquema JSON, ejecuta decodificación restringida en los servidores de Anthropic y devuelve un objeto tipado en response.parsed_output.
response = client.messages.parse(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}],
    output_format=FeaturePlan
)

plan = response.parsed_output
if plan is not None:
    print(f"Summary: {plan.summary}")
    print(f"Steps: {plan.steps}")
Comprueba parsed_output por si es None antes de usarlo. Un rechazo durante el streaming o un corte temprano por max_tokens puede dejarlo vacío. Este camino también evita el problema del bloque de pensamiento porque lees parsed_output en lugar de hurgar en content.
Si necesitas salida estructurada en un modelo sin soporte de API, pide JSON en el prompt y valídalo con FeaturePlan.model_validate_json(text), reintentando una vez si falla. No combines salida estructurada con prefilling del turno del asistente; Fable 5 devuelve 400 con ese patrón.
Ese mismo razonamiento adaptativo puede aumentar la espera hasta el primer token en prompts complejos. El streaming imprime fragmentos a medida que llegan.
Usa el client.messages.stream() como context manager. stream.text_stream emite trozos de texto y omite automáticamente los bloques de pensamiento.
with client.messages.stream(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
) as stream:
    for chunk in stream.text_stream:
        print(chunk, end="", flush=True)

final = stream.get_final_message()
print(f"\nInput tokens: {final.usage.input_tokens}")
print(f"Output tokens: {final.usage.output_tokens}")
Llama a get_final_message() después de que se cierre el bloque with, no dentro. Ahí es donde están el motivo de parada y los recuentos de uso.
El streaming y la salida estructurada pueden convivir, pero acumula la respuesta completa antes de parsearla. JSON parcial no es JSON válido.
El uso de herramientas permite que el modelo solicite información en lugar de depender solo del prompt. Mantengo la primera herramienta pequeña: read_project_file. El modelo pide leer un archivo, tu código lo lee y el modelo usa lo que encuentre.
El bucle de herramientas tiene una forma fija. Claude devuelve stop_reason: "tool_use" cuando quiere llamar a una herramienta, tú la ejecutas y devuelves un bloque tool_result, y el bucle continúa hasta que stop_reason sea "end_turn" o "refusal".
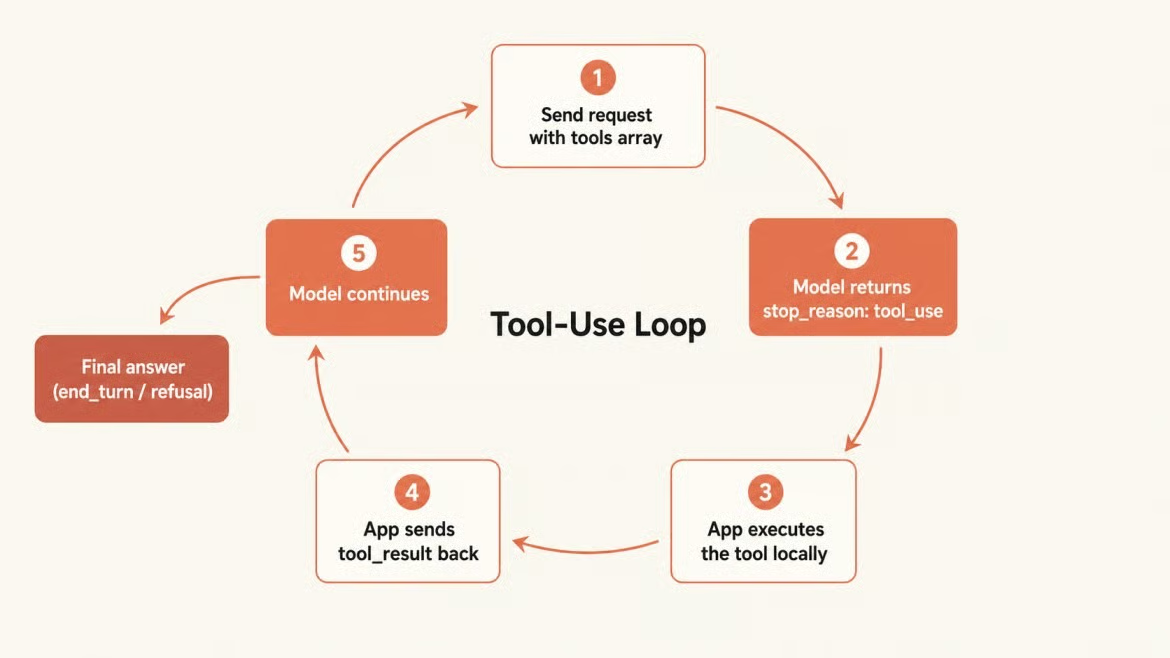
Bucle de herramientas de la solicitud a la respuesta. Imagen del autor.
READ_FILE_TOOL = {
    "name": "read_project_file",
    "description": "Read the contents of a file in the project.",
    "input_schema": {
        "type": "object",
        "properties": {
            "path": {"type": "string", "description": "Relative path to the file"}
        },
        "required": ["path"]
    }
}

messages = [{"role": "user", "content": feature}]

while True:
    response = client.messages.create(
        model=MODEL,
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        tools=[READ_FILE_TOOL],
        messages=messages
    )

    if response.stop_reason in ("end_turn", "refusal"):
        break

    if response.stop_reason == "tool_use":
        tool_block = next(b for b in response.content if b.type == "tool_use")

        # Execute the tool locally
        try:
            with open(tool_block.input["path"]) as f:
                result = f.read()[:2000]
        except FileNotFoundError:
            result = f"File not found: {tool_block.input['path']}"

        messages.append({"role": "assistant", "content": response.content})
        messages.append({
            "role": "user",
            "content": [{
                "type": "tool_result",
                "tool_use_id": tool_block.id,
                "content": result
            }]
        })

# Read the final answer
text_block = next((b for b in response.content if b.type == "text"), None)
print(text_block.text if text_block else "No text in final response")
El modelo nunca ejecuta este código. Emite una solicitud estructurada con un nombre de herramienta e inputs en JSON; tu aplicación realiza la lectura del archivo. No añadas texto conversacional en el mismo turno de usuario que un bloque tool_result, o el modelo puede detenerse en lugar de continuar el plan.
Antes de convertir esto en una app, revisa la estructura de costes. Fable 5 cuesta 10 $ por millón de tokens de entrada y 50 $ por millón de tokens de salida. La salida suele ser la partida mayor: un plan de 2.000 tokens cuesta 0,10 $ solo en salida.
Aquí tienes la tabla de precios en la familia Anthropic.
|
Modelo |
Entrada (por MTok) |
Salida (por MTok) |
Notas |
|
Haiku 4.5 |
$1 |
$5 |
El más rápido, calidad cercana a frontera |
|
Sonnet 4.6 |
$3 |
$15 |
Buen equilibrio entre velocidad y profundidad |
|
Opus 4.8 |
$5 |
$25 |
Nivel superior de Opus |
|
Fable 5 |
$10 |
$50 |
Modelo más capaz de amplia disponibilidad |
El caché de prompts puede reducir el coste repetido del prompt de sistema. Una vez cacheado, las lecturas cuestan 1 $ por millón de tokens en lugar de 10 $. El bloque mínimo cacheable es de 512 tokens en la API de Claude.
# Count tokens before sending an expensive request
count = client.messages.count_tokens(
    model=MODEL,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)
print(f"Estimated input tokens: {count.input_tokens}")

# Calculate actual cost after each request
INPUT_PRICE = 10.0 / 1_000_000
OUTPUT_PRICE = 50.0 / 1_000_000

response = client.messages.create(...)
cost = (
    response.usage.input_tokens * INPUT_PRICE +
    response.usage.output_tokens * OUTPUT_PRICE
)
print(f"Total cost: ${cost:.6f}")
count_tokens no cuesta dinero ni consume tu límite de salida por minuto. Úsalo para frenar peticiones caras. Para trabajos sin interacción, la Batch API reduce a la mitad los precios de entrada y salida.
Fable 5 usa el tokenizador introducido con Opus 4.7, que puede producir aproximadamente un 30% más de tokens con el mismo texto que modelos Claude anteriores. Tenlo en cuenta al migrar desde Claude 4.6.
Fable 5 ejecuta clasificadores de seguridad junto a la generación. Cuando uno se activa, la API devuelve un HTTP 200 correcto, no un error, y la única señal es stop_reason: "refusal". Un manejo de errores que solo capture excepciones pasará por alto los rechazos y tu app devolverá silencio.
Comprueba siempre el motivo de parada.
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}]
)

if response.stop_reason == "refusal":
    category = (
        response.stop_details.category
        if response.stop_details else "policy"
    )
    print(f"Request declined ({category}). Please rephrase and try again.")
else:
    print(get_text(response))
En mis pruebas, Fable 5 a menudo rechazó peticiones limítrofes en texto normal, devolviendo un end_turn normal. El rechazo duro del clasificador, con stop_reason: "refusal" y content vacío, es más raro. La comprobación anterior cubre ese caso para que tu app no devuelva nada en silencio.
stop_details.category puede ser "cyber", "bio" o "reasoning_extraction". La última salta cuando un prompt intenta extraer la cadena de pensamiento interna del modelo. En herramientas de desarrollador que inspeccionan escáneres de seguridad de red o pipelines biológicos puedes sufrir falsos positivos. Reformular para dejar claro que la tarea es defensiva suele resolverlo.
En sistemas en producción, puedes configurar un fallback automático a Opus 4.8 con el beta fallbacks que se ejecuta en el servidor en la API de Claude y Claude Platform en AWS. No es lo mismo que Amazon Bedrock: Bedrock, Vertex AI y Foundry requieren lógica de fallback en tu aplicación.
response = client.beta.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}],
    fallbacks=[{"model": "claude-opus-4-8"}],
    betas=["server-side-fallback-2026-06-01"]
)
Una petición rechazada que no genera salida no se factura. Un rechazo a mitad de streaming factura lo generado antes de que saltara el clasificador.
Si tu app solo maneja texto, puedes saltarte esta sección. Esta parte es independiente del flujo de planificación, pero usa la misma forma de la Messages API. Fable 5 acepta imágenes como bloques en base64 o URLs. Un caso común es revisar capturas de UI contra un requisito.
import base64

with open("login_form.png", "rb") as f:
    img_data = base64.standard_b64encode(f.read()).decode("utf-8")

response = client.messages.create(
    model=MODEL,
    max_tokens=1024,
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "image",
                "source": {
                    "type": "base64",
                    "media_type": "image/png",
                    "data": img_data
                }
            },
            {
                "type": "text",
                "text": "Review this UI against the requirement: add a 'Forgot password' link below the login button. Is it present? If not, describe what needs to change."
            }
        ]
    }]
)
print(get_text(response))
Una imagen a tamaño completo cuesta aproximadamente 4.784 tokens de entrada independientemente de su contenido, así que reduce o comprime antes de enviar si no necesitas la resolución completa. Fable 5 procesa imágenes de hasta 2.576 px de ancho y escala cualquier cosa mayor. Formatos soportados: JPEG, PNG, GIF y WebP.
A estas alturas, el script local ya tiene el flujo completo. Envuelve el asistente en una ruta de FastAPI para que pueda llamarlo un frontend o servicio. Usa AsyncAnthropic dentro de rutas async, ya que el cliente síncrono bloquea el event loop. Inicialízalo una vez al arrancar, no por petición.
from contextlib import asynccontextmanager
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from anthropic import AsyncAnthropic

client_instance: AsyncAnthropic | None = None

@asynccontextmanager
async def lifespan(app: FastAPI):
    global client_instance
    client_instance = AsyncAnthropic()
    yield
    await client_instance.close()

app = FastAPI(lifespan=lifespan)

class PlanRequest(BaseModel):
    feature_request: str

@app.post("/plan")
async def create_plan(body: PlanRequest):
    response = await client_instance.messages.create(
        model="claude-fable-5",
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        messages=[{"role": "user", "content": body.feature_request}]
    )

    if response.stop_reason == "refusal":
        raise HTTPException(status_code=400, detail="Request declined by safety classifier.")

    return {
        "plan": get_text(response),
        "input_tokens": response.usage.input_tokens,
        "output_tokens": response.usage.output_tokens
    }
Ejecuta con uvicorn app:app --reload y prueba el endpoint /plan desde la documentación de FastAPI en http://localhost:8000/docs.
Aprende con DataCamp
Curso
Curso
Curso
Tutorial
Moez Ali
13 min
Tutorial
Abid Ali Awan
Tutorial
Zoumana Keita
14 min
Tutorial
Arunn Thevapalan
13 min
Tutorial
Abid Ali Awan
8 min
Tutorial
Zoumana Keita
12 min