
कोर्स
Claude Code 101
3 घंटा
27.5K
अपडेट (1 जुलाई, 2026): Claude Fable 5 की एक्सेस बहाल कर दी गई है। अब यह Claude Platform, Claude.ai, Claude Code, और Claude Cowork पर वैश्विक रूप से उपलब्ध है, क्योंकि निर्यात नियंत्रण आदेश हटा लिया गया है। Mythos 5 अब भी केवल सत्यापित Project Glasswing पार्टनर्स तक सीमित है।
अपडेट (2 सितंबर, 2026): Anthropic ने Fable 5 का उत्तराधिकारी मॉडल प्रकाशित किया है। सभी विवरणों के लिए हमारा Claude Fable 5.1 गाइड पढ़ने की सलाह देता हूँ।
जब मैं किसी नए मॉडल को API से टेस्ट करता हूँ, तो मुझे लॉन्च नोट्स से कम और उन हिस्सों से ज्यादा मतलब होता है जिन्हें मुझे कोड में वायर करना है: API कॉल कैसी दिखती है, पिछले मॉडल से क्या बदला, इसकी लागत कितनी होगी, और जब सेफ्टी लेयर ना कह दे तो क्या होता है?
हमारे Claude Fable 5 के ओवरव्यू लेख में लॉन्च, बेंचमार्क नतीजे, और वह सेफ्टी सेटअप कवर किया गया था जो Fable 5 को अलग बनाता है। नीचे का कोड वहीं से आगे बढ़ता है। खास तौर पर, हम एक Developer Task Assistant का उपयोग करेंगे जो किसी सॉफ़्टवेयर फीचर रिक्वेस्ट को लेकर एक संरचित इम्प्लीमेंटेशन प्लान लौटाता है, फिर उसमें streaming, tool use, कॉस्ट ट्रैकिंग, और एक FastAPI endpoint जोड़ेंगे।
हम कवर करेंगे:
Claude Fable 5 एक Anthropic मॉडल है जो 9 जून, 2026 को जारी हुआ, जिसका API मॉडल स्ट्रिंग claude-fable-5 है। Anthropic के अनुसार यह Claude Mythos 5 वाला वही बेस मॉडल है, लेकिन सामान्य उपलब्धता के लिए उस पर सेफ्टी क्लासिफ़ायर्स लगाए गए हैं। Mythos 5 Project Glasswing तक सीमित है, जो भरोसेमंद सुरक्षा संगठनों के लिए एक प्रतिबंधित कार्यक्रम है।
डेवलपर्स के लिए, प्रासंगिक API विवरण:
1M टोकन का कॉन्टेक्स्ट विंडो और प्रति अनुरोध अधिकतम 128k आउटपुट टोकन
प्राइसिंग: प्रति मिलियन इनपुट टोकन $10 और प्रति मिलियन आउटपुट टोकन $50, जो Opus 4.8 का दोगुना है
Adaptive thinking हमेशा ऑन रहता है। आप इसे अक्षम नहीं कर सकते। effort पैरामीटर गहराई नियंत्रित करता है; मॉडल की आंतरिक reasoning जेनरेट और बिल की जाती है, चाहे आप उसे दिखाएँ या नहीं
यह एक "Covered Model" है, यानी 30 दिन का डाटा रिटेंशन अनिवार्य है। Zero Data Retention इस मॉडल पर उपलब्ध नहीं है।
मैं इसे हर API कॉल के लिए नहीं इस्तेमाल करूंगा। यह उन कार्यों के लिए ज्यादा समझ में आता है जिन्हें आर्किटेक्चर, edge cases, और इम्प्लीमेंटेशन डिटेल्स पर reasoning चाहिए। सरल कामों के लिए Sonnet 4.6 या Haiku 4.5 शायद पर्याप्त हैं।
हम जो असिस्टेंट बनाएँगे, वह सॉफ़्टवेयर फीचर रिक्वेस्ट लेता है और एक संरचित प्लान लौटाता है: टेक्निकल समरी, क्रम में इम्प्लीमेंटेशन स्टेप्स, संभावित फ़ाइल परिवर्तन, जोखिम, और टेस्ट।
मैं यह उदाहरण इसलिए लेता हूँ क्योंकि यह उन API डिटेल्स को मजबूर करता है जो वास्तविक इंटीग्रेशन में मायने रखते हैं: structured output, streaming, tool calls, कॉस्ट, और refusal हैंडलिंग। यह छोटा है, लेकिन सिर्फ Hello World नहीं है।
नीचे दिए सेक्शंस इन्हीं हिस्सों को एक-एक करके बनाते हैं।
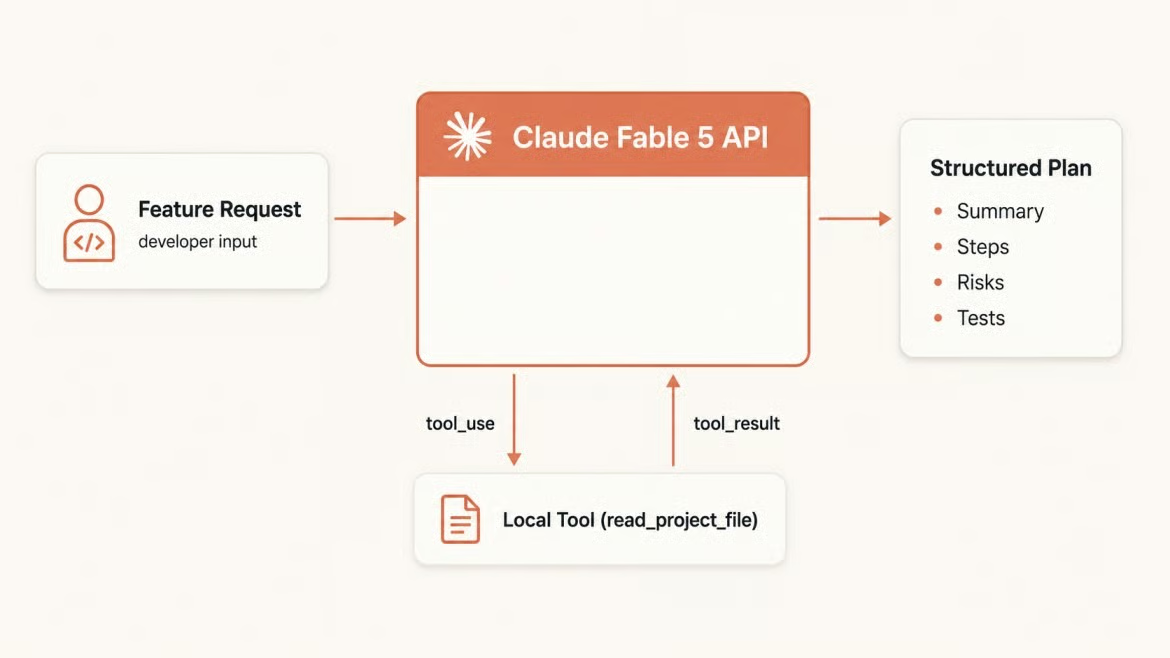
फीचर रिक्वेस्ट से संरचित प्लान तक का प्रवाह। चित्र: लेखक।
मुख्य कोड लोकल स्क्रिप्ट के लिए task_assistant.py और FastAPI endpoint के लिए app.py में रहता है।
साथ चलने के लिए, आपको चाहिए:
Python 3.9 या नया (ट्यूटोरियल 3.10+ फीचर्स का उपयोग करता है, जैसे Pydantic मॉडल्स में built-in type hints, पर SDK स्वयं 3.9+ सपोर्ट करता है)
claude-fable-5 की एक्सेस वाला Anthropic API key
Environment variables, JSON, और HTTP APIs की मूल जानकारी
एक टर्मिनल और एक कोड एडिटर
एक प्रोजेक्ट फ़ोल्डर और एक वर्चुअल एनवायरनमेंट बनाकर शुरू करें।
mkdir task-assistant
cd task-assistant
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
Anthropic SDK, FastAPI, और कुछ हेल्पर्स इंस्टॉल करें।
pip install anthropic fastapi uvicorn python-dotenv pydantic.env फ़ाइल प्रोजेक्ट रूट पर अपने API key के साथ बनाएँ। इस फ़ाइल को कभी भी वर्शन कंट्रोल में कमिट न करें।
ANTHROPIC_API_KEY=sk-ant-...इसे अपनी स्क्रिप्ट के शीर्ष पर लोड करें। Anthropic() स्वतः ANTHROPIC_API_KEY को एनवायरनमेंट से पढ़ता है।
from dotenv import load_dotenv
from anthropic import Anthropic

load_dotenv()
client = Anthropic()
क्लाइंट को मॉड्यूल स्तर पर एक बार इनिशियलाइज़ करें और पूरे ट्यूटोरियल में reuse करें।
प्रोजेक्ट लॉजिक जोड़ने से पहले, मैं एक न्यूनतम रिक्वेस्ट भेजकर सेटअप की पुष्टि करता हूँ। Messages API एक मॉडल स्ट्रिंग, max_tokens कैप, और messages array लेता है। max_tokens अनिवार्य है; यदि आप इसे छोड़ देते हैं, तो SDK TypeError उठाता है।
MODEL = "claude-fable-5"

def get_text(response):
    """Return the first text block, skipping thinking or tool blocks."""
    return next((b.text for b in response.content if b.type == "text"), "")

response = client.messages.create(
    model=MODEL,
    max_tokens=512,
    messages=[{"role": "user", "content": "Reply in one sentence to confirm the API connection is working."}]
)

print(get_text(response))
print(f"Model: {response.model}")
print(f"Input tokens: {response.usage.input_tokens}")
print(f"Output tokens: {response.usage.output_tokens}")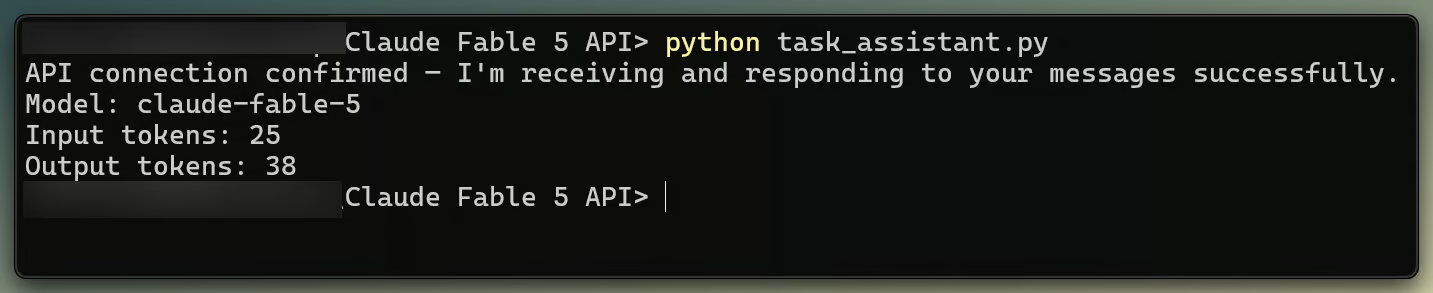
Fable 5 API प्रतिक्रिया और टोकन। चित्र: लेखक।
response.content कंटेंट ब्लॉक्स की सूची है, न कि सादा स्ट्रिंग। ऊपर बताई गई adaptive thinking के कारण, पहला ब्लॉक अक्सर thinking ब्लॉक होता है, और content[0].text एक AttributeError उठा सकता है। get_text हेल्पर इसके बजाय block.type == "text" से फ़िल्टर करता है।
usage ऑब्जेक्ट हर रिक्वेस्ट के बाद इनपुट और आउटपुट टोकन काउंट देता है। response.model बताता है किस मॉडल ने उत्तर दिया, जो फ़ॉलबैक कॉन्फ़िगर होने पर मायने रखता है।
effort पैरामीटर, जिसे output_config के अंदर पास किया जाता है, उसी reasoning depth का कंट्रोल है।
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": feature_request}]
)
डिफ़ॉल्ट "high" है। मैं वहीं से शुरू करूंगा, फिर "low" या "medium" का उपयोग तब करूँगा जब latency ज्यादा महत्वपूर्ण हो, और "xhigh" या "max" लंबे समस्याओं के लिए। Effort यह बदलता है कि मॉडल कितने thinking tokens जेनरेट करता है, न कि वह उन्हें जेनरेट करेगा या नहीं।
system पैरामीटर रिक्वेस्ट में टॉप-लेवल फ़ील्ड है, जो messages array से अलग है। जो भी आप वहाँ रखते हैं वह हर टर्न पर लागू होता है, यानी वह किसी भी एकल टर्न इंस्ट्रक्शन से प्रति शब्द अधिक काम करता है।
Developer Task Assistant के लिए, मैं सिस्टम प्रॉम्प्ट को संकरा रखता हूँ: विस्तृत विश्लेषण के बजाय एक संक्षिप्त इंजीनियरिंग प्लान लौटाएँ।
SYSTEM_PROMPT = """You are a senior software engineer who reviews feature requests and returns
implementation plans. For every request:
- Write a one sentence technical summary
- List the implementation steps in order
- Name the files or components most likely to change
- Call out at most three risks or edge cases
- Suggest concrete tests
Do not narrate options you won't pursue. Act on what you know; ask only when key details are missing."""
वह आखिरी निर्देश मायने रखता है। सरल रिक्वेस्ट पर Fable 5 कभी-कभी ज़रूरत से ज़्यादा प्लानिंग जोड़ देता है, इसलिए प्रॉम्प्ट आउटपुट को बाँध देता है ताकि प्रतिक्रिया भटके नहीं।
हर कॉल के साथ सिस्टम प्रॉम्प्ट पास करें।
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature_request}]
)
Assistant turn prefilling Fable 5 पर सपोर्टेड नहीं है। यदि आपके पास पुराना Claude कोड है जो JSON आउटपुट मजबूर करने के लिए {"role": "assistant", "content": "{"} से असिस्टेंट टर्न शुरू करता है, तो उसे हटा दें। यह पैटर्न Fable 5 पर 400 लौटाता है, जो पुराना कोड पोर्ट करते समय एक आसान जाल है।
किसी फीचर की प्लानिंग में एक ही रिस्पॉन्स में आर्किटेक्चर, failure modes, और टेस्ट स्ट्रैटेजी ट्रैक करनी होती है। यह एक अच्छा पहला वर्कफ़्लो है क्योंकि यह निरीक्षण के लिए पर्याप्त छोटा है, पर केवल एक खिलौना प्रॉम्प्ट नहीं।
feature = (
    "Add password reset to our Django app. "
    "Users should receive a token via email and land on a form to set a new password."
)

response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    output_config={"effort": "high"},
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)

print(get_text(response))
एक सामान्य प्रतिक्रिया एक ही बार में टोकन जेनरेशन, ईमेल डिलीवरी, फॉर्म हैंडलिंग, और expiry cleanup को कवर करती है।
टर्मिनल में सादा टेक्स्ट ठीक है। एक बार जब प्लान को ऐप डेटा बनना हो, तो structured output के साथ काम करना आसान होता है। Claude API client.messages.parse() और एक Pydantic मॉडल के जरिए structured outputs सपोर्ट करता है, और यह claude-fable-5 के साथ काम करता है।
Pydantic मॉडल के रूप में अपेक्षित आउटपुट शेप परिभाषित करें।
from pydantic import BaseModel

class FeaturePlan(BaseModel):
    summary: str
    steps: list[str]
    files: list[str]
    risks: list[str]
    tests: list[str]
output_format के रूप में क्लास पास करें। SDK इसे JSON schema में बदलता है, Anthropic के सर्वरों पर constrained decoding चलती है, और टाइप्ड ऑब्जेक्ट response.parsed_output पर लौटता है।
response = client.messages.parse(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}],
    output_format=FeaturePlan
)

plan = response.parsed_output
if plan is not None:
    print(f"Summary: {plan.summary}")
    print(f"Steps: {plan.steps}")
parsed_output को उपयोग करने से पहले None के लिए जाँचें। स्ट्रीमिंग के दौरान refusal या शुरुआती max_tokens कटऑफ इसे खाली छोड़ सकता है। यह रास्ता thinking ब्लॉक इश्यू से भी बचाता है क्योंकि आप content में घुसे बिना parsed_output पढ़ते हैं।
यदि आपको ऐसे मॉडल पर structured output चाहिए जहाँ API सपोर्ट न हो, तो प्रॉम्प्ट में JSON माँगें और FeaturePlan.model_validate_json(text) से वैलिडेट करें, असफल होने पर एक बार retry करें। Structured output को assistant turn prefilling के साथ न जोड़ें; Fable 5 उस पैटर्न के लिए 400 लौटाता है।
यही adaptive thinking व्यवहार जटिल प्रॉम्प्ट्स पर पहले टोकन से पहले इंतज़ार बढ़ा सकता है। स्ट्रीमिंग आने वाले टेक्स्ट चंक्स को आते ही प्रिंट कर देता है।
client.messages.stream() कॉन्टेक्स्ट मैनेजर का उपयोग करें। stream.text_stream टेक्स्ट चंक्स देता है और thinking ब्लॉक्स को अपने आप स्किप करता है।
with client.messages.stream(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
) as stream:
    for chunk in stream.text_stream:
        print(chunk, end="", flush=True)

final = stream.get_final_message()
print(f"\nInput tokens: {final.usage.input_tokens}")
print(f"Output tokens: {final.usage.output_tokens}")
get_final_message() को with ब्लॉक के बंद होने के बाद कॉल करें, अंदर नहीं। वहीं stop reason और usage काउंट्स मिलते हैं।
स्ट्रीमिंग और structured output साथ रह सकते हैं, लेकिन पार्स करने से पहले पूरे रिस्पॉन्स को इकट्ठा करें। आंशिक JSON वैध JSON नहीं होता।
टूल उपयोग मॉडल को केवल प्रॉम्प्ट पर निर्भर रहने के बजाय जानकारी माँगने देता है। पहला टूल मैं छोटा रखता हूँ: read_project_file। मॉडल फ़ाइल पढ़ने को कहता है, आपका कोड फ़ाइल पढ़ता है, और मॉडल जो पाता है उसका उपयोग करता है।
टूल लूप का एक तय ढांचा है। जब मॉडल को टूल कॉल करना हो, Claude stop_reason: "tool_use" लौटाता है, आप टूल चलाते हैं और एक tool_result ब्लॉक भेजते हैं, और लूप तब तक चलता है जब तक stop_reason "end_turn" या "refusal" न हो जाए।
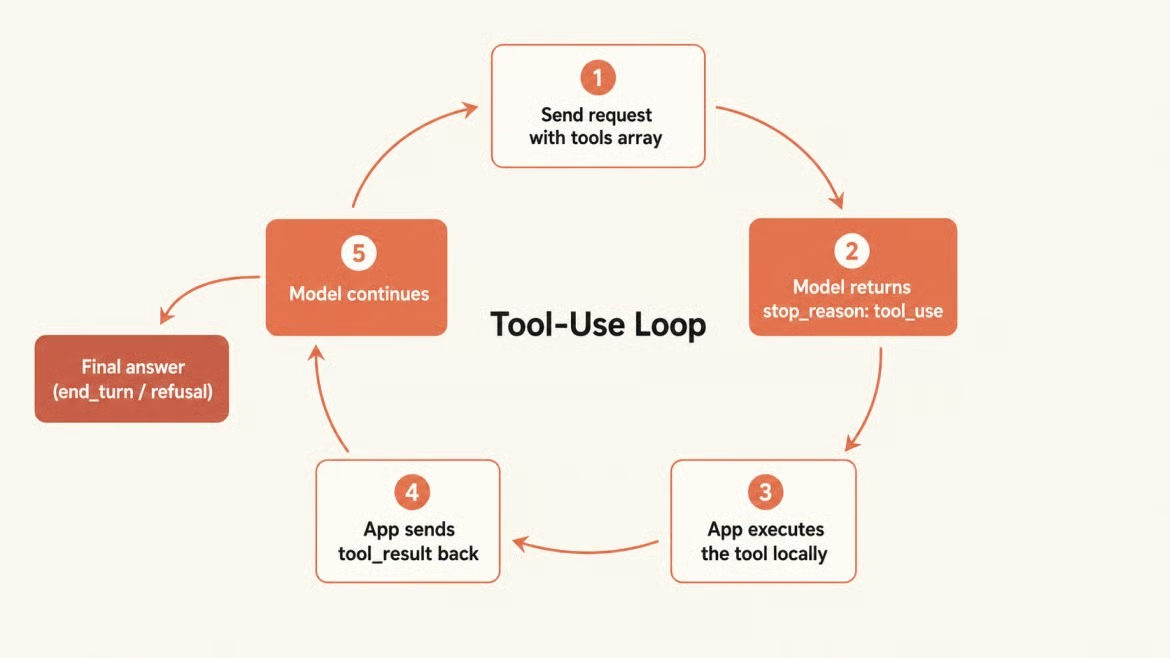
रिक्वेस्ट से उत्तर तक टूल लूप। चित्र: लेखक।
READ_FILE_TOOL = {
    "name": "read_project_file",
    "description": "Read the contents of a file in the project.",
    "input_schema": {
        "type": "object",
        "properties": {
            "path": {"type": "string", "description": "Relative path to the file"}
        },
        "required": ["path"]
    }
}

messages = [{"role": "user", "content": feature}]

while True:
    response = client.messages.create(
        model=MODEL,
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        tools=[READ_FILE_TOOL],
        messages=messages
    )

    if response.stop_reason in ("end_turn", "refusal"):
        break

    if response.stop_reason == "tool_use":
        tool_block = next(b for b in response.content if b.type == "tool_use")

        # Execute the tool locally
        try:
            with open(tool_block.input["path"]) as f:
                result = f.read()[:2000]
        except FileNotFoundError:
            result = f"File not found: {tool_block.input['path']}"

        messages.append({"role": "assistant", "content": response.content})
        messages.append({
            "role": "user",
            "content": [{
                "type": "tool_result",
                "tool_use_id": tool_block.id,
                "content": result
            }]
        })

# Read the final answer
text_block = next((b for b in response.content if b.type == "text"), None)
print(text_block.text if text_block else "No text in final response")
मॉडल यह कोड कभी एक्ज़ीक्यूट नहीं करता। वह टूल नाम और JSON इनपुट्स के साथ एक संरचित रिक्वेस्ट emit करता है; आपकी एप्लीकेशन फ़ाइल पढ़ती है। एक ही user टर्न में tool_result ब्लॉक के साथ वार्तालापी टेक्स्ट न जोड़ें, वरना मॉडल प्लान जारी रखने के बजाय रुक सकता है।
इसे ऐप में बदलने से पहले, कॉस्ट प्रोफ़ाइल देखें। Fable 5 की कीमत इनपुट के लिए $10/MTok और आउटपुट के लिए $50/MTok है। आउटपुट आमतौर पर बड़ा मद होता है: 2,000-टोकन का प्लान सिर्फ आउटपुट में $0.10 पड़ता है।
यहाँ Anthropic फैमिली में प्राइस तालिका है।
|
मॉडल |
इनपुट (प्रति MTok) |
आउटपुट (प्रति MTok) |
टिप्पणी |
|
Haiku 4.5 |
$1 |
$5 |
सबसे तेज, near-frontier गुणवत्ता |
|
Sonnet 4.6 |
$3 |
$15 |
गति और गहराई का मजबूत संतुलन |
|
Opus 4.8 |
$5 |
$25 |
शीर्ष Opus स्तर |
|
Fable 5 |
$10 |
$50 |
सबसे सक्षम व्यापक रूप से जारी मॉडल |
प्रोम्प्ट कैशिंग दोहराए गए सिस्टम प्रॉम्प्ट की लागत घटा सकती है। एक बार सिस्टम प्रॉम्प्ट ब्लॉक कैश होने पर, दोहराए गए रीड की कीमत $10 के बजाय $1 प्रति मिलियन टोकन होती है। Claude API पर न्यूनतम कैशेबल ब्लॉक 512 टोकन है।
# Count tokens before sending an expensive request
count = client.messages.count_tokens(
    model=MODEL,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": feature}]
)
print(f"Estimated input tokens: {count.input_tokens}")

# Calculate actual cost after each request
INPUT_PRICE = 10.0 / 1_000_000
OUTPUT_PRICE = 50.0 / 1_000_000

response = client.messages.create(...)
cost = (
    response.usage.input_tokens * INPUT_PRICE +
    response.usage.output_tokens * OUTPUT_PRICE
)
print(f"Total cost: ${cost:.6f}")
count_tokens पैसे नहीं लगाता और आपके आउटपुट रेट लिमिट के खिलाफ नहीं गिना जाता। महंगे रिक्वेस्ट गेट करने के लिए इसका उपयोग करें। जिन जॉब्स में इंटरैक्शन नहीं चाहिए, उनके लिए Batch API इनपुट और आउटपुट दोनों कीमतें आधी कर देता है।
Fable 5 Opus 4.7 के साथ पेश किए गए tokenizer का उपयोग करता है, जो पुराने Claude मॉडलों के समान टेक्स्ट पर लगभग 30% अधिक टोकन पैदा कर सकता है। Claude 4.6 से माइग्रेशन में इसे ध्यान में रखें।
Fable 5 जेनरेशन के साथ-साथ सेफ्टी क्लासिफ़ायर्स चलाता है। जब कोई ट्रिगर होता है, तो API सफल HTTP 200 लौटाता है, त्रुटि नहीं, और एकमात्र संकेत होता है stop_reason: "refusal"। केवल एक्सेप्शन पकड़ने वाली error handling refusals को पूरी तरह मिस कर देगी, और आपका ऐप चुपचाप कुछ नहीं लौटाएगा।
हमेशा stop reason जाँचें।
response = client.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}]
)

if response.stop_reason == "refusal":
    category = (
        response.stop_details.category
        if response.stop_details else "policy"
    )
    print(f"Request declined ({category}). Please rephrase and try again.")
else:
    print(get_text(response))
मेरे परीक्षणों में, Fable 5 ने सीमा रेखा के अनुरोधों को अक्सर सादे टेक्स्ट में ठुकराया, एक सामान्य end_turn लौटाते हुए। हार्ड क्लासिफ़ायर refusal, जिसमें stop_reason: "refusal" और content खाली होता है, दुर्लभ है। ऊपर की जाँच उस पथ को संभालती है ताकि आपका ऐप चुपचाप कुछ भी न लौटाए।
stop_details.category "cyber", "bio", या "reasoning_extraction" हो सकता है। आखिरी तब फायर होता है जब कोई प्रॉम्प्ट मॉडल की आंतरिक chain of thought निकालने की कोशिश करता है। वे डेवलपर टूल जो नेटवर्क सुरक्षा स्कैनर या बायोलॉजिकल डाटा पाइपलाइंस देखते हैं, उनमें क्लासिफ़ायर false positives लग सकते हैं। टास्क को स्पष्ट रूप से रक्षात्मक बताने के लिए पुनः वाक्यांश बनाना अक्सर इसे दूर कर देता है।
डिप्लॉयड सिस्टम्स के लिए, आप Claude API और AWS पर Claude Platform में सर्वर-रनिंग fallbacks बीटा के साथ Opus 4.8 पर स्वचालित फ़ॉलबैक कॉन्फ़िगर कर सकते हैं। यह Amazon Bedrock जैसा नहीं है: Bedrock, Vertex AI, और Foundry में फ़ॉलबैक लॉजिक आपकी एप्लीकेशन में चाहिए।
response = client.beta.messages.create(
    model=MODEL,
    max_tokens=2048,
    system=SYSTEM_PROMPT,
    messages=[{"role": "user", "content": user_input}],
    fallbacks=[{"model": "claude-opus-4-8"}],
    betas=["server-side-fallback-2026-06-01"]
)
जिस अनुरोध को अस्वीकार कर दिया गया और कोई आउटपुट जेनरेट नहीं हुआ, उसके लिए बिल नहीं बनता। मध्य-स्ट्रीम refusal में क्लासिफ़ायर फायर होने से पहले जो जेनरेट हो चुका है, उसके लिए बिल बनता है।
यदि आपका ऐप केवल टेक्स्ट संभालता है, तो यह सेक्शन छोड़ सकते हैं। यह हिस्सा प्लानिंग फ्लो से अलग है, पर वही Messages API शेप उपयोग करता है। Fable 5 इमेज इनपुट्स base64-एन्कोडेड ब्लॉक्स या URLs के रूप में स्वीकार करता है। एक उपयोग मामला है फीचर आवश्यकता के खिलाफ UI स्क्रीनशॉट रिव्यू।
import base64

with open("login_form.png", "rb") as f:
    img_data = base64.standard_b64encode(f.read()).decode("utf-8")

response = client.messages.create(
    model=MODEL,
    max_tokens=1024,
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "image",
                "source": {
                    "type": "base64",
                    "media_type": "image/png",
                    "data": img_data
                }
            },
            {
                "type": "text",
                "text": "Review this UI against the requirement: add a 'Forgot password' link below the login button. Is it present? If not, describe what needs to change."
            }
        ]
    }]
)
print(get_text(response))
फुल-साइज़ इमेज लगभग 4,784 इनपुट टोकन की लागत रखती है, चाहे उसमें क्या भी दिखे, इसलिए यदि पूरी रेज़ोल्यूशन की ज़रूरत न हो तो भेजने से पहले resize या compress करें। Fable 5 2,576 px चौड़ाई तक की इमेज प्रोसेस करता है और इससे बड़ी किसी भी इमेज को स्केल डाउन कर देता है। सपोर्टेड फॉर्मैट JPEG, PNG, GIF, और WebP हैं।
इस बिंदु पर, लोकल स्क्रिप्ट में पूरा वर्कफ़्लो है। असिस्टेंट को FastAPI रूट में लपेटें ताकि कोई फ्रंटएंड या सर्विस इसे कॉल कर सके। async रूट्स में AsyncAnthropic का उपयोग करें, क्योंकि sync क्लाइंट इवेंट लूप को ब्लॉक करता है। इसे startup पर एक बार इनिशियलाइज़ करें, प्रति रिक्वेस्ट नहीं।
from contextlib import asynccontextmanager
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from anthropic import AsyncAnthropic

client_instance: AsyncAnthropic | None = None

@asynccontextmanager
async def lifespan(app: FastAPI):
    global client_instance
    client_instance = AsyncAnthropic()
    yield
    await client_instance.close()

app = FastAPI(lifespan=lifespan)

class PlanRequest(BaseModel):
    feature_request: str

@app.post("/plan")
async def create_plan(body: PlanRequest):
    response = await client_instance.messages.create(
        model="claude-fable-5",
        max_tokens=2048,
        system=SYSTEM_PROMPT,
        messages=[{"role": "user", "content": body.feature_request}]
    )

    if response.stop_reason == "refusal":
        raise HTTPException(status_code=400, detail="Request declined by safety classifier.")

    return {
        "plan": get_text(response),
        "input_tokens": response.usage.input_tokens,
        "output_tokens": response.usage.output_tokens
    }
इसे uvicorn app:app --reload से चलाएँ और /plan endpoint को FastAPI docs पर http://localhost:8000/docs से टेस्ट करें।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स