Kursus
Pengantar Deep Learning dengan Python
4 jam
264.6K
(Tutorial ini mengasumsikan pembaca sudah familiar dengan dasar-dasar jaringan saraf)
Istilah jaringan saraf bukan lagi hal yang asing bagi komunitas Ilmu Komputer atau, katakanlah, masyarakat umum. Alasan utama yang membuatnya begitu menarik bukan hanya banyaknya masalah dunia nyata yang diselesaikannya, tetapi juga jenis masalah yang diselesaikannya. Bagaimana bisa begitu beragam?
Baik itu di bidang Psikologi Kognitif, di ranah Keamanan Siber, di area Kesehatan (Untuk sementara, Anda tidak mempertimbangkan Computer Vision, Computer Graphics, Natural Language Processing, dll.). Mari sebut yang lebih jarang! Hampir setiap industri memperoleh manfaat luar biasa dari kecerdasan dan otomatisasi yang ditawarkan jaringan saraf.
Tapi mengapa? Ini adalah pertanyaan yang terus muncul! Jawabannya masih dalam penelitian aktif karena Jaringan Saraf cenderung seperti kotak hitam dan kemiripannya dengan otak membuat pertanyaan ini semakin rumit. Bagaimanapun, menjawab pertanyaan itu bukan tujuan tulisan ini.
Satu hal yang pasti! Untuk memperoleh hasil yang diharapkan dari jaringan saraf, hal yang harus dipastikan adalah Pelatihannya. Dan sejauh ini, Anda mungkin sudah menyadari bahwa melatih yang sangat besar membutuhkan daya komputasi yang sangat besar. Tanpa GPU dan SSD yang baik, hampir mustahil melatih jaringan saraf yang sangat besar. Sekarang, seberapa besar itu sangat besar? Yah, cukup besar untuk menghasilkan hasil yang baik pada dataset ImageNet karena itu semacam tolok ukur.
Namun gagasan melatih jaringan saraf raksasa ini benar-benar direvolusi ketika tim peneliti berbakat dari Fast.ai mampu mengalahkan model Google dengan mencapai akurasi 93% hanya dalam 18 menit dengan biaya hanya $40.
Terdengar menarik? Lanjutkan membaca!
Lalu apa bahan kunci di balik ini? GPU tercanggih? TPU tercanggih? SSD tercanggih?
Tentu saja tidak. Konfigurasi tim cukup sederhana karena biayanya hanya $40. Bahan kuncinya adalah penggunaan algoritme mutakhir untuk melatih jaringan saraf. Dalam blog ini, peneliti dan pendidik hebat Jeremy Howard membahas alasan utama di balik kemenangan besar ini.
Ini adalah contoh klasik di mana kekuatan perangkat keras mahal kalah oleh kekuatan algoritme yang mumpuni. Dalam tulisan ini, Anda akan mengupas detail salah satu teknik yang dapat memastikan jaringan saraf dilatih dengan laju pembelajaran terbaik. Teknik ini dikenal sebagai Cyclical Learning Rate (CLR). Teknik ini diusulkan pada 2015 oleh Leslie N. Smith. Anda dapat melihat makalah aslinya di sini.
Tapi mengapa hanya membahas laju pembelajaran ketika ada hiperparameter penting lain seperti dropout rate dan fungsi aktivasi? Karena laju pembelajaran adalah yang paling penting di antaranya. Hanya itu!
Dalam tulisan ini, Anda akan mempelajari:
Mari kita tinjau cepat tujuan utama penggunaan laju pembelajaran saat melatih jaringan saraf.
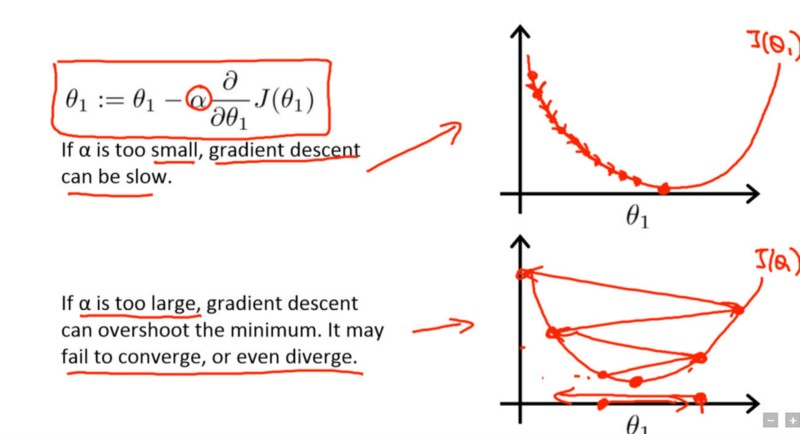
Laju pembelajaran adalah sebuah hiperparameter yang mengontrol seberapa banyak Anda menyesuaikan bobot jaringan terhadap gradien loss. Apa? Mengapa gradien muncul di sini? Karena Anda sedang mengoptimalkan jaringan saraf yang baru saja Anda buat dengan gradient descent. Tujuan inti gradient descent adalah menemukan titik minimum dari fungsi loss yang dioptimalkan jaringan saraf Anda. Perhatikan gambar berikut [diambil dari kursus Deep Learning Andrew Ng di Coursera]:
Istilah di dalam persegi panjang adalah aturan pembaruan yang digunakan jaringan untuk mulai mempelajari parameternya $\theta$1 di mana $\alpha$ adalah laju pembelajaran.
Pada kurva pertama, titik paling bawah adalah minimum dari fungsi loss. Misalkan pada iterasi saat ini, jaringan Anda berada dekat titik paling atas di sebelah kiri. Untuk mencapai titik terendah, Anda mengambil turunan parsial dari fungsi loss $J(\theta1)$ dan menghitung gradien untuk mendapatkan arah menuju titik terendah itu.
Untuk sampai sedikit lebih cepat, Anda menambahkan istilah lain $\alpha$ yang merupakan laju pembelajaran. Semakin kecil nilainya, semakin lambat Anda bergerak di sepanjang kemiringan menurun. Meskipun ini bisa jadi ide yang baik (menggunakan laju pembelajaran rendah) untuk memastikan Anda tidak melewatkan minimum lokal mana pun, ini juga bisa berarti Anda akan membutuhkan waktu lama untuk konvergen — terutama jika terjebak di wilayah dataran tinggi.
Itu tadi tinjauan singkat tujuan laju pembelajaran dalam kata-kata sederhana. Sekarang Anda akan mempelajari teknik memilih laju pembelajaran yang baik untuk jaringan saraf Anda.
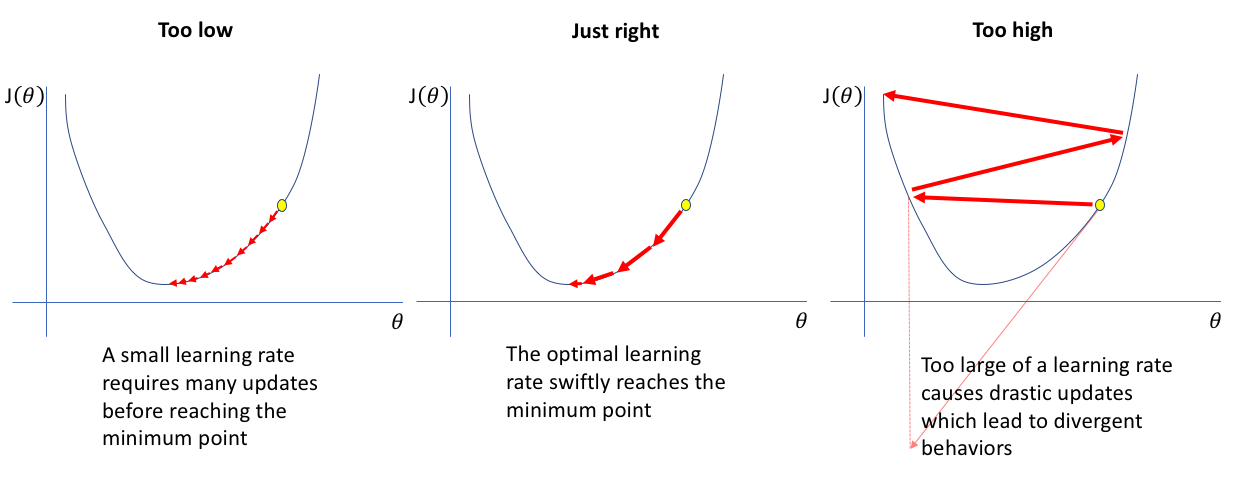
Tidak ada laju pembelajaran yang tetap untuk sebuah jaringan saraf. Itu bergantung pada jenis masalah yang Anda kerjakan, tipe data yang Anda masukkan ke jaringan, dan yang terpenting struktur jaringan yang bervariasi dari satu masalah ke masalah lain. Memilih laju pembelajaran secara manual adalah tugas yang sangat melelahkan karena jika Anda melatih jaringan besar, biayanya bisa sangat besar. Dan juga memakan waktu.
Haruskah Anda menjalankan metode optimisasi hiperparameter standar seperti Grid Search atau Random Search?
Sebelum CLR, Adaptive Learning Rates diusulkan yang dapat dianggap sebagai pesaing CLR, tetapi eksperimen dengan Adaptive Learning Rates mahal secara komputasi, sementara CLR tidak.
Sampai sekarang, praktik paling umum adalah menetapkan laju pembelajaran ke nilai konstan dan menurunkannya satu orde magnitudo begitu akurasi mulai mendatar.
Oleh karena itu, ada kebutuhan jelas akan teknik sistematis yang dapat menyederhanakan proses memilih laju pembelajaran yang baik untuk jaringan saraf tertentu. Tidak hanya itu, juga harus ada alasan yang memadai untuk mendukung pendekatan tersebut agar dapat dipercaya.
Tampaknya Cyclical Learning Rates (CLR) hadir tepat pada waktunya.
Tujuan cyclical learning rate (CLR) ada dua:
Anda akan mempelajari bagian ini untuk membangun intuisi tentang cara kerja CLR. Pada bagian berikutnya, Anda akan menyelami lebih detail. Pada bagian sebelumnya, Anda telah memahami secara singkat mengapa laju pembelajaran digunakan. Mari kita ingat lagi.
Laju pembelajaran yang ideal adalah yang menghasilkan penurunan tajam pada loss jaringan. Di sinilah keampuhan CLR. Makalah asli CLR membahas sebuah eksperimen di mana Anda dapat mengamati perilaku laju pembelajaran terhadap loss. Eksperimen ini mudah divisualisasikan: Anda secara bertahap meningkatkan laju pembelajaran setelah setiap mini-batch, sambil merekam loss pada setiap kenaikan. Peningkatan bertahap ini bisa linear atau eksponensial. Dan ya, inilah yang disebut LR Range Test.
Setelah melakukan eksperimen yang ditunjukkan Leslie, untuk laju pembelajaran yang terlalu rendah, loss mungkin menurun tetapi sangat lambat. Saat memasuki zona laju pembelajaran optimal, Anda akan melihat penurunan cepat pada fungsi loss. Jika Anda terus meningkatkan laju pembelajaran, ini dapat menyebabkan hilangnya parameter dalam jaringan yang pada gilirannya dapat meningkatkan loss. Jadi, dari eksperimen ini, jelas bahwa Anda tertarik pada penurunan curam dari fungsi loss dan untuk itu, Anda dapat menganalisis gradien fungsi loss pada berbagai tahap pelatihan.
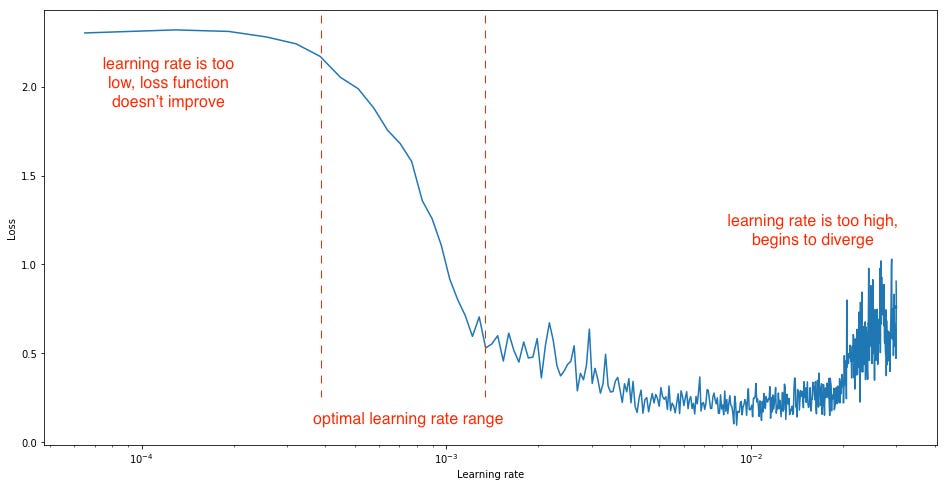
Jadi, dari grafik di atas, Anda dapat dengan mudah melihat tiga fase berbeda: pertama loss tidak banyak berubah, lalu tiba saat terjadi penurunan tajam, dan kemudian loss kembali meningkat perlahan.
Dapatkah Anda melihat penurunan paling curam di antara yang lain? Ya, pada dasarnya Anda ingin berada di rentang itu, dan CLR akan memberi Anda pendekatan yang terarah untuk menemukannya. Sudah mulai paham, mari cari tahu lebih lanjut.
Pengamatan di atas memberi Anda poin penting untuk dipertimbangkan:
Intuisi CLR muncul dari gagasan membiarkan laju pembelajaran bervariasi dalam suatu rentang nilai, alih-alih mengadopsi nilai yang menurun secara linear atau eksponensial. Anda dapat melakukannya dengan menetapkan rentang laju pembelajaran tertentu dan kemudian, alih-alih melakukan variasi linear atau eksponensial, Anda memvariasikan laju pembelajaran secara siklik dari rentang yang ditentukan. Leslie mempertimbangkan bentuk fungsi berikut untuk memvariasikan laju pembelajaran secara siklik:
Namun semua bentuk menghasilkan hasil yang setara, dan dalam makalah asli, idenya hanya disajikan dengan bentuk segitiga (naik linear lalu turun linear) karena kesederhanaannya. Kebijakan ini juga disebut sebagai triangular learning rate policy. Implementasinya juga mudah. Berikut adalah implementasi umum dari triangular learning rate policy:
local cycle = math.floor(1 + epochCounter / ( 2 ∗ stepsize))
local x = math.abs(epochCounter / stepsize − 2∗ cycle + 1 )
local lr = opt.LR + (maxLR − opt.LR) ∗ math.max(0 , (1−x ))
di mana
Lihat gambar berikut untuk memikirkan bentuk segitiga secara visual:

Sumber: Makalah CLR asli yang disebutkan di awal tutorial.
Selain kebijakan laju pembelajaran segitiga, kebijakan berikut juga disajikan dalam makalah:
Satu pertanyaan yang mungkin langsung Anda tanyakan pada titik ini adalah - Bagaimana memperkirakan nilai batas minimum dan maksimum yang wajar? Ingat LR Range Test yang baru saja Anda pelajari? Sekarang, Anda seharusnya bisa melihat relevansinya dengan lebih baik.
Leslie mengusulkan cara yang mudah dan nyaman untuk menentukan rentang Laju Pembelajaran:
Mari lakukan studi kasus singkat sekarang untuk melihat bagaimana CLR dapat memberikan hasil yang luar biasa.
(Hingga akhir tutorial ini, Anda akan menemukan beberapa pengembangan lebih lanjut di atas CLR yang baru-baru ini diusulkan, tetapi sejauh ini Anda sudah memahami nilai CLR.)
Anda akan melakukannya menggunakan dataset klasik MNIST yang mungkin merupakan dataset paling populer untuk memulai Computer Vision dan Deep Learning. Lihat blog ini jika Anda ingin mempelajari MNIST secara sangat mendetail. Anda akan menggunakan keras secara ekstensif untuk semua keperluan eksperimen. keras menyediakan versi bawaan dari dataset tersebut. Anda akan memulai eksperimen dengan mengimpornya dan melakukan beberapa EDA dasar.
from keras.datasets import mnist
Using TensorFlow backend.
Anda telah berhasil mengimpor dataset. Sekarang, Anda akan melakukan beberapa visualisasi dasar dari dataset.
import matplotlib.pyplot as plt

(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Plot 4 images as gray scale
plt.subplot(152)
plt.imshow(X_train[0], cmap=plt.get_cmap('gray'))
plt.subplot(153)
plt.imshow(X_train[1], cmap=plt.get_cmap('gray'))
plt.subplot(154)
plt.imshow(X_train[2], cmap=plt.get_cmap('gray'))
plt.subplot(155)
plt.imshow(X_train[3], cmap=plt.get_cmap('gray'))
# Show the plot
plt.show()
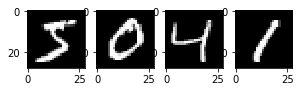
Bagus! Anda akan langsung membangun jaringan saraf multilapis sederhana. Namun sebelum itu, Anda akan melakukan beberapa prapemrosesan data dasar.
# Flatten 28*28 images to a 784 vector for each image
num_pixels = X_train.shape[1] * X_train.shape[2]
X_train = X_train.reshape(X_train.shape[0], num_pixels).astype('float32')
X_test = X_test.reshape(X_test.shape[0], num_pixels).astype('float32')
Apa yang Anda lakukan?
Gambar dalam dataset berdimensi 28*28 yang sulit diakomodasi dalam jaringan multilapis sederhana. Itulah mengapa Anda mengonversi gambar menjadi satu dimensi di mana setiap gambar berisi 784 data piksel menggunakan fungsi reshape().
Nilai piksel pada gambar berada pada rentang 0 - 255. Ide yang baik adalah menurunkannya lebih jauh dengan menormalisasi rentang ke 0 - 1.
X_train = X_train / 255
X_test = X_test / 255
Variabel keluaran adalah bilangan bulat dari 0 hingga 9. Ini adalah masalah klasifikasi multikelas. Anda akan melakukan one-hot encoding pada label kelas untuk mengubah vektor bilangan bulat kelas menjadi matriks biner. Anda melakukan ini untuk melakukan “binarisasi” kategori sehingga dapat disertakan sebagai fitur untuk melatih jaringan saraf.
Anda dapat dengan mudah melakukannya menggunakan fungsi pembantu bawaan np_utils.to_categorical() di keras.
from keras.utils import np_utils

y_train = np_utils.to_categorical(y_train)
y_test = np_utils.to_categorical(y_test)
num_classes = y_test.shape[1]
Sekarang Anda akan mendefinisikan struktur jaringan Anda. Anda akan menggunakan jaringan fully-connected sederhana untuk tujuan ini. Di keras ini biasanya proses tiga langkah:
import numpy as np
from keras.models import Sequential
from keras.layers import Dense

# Create model
model = Sequential()
model.add(Dense(num_pixels, input_dim=num_pixels, kernel_initializer='normal', activation='relu'))
model.add(Dense(num_classes, kernel_initializer='normal', activation='softmax'))

# Compile model
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
Mari lihat apa yang Anda lakukan pada kode di atas. Anda menyusun jaringan secara berurutan (yang merupakan tumpukan linear layer). Lalu Anda mulai menambahkan layer ke jaringan, di mana pada layer pertama Anda menambahkan neuron (sama dengan jumlah piksel pada gambar, yakni 784) dan Anda menentukan dimensi input gambar yang dalam hal ini sama dengan jumlah piksel. Anda menginstruksikan jaringan untuk menginisialisasi bobot dari distribusi normal. Terakhir, Anda memberikan relu sebagai fungsi aktivasi untuk layer pertama.
Pada layer terakhir, Anda mempertahankan jumlah neuron 10 (jumlah label kelas), dan Anda memberikan aktivasi softmax untuk mengubah keluaran menjadi nilai seperti probabilitas dan memungkinkan satu kelas dari 10 dipilih sebagai prediksi keluaran model.
Anda mengompilasi model untuk menentukan metode optimasi model (yang dalam hal ini ADAM) dan jenis loss yang akan dioptimasi metode ini (yang dalam hal ini categorical_loss).
Sekarang Anda akan melatih model dan mencatat waktu yang dibutuhkan. Anda juga akan menguji performanya.
import timeit

# For fixing the reproducibility
from numpy.random import seed
seed(1)

# Fit the model
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=200, verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 10s - loss: 0.2774 - acc: 0.9207 - val_loss: 0.1362 - val_acc: 0.9610
Epoch 2/10
 - 8s - loss: 0.1113 - acc: 0.9675 - val_loss: 0.0951 - val_acc: 0.9720
Epoch 3/10
 - 8s - loss: 0.0712 - acc: 0.9793 - val_loss: 0.0802 - val_acc: 0.9750
Epoch 4/10
 - 8s - loss: 0.0503 - acc: 0.9857 - val_loss: 0.0687 - val_acc: 0.9788
Epoch 5/10
 - 8s - loss: 0.0360 - acc: 0.9897 - val_loss: 0.0632 - val_acc: 0.9797
Epoch 6/10
 - 8s - loss: 0.0267 - acc: 0.9928 - val_loss: 0.0643 - val_acc: 0.9784
Epoch 7/10
 - 8s - loss: 0.0201 - acc: 0.9951 - val_loss: 0.0633 - val_acc: 0.9802
Epoch 8/10
 - 8s - loss: 0.0150 - acc: 0.9962 - val_loss: 0.0613 - val_acc: 0.9808
Epoch 9/10
 - 8s - loss: 0.0108 - acc: 0.9978 - val_loss: 0.0625 - val_acc: 0.9806
Epoch 10/10
 - 8s - loss: 0.0076 - acc: 0.9988 - val_loss: 0.0612 - val_acc: 0.9809
Time taken for the Network to train :  86.4216202873591
Baseline Error: 1.91%
Model sederhana ini cukup baik dengan mencapai tingkat kesalahan hanya 1,91% dalam sekitar 87 detik. Sekarang Anda akan melihat kekuatan CLR. Anda akan mulai dengan mengkloning implementasi keras untuk CLR dari Github.
Setelah berhasil mengkloning, Anda akan memiliki berkas berikut di direktori kerja lokal Anda.

Kebijakan CLR diimplementasikan sebagai sebuah keras callback di sini.
from keras.callbacks import *
from clr_callback import *
from keras.optimizers import Adam

# You are using the triangular learning rate policy and
#  base_lr (initial learning rate which is the lower boundary in the cycle) is 0.1
clr_triangular = CyclicLR(mode='triangular')
model.compile(optimizer=Adam(0.1), loss='categorical_crossentropy', metrics=['accuracy'])
Anda akan meneruskan clr_triangular ke parameter callbacks saat melatih jaringan. Kali ini Anda akan menggunakan batch_size yang lebih besar. Anda juga akan mencatat waktunya.
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=2000,callbacks=[clr_triangular], verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 4s - loss: 0.0046 - acc: 0.9996 - val_loss: 0.0571 - val_acc: 0.9831
Epoch 2/10
 - 4s - loss: 0.0030 - acc: 0.9998 - val_loss: 0.0575 - val_acc: 0.9829
Epoch 3/10
 - 4s - loss: 0.0023 - acc: 0.9999 - val_loss: 0.0594 - val_acc: 0.9827
Epoch 4/10
 - 4s - loss: 0.0018 - acc: 0.9999 - val_loss: 0.0589 - val_acc: 0.9835
Epoch 5/10
 - 4s - loss: 0.0014 - acc: 1.0000 - val_loss: 0.0595 - val_acc: 0.9831
Epoch 6/10
 - 4s - loss: 0.0011 - acc: 1.0000 - val_loss: 0.0600 - val_acc: 0.9836
Epoch 7/10
 - 4s - loss: 0.0010 - acc: 1.0000 - val_loss: 0.0612 - val_acc: 0.9832
Epoch 8/10
 - 4s - loss: 8.2190e-04 - acc: 1.0000 - val_loss: 0.0621 - val_acc: 0.9829
Epoch 9/10
 - 4s - loss: 6.6182e-04 - acc: 1.0000 - val_loss: 0.0624 - val_acc: 0.9836
Epoch 10/10
 - 4s - loss: 5.7177e-04 - acc: 1.0000 - val_loss: 0.0635 - val_acc: 0.9836
Time taken for the Network to train :  43.23223609056981
Baseline Error: 1.64%
Dapatkah Anda melihat keunggulannya? Ini sungguh menakjubkan! Model Anda hanya membutuhkan 44 detik untuk dilatih dan menghasilkan tingkat kesalahan yang bahkan lebih baik daripada sebelumnya. Sangat bagus!
Anda telah sampai di akhir. Dalam tutorial ini, Anda mempelajari masalah krusial dalam menemukan laju pembelajaran yang sesuai dan bagaimana CLR sepenuhnya mengubah cara Anda mendekati masalah ini. Anda mempelajari CLR dengan cakupan detail yang baik dan melakukan eksperimen kecil untuk melihat bagaimana CLR dapat menghasilkan hasil yang sangat baik dalam waktu lebih singkat.
Lalu, selanjutnya apa? Dua turunan yang lahir dari CLR adalah:
Pelajari dua pendekatan di atas untuk mendapatkan wawasan lebih lanjut tentang topik ini. Juga, setelah CLR Leslie menerbitkan makalah berjudul A disciplined approach to neural network hyper-parameters: Part 1 -- learning rate, batch size, momentum, and weight decay yang meninjau kembali CLR dan membahas metode efisien untuk memilih nilai hiperparameter penting lainnya dari jaringan saraf. Leslie juga meninjau kembali salah satu tekniknya yang disebut Super Convergence dalam makalah ini. Makalah ini wajib dibaca bagi siapa pun yang berpikir, makan, dan tidur bersama jaringan saraf.
Keterbatasan penerapan adalah salah satu kekurangan signifikan dari CLR. CLR harus dibuat benar-benar andal sebelum dapat digunakan di tingkat produksi.
Jika Anda tertarik mengetahui lebih banyak tentang Jaringan Saraf, Anda sebaiknya mengambil kursus Deep Learning in Python dari DataCamp yang dirancang sangat baik dan diajarkan oleh Dan Becker (Head of Kaggle Learn).
Pelajari lebih lanjut tentang Python dan Deep Learning
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt




