Last chance! 50% off DataCamp Premium
Sale ends in
(यह ट्यूटोरियल मान कर चलता है कि पाठक को neural networks की मूल बातें मालूम हैं)
Neural network अब कंप्यूटर साइंस समुदाय—या कहें कि आम समाज—के लिए कोई अनजाना शब्द नहीं रहा। इसकी लोकप्रियता का कारण सिर्फ यह नहीं है कि यह कितनी वास्तविक दुनिया की समस्याएँ सुलझा रहा है, बल्कि यह भी है कि यह किस तरह की समस्याएँ सुलझा रहा है। ये इतने विविध कैसे हो सकते हैं?
चाहे वह Cognitive Psychology का क्षेत्र हो, Cyber Security का डोमेन, या Health-care का क्षेत्र (फिलहाल आप Computer Vision, Computer Graphics, Natural Language Processing आदि को अलग रखिए)। आइए कुछ कम प्रचलित क्षेत्रों के नाम लें! लगभग हर उद्योग को neural network की बुद्धिमत्ता और स्वचालन से अपार लाभ हो रहा है।
लेकिन क्यों? यह सवाल बार-बार उठता रहता है! खैर, इसका उत्तर अभी भी सक्रिय शोध का विषय है क्योंकि Neural Networks स्वभाव से एक तरह के black box हैं और मस्तिष्क से इनकी समानता इस प्रश्न को और जटिल बना देती है। वैसे भी, उस प्रश्न का उत्तर देना इस पोस्ट का उद्देश्य नहीं है।
एक बात तय है! किसी neural network से अपेक्षित परिणाम पाने के लिए जिस एक चीज़ को सुनिश्चित करना होता है, वह है उसका Training। और अब तक, आप समझ चुके होंगे कि बहुत बड़े नेटवर्क का प्रशिक्षण भारी computation शक्ति माँगता है। अच्छे GPUs, SSDs के बिना बहुत बड़े neural network को train करना लगभग असंभव है। अब बहुत बड़ा कितना? खैर, इतना बड़ा कि वह ImageNet डेटासेट पर अच्छे परिणाम दे—क्योंकि यही एक तरह का benchmark है।
लेकिन विशाल neural networks को train करने की यही धारणा तब पूरी तरह बदल गई जब Fast.ai के प्रतिभाशाली शोधकर्ताओं की टीम ने Google के मॉडल को पछाड़ते हुए मात्र 18 मिनट में 93% accuracy हासिल कर ली—वह भी सिर्फ $40 की लागत में।
रोचक लग रहा है? पढ़ते रहिए!
पर यह सब संभव होने के पीछे मुख्य तत्व क्या थे? State-of-the-art GPUs? State-of-the-art TPUs? State-of-the-art SSDs?
बिलकुल नहीं। टीम का विन्यास काफी साधारण था—आखिर लागत तो केवल $40 थी। असल कुंजी थी neural network को train करने के लिए state-of-the-art algorithms का उपयोग। इस ब्लॉग में महान शोधकर्ता और शिक्षक Jeremy Howard ने इस बड़ी जीत के मुख्य कारणों पर चर्चा की है।
यह एक क्लासिक उदाहरण है जहाँ महंगे हार्डवेयर की ताकत शक्तिशाली एल्गोरिद्म की ताकत के आगे फीकी पड़ जाती है। इस पोस्ट में, आप ऐसी ही एक तकनीक का विवरण जानेंगे जो यह सुनिश्चित कर सकती है कि neural network को संभवतः सबसे अच्छे learning rate के साथ train किया जाए। इस तकनीक को Cyclical Learning Rate (CLR) कहा जाता है। इसे 2015 में Leslie N. Smith ने प्रस्तावित किया था। आप मूल शोधपत्र यहाँ देख सकते हैं।
पर जब अन्य महत्त्वपूर्ण hyperparameters जैसे dropout rate और activation functions मौजूद हैं, तो सिर्फ learning rate पर ही क्यों? क्योंकि इनमें learning rate सबसे महत्त्वपूर्ण है। बस इतना ही!
इस पोस्ट में, आप पढ़ेंगे:
आइए जल्दी से देख लें कि neural net के training में learning rates का प्राथमिक उद्देश्य क्या है।
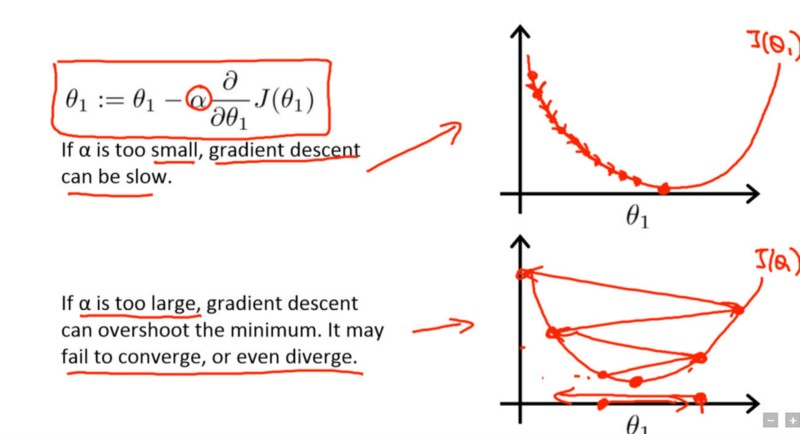
Learning rate एक hyperparameter है जो loss gradient के सापेक्ष आपके नेटवर्क के weights को कितना समायोजित करना है, यह नियंत्रित करता है। क्या? Gradients यहाँ क्यों आए? क्योंकि आप अपने नए बनाए neural network को gradient descent से optimize करने जा रहे हैं। मूलतः gradient descent का लक्ष्य उस loss function के minima को खोजना है जिसे आपका neural network optimize करने की कोशिश कर रहा है। नीचे दिए गए चित्र को देखें [Coursera पर Andrew Ng के Deep Learning कोर्स से लिया गया]:
आयत में दिया गया पद वह update rule है जिसके जरिए नेटवर्क अपना पैरामीटर $\theta$1 सीखना शुरू करता है, जहाँ $\alpha$ learning rate है।
पहले ग्राफ में सबसे निचला बिंदु loss function का minima है। मान लीजिए, वर्तमान iteration में आपका नेटवर्क बाएँ सबसे ऊपर के बिंदु के पास है। अब, उस सबसे निचले बिंदु तक पहुँचने के लिए आप loss function $J(\theta1)$ के partial derivatives लेते हैं और gradients निकालते हैं ताकि उस बिंदु की दिशा मिल सके।
उस बिंदु तक थोड़ा तेज़ी से पहुँचने के लिए आप एक और पद $\alpha$ जोड़ते हैं जो learning rate है। मान कम होगा तो आप ढलान पर धीमे-धीमे आगे बढ़ेंगे। जबकि यह एक अच्छा विचार हो सकता है (कम learning rate का उपयोग) ताकि कोई local minima न छूटे, इसका अर्थ यह भी हो सकता है कि आपको अभिसरण में बहुत समय लगे—खासकर अगर आप plateau क्षेत्र में फँस जाएँ।
यह learning rates के उद्देश्यों का सरल शब्दों में एक त्वरित पुनरावलोकन था। अब आप देखेंगे कि अपने neural network के लिए अच्छा learning rate चुनने की तकनीकें क्या हैं।
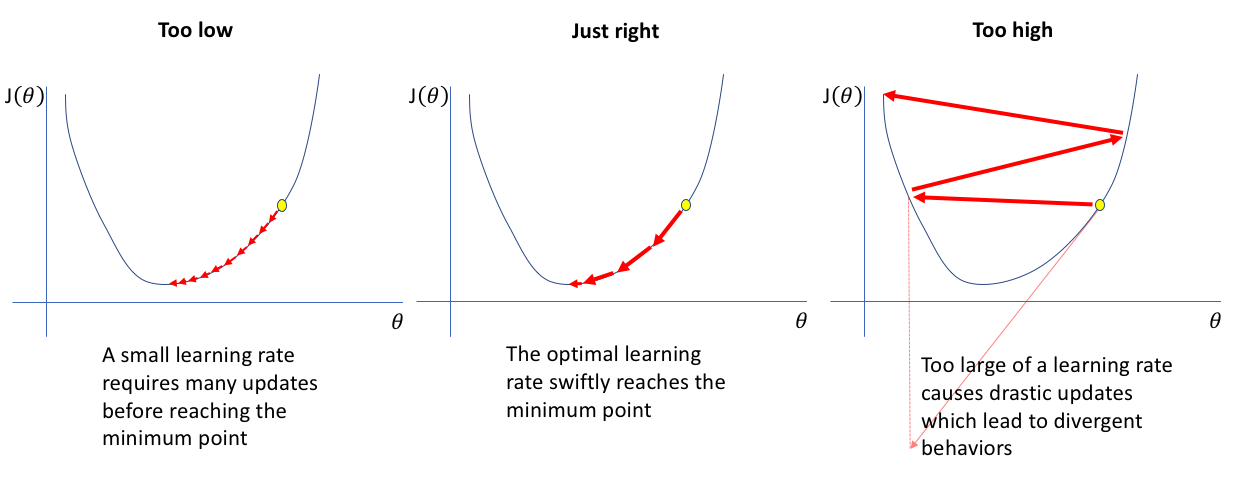
किसी neural network के लिए कोई स्थिर learning rate नहीं होता। यह उस समस्या के प्रकार, नेटवर्क में दी जा रही डेटा की प्रकृति, और सबसे बढ़कर नेटवर्क की संरचना पर निर्भर करता है—जो समस्या दर समस्या बदलती है। Learning rate को हाथ से चुनना बहुत कष्टसाध्य काम है, क्योंकि अगर आप एक बड़ा नेटवर्क train कर रहे हैं तो लागत बहुत अधिक हो सकती है। और समय भी बहुत लगता है।
क्या आपको Grid Search या Random Search जैसे मानक hyperparameter optimization तरीकों को चलाना चाहिए?
CLR से पहले, Adaptive Learning Rates प्रस्तावित किए गए थे जिन्हें CLR के प्रतिद्वंद्वी की तरह समझा जा सकता है, लेकिन Adaptive Learning Rates पर प्रयोग करना computation के लिहाज़ से महँगा है—जबकि CLR ऐसा नहीं है।
अब भी, सबसे आम प्रथा यह है कि learning rate को एक स्थिर मान पर सेट किया जाए और जब accuracy plateau पर पहुँच जाए तो उसे एक order of magnitude से घटा दिया जाए।
इसलिए, एक सुव्यवस्थित तकनीक की स्पष्ट आवश्यकता है जो किसी विशेष neural network के लिए अच्छा learning rate चुनने की प्रक्रिया को सरल बना दे। साथ ही, इस पद्धति पर भरोसा करने लायक पर्याप्त कारण भी होने चाहिए।
ऐसा लगता है कि Cyclical Learning Rates (CLR) समय पर ही सामने आए।
Cyclical learning rate (CLR) के उद्देश्य दो प्रकार के हैं:
आप इस खंड को केवल यह समझ विकसित करने के लिए पढ़ेंगे कि CLR कैसे काम करता है। अगले खंड में आप और गहराई में जाएँगे। पिछले हिस्सों में, आपने संक्षेप में समझा कि learning rates का उपयोग क्यों होता है। आइए इसे फिर से याद करें।
आदर्श learning rate वह होगा जो नेटवर्क के loss को तीव्रता से घटाए। यहीं CLR का कमाल आता है। मूल CLR शोधपत्र एक ऐसे प्रयोग का वर्णन करता है जिसमें आप loss के सापेक्ष learning rate के व्यवहार को देख सकते हैं। यह प्रयोग देखना सीधा है—आप प्रत्येक mini-batch के बाद learning rate को धीरे-धीरे बढ़ाते हैं, और हर वृद्धि पर loss दर्ज करते जाते हैं। यह बढ़ोतरी रैखिक (linear) या घातीय (exponential)—दोनों में से कोई भी हो सकती है। और हाँ, यही मूलतः LR Range Test है।
Leslie द्वारा दिखाए गए प्रयोग के बाद देखा गया कि बहुत कम learning rates पर loss घटता तो है पर बहुत ही धीमी गति से। जब आप optimal learning rate के क्षेत्र में प्रवेश करते हैं, तो loss function में तेज़ गिरावट दिखती है। यदि आप learning rate को और बढ़ाते हैं, तो यह नेटवर्क में पैरामीटर loss पैदा कर सकता है, जो बदले में loss बढ़ा सकता है। तो, इस प्रयोग से स्पष्ट है कि आप loss function में तीव्र कमी में रुचि रखते हैं और इसके लिए आप training के विभिन्न चरणों में loss function के gradients का विश्लेषण कर सकते हैं।
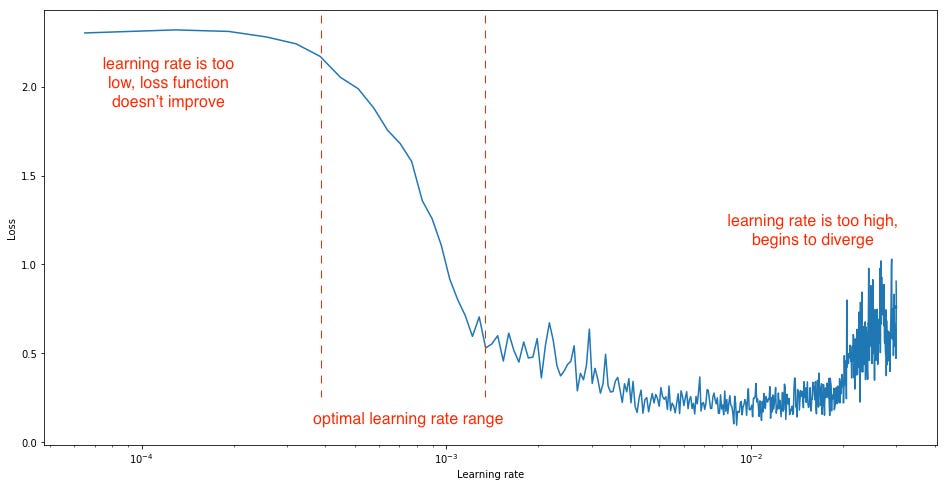
तो, ऊपर दिए गए ग्राफ से आप आसानी से तीन अलग-अलग चरण देख सकते हैं—पहले जहाँ loss में बहुत बदलाव नहीं होता, फिर एक समय आता है जब तीव्र गिरावट होती है और फिर loss दोबारा धीरे-धीरे बढ़ने लगता है।
क्या आप सबसे तीव्र गिरावट देख पा रहे हैं? जी हाँ, मूलतः आप उसी दायरे में पहुँचना चाहते हैं, और CLR इसे ढूँढने का अनुशासित तरीका देता है। अब जब समझ बन रही है, तो और जानें।
ऊपर का अवलोकन आपको एक महत्त्वपूर्ण बिंदु देता है:
CLR की अंतर्दृष्टि इस विचार से आती है कि learning rate को किसी रैखिक या घातीय घटते मान को अपनाने के बजाय एक तय दायरे में बदलने दिया जाए। आप ऐसा learning rates के एक निश्चित दायरे को सेट करके कर सकते हैं और फिर रैखिक या घातीय परिवर्तन के बजाय, उस तय दायरे में learning rates को चक्रीय रूप से बदलते रहें। Learning rate को चक्रीय रूप से बदलने के लिए Leslie ने निम्नलिखित फ़ंक्शन रूपों पर विचार किया:
लेकिन सभी रूपों से समकक्ष परिणाम मिले, और इसलिए मूल शोधपत्र में सादगी के कारण विचार केवल triangular रूप (रैखिक रूप से बढ़ना और फिर रैखिक रूप से घटना) के साथ प्रस्तुत किया गया। इस नीति को triangular learning rate policy भी कहा जाता है। इसे लागू करना भी सीधा है। नीचे triangular learning rate policy का एक सामान्यीकृत कार्यान्वयन दिया है:
local cycle = math.floor(1 + epochCounter / ( 2 ∗ stepsize))
local x = math.abs(epochCounter / stepsize − 2∗ cycle + 1 )
local lr = opt.LR + (maxLR − opt.LR) ∗ math.max(0 , (1−x ))
जहाँ
त्रिकोणीय रूप को दृश्य रूप में समझने के लिए निम्न चित्र देखें:

स्रोत: ट्यूटोरियल की शुरुआत में उल्लिखित मूल CLR शोधपत्र।
Triangular learning rate policy के अतिरिक्त, शोधपत्र में निम्न नीतियाँ भी प्रस्तुत की गईं:
इस बिंदु पर आपके मन में एक सवाल जल्दी से आ सकता है—न्यूनतम और अधिकतम सीमाएँ यथोचित रूप से कैसे तय करें? याद है, आपने अभी-अभी LR Range Test पढ़ा? अब इसकी प्रासंगिकता और स्पष्ट होनी चाहिए।
Leslie ने Learning Rate की सीमा तय करने का एक सरल और सुविधाजनक तरीका सुझाया:
अब एक छोटा case study करें ताकि देखें कि CLR कैसे अद्भुत परिणाम दे सकता है।
(इस ट्यूटोरियल के अंत तक, आप CLR पर हाल में प्रस्तावित कुछ और प्रगतियों के बारे में भी जानेंगे—पर अभी तक आप CLR का महत्व समझ चुके हैं।)
आप यह क्लासिक MNIST डेटासेट के साथ करेंगे, जो संभवतः Computer Vision और Deep Learning में शुरुआत करने के लिए सबसे लोकप्रिय डेटासेट है। यदि आप MNIST को विस्तार से समझना चाहते हैं तो यह ब्लॉग देखें। आप प्रयोग के सभी उद्देश्यों के लिए keras का व्यापक उपयोग करेंगे। keras इस डेटासेट का एक built-in संस्करण देता है। आप इसे import करके और कुछ बुनियादी EDA करके अपना प्रयोग शुरू करेंगे।
from keras.datasets import mnist
Using TensorFlow backend.
आपने डेटासेट सफलतापूर्वक import कर लिया। अब आप डेटासेट का कुछ बुनियादी विज़ुअलाइज़ेशन करेंगे।
import matplotlib.pyplot as plt

(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Plot 4 images as gray scale
plt.subplot(152)
plt.imshow(X_train[0], cmap=plt.get_cmap('gray'))
plt.subplot(153)
plt.imshow(X_train[1], cmap=plt.get_cmap('gray'))
plt.subplot(154)
plt.imshow(X_train[2], cmap=plt.get_cmap('gray'))
plt.subplot(155)
plt.imshow(X_train[3], cmap=plt.get_cmap('gray'))
# Show the plot
plt.show()
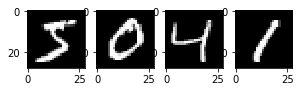
बहुत बढ़िया! अब आप सीधे एक सरल multi-layer neural network बनाने की ओर बढ़ेंगे। पर उससे पहले, कुछ बुनियादी data preprocessing करेंगे।
# Flatten 28*28 images to a 784 vector for each image
num_pixels = X_train.shape[1] * X_train.shape[2]
X_train = X_train.reshape(X_train.shape[0], num_pixels).astype('float32')
X_test = X_test.reshape(X_test.shape[0], num_pixels).astype('float32')
आपने क्या किया?
डेटासेट में छवियाँ 28*28 आयाम की हैं जिन्हें एक साधारण multilayer neural network में समायोजित करना कठिन होता है। इसलिए आपने reshape() फ़ंक्शन का उपयोग करके छवियों को एक आयाम में बदला, जहाँ प्रत्येक छवि में 784-पिक्सेल डेटा है।
छवियों में पिक्सेल मान 0 - 255 की सीमा में हैं। एक अच्छा विचार होगा कि इसे और घटाकर 0 - 1 की सीमा में normalize कर दिया जाए।
X_train = X_train / 255
X_test = X_test / 255
आउटपुट वैरिएबल 0 से 9 तक का एक integer है। यह एक multi-class classification समस्या है। आप class labels का one-hot encoding करेंगे ताकि class integers के वेक्टर को binary matrix में बदला जा सके। आप यह “binarization” इसलिए करेंगे ताकि इसे neural network को train करने के लिए एक फीचर के रूप में शामिल किया जा सके।
आप यह आसानी से keras में उपलब्ध np_utils.to_categorical() helper फ़ंक्शन से कर सकते हैं।
from keras.utils import np_utils

y_train = np_utils.to_categorical(y_train)
y_test = np_utils.to_categorical(y_test)
num_classes = y_test.shape[1]
अब आप अपने नेटवर्क की संरचना परिभाषित करेंगे। इसके लिए आप एक सरल fully-connected नेटवर्क का उपयोग करेंगे। keras में यह आम तौर पर तीन-चरण की प्रक्रिया है:
import numpy as np
from keras.models import Sequential
from keras.layers import Dense

# Create model
model = Sequential()
model.add(Dense(num_pixels, input_dim=num_pixels, kernel_initializer='normal', activation='relu'))
model.add(Dense(num_classes, kernel_initializer='normal', activation='softmax'))

# Compile model
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
आइए देखें आपने ऊपर के कोड में क्या किया। आप नेटवर्क को sequential रूप से बना रहे हैं (जो परतों का linear stack है)। फिर आपने नेटवर्क में परतें जोड़ना शुरू किया जहाँ पहली परत में आपने neurons जोड़े (जो एक छवि में पिक्सेलों की संख्या के बराबर यानी 784 हैं) और इनपुट dimension निर्दिष्ट किया जो यहाँ पिक्सेलों की संख्या के समान है। आपने नेटवर्क को निर्देश दिया कि वह अपने weights को normal वितरण से initialize करे। अंत में, पहली परत के लिए आपने relu activation फ़ंक्शन दिया।
अंतिम परत में आपने neurons की संख्या 10 रखी (जो class labels की संख्या है), और activation softmax दिया ताकि आउटपुट को probability-जैसे मानों में बदला जा सके और 10 में से एक class को मॉडल की अंतिम भविष्यवाणी के रूप में चुना जा सके।
आपने मॉडल को compile किया ताकि मॉडल की optimization विधि तय हो (यहाँ ADAM) और वह किस प्रकार के loss को optimize करेगा (यहाँ categorical_loss)।
अब आप मॉडल को train करेंगे और training में लगा समय दर्ज करेंगे। आप उसका प्रदर्शन भी जाँचेंगे।
import timeit

# For fixing the reproducibility
from numpy.random import seed
seed(1)

# Fit the model
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=200, verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 10s - loss: 0.2774 - acc: 0.9207 - val_loss: 0.1362 - val_acc: 0.9610
Epoch 2/10
 - 8s - loss: 0.1113 - acc: 0.9675 - val_loss: 0.0951 - val_acc: 0.9720
Epoch 3/10
 - 8s - loss: 0.0712 - acc: 0.9793 - val_loss: 0.0802 - val_acc: 0.9750
Epoch 4/10
 - 8s - loss: 0.0503 - acc: 0.9857 - val_loss: 0.0687 - val_acc: 0.9788
Epoch 5/10
 - 8s - loss: 0.0360 - acc: 0.9897 - val_loss: 0.0632 - val_acc: 0.9797
Epoch 6/10
 - 8s - loss: 0.0267 - acc: 0.9928 - val_loss: 0.0643 - val_acc: 0.9784
Epoch 7/10
 - 8s - loss: 0.0201 - acc: 0.9951 - val_loss: 0.0633 - val_acc: 0.9802
Epoch 8/10
 - 8s - loss: 0.0150 - acc: 0.9962 - val_loss: 0.0613 - val_acc: 0.9808
Epoch 9/10
 - 8s - loss: 0.0108 - acc: 0.9978 - val_loss: 0.0625 - val_acc: 0.9806
Epoch 10/10
 - 8s - loss: 0.0076 - acc: 0.9988 - val_loss: 0.0612 - val_acc: 0.9809
Time taken for the Network to train :  86.4216202873591
Baseline Error: 1.91%
यह साधारण मॉडल लगभग 87 सेकंड में केवल 1.91% की error दर तक पहुँचा—काफी अच्छा। अब आप CLR की ताकत देखेंगे। आप keras में CLR का implementation Github से clone करके शुरू करेंगे।
सफलतापूर्वक clone करने के बाद, आपकी local working directory में निम्न फाइलें होनी चाहिए।

यहाँ CLR policy को keras callback के रूप में implement किया गया है।
from keras.callbacks import *
from clr_callback import *
from keras.optimizers import Adam

# You are using the triangular learning rate policy and
#  base_lr (initial learning rate which is the lower boundary in the cycle) is 0.1
clr_triangular = CyclicLR(mode='triangular')
model.compile(optimizer=Adam(0.1), loss='categorical_crossentropy', metrics=['accuracy'])
आप इस clr_triangular को नेटवर्क को fit करते समय callbacks पैरामीटर में पास करेंगे। इस बार आप बड़ा batch_size लेंगे। समय भी दर्ज करेंगे।
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=2000,callbacks=[clr_triangular], verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 4s - loss: 0.0046 - acc: 0.9996 - val_loss: 0.0571 - val_acc: 0.9831
Epoch 2/10
 - 4s - loss: 0.0030 - acc: 0.9998 - val_loss: 0.0575 - val_acc: 0.9829
Epoch 3/10
 - 4s - loss: 0.0023 - acc: 0.9999 - val_loss: 0.0594 - val_acc: 0.9827
Epoch 4/10
 - 4s - loss: 0.0018 - acc: 0.9999 - val_loss: 0.0589 - val_acc: 0.9835
Epoch 5/10
 - 4s - loss: 0.0014 - acc: 1.0000 - val_loss: 0.0595 - val_acc: 0.9831
Epoch 6/10
 - 4s - loss: 0.0011 - acc: 1.0000 - val_loss: 0.0600 - val_acc: 0.9836
Epoch 7/10
 - 4s - loss: 0.0010 - acc: 1.0000 - val_loss: 0.0612 - val_acc: 0.9832
Epoch 8/10
 - 4s - loss: 8.2190e-04 - acc: 1.0000 - val_loss: 0.0621 - val_acc: 0.9829
Epoch 9/10
 - 4s - loss: 6.6182e-04 - acc: 1.0000 - val_loss: 0.0624 - val_acc: 0.9836
Epoch 10/10
 - 4s - loss: 5.7177e-04 - acc: 1.0000 - val_loss: 0.0635 - val_acc: 0.9836
Time taken for the Network to train :  43.23223609056981
Baseline Error: 1.64%
क्या आप लाभ देख पा रहे हैं? यह देखने लायक है! आपका मॉडल मात्र 44 सेकंड में train हो गया और पिछली बार से भी बेहतर error दर दे गया। बहुत बढ़िया!
आप अंत तक पहुँच गए हैं। इस ट्यूटोरियल में आपने उपयुक्त learning rate ढूँढने की अत्यंत महत्वपूर्ण समस्या और CLR ने इसे सुलझाने का नजरिया कैसे बदल दिया, यह पढ़ा। आपने CLR को पर्याप्त विस्तार से समझा और छोटे प्रयोग करके देखा कि CLR कम समय में बेहतरीन परिणाम कैसे दे सकता है।
अब आगे क्या? CLR से निकले दो उप-उत्पाद हैं:
ऊपर दिए गए दोनों तरीकों का अध्ययन करें ताकि इस विषय पर और भी अंतर्दृष्टि मिले। साथ ही, CLR के बाद Leslie ने A disciplined approach to neural network hyper-parameters: Part 1 -- learning rate, batch size, momentum, and weight decay शीर्षक से एक शोधपत्र प्रकाशित किया जिसमें CLR की पुनर्रचना के साथ neural network के अन्य महत्त्वपूर्ण hyperparameters के मान चुनने के कुशल तरीकों पर चर्चा है। इस पेपर में Leslie ने अपनी एक तकनीक Super Convergence की भी पुनरावृत्ति की। जो कोई neural networks के बारे में सोचता, खाता और सोता है—उसके लिए यह शोधपत्र अवश्य पढ़ने योग्य है।
सीमित प्रयोज्यता CLR की एक प्रमुख कमी है। इसे production स्तर पर इस्तेमाल करने से पहले और सुदृढ़ बनाना होगा।
यदि आप Neural Networks के बारे में और जानना चाहते हैं, तो DataCamp का Deep Learning in Python कोर्स ज़रूर करें—यह बहुत अच्छी तरह डिज़ाइन किया गया है और Dan Becker (Head of Kaggle Learn) द्वारा पढ़ाया जाता है।
Python और Deep Learning के बारे में और जानें
कोर्स
कोर्स