Cours
Introduction au Deep Learning en Python
4 h
264.6K
(Ce tutoriel suppose que vous maîtrisez les bases des réseaux de neurones)
Le terme « réseau de neurones » n’a plus rien d’exotique, ni pour l’informatique ni, soyons honnêtes, pour le grand public. S’il fascine, ce n’est pas seulement parce qu’il résout quantité de problèmes concrets : c’est surtout par la diversité des problèmes qu’il sait adresser. Comment expliquer une telle variété ?
Que ce soit en psychologie cognitive, en cybersécurité, en santé (sans même parler pour l’instant de la vision par ordinateur, des graphismes, du traitement du langage naturel, etc.), les cas d’usage moins attendus ne manquent pas. Presque tous les secteurs profitent massivement de l’intelligence et de l’automatisation qu’offre un réseau de neurones.
Mais pourquoi ? La question revient sans cesse. La réponse reste l’objet de recherches actives : les réseaux de neurones sont des boîtes noires, et leur ressemblance avec le cerveau complique encore l’analyse. Quoi qu’il en soit, ce n’est pas l’objectif de cet article.
Une chose est sûre : pour obtenir les résultats attendus, il faut soigner le training (entraînement). Et vous l’avez sans doute déjà constaté : entraîner un très grand réseau demande une puissance de calcul considérable. Sans de bons GPU et SSD, il est presque impossible d’entraîner un réseau très grand. Et qu’est-ce qu’un réseau « très grand » ? Disons, de quoi produire d’excellents résultats sur ImageNet, la référence en la matière.
Cette vision de l’entraînement de réseaux immenses a été complètement bousculée quand une équipe de chercheurs de talent chez Fast.ai a dépassé le modèle de Google, atteignant 93 % de précision en seulement 18 minutes, pour un coût total de 40 $.
Intriguant ? Lisez la suite !
Mais quels ont été les ingrédients clés ? Des GPU dernier cri ? Des TPU de pointe ? Des SSD ultra-rapides ?
Absolument pas. La configuration était modeste — le coût total n’était que de 40 $. L’élément décisif : des algorithmes d’entraînement de pointe. Dans cet article, le chercheur et pédagogue Jeremy Howard détaille les raisons de ce succès.
C’est l’exemple parfait où la puissance d’algorithmes bien pensés prend le pas sur du matériel coûteux. Ici, vous allez découvrir une technique qui aide à entraîner un réseau avec le meilleur taux d’apprentissage possible : le Cyclical Learning Rate (CLR), ou taux d’apprentissage cyclique. Proposé en 2015 par Leslie N. Smith. Retrouvez l’article original ici.
Pourquoi se concentrer sur le taux d’apprentissage, alors qu’il existe d’autres hyperparamètres essentiels comme le taux de dropout ou les fonctions d’activation ? Parce que le taux d’apprentissage est le plus important d’entre eux. Tout simplement.
Dans cet article, vous allez voir :
Revenons rapidement à l’objectif premier du taux d’apprentissage dans l’entraînement d’un réseau.
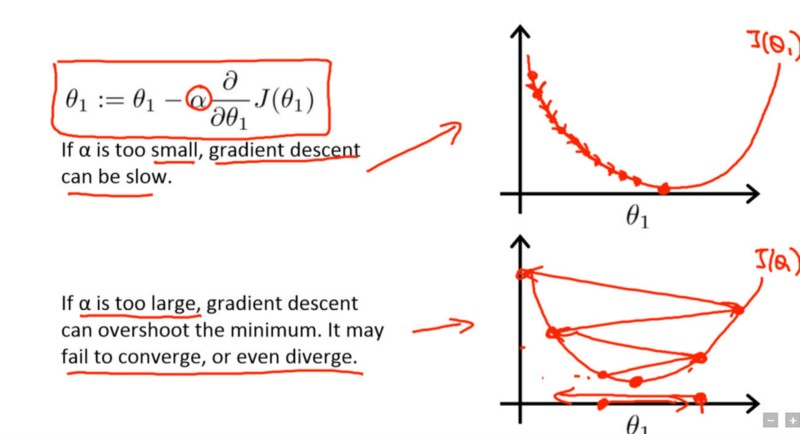
Le taux d’apprentissage est un hyperparamètre qui contrôle l’ampleur de la mise à jour des poids du réseau au regard du gradient de la perte. Pourquoi parler de gradients ? Parce que vous cherchez à optimiser un réseau fraîchement créé avec la descente de gradient. Son but : trouver le minimum de la fonction de perte que votre réseau veut optimiser. Regardez l’illustration suivante [issue du cours de Deep Learning d’Andrew Ng sur Coursera] :
Le terme encadré est la règle de mise à jour avec laquelle le réseau commence à apprendre ses paramètres $\theta$1, où $\alpha$ est le taux d’apprentissage.
Sur la première courbe, le point le plus bas est le minimum de la fonction de perte. Supposons que, dans l’itération courante, votre réseau se situe près du point haut à gauche. Pour converger vers le minimum, vous calculez les dérivées partielles de la perte $J(\theta1)$ et obtenez ainsi les gradients qui indiquent la direction à suivre.
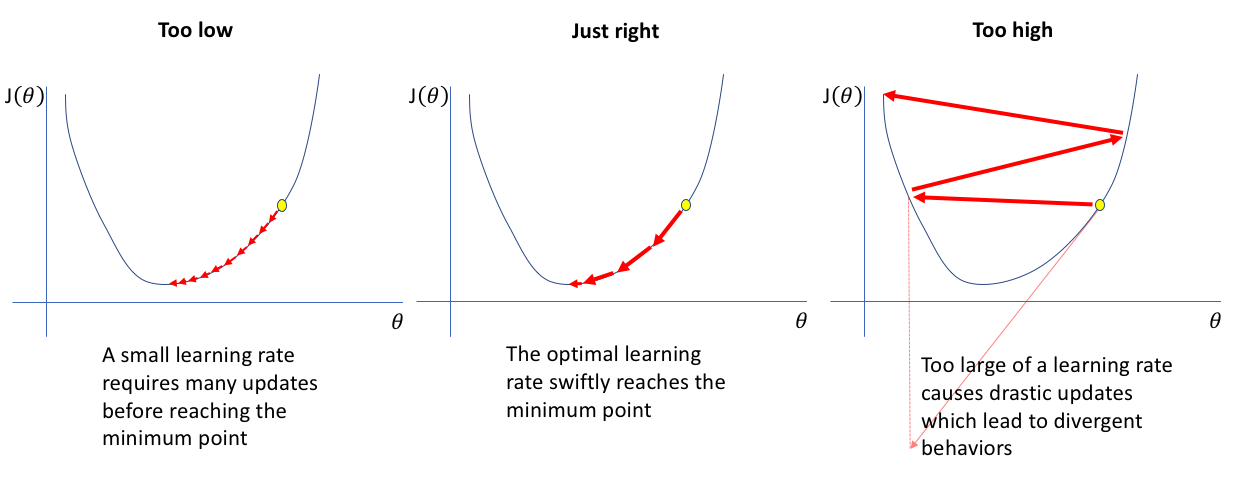
Pour accélérer la progression, vous ajoutez le terme $\alpha$, le taux d’apprentissage. Plus il est faible, plus la descente est lente. C’est utile pour éviter de manquer des minima locaux, mais cela peut rallonger considérablement la convergence — en particulier si vous vous retrouvez sur un plateau.
Voilà pour le rappel, en termes simples. Passons maintenant aux techniques de choix d’un bon taux d’apprentissage.
Source : le blog de Jeremy Jordan
Il n’existe pas de taux d’apprentissage fixe pour tous les réseaux. Il dépend du problème traité, du type de données injectées, et surtout de l’architecture du réseau, qui varie selon les cas. Choisir « à la main » un taux d’apprentissage est pénible : si vous entraînez un grand réseau, la facture peut grimper vite — et cela prend du temps.
Faut-il lancer des recherches d’hyperparamètres classiques comme Grid Search ou Random Search ?
Avant le CLR, on a proposé des taux d’apprentissage adaptatifs, concurrent direct du CLR, mais leurs expérimentations sont coûteuses en calcul — ce que n’est pas le CLR.
Encore aujourd’hui, la pratique la plus courante consiste à fixer un taux d’apprentissage constant puis à le réduire d’un ordre de grandeur quand la précision plafonne.
Il faut donc une méthode systématique qui simplifie le choix d’un bon taux pour un réseau donné. Et il faut aussi des arguments solides pour justifier la confiance qu’on peut lui accorder.
On dirait bien que les taux d’apprentissage cycliques (CLR) sont arrivés à point nommé.
Le CLR poursuit deux objectifs :
Cette section vise surtout à développer votre intuition du CLR. Vous entrerez dans les détails ensuite. Nous avons rappelé pourquoi on utilise un taux d’apprentissage ; revenons-y un instant.
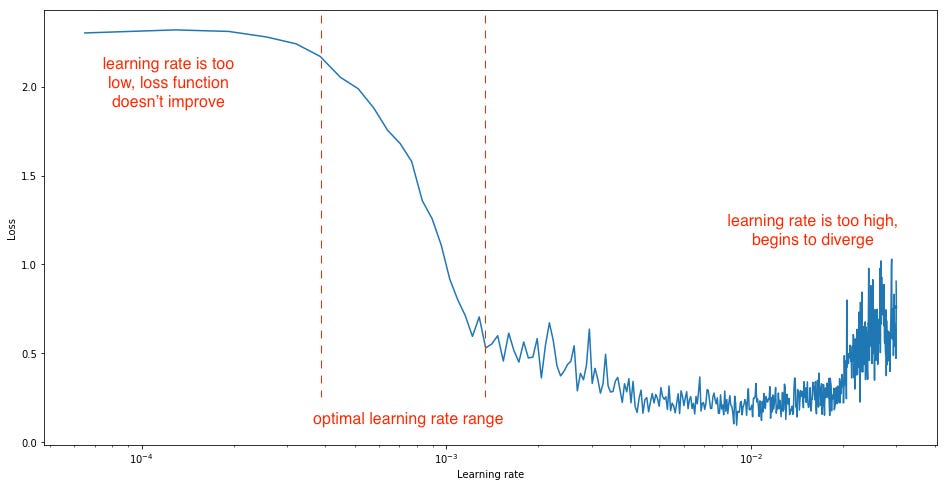
Un taux d’apprentissage idéal provoque une forte baisse de la perte du réseau. C’est là que la magie du CLR opère. L’article initial présente une expérience qui observe le comportement de la perte en fonction du taux d’apprentissage : on augmente progressivement le taux après chaque mini-batch et l’on enregistre la perte à chaque incrément. Cette augmentation peut être linéaire ou exponentielle. C’est précisément le LR Range Test.
Suite à cette expérience, Leslie montre que, pour des taux trop faibles, la perte décroît, mais très lentement. En entrant dans la zone optimale, la perte chute rapidement. Si vous continuez d’augmenter le taux, vous risquez de dégrader l’apprentissage des paramètres et de faire remonter la perte. Conclusion : vous cherchez la zone de chute la plus abrupte, et pour cela vous pouvez analyser les gradients de la perte à différentes étapes de l’entraînement.
Source : le blog de Jeremy Jordan
Sur le graphique ci-dessus, on distingue trois phases : une zone où la perte varie peu, puis une chute marquée, puis une remontée progressive.
Voyez-vous la chute la plus abrupte ? C’est cette plage qui vous intéresse. Le CLR vous donne une méthode rigoureuse pour la trouver. Voyons cela plus en profondeur.
De cette observation découle un point clé :
L’intuition du CLR consiste à faire varier le taux d’apprentissage dans une plage donnée, plutôt que de le faire décroître linéairement ou exponentiellement. Concrètement, vous fixez une plage, puis, au lieu d’une variation monotone, vous faites varier le taux cycliquement dans cette plage. Leslie a considéré les formes suivantes pour faire varier cycliquement le taux :
Toutes donnent des résultats équivalents. L’article original se concentre donc sur la forme triangulaire (augmentation linéaire puis diminution linéaire), par simplicité. Cette politique est appelée triangular learning rate policy. Sa mise en œuvre est directe. Voici une implémentation généralisée de la triangular learning rate policy :
local cycle = math.floor(1 + epochCounter / ( 2 ∗ stepsize))
local x = math.abs(epochCounter / stepsize − 2∗ cycle + 1 )
local lr = opt.LR + (maxLR − opt.LR) ∗ math.max(0 , (1−x ))
où
La figure suivante aide à visualiser la forme triangulaire :

Source : l’article CLR original cité en début de tutoriel.
En plus de la politique triangulaire, l’article présente aussi :
Question naturelle à ce stade : comment estimer des bornes inférieure et supérieure raisonnables ? Rappelez-vous du LR Range Test évoqué plus haut : vous voyez mieux son intérêt.
Leslie propose une méthode simple et pratique pour définir la plage :
Passons à une étude de cas pour voir le CLR à l’œuvre.
(En fin de tutoriel, vous trouverez quelques améliorations récentes du CLR. Pour l’instant, vous en avez déjà mesuré l’intérêt.)
Nous utiliserons le jeu de données classique MNIST, sans doute le plus populaire pour débuter en vision par ordinateur et deep learning. Consultez cet article pour une présentation détaillée de MNIST. Vous utiliserez keras pour l’expérience ; le dataset est intégré.
from keras.datasets import mnist
Using TensorFlow backend.
Le dataset est importé. Réalisons quelques visualisations simples.
import matplotlib.pyplot as plt

(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Plot 4 images as gray scale
plt.subplot(152)
plt.imshow(X_train[0], cmap=plt.get_cmap('gray'))
plt.subplot(153)
plt.imshow(X_train[1], cmap=plt.get_cmap('gray'))
plt.subplot(154)
plt.imshow(X_train[2], cmap=plt.get_cmap('gray'))
plt.subplot(155)
plt.imshow(X_train[3], cmap=plt.get_cmap('gray'))
# Show the plot
plt.show()
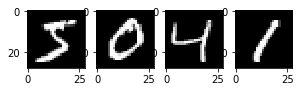
Parfait ! Avançons directement vers la construction d’un réseau multi‑couches simple. Au préalable, appliquons quelques prétraitements.
# Flatten 28*28 images to a 784 vector for each image
num_pixels = X_train.shape[1] * X_train.shape[2]
X_train = X_train.reshape(X_train.shape[0], num_pixels).astype('float32')
X_test = X_test.reshape(X_test.shape[0], num_pixels).astype('float32')
Qu’avons‑nous fait ?
Les images sont en 28×28, ce qui n’est pas idéal pour un réseau dense simple. Nous les avons donc aplaties en un vecteur de 784 pixels via reshape().
Les pixels sont entre 0 et 255. Mieux vaut normaliser en 0 – 1.
X_train = X_train / 255
X_test = X_test / 255
La variable cible est un entier de 0 à 9. C’est une classification multi-classes. Nous allons appliquer un one‑hot encoding des étiquettes pour obtenir une matrice binaire, afin de l’utiliser comme sortie du réseau.
Vous pouvez le faire avec np_utils.to_categorical() de keras.
from keras.utils import np_utils

y_train = np_utils.to_categorical(y_train)
y_test = np_utils.to_categorical(y_test)
num_classes = y_test.shape[1]
Définissons maintenant l’architecture. Nous utiliserons un réseau entièrement connecté simple. Avec keras, cela suit trois étapes :
import numpy as np
from keras.models import Sequential
from keras.layers import Dense

# Create model
model = Sequential()
model.add(Dense(num_pixels, input_dim=num_pixels, kernel_initializer='normal', activation='relu'))
model.add(Dense(num_classes, kernel_initializer='normal', activation='softmax'))

# Compile model
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
Que fait ce code ? Vous construisez séquentiellement le réseau (pile linéaire de couches). Première couche : autant de neurones que de pixels (784), entrée de même dimension, poids initialisés selon une loi normale, activation relu.
Couche de sortie : 10 neurones (une par classe), activation softmax pour produire des probabilités et sélectionner une seule classe en sortie.
La compilation précise la méthode d’optimisation (ADAM) et la perte optimisée (categorical_crossentropy).
Entraînons le modèle, mesurons le temps et testons ses performances.
import timeit

# For fixing the reproducibility
from numpy.random import seed
seed(1)

# Fit the model
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=200, verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 10s - loss: 0.2774 - acc: 0.9207 - val_loss: 0.1362 - val_acc: 0.9610
Epoch 2/10
 - 8s - loss: 0.1113 - acc: 0.9675 - val_loss: 0.0951 - val_acc: 0.9720
Epoch 3/10
 - 8s - loss: 0.0712 - acc: 0.9793 - val_loss: 0.0802 - val_acc: 0.9750
Epoch 4/10
 - 8s - loss: 0.0503 - acc: 0.9857 - val_loss: 0.0687 - val_acc: 0.9788
Epoch 5/10
 - 8s - loss: 0.0360 - acc: 0.9897 - val_loss: 0.0632 - val_acc: 0.9797
Epoch 6/10
 - 8s - loss: 0.0267 - acc: 0.9928 - val_loss: 0.0643 - val_acc: 0.9784
Epoch 7/10
 - 8s - loss: 0.0201 - acc: 0.9951 - val_loss: 0.0633 - val_acc: 0.9802
Epoch 8/10
 - 8s - loss: 0.0150 - acc: 0.9962 - val_loss: 0.0613 - val_acc: 0.9808
Epoch 9/10
 - 8s - loss: 0.0108 - acc: 0.9978 - val_loss: 0.0625 - val_acc: 0.9806
Epoch 10/10
 - 8s - loss: 0.0076 - acc: 0.9988 - val_loss: 0.0612 - val_acc: 0.9809
Time taken for the Network to train :  86.4216202873591
Baseline Error: 1.91%
Ce modèle simple s’en sort très bien : 1,91 % d’erreur en environ 87 secondes. Passons à la puissance du CLR. Commencez par cloner l’implémentation Keras du CLR sur GitHub.
Après clonage, vous devriez avoir les fichiers suivants dans votre répertoire de travail.

La politique CLR est implémentée en tant que keras callback.
from keras.callbacks import *
from clr_callback import *
from keras.optimizers import Adam

# You are using the triangular learning rate policy and
#  base_lr (initial learning rate which is the lower boundary in the cycle) is 0.1
clr_triangular = CyclicLR(mode='triangular')
model.compile(optimizer=Adam(0.1), loss='categorical_crossentropy', metrics=['accuracy'])
Vous allez passer clr_triangular au paramètre callbacks lors de l’entraînement. Utilisons un batch_size plus grand et mesurons le temps.
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=2000,callbacks=[clr_triangular], verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 4s - loss: 0.0046 - acc: 0.9996 - val_loss: 0.0571 - val_acc: 0.9831
Epoch 2/10
 - 4s - loss: 0.0030 - acc: 0.9998 - val_loss: 0.0575 - val_acc: 0.9829
Epoch 3/10
 - 4s - loss: 0.0023 - acc: 0.9999 - val_loss: 0.0594 - val_acc: 0.9827
Epoch 4/10
 - 4s - loss: 0.0018 - acc: 0.9999 - val_loss: 0.0589 - val_acc: 0.9835
Epoch 5/10
 - 4s - loss: 0.0014 - acc: 1.0000 - val_loss: 0.0595 - val_acc: 0.9831
Epoch 6/10
 - 4s - loss: 0.0011 - acc: 1.0000 - val_loss: 0.0600 - val_acc: 0.9836
Epoch 7/10
 - 4s - loss: 0.0010 - acc: 1.0000 - val_loss: 0.0612 - val_acc: 0.9832
Epoch 8/10
 - 4s - loss: 8.2190e-04 - acc: 1.0000 - val_loss: 0.0621 - val_acc: 0.9829
Epoch 9/10
 - 4s - loss: 6.6182e-04 - acc: 1.0000 - val_loss: 0.0624 - val_acc: 0.9836
Epoch 10/10
 - 4s - loss: 5.7177e-04 - acc: 1.0000 - val_loss: 0.0635 - val_acc: 0.9836
Time taken for the Network to train :  43.23223609056981
Baseline Error: 1.64%
Vous voyez l’avantage ? C’est bluffant ! Le modèle n’a mis que 44 secondes à s’entraîner, avec un taux d’erreur encore meilleur. Très bien !
Vous êtes arrivé au bout. Dans ce tutoriel, vous avez étudié la question cruciale du choix d’un taux d’apprentissage et vu comment le CLR a changé l’approche. Vous avez couvert ses principes, puis validé son intérêt via de petites expériences, avec des résultats excellents en moins de temps.
Et maintenant ? Deux prolongements issus du CLR :
Étudiez ces deux approches pour aller plus loin. Après le CLR, Leslie a publié A disciplined approach to neural network hyper-parameters: Part 1 -- learning rate, batch size, momentum, and weight decay, qui revisite le CLR et propose des méthodes efficaces pour choisir d’autres hyperparamètres clés. Il y revient aussi sur une technique appelée Super Convergence. Une lecture indispensable pour qui vit et respire réseaux de neurones.
L’une des limites majeures du CLR est sa portée d’application. Il doit encore être éprouvé avant un usage systématique en production.
Pour en savoir plus sur les réseaux de neurones, suivez le cours Deep Learning in Python de DataCamp, très bien conçu et enseigné par Dan Becker (Head of Kaggle Learn).
Approfondissez Python et le deep learning
Cours
Cours